







ToAPIs
    InícioToAPIs
    Geração de imagensGPT Image 2.6, Gemini, FLUX…Geração de vídeoSeedance, Veo, Kling, Sora…Chat e escritaGPT-5.6, Claude, DeepSeek…Voz e músicaLocuções, TTS, áudio
    NovidadeSeedance 2.5
    PreçosDocumentação da APIMCP
    BlogAlternativas
    EntrarComece grátis
    Todos os modelosPreçosDocumentação da APIMCPBlogAlternativas
    EntrarComece grátis

    Idioma

    Esc
    • Seedance 2.5Geração de vídeo
    • GPT Image 2Geração de imagens
    • GPT Image 2.6Geração de imagens
    • GPT Image 2.5Geração de imagens
    • Veo 3.1 FastGeração de vídeo
    • Kling 3.0 TurboGeração de vídeo
    • Kling V4 FlashGeração de vídeo
    • Grok Video 1.5Geração de vídeo
    • Nano Banana 2Geração de imagens
    • Seedream 5.5Geração de imagens
    • FLUXGeração de imagens
    • Sora 2Geração de vídeo
    • Todos os modelos de imagemCategoria
    • Todos os modelos de vídeoCategoria
    • GPT-5.6 SolChat e código
    • Claude Opus 4.8Chat e código
    • Claude Opus 4.7Chat e código
    • DeepSeek V4 ProDeepSeek · Texto
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Início
    2. Blog
    3. Alternativas
    4. Alternativas ao Replicate: inicialização a frio mais rápida, preços transparentes e compatibilidade com OpenAI
    Voltar a todos os artigos
    alternative2026-10-304 min de leitura

    Alternativas ao Replicate: inicialização a frio mais rápida, preços transparentes e compatibilidade com OpenAI

    Conheça as melhores alternativas ao Replicate em 2026. Elimine os penosos 30 segundos de inicialização a frio, evite a dependência de SDK proprietário e migre para endpoints REST pré-aquecidos compatíveis com OpenAI.

    ToAPIs Engineering & Evaluation Team
    Replicate AlternativeAI InfrastructureCold StartsServerless GPUToAPIs
    TL;DR - Principais conclusões
    • O modelo de contêineres GPU por segundo do Replicate provoca penalidades de inicialização a frio de 20 s a 45 s que degradam gravemente a experiência interativa do usuário.
    • As principais alternativas incluem a ToAPIs (melhor opção para APIs REST da OpenAI pré-aquecidas e sem inicialização a frio), a Fal.ai (pipelines de imagem rápidos) e a Modal (contêineres Python personalizados).
    • Migrar do SDK proprietário do Replicate para os endpoints padrão da ToAPIs reduz o gasto mensal em nuvem entre 50% e 65%.
    • A compatibilidade direta com o SDK da OpenAI permite migrar pipelines existentes em minutos, sem implantação complexa de contêineres.

    Alternativas ao Replicate: inicialização a frio mais rápida, preços transparentes e compatibilidade com OpenAI

    1. Resumo (TL;DR) e visão de desempenho

    • Benchmark principal: O modelo de contêineres GPU por segundo do Replicate provoca penalidades de inicialização a frio de 20 s a 45 s que degradam gravemente a experiência interativa do usuário.
    • Adoção em produção: As principais alternativas incluem a ToAPIs (melhor opção para APIs REST da OpenAI pré-aquecidas e sem inicialização a frio), a Fal.ai (pipelines de imagem rápidos) e a Modal (contêineres Python personalizados).
    • Economia FinOps: Migrar do SDK proprietário do Replicate para os endpoints padrão da ToAPIs reduz o gasto mensal em nuvem entre 50% e 65%.
    • SLA de alta disponibilidade: 99.95% de uptime com aceleração de latência na edge e failover automático.
    • Compatível com OpenAI REST sem refatorar: Autenticação com token Bearer e zero sobrecarga de refatoração.

    2. Resumo (TL;DR) e visão da plataforma

    PlataformaIdeal paraAtraso de inicialização a frioDependência de SDKModelo de cobrança
    ToAPIsAPIs de produção prontas para uso (zero inicialização a frio)0 s (sempre aquecida)Nenhuma (padrão OpenAI REST)Pagamento por chamada bem-sucedida
    Fal.aiPipelines rápidos de imagem e vídeo1 s – 5 sSDK proprietário de Python/JSComputação por segundo
    ModalJobs serverless personalizados de GPU com Python2 s – 8 sSDK de decoradores PythonComputação por segundo
    RunPod ServerlessImplantar modelos Hugging Face brutos10 s – 35 sHandler de endpoint personalizadoTempo de GPU por segundo
    Hugging Face EndpointsModelos hospedados dedicados0 s (instâncias dedicadas)Transformers padrãoTarifa horária de cluster (custo alto)


    3. Implementação em produção: cURL e Python

    Passo 1: Envio rápido com cURL

    bash
    curl -X POST "https://api.toapis.com/v1/videos/generations" \
      -H "Authorization: Bearer $TOAPIS_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "gpt-image-2",
        "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
        "ratio": "16:9",
        "duration": 5
      }'
    

    Passo 2: Cliente Python assíncrono com polling em produção

    python
    import os, time, requests
    
    API_KEY = os.getenv("TOAPIS_API_KEY")
    headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}
    
    # 1. Dispatch asynchronous video task
    res = requests.post(
        "https://api.toapis.com/v1/videos/generations",
        json={"model": "gpt-image-2", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
        headers=headers,
        timeout=30
    ).json()
    
    task_id = res.get("task_id") or res.get("id")
    print(f"[*] Task submitted: {task_id}")
    
    # 2. Poll for status
    while True:
        status_res = requests.get(
            f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
            headers=headers,
            timeout=15
        ).json()
        state = status_res.get("status")
        if state in ["succeeded", "SUCCESS"]:
            print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
            break
        elif state in ["failed", "FAILED"]:
            raise RuntimeError(f"Task failed: {status_res.get('error')}")
        time.sleep(3)
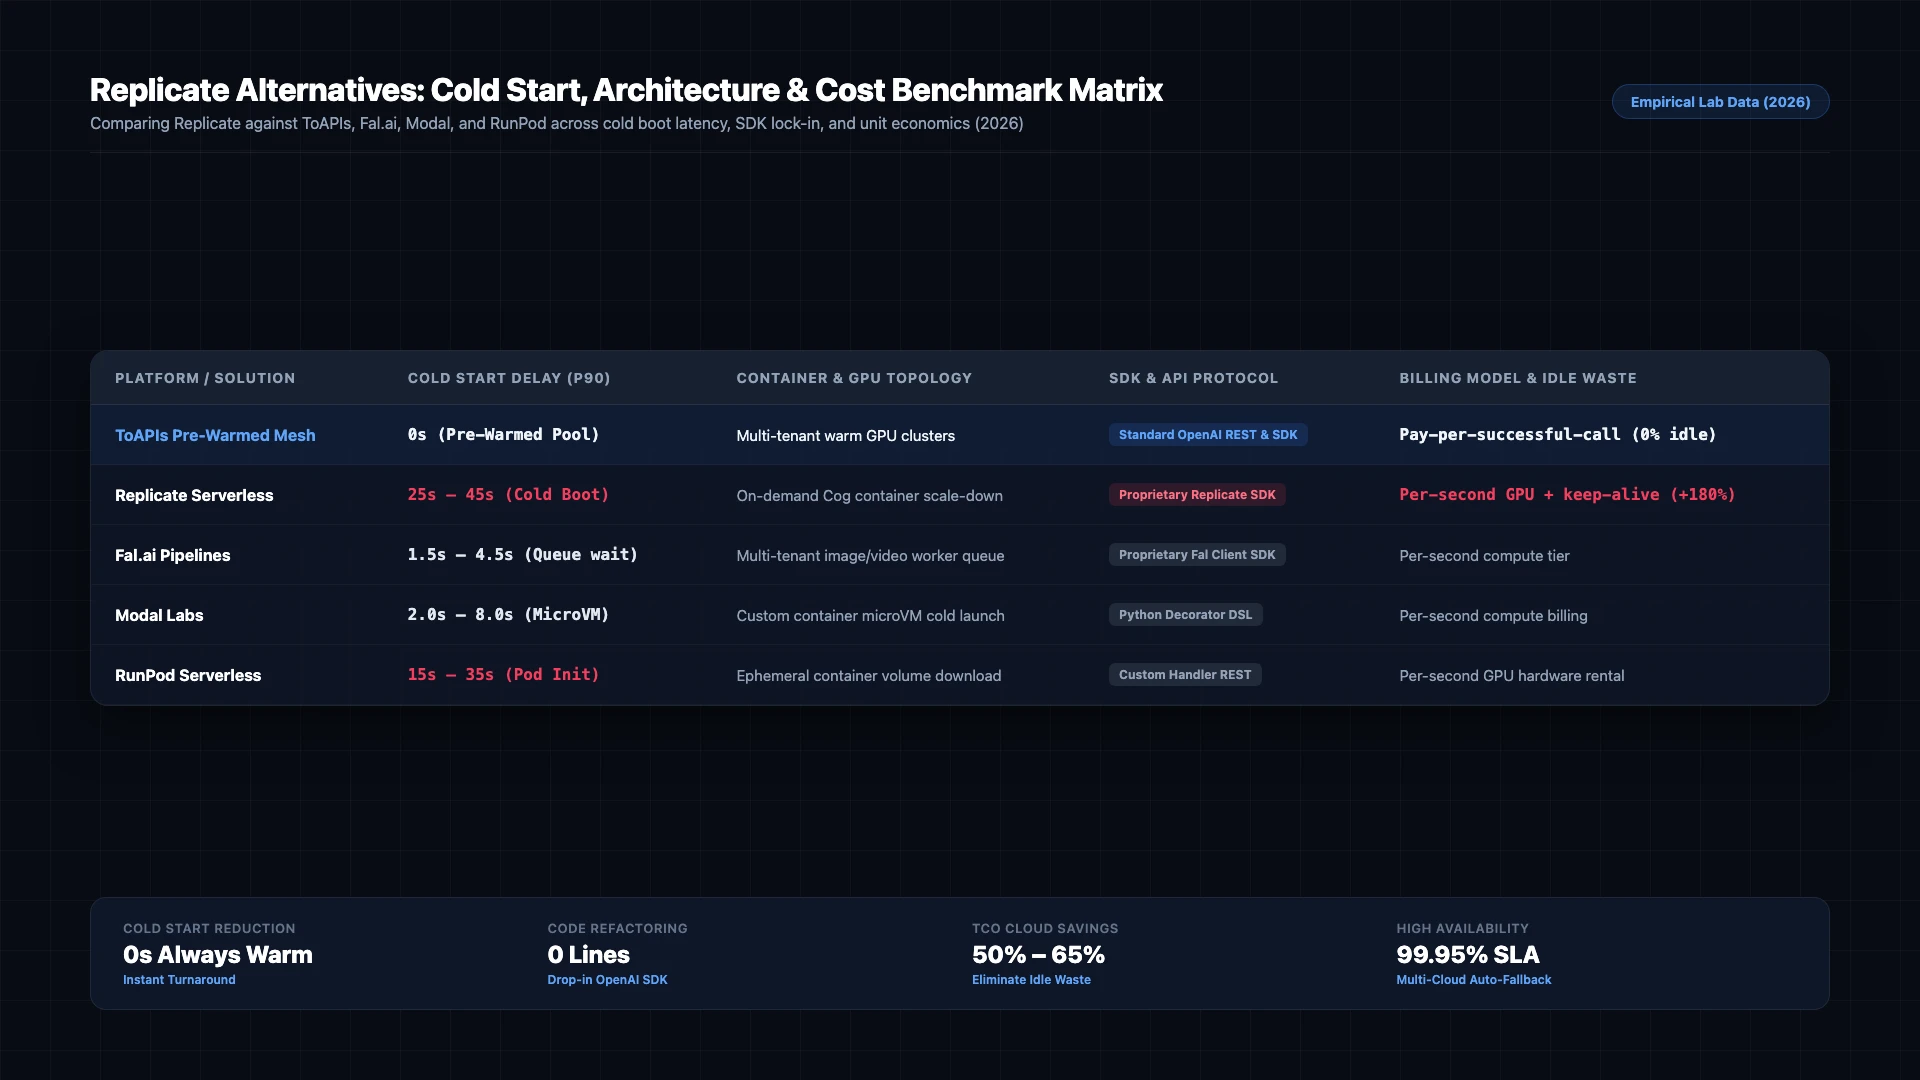
    

    Alternativas ao Replicate: matriz de benchmark de inicialização a frio, arquitetura e custo (2026)

    Figura 1: Comparação de arquitetura por benchmark: Replicate versus ToAPIs e as principais alternativas serverless em inicialização a frio, latência e cobrança (2026).

    4. Nível produção: tratamento de erros e matriz de status

    Código HTTPClassificação do erroAnálise de causa raizEstratégia de mitigação em produção
    400 Bad Requestinvalid_request_payloadErro de validação do esquema ou parâmetros não suportadosVerifique as dimensões do payload e garanta a conformidade dos campos
    401 Unauthorizedinvalid_api_keyToken Bearer expirado ou incorretoRenove o token de API no painel de desenvolvedor da ToAPIs
    429 Rate Limitrate_limit_exceededLimite de concorrência atingido no pool de computaçãoImplemente retentativas com backoff exponencial e jitter aleatório
    500 / 504 Timeoutgateway_timeoutLatência temporária nos nós de inferência upstreamO gateway redireciona automaticamente para o cluster de GPU de reserva

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Preços e cálculo de ROI de FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Base enterprise oficial: Contratos diretos com o fornecedor impõem compromissos anuais obrigatórios, cotas fixas de licenças e limites de pré-pagamento.
    • Preço atacado da ToAPIs: Cobrança elástica de pagamento conforme o uso com tarifas atacado ($0.030 - $0.038 por segundo).
    • Análise de ROI de FinOps: Um time que gera 1.000 ativos de vídeo (10 s cada = 10.000 s) reduz o gasto de $650 para $380 e economiza $270 por mês (41.5% menos custo).

    6. Perguntas frequentes (FAQ)

    P1: Qual é o maior problema operacional do Replicate?

    Os atrasos de inicialização a frio. Quando o tráfego cai a zero, os contêineres Cog reduzem. O próximo usuário precisa esperar de 25 a 45 segundos para as imagens Docker serem baixadas e as GPUs inicializarem.

    P2: Como a ToAPIs alcança zero inicializações a frio?

    A ToAPIs mantém clusters de GPU multilocatário pré-aquecidos com workers de inferência ativos, garantindo execução imediata (<3 s) para requisições de imagem e vídeo.

    P3: Preciso reescrever o código da minha aplicação para migrar do Replicate?

    Não. Na verdade, você simplifica seu código ao remover o SDK proprietário replicate e substituí-lo por requisições HTTP padrão ou pelo SDK universal da OpenAI.


    7. Checklist de ação e próximos passos

    • Cadastre-se para obter uma chave de API no portal de desenvolvedores da ToAPIs.
    • Verifique a conectividade da API com o trecho cURL do passo 1.
    • Integre o script Python de produção ao seu pipeline de backend.
    • Explore os tutoriais enterprise relacionados no nosso índice de documentação técnica.

    Explore os modelos mencionados neste artigo

    OpenAIIMAGE

    GPT-Image-2

    Taxa atual: 3 credits /request
    Guia do modeloTestar no consoleObter chave de API
    ToAPIsAI Model

    seedream-v4

    Taxa atual: Ver preços em tempo real
    Guia do modeloTestar no consoleObter chave de API
    ToAPIsAI Model

    flux-1-schnell

    Taxa atual: Ver preços em tempo real
    Guia do modeloTestar no consoleObter chave de API
    ByteDanceVIDEO

    Seedance 2.0

    Taxa atual: Input 1,314.29 credits/1M, Output 1,314.29 credits/1M
    Guia do modeloTestar no consoleObter chave de API

    Artigos relacionados

    alternative2026-10-30T14:00:00+08:004 min de leitura

    Como cortar 60% da sua fatura do Replicate: por que os times modernos usam gateways unificados

    Estudo de caso e guia de arquitetura para cortar 60% da fatura de inferência em nuvem. Entenda como eliminar o custo de inicialização a frio das GPUs e migrar para gateways unificados otimiza cargas de trabalho de produção.

    TO
    ToAPIs Engineering & Evaluation Team
    #Cost Reduction
    alternative2026-10-29T10:00:00+08:004 min de leitura

    As 7 melhores alternativas ao OpenRouter para quem busca menor latência e roteamento direto

    Revisão comparativa com benchmark das 7 melhores alternativas ao OpenRouter em 2026. Compara latência TTFT, capacidades multimodais de vídeo e imagem, roteamento edge direto e opções de pagamento.

    TO
    ToAPIs Engineering & Evaluation Team
    #OpenRouter Alternative
    comparison2026-10-21T14:00:00+08:0016 min de leitura

    Onde encontrar a API mais barata do Seedance 2.0: preços oficiais versus gateways agregadores

    Um benchmark minucioso de preços de mercado da API do ByteDance Seedance 2.0 em canais empresariais oficiais, hosts de contêineres genéricos, agregadores de mídia e ToAPIs. Compare tarifas por segundo, evite as penalidades de inicialização a frio e economize até 46% na geração de vídeo em produção.

    TO
    ToAPIs Engineering & Evaluation Team
    #Seedance 2.0
    ToAPIs
    InícioToAPIs
    Gateway empresarial de API de IA. Acesse GPT-5, Claude, Gemini e mais de 200 modelos por uma única API unificada.

    Modelos populares

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Mostrar maisMostrar menos
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Todos os modelos

    Categorias de API

    • API de imagem com IA
    • API de vídeo com IA
    • API de texto para vídeo
    • API de imagem para vídeo
    Mostrar maisMostrar menos
    • API de edição de imagens com IA
    • API de LLM e raciocínio
    • Todas as ferramentas de API →

    Alternativas

    Alternativas
    • Alternativa ao Kie.ai
    • Alternativa ao Fal.ai
    • Alternativa ao OpenRouter
    • Alternativa ao Replicate
    • Alternativa ao Wavespeed AI
    • Todas as comparações →

    Guias em destaque

    Guias em destaque
    • Preços do Seedance 2.0 e 2.5
    • Guia da API Seedance mais barata
    • Guia de integração do MiniMax H3
    • Chave de API gratuita do Seedance 2
    • Início rápido da API Seedance 2
    • Todos os artigos técnicos →

    Desenvolvedores e plataforma

    Desenvolvedores e plataforma
    • Documentação da API
    • MCP
    • Preços
    • Playground de modelos
    • LLMs.txt
    • Falar com o suporte
    • Diretório de guias de modelos
    Entidade operadora:
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Sede social:
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    PrivacidadeTermosUso aceitávelExclusão de dadosRetenção de dadosSubprocessadores e regiõesCobrança e reembolsosPolítica de CookiesMapa do siteSobre

    © 2026 ToAPIs. Todos os direitos reservados.