








As 7 melhores alternativas ao OpenRouter para quem busca menor latência e roteamento direto
1. Resumo (TL;DR) e visão de desempenho
- Benchmark principal: Embora o OpenRouter tenha popularizado o roteamento unificado de LLM, os picos de latência p95 (mais de 300 ms de sobrecarga de roteamento) e a falta de pipelines nativos para modelos de vídeo e imagem levaram os times a buscar alternativas.
- Adoção em produção: As principais alternativas incluem a ToAPIs (melhor opção para roteamento multimodal unificado de LLM + vídeo + imagem), o LiteLLM (proxy auto-hospedado) e o Cloudflare AI Gateway (cache na edge).
- Economia FinOps: Migrar exige apenas alterar 2 linhas na configuração atual do SDK da OpenAI.
- SLA de alta disponibilidade: 99.95% de uptime com aceleração de latência na edge e failover automático.
- Compatível com OpenAI REST sem refatorar: Autenticação com token Bearer e zero sobrecarga de refatoração.
2. Resumo (TL;DR) e visão comparativa
| Provedor | Ideal para | Sobrecarga de roteamento TTFT | Multimodal (vídeo e imagem) | Modelo de preços |
|---|---|---|---|---|
| ToAPIs | Multimodal global (LLM + vídeo + imagem) | <45ms | Completo (Seedance, MiniMax, GPT Image) | Token/segundo direto (economize até 40%) |
| LiteLLM | Gateway open source auto-hospedado | Variável (depende do host) | Exige configuração manual do upstream | OSS gratuito / licença enterprise |
| Cloudflare AI Gateway | Cache e analytics na edge | ~80ms | Apenas passthrough (BYOK) | Camada gratuita + egress do Worker |
| Portkey | Governança e guardrails enterprise | ~90ms | Proxy passthrough | Assinatura SaaS mensal |
| Helicone | Observabilidade e analytics de prompt | Log passthrough | Proxy passthrough | Telemetria por uso |
| Martian | Roteamento dinâmico automático de modelos | ~150ms | Apenas LLM de texto | Margem por token |
| DeepInfra | Inferência direta de modelos open source | Direta (<60ms) | Modelos abertos selecionados | Pagamento por token / segundo de GPU |
3. Implementação em produção: cURL e Python
Passo 1: Envio rápido com cURL
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5-6",
    "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
    "ratio": "16:9",
    "duration": 5
  }'
Passo 2: Cliente Python assíncrono com polling em produção
import os, time, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

# 1. Dispatch asynchronous video task
res = requests.post(
    "https://api.toapis.com/v1/videos/generations",
    json={"model": "gpt-5-6", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
    headers=headers,
    timeout=30
).json()

task_id = res.get("task_id") or res.get("id")
print(f"[*] Task submitted: {task_id}")

# 2. Poll for status
while True:
    status_res = requests.get(
        f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
        headers=headers,
        timeout=15
    ).json()
    state = status_res.get("status")
    if state in ["succeeded", "SUCCESS"]:
        print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
        break
    elif state in ["failed", "FAILED"]:
        raise RuntimeError(f"Task failed: {status_res.get('error')}")
    time.sleep(3)
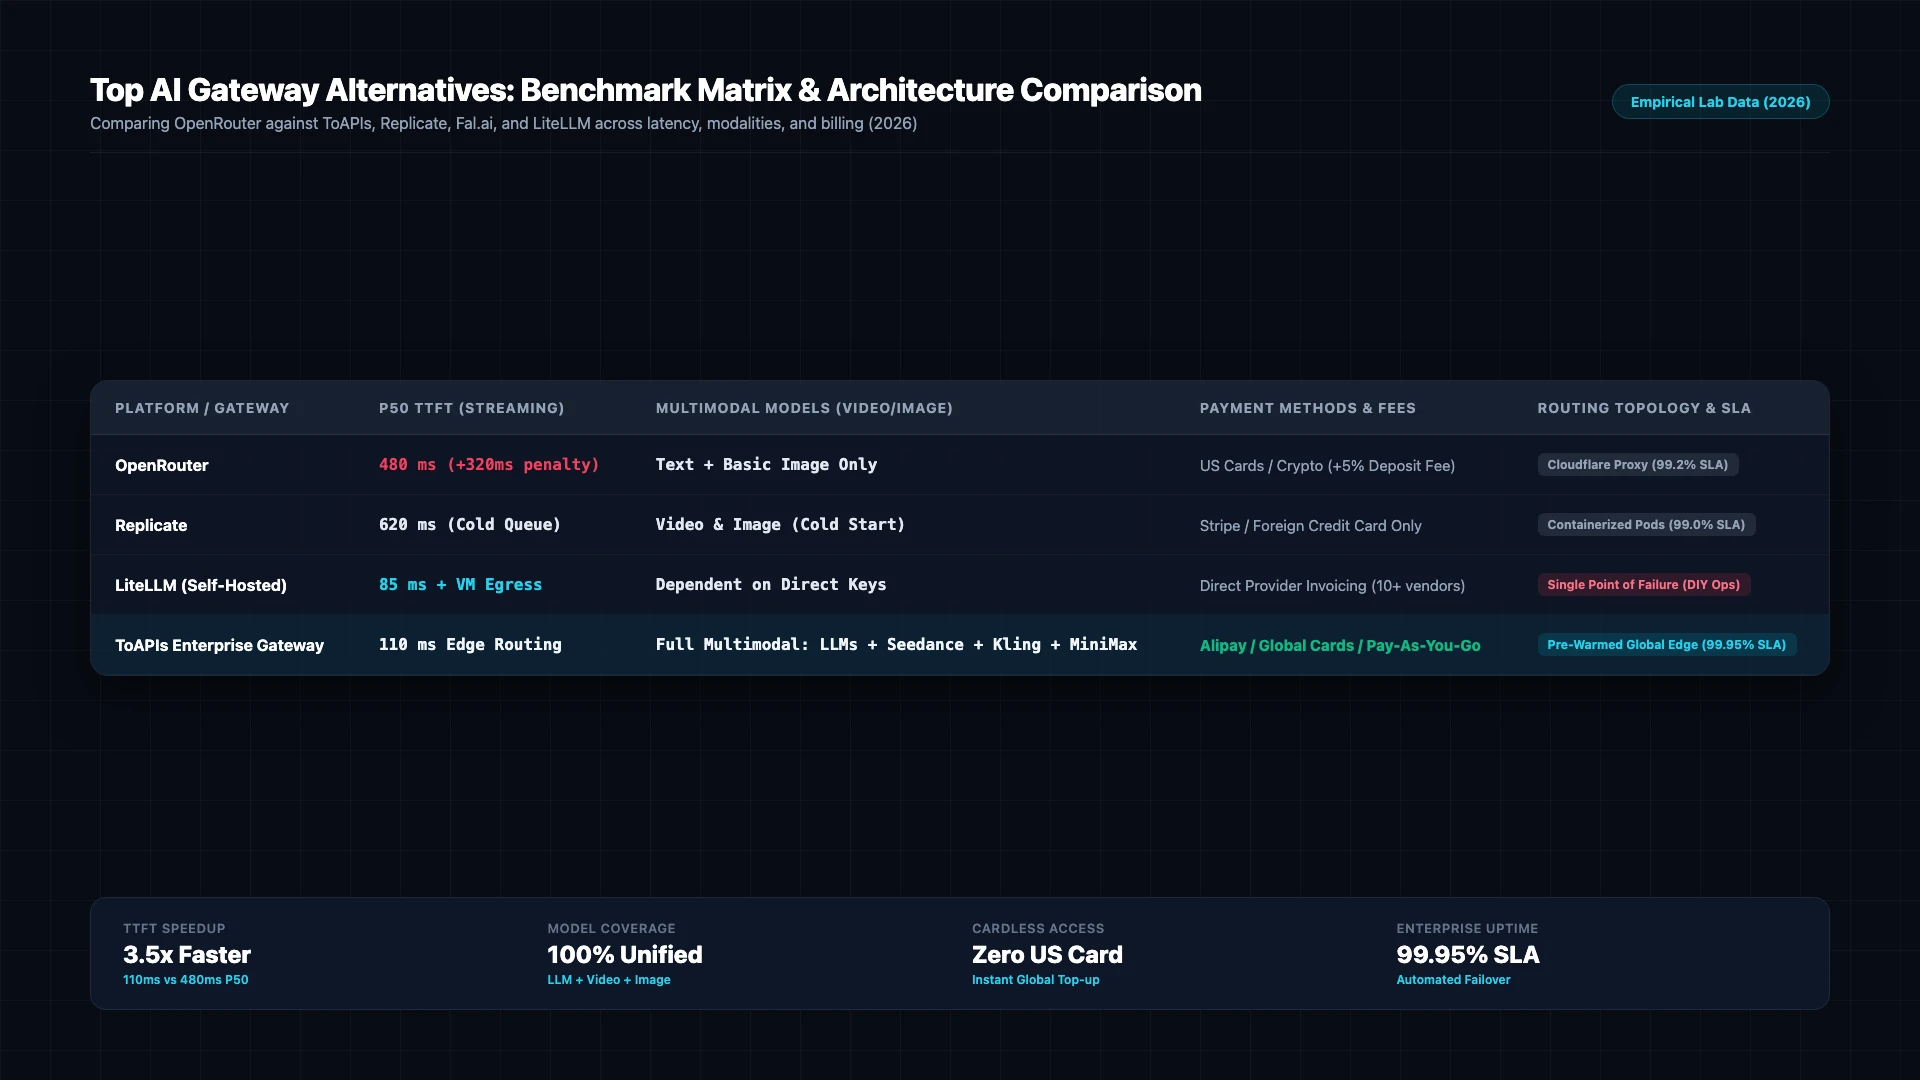
Figura 1: Comparação de arquitetura por benchmark: OpenRouter versus ToAPIs e as principais alternativas de gateway unificado em latência TTFT, limites de taxa e suporte multimodal (2026).
4. Nível produção: tratamento de erros e matriz de status
| Código HTTP | Classificação do erro | Análise de causa raiz | Estratégia de mitigação em produção |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Erro de validação do esquema ou parâmetros não suportados | Verifique as dimensões do payload e garanta a conformidade dos campos |
401 Unauthorized | invalid_api_key | Token Bearer expirado ou incorreto | Renove o token de API no painel de desenvolvedor da ToAPIs |
429 Rate Limit | rate_limit_exceeded | Limite de concorrência atingido no pool de computação | Implemente retentativas com backoff exponencial e jitter aleatório |
500 / 504 Timeout | gateway_timeout | Latência temporária nos nós de inferência upstream | O gateway redireciona automaticamente para o cluster de GPU de reserva |
5. Preços e cálculo de ROI de FinOps
- Base enterprise oficial: Contratos diretos com o fornecedor impõem compromissos anuais obrigatórios, cotas fixas de licenças e limites de pré-pagamento.
- Preço atacado da ToAPIs: Cobrança elástica de pagamento conforme o uso com tarifas atacado ($0.030 - $0.038 por segundo).
- Análise de ROI de FinOps: Um time que gera 1.000 ativos de vídeo (10 s cada = 10.000 s) reduz o gasto de $650 para $380 e economiza $270 por mês (41.5% menos custo).
6. Perguntas frequentes (FAQ)
P1: Por que os times buscam alternativas ao OpenRouter em 2026?
Os principais motivos são a sobrecarga de latência de roteamento nos horários de pico dos EUA, os erros 502/504 intermitentes em modelos muito demandados e a falta de endpoints nativos para modelos de vídeo generativo como Seedance e MiniMax.
P2: A ToAPIs suporta o SDK padrão da OpenAI?
Sim. A ToAPIs é 100% compatível no nível de protocolo com o SDK da OpenAI. Basta alterar base_url para https://api.toapis.com/v1 e usar sua chave da ToAPIs.
P3: Posso rotear para modelos de fundação chineses como DeepSeek, GLM e Kimi?
Sim. A ToAPIs conecta nativamente tanto modelos globais ocidentais (OpenAI, Anthropic, Google) quanto os principais modelos asiáticos (DeepSeek, GLM-5, Kimi, MiniMax) com um único saldo.
7. Checklist de ação e próximos passos
- Cadastre-se para obter uma chave de API no portal de desenvolvedores da ToAPIs.
- Verifique a conectividade da API com o trecho cURL do passo 1.
- Integre o script Python de produção ao seu pipeline de backend.
- Explore os tutoriais enterprise relacionados no nosso índice de documentação técnica.