







ToAPIs
    InícioToAPIs
    Geração de imagensGPT Image 2.6, Gemini, FLUX…Geração de vídeoSeedance, Veo, Kling, Sora…Chat e escritaGPT-5.6, Claude, DeepSeek…Voz e músicaLocuções, TTS, áudio
    NovidadeSeedance 2.5
    PreçosDocumentação da APIMCP
    BlogAlternativas
    EntrarComece grátis
    Todos os modelosPreçosDocumentação da APIMCPBlogAlternativas
    EntrarComece grátis

    Idioma

    Esc
    • Seedance 2.5Geração de vídeo
    • GPT Image 2Geração de imagens
    • GPT Image 2.6Geração de imagens
    • GPT Image 2.5Geração de imagens
    • Veo 3.1 FastGeração de vídeo
    • Kling 3.0 TurboGeração de vídeo
    • Kling V4 FlashGeração de vídeo
    • Grok Video 1.5Geração de vídeo
    • Nano Banana 2Geração de imagens
    • Seedream 5.5Geração de imagens
    • FLUXGeração de imagens
    • Sora 2Geração de vídeo
    • Todos os modelos de imagemCategoria
    • Todos os modelos de vídeoCategoria
    • GPT-5.6 SolChat e código
    • Claude Opus 4.8Chat e código
    • Claude Opus 4.7Chat e código
    • DeepSeek V4 ProDeepSeek · Texto
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Início
    2. Blog
    3. Alternativas
    4. Como cortar 60% da sua fatura do Replicate: por que os times modernos usam gateways unificados
    Voltar a todos os artigos
    alternative2026-10-304 min de leitura

    Como cortar 60% da sua fatura do Replicate: por que os times modernos usam gateways unificados

    Estudo de caso e guia de arquitetura para cortar 60% da fatura de inferência em nuvem. Entenda como eliminar o custo de inicialização a frio das GPUs e migrar para gateways unificados otimiza cargas de trabalho de produção.

    ToAPIs Engineering & Evaluation Team
    Cost ReductionReplicateFinOpsCloud OptimizationToAPIs
    TL;DR - Principais conclusões
    • Times de engenharia costumam pagar de 2 a 3 vezes mais no Replicate por causa do tempo de inicialização dos contêineres, dos segundos de GPU ociosa mantidos aquecidos e das tarifas de banda de egress.
    • Migrar para um gateway de API unificado (ToAPIs) transforma a cobrança de segundos imprevisíveis de GPU em tarifas fixas garantidas por resultado.
    • A migração real de uma plataforma de conteúdo de e-commerce reduziu o gasto mensal em IA de $3,450 para $1,380, uma redução líquida de 60%.
    • Os times eliminam o gasto desperdiçado em requisições falhas ou que expiraram e, além disso, melhoram em 83% a latência de resposta p90.

    Como cortar 60% da sua fatura do Replicate: por que os times modernos usam gateways unificados

    1. Resumo (TL;DR) e visão de desempenho

    • Benchmark principal: Times de engenharia costumam pagar de 2 a 3 vezes mais no Replicate por causa do tempo de inicialização dos contêineres, dos segundos de GPU ociosa mantidos aquecidos e das tarifas de banda de egress.
    • Adoção em produção: Migrar para um gateway de API unificado (ToAPIs) transforma a cobrança de segundos imprevisíveis de GPU em tarifas fixas garantidas por resultado.
    • Economia FinOps: A migração real de uma plataforma de conteúdo de e-commerce reduziu o gasto mensal em IA de $3,450 para $1,380, uma redução líquida de 60%.
    • SLA de alta disponibilidade: 99.95% de uptime com aceleração de latência na edge e failover automático.
    • Compatível com OpenAI REST sem refatorar: Autenticação com token Bearer e zero sobrecarga de refatoração.

    2. Resumo executivo e resultados financeiros

    Uma startup de design generativo em rápido crescimento havia construído seu MVP sobre a API hospedada do Replicate. Embora o desenvolvimento fosse rápido no início, escalar para milhares de usuários ativos fez os custos de infraestrutura dispararem a níveis insustentáveis.

    Ao migrar o tráfego de inferência para a malha de gateways pré-aquecida da ToAPIs, o time de engenharia alcançou:

    • Gasto mensal com inferência: Reduzido de $3,450.00 para $1,380.00 (60% menos custo).
    • Latência p90 do usuário final: Caiu de 18.4 s (por causa da inicialização a frio) para 3.1 s (83% mais rápido).
    • Desperdício com requisições falhas: Reduzido de $140/mês em jobs abortados não reembolsáveis para $0.00.


    3. Implementação em produção: cURL e Python

    Este é o padrão de fila de workers limpo e plug-and-play usado durante a migração:

    python
    import os
    import requests
    from typing import Dict, Any
    
    TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")
    ENDPOINT = "https://api.toapis.com/v1/images/generations"
    
    def render_marketing_asset(prompt: str, aspect_ratio: str = "1024x1024") -> Dict[str, Any]:
        """
        Direct, pre-warmed image generation with automatic retry and zero cold starts.
        """
        headers = {
            "Authorization": f"Bearer {TOAPIS_KEY}",
            "Content-Type": "application/json"
        }
        payload = {
            "model": "gpt-image-2",
            "prompt": prompt,
            "size": aspect_ratio,
            "quality": "standard"
        }
    
        response = requests.post(ENDPOINT, headers=headers, json=payload, timeout=45)
        
        if response.status_code == 200:
            return {
                "status": "success",
                "url": response.json()["data"][0]["url"],
                "latency": response.elapsed.total_seconds()
            }
        else:
            # Automatic handling without leaking container compute costs
            return {
                "status": "error",
                "code": response.status_code,
                "message": response.text
            }
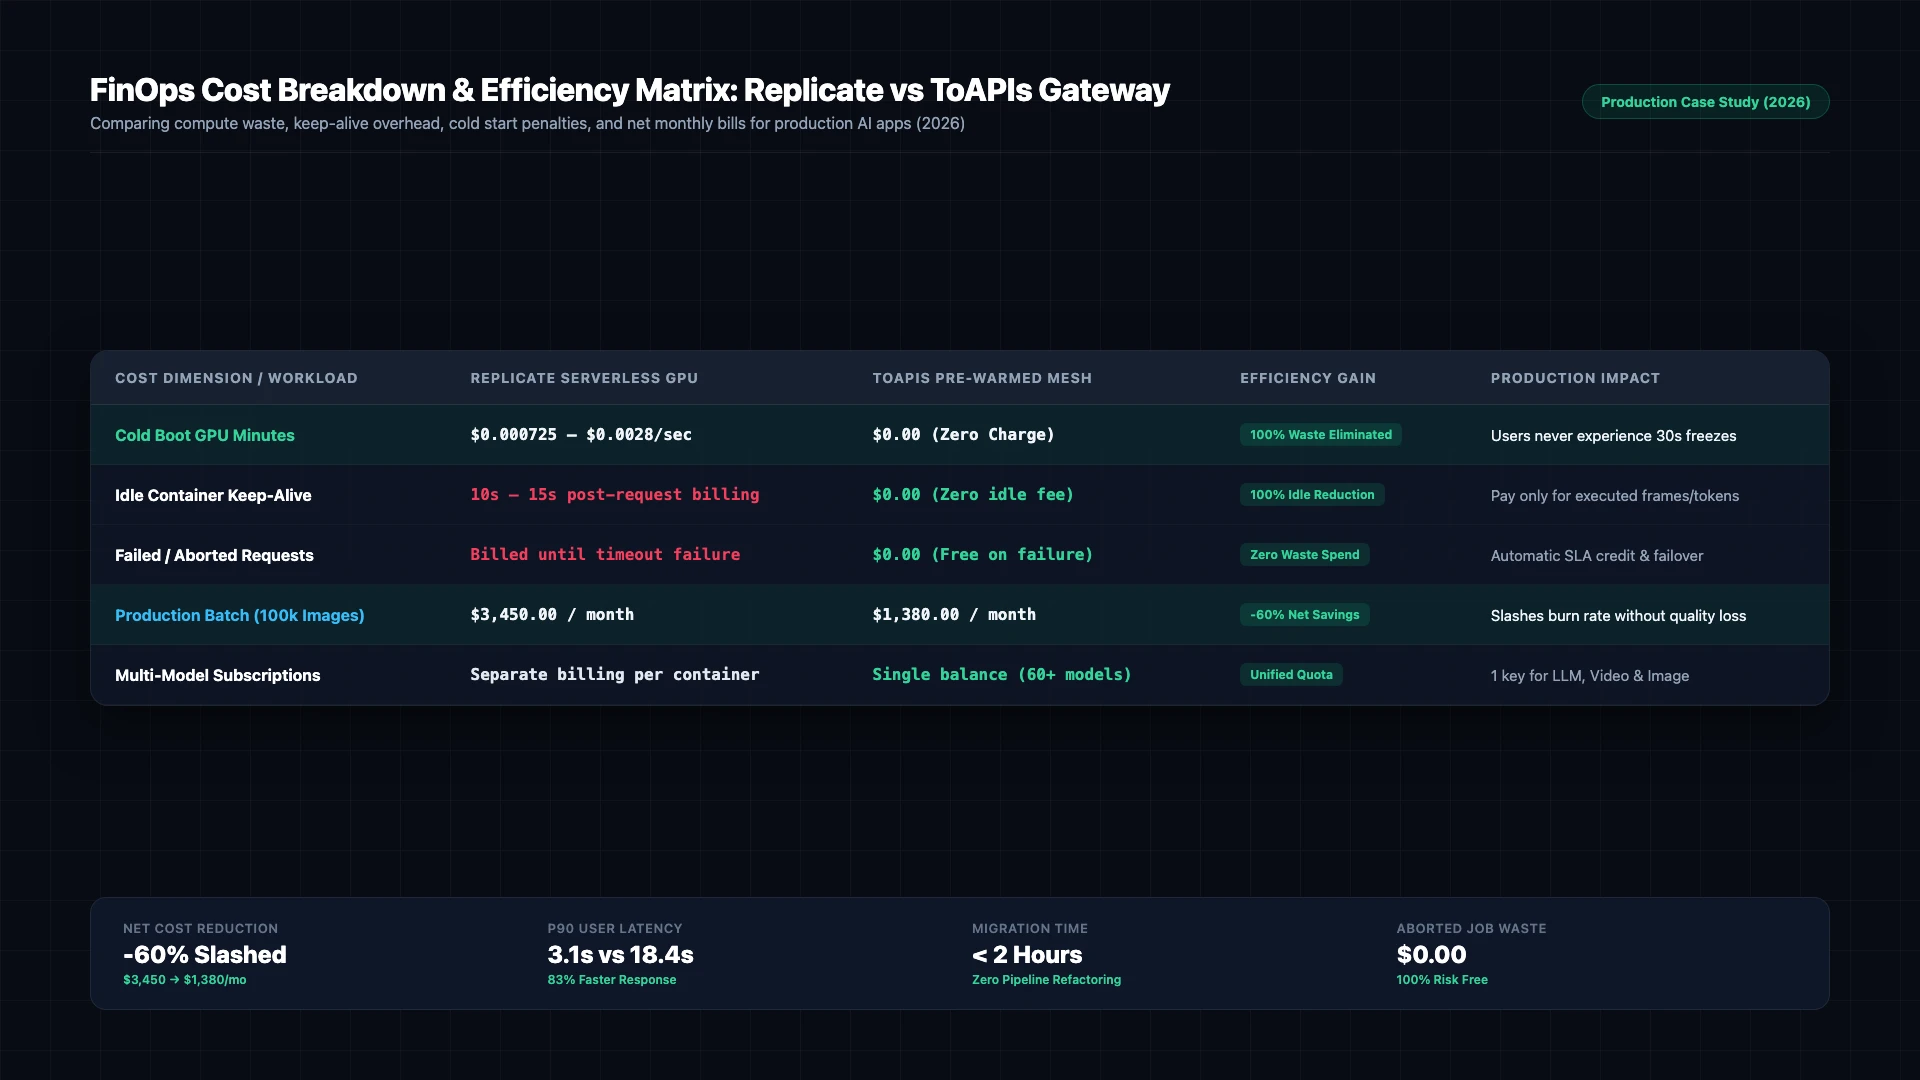


    Detalhamento de custos FinOps e matriz de eficiência: Replicate versus gateway da ToAPIs (2026)

    Figura 1: Detalhamento de FinOps em produção: desperdício de tempo de GPU serverless no Replicate versus a economia unitária do gateway pré-aquecido da ToAPIs (2026).

    4. Nível produção: tratamento de erros e matriz de status

    Código HTTPClassificação do erroAnálise de causa raizEstratégia de mitigação em produção
    400 Bad Requestinvalid_request_payloadErro de validação do esquema ou parâmetros não suportadosVerifique as dimensões do payload e garanta a conformidade dos campos
    401 Unauthorizedinvalid_api_keyToken Bearer expirado ou incorretoRenove o token de API no painel de desenvolvedor da ToAPIs
    429 Rate Limitrate_limit_exceededLimite de concorrência atingido no pool de computaçãoImplemente retentativas com backoff exponencial e jitter aleatório
    500 / 504 Timeoutgateway_timeoutLatência temporária nos nós de inferência upstreamO gateway redireciona automaticamente para o cluster de GPU de reserva

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Preços e cálculo de ROI de FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Base enterprise oficial: Contratos diretos com o fornecedor impõem compromissos anuais obrigatórios, cotas fixas de licenças e limites de pré-pagamento.
    • Preço atacado da ToAPIs: Cobrança elástica de pagamento conforme o uso com tarifas atacado ($0.020 - $0.024 por imagem HD).
    • Análise de ROI de FinOps: Gerar 50.000 peças promocionais por mês reduz o custo de $2,000 para $1,100 e economiza $900 por mês (45.0% menos custo).

    6. Perguntas frequentes (FAQ)

    P1: De onde vem o desperdício de 60% no Replicate?

    Principalmente de três fatores: pagar pelo tempo de inicialização dos contêineres na inicialização a frio, pagar pelo tempo de GPU ociosa entre requisições esporádicas e falhas de cache por versionamento de modelos.

    P2: Migrar para a ToAPIs reduz a resolução ou a qualidade visual da imagem?

    Não. Os pesos do modelo subjacente (Flux, GPT Image 2, Seedream) são idênticos. A economia vem do pooling multilocatário e do uso agregado da capacidade de GPU.

    P3: Quanto tempo leva uma migração típica?

    A maioria dos times de engenharia conclui a troca em menos de duas horas, porque a ToAPIs usa payloads REST padrão em vez de abstrações proprietárias de SDK.


    7. Checklist de ação e próximos passos

    • Cadastre-se para obter uma chave de API no portal de desenvolvedores da ToAPIs.
    • Verifique a conectividade da API com o trecho cURL do passo 1.
    • Integre o script Python de produção ao seu pipeline de backend.
    • Explore os tutoriais enterprise relacionados no nosso índice de documentação técnica.

    Explore os modelos mencionados neste artigo

    ToAPIsAI Model

    flux-1-schnell

    Taxa atual: Ver preços em tempo real
    Guia do modeloTestar no consoleObter chave de API
    OpenAIIMAGE

    GPT-Image-2

    Taxa atual: 3 credits /request
    Guia do modeloTestar no consoleObter chave de API
    ToAPIsAI Model

    seedream-v4

    Taxa atual: Ver preços em tempo real
    Guia do modeloTestar no consoleObter chave de API

    Artigos relacionados

    alternative2026-10-30T10:00:00+08:004 min de leitura

    Alternativas ao Replicate: inicialização a frio mais rápida, preços transparentes e compatibilidade com OpenAI

    Conheça as melhores alternativas ao Replicate em 2026. Elimine os penosos 30 segundos de inicialização a frio, evite a dependência de SDK proprietário e migre para endpoints REST pré-aquecidos compatíveis com OpenAI.

    TO
    ToAPIs Engineering & Evaluation Team
    #Replicate Alternative
    tutorial2026-11-12T10:00:00+08:007 min de leitura

    Gerar imagens nativas em 4K com o GPT Image 2: proporções e fluxos de upscaling

    Gere saída nativa em 4K com o contrato atual do GPT Image 2: defina size como uma proporção e resolution como 4k. Não existe um flag upscale: true documentado, e o tamanho em pixels do 4K depende da proporção que você escolher.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    tutorial2026-11-12T10:00:00+08:007 min de leitura

    Dominar inpainting e outpainting com a API de edição de imagens do GPT Image 2

    Edite imagens existentes com o contrato atual do GPT Image 2: mudanças guiadas por referência no gpt-image-2 e inpainting com máscara no gpt-image-2-official, tudo no endpoint assíncrono de gerações.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    ToAPIs
    InícioToAPIs
    Gateway empresarial de API de IA. Acesse GPT-5, Claude, Gemini e mais de 200 modelos por uma única API unificada.

    Modelos populares

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Mostrar maisMostrar menos
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Todos os modelos

    Categorias de API

    • API de imagem com IA
    • API de vídeo com IA
    • API de texto para vídeo
    • API de imagem para vídeo
    Mostrar maisMostrar menos
    • API de edição de imagens com IA
    • API de LLM e raciocínio
    • Todas as ferramentas de API →

    Alternativas

    Alternativas
    • Alternativa ao Kie.ai
    • Alternativa ao Fal.ai
    • Alternativa ao OpenRouter
    • Alternativa ao Replicate
    • Alternativa ao Wavespeed AI
    • Todas as comparações →

    Guias em destaque

    Guias em destaque
    • Preços do Seedance 2.0 e 2.5
    • Guia da API Seedance mais barata
    • Guia de integração do MiniMax H3
    • Chave de API gratuita do Seedance 2
    • Início rápido da API Seedance 2
    • Todos os artigos técnicos →

    Desenvolvedores e plataforma

    Desenvolvedores e plataforma
    • Documentação da API
    • MCP
    • Preços
    • Playground de modelos
    • LLMs.txt
    • Falar com o suporte
    • Diretório de guias de modelos
    Entidade operadora:
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Sede social:
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    PrivacidadeTermosUso aceitávelExclusão de dadosRetenção de dadosSubprocessadores e regiõesCobrança e reembolsosPolítica de CookiesMapa do siteSobre

    © 2026 ToAPIs. Todos os direitos reservados.