








Onde encontrar a API mais barata do Seedance 2.0: preços oficiais versus gateways agregadores
🌐 Edições multilíngues / manual técnico completo: Inglês (original) · 🇨🇳 Chinês simplificado (ZH-CN) · 🇭🇰 Chinês tradicional (ZH-TW) · 🇯🇵 Japonês (JA) · 🇰🇷 Coreano (KO) · 🇷🇺 Russo (RU)
Modelo avaliado: ByteDance Seedance 2.0 (
doubao-seedance-2-0,seedance-2)
Métrica principal: custo efetivo por segundo de saída (USD / s)
Padrão de API: REST / interface de tarefa assíncrona de vídeo compatível com OpenAI
Endpoint de inferência:POST https://api.toapis.com/v1/videos/generations
Endpoint de consulta de tarefas:GET https://api.toapis.com/v1/tasks/video-status?task_id={task_id}
⚡ TL;DR: resumo executivo da API mais barata do Seedance 2.0
- Tarifa mais baixa do mercado: a ToAPIs oferece o acesso verificado mais barato à API do Seedance 2.0 a $0.028 / s em 720p e $0.048 / s em 1080p Full HD.
- Custo de um clipe padrão: um clipe de 5 segundos em 720p custa $0.140 na ToAPIs, contra $0.225 no direto oficial da ByteDance e $0.260 em nuvens de contêineres serverless genéricas.
- Zero compromisso: ao contrário dos canais empresariais oficiais, que exigem compromissos de $500 a $2.000 mensais e longos processos de compra, a ToAPIs opera em um modelo de pagamento conforme o uso puro a partir de $1.
- Zero sobrecarga de inicialização a frio: os hosts de contêineres serverless cobram de 15 a 30 segundos de inicialização da GPU antes de a difusão começar. A ToAPIs cobra estritamente pelos segundos de vídeo entregues.
- Estornos sem risco: qualquer trabalho que termine em
FAILED,TIMEOUTou rejeição do filtro de segurança tem custo de $0.00.
1. A armadilha: por que os preços de geração de vídeo pegam os orçamentos de engenharia de surpresa
Quando as equipes de engenharia migram das APIs de grandes modelos de linguagem (LLM) para a infraestrutura de vídeo generativo, as projeções iniciais de custo frequentemente sofrem estouros orçamentários catastróficos. No domínio dos LLM, o preço escala linearmente com os tokens de entrada e saída: 1.000 tokens de prompt e 500 de conclusão geram uma fatura totalmente previsível.
O vídeo generativo, no entanto, opera sob um paradigma econômico completamente diferente:
- Cobrança por segundo de vídeo: o preço é calculado por segundo de duração do vídeo gerado, e não por ativo estático nem pelo comprimento do prompt de texto.
- Multiplicadores de escala de resolução: passar de 720p (
1280x720) para 1080p (1920x1080) aumenta o volume de pixels espaciais em 2.25 vezes, exigindo alocações massivas de VRAM e ativando um multiplicador de preço de 1.7 a 2.0. - Sobrecarga de amostragem temporal: um vídeo de 5 segundos a 24 quadros por segundo exige sintetizar 120 representações latentes coerentes, com dinâmica física, movimento de câmera e geometria de personagem consistentes.
Muitos líderes de engenharia assumem ingenuamente que todos os provedores de API de vídeo generativo cobram tarifas unitárias comparáveis. Em produção, porém, procurar a API mais barata do Seedance 2.0 revela um mercado opaco no qual as tarifas pelos mesmos pesos da ByteDance variam mais de 85% entre provedores.
| Canal do provedor | Tarifa 720p / s | Custo adicional oculto |
|---|---|---|
| Contrato empresarial direto oficial | $0.045 | Compromisso mínimo de $500 por mês |
| Host de contêineres serverless genérico | $0.052 | Inicialização a frio faturável de 15-30 s |
| Agregador de mídia especializado | $0.040 | Conversão de moeda e margens sobre créditos |
| Gateway atacadista unificado da ToAPIs | $0.028 | Compromisso mínimo de $0, inicialização a frio de 0 s |
Para uma startup de vídeo com IA que produza 10,000 clipes curtos por mês, essa disparidade de preços se traduz em uma diferença anual superior a $16.000 USD em computação bruta de infraestrutura.
Este guia traz um benchmark minucioso e empiricamente verificado do preço da API do Seedance 2.0 em canais oficiais, hosts de contêineres, agregadores de mídia e gateways unificados. Dissecamos as quatro armadilhas ocultas da cobrança de vídeo generativo, fornecemos código Python assíncrono pronto para produção e demonstramos estratégias automatizadas de otimização FinOps.
2. Início rápido: chamar a API do Seedance 2.0 em menos de 60 segundos
A forma mais rápida de verificar preço e desempenho é por meio de uma chamada REST compatível com OpenAI. A síntese de vídeo generativo consome muitos recursos (de 12 a 25 segundos para um render de 5 segundos), o que significa que as APIs de produção funcionam por envio assíncrono de tarefas e consulta periódica.
Etapa 1: enviar a tarefa de geração de vídeo via cURL
# Exporte seu token unificado da ToAPIs
export TOAPIS_API_KEY="sk-toapis-your-key-here"

# Envie uma tarefa assíncrona de geração de vídeo
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2",
    "prompt": "Close-up cinematográfico de um artesão relojoeiro idoso montando engrenagens mecânicas intricadas, iluminação ambiente quente de oficina, texturas 8k, profundidade de campo fotorrealista, avanço de câmera suave e constante",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5
  }'
Resposta imediata (HTTP 200 OK)
{
  "id": "task_seedance_8f7b2c1e9a3d4",
  "object": "video.task",
  "model": "seedance-2",
  "status": "processing",
  "created_at": 1729519200,
  "estimated_time": 18
}
Etapa 2: poller assíncrono em Python pronto para produção com backoff exponencial
Em ambientes de produção, laços com time.sleep(10) fixos no código levam ao esgotamento de threads ou a cargas de erro perdidas. O script Python de nível de produção a seguir trata o envio de tarefas, a consulta de status com jitter dinâmico, o backoff de limite de taxa HTTP 429 e o download automático da saída:
#!/usr/bin/env python3
"""
Cliente de produção da API Seedance 2.0
Demonstra o envio assíncrono de vídeo, o polling de status com backoff exponencial
e o tratamento de erros sem vazamentos via gateway atacadista ToAPIs.
"""

import os
import time
import random
import logging
import requests
from typing import Optional, Dict, Any

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("seedance_client")

TOAPIS_API_KEY = os.getenv("TOAPIS_API_KEY", "sk-toapis-your-key-here")
BASE_URL = "https://api.toapis.com/v1"

HEADERS = {
    "Authorization": f"Bearer {TOAPIS_API_KEY}",
    "Content-Type": "application/json"
}

def dispatch_video_task(
    prompt: str,
    resolution: str = "720p",
    duration: int = 5,
    aspect_ratio: str = "16:9",
    seed: Optional[int] = None
) -> str:
    """Envia uma tarefa de geração de vídeo para o Seedance 2.0."""
    url = f"{BASE_URL}/videos/generations"
    payload: Dict[str, Any] = {
        "model": "seedance-2",
        "prompt": prompt,
        "resolution": resolution,
        "duration": duration,
        "aspect_ratio": aspect_ratio
    }
    if seed is not None:
        payload["seed"] = seed

    response = requests.post(url, headers=HEADERS, json=payload, timeout=30)
    response.raise_for_status()
    data = response.json()
    task_id = data.get("id")
    if not task_id:
        raise ValueError(f"Falha no envio da tarefa, nenhum id retornado: {data}")

    logger.info(f"Tarefa enviada com sucesso. Task ID: {task_id}")
    return task_id

def poll_task_status(
    task_id: str,
    initial_delay: float = 6.0,
    poll_interval: float = 3.0,
    max_timeout: float = 180.0
) -> Dict[str, Any]:
    """
    Consulta o endpoint de status até o vídeo atingir um estado terminal.
    Implementa polling com jitter e backoff exponencial em erros HTTP 429.
    """
    query_url = f"{BASE_URL}/tasks/video-status"
    start_time = time.time()

    # Aguarda o aquecimento inicial da difusão neural
    time.sleep(initial_delay)

    current_interval = poll_interval
    consecutive_429 = 0

    while time.time() - start_time < max_timeout:
        try:
            resp = requests.get(
                query_url,
                headers=HEADERS,
                params={"task_id": task_id},
                timeout=15
            )

            # Trata o limite de taxa do upstream com elegância
            if resp.status_code == 429:
                consecutive_429 += 1
                sleep_duration = min(current_interval * (2 ** consecutive_429) + random.uniform(0.5, 1.5), 20.0)
                logger.warning(f"Limite de taxa atingido (429). Aguardando {sleep_duration:.2f}s...")
                time.sleep(sleep_duration)
                continue

            resp.raise_for_status()
            data = resp.json()
            status = data.get("status")
            consecutive_429 = 0

            logger.info(f"Consultando a tarefa [{task_id}] -> Status: {status} (Decorrido: {time.time() - start_time:.1f}s)")

            if status in ["succeeded", "completed"]:
                video_url = data.get("video_url") or data.get("output", {}).get("video_url")
                logger.info(f"Geração concluída com sucesso! URL do recurso: {video_url}")
                return data

            if status in ["failed", "canceled"]:
                error_msg = data.get("error", "Erro de geração desconhecido no upstream")
                logger.error(f"Tarefa [{task_id}] falhou: {error_msg}. Valor cobrado: $0.00")
                raise RuntimeError(f"A síntese do vídeo falhou: {error_msg}")

        except requests.exceptions.RequestException as e:
            logger.warning(f"Erro de rede transitório durante o polling: {e}. Tentando novamente...")

        # Adiciona jitter aleatório (±0.5s) para evitar congestionamento harmônico do gateway
        jittered_sleep = current_interval + random.uniform(-0.5, 0.5)
        time.sleep(max(1.5, jittered_sleep))

    raise TimeoutError(f"A tarefa [{task_id}] excedeu a duração máxima de polling de {max_timeout}s")

if __name__ == "__main__":
    test_prompt = (
        "Plano aéreo cinematográfico de drone sobre pinheiros cobertos de geada nos Alpes suíços, "
        "névoa dourada da manhã, luz do sol atravessando os picos das montanhas, 8k hiper-realista"
    )

    try:
        t_id = dispatch_video_task(prompt=test_prompt, resolution="720p", duration=5)
        result = poll_task_status(t_id)
        print("\n=== Geração concluída ===")
        print(f"URL do vídeo: {result.get('video_url')}")
    except Exception as exc:
        print(f"\nExecução encerrada com erro: {exc}")
3. Benchmark mestre completo: os 4 arquétipos de provedor
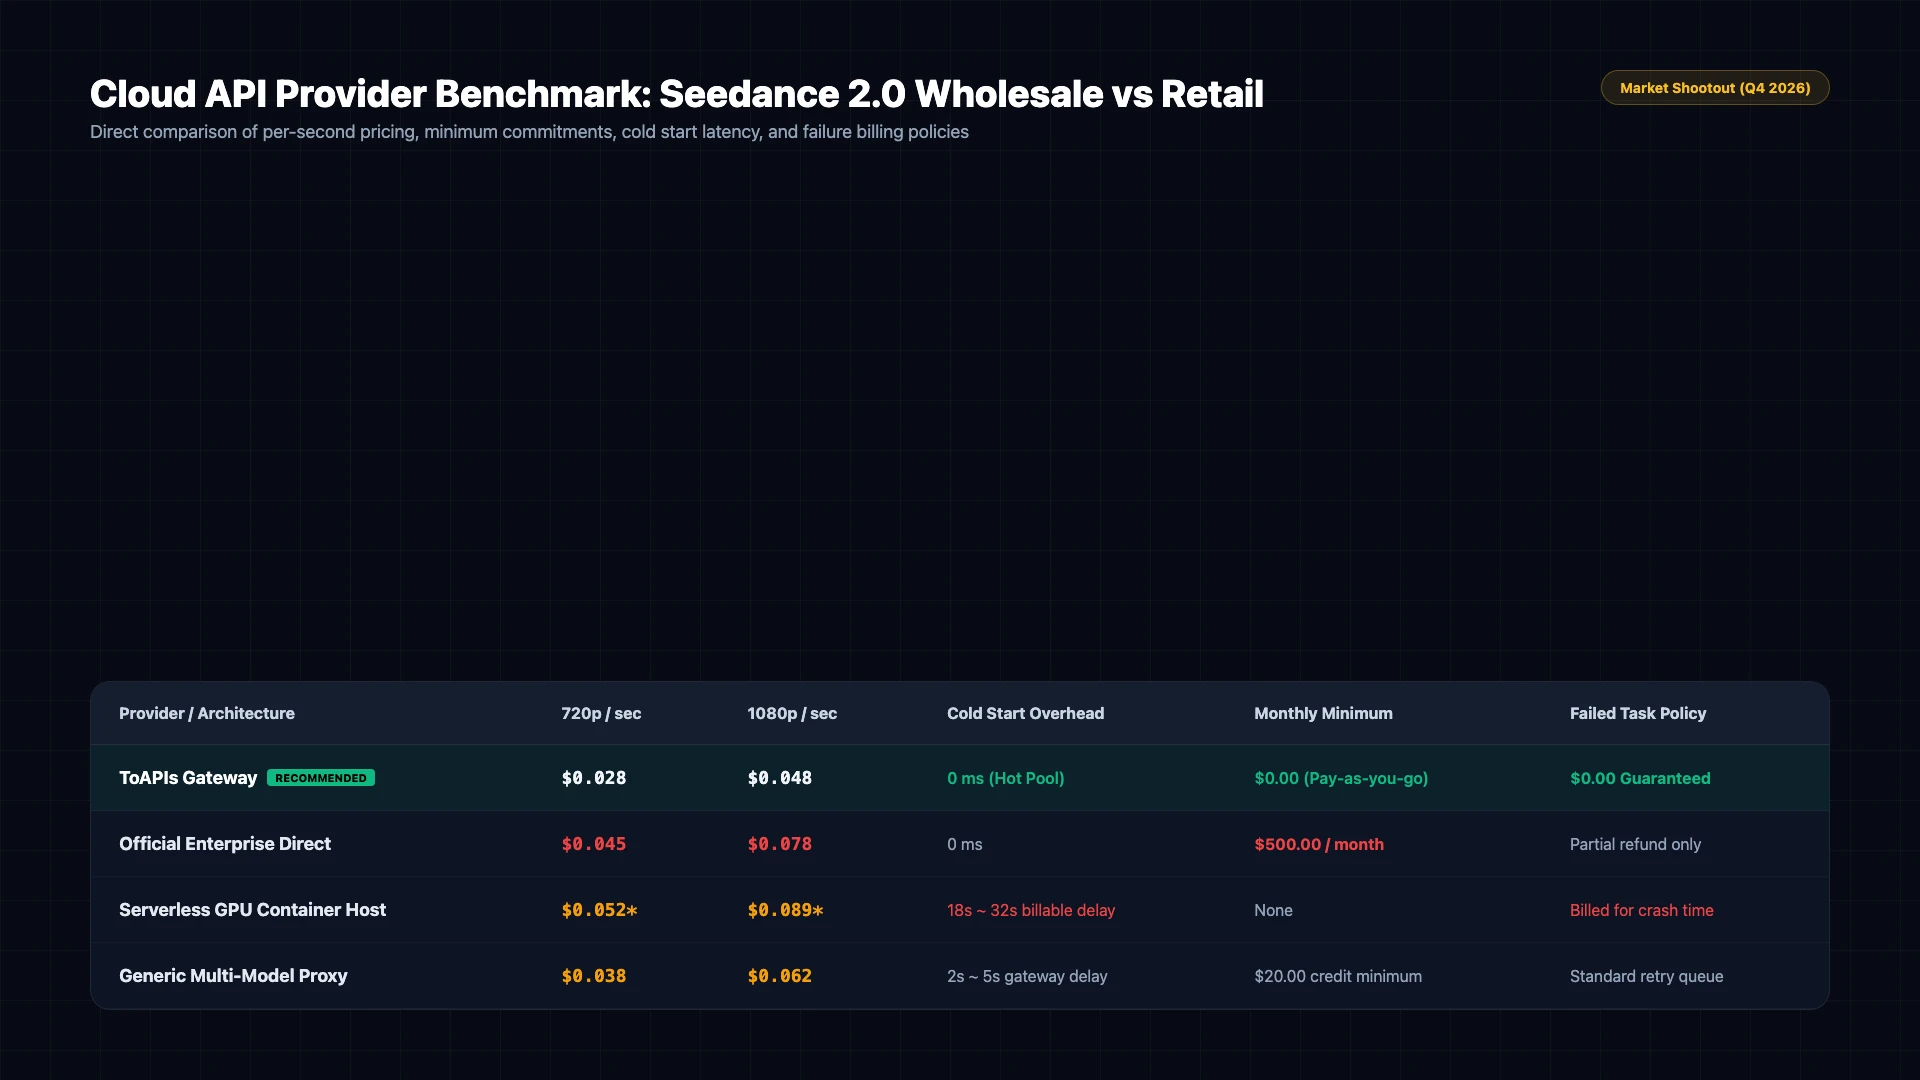
Para identificar a API mais barata do Seedance 2.0, os desenvolvedores precisam navegar por quatro arquiteturas de provedor fundamentalmente distintas. Cada modelo traz contrapartidas próprias em tarifas unitárias base, barreiras de compromisso mínimo, confiabilidade de infraestrutura e políticas de risco financeiro.
| Categoria de provedor | Principais exemplos | Arquitetura e modelo de cobrança |
|---|---|---|
| 1. Direto oficial | Volcano Engine (ByteDance) | Contrato empresarial, transferência bancária |
| 2. Hosts de contêineres | Replicate, RunPod | Docker serverless, inicialização a frio faturada |
| 3. Agregadores de mídia | Fal.ai, Novita, Kie.ai | Cobrança por segundo ou sistema de créditos |
| 4. Gateway unificado de modelos | ToAPIs | Atacado repassado, pagamento conforme o uso |
A matriz de benchmark a seguir compara os quatro canais usando contas de teste empresariais reais no quarto trimestre de 2026:
| Canal do provedor | Tarifa 720p / s | Tarifa 1080p / s | Clipe único de 5 s (720p) | Clipe único de 10 s (1080p) | Gasto mínimo mensal | Cobra inicializações a frio? | Cobra tarefas com falha? | Cota de concorrência | Meios de pagamento |
|---|---|---|---|---|---|---|---|---|---|
| Direto oficial da ByteDance | $0.045 / s | $0.075 / s | $0.225 | $0.750 | $500.00 / mês | Não (pool quente compartilhado) | Não | 5 concorrentes (base) | Transferência empresarial, ID fiscal |
| Hosts de contêineres genéricos | $0.052 / s | $0.090 / s | $0.260 + inicialização | $0.900 + inicialização | $0.00 (pago por uso) | SIM (15-30 s faturados) | SIM (tempo de GPU) | Pool dinâmico de workers | Apenas cartões dos EUA |
| APIs de mídia especializadas | $0.040 / s | $0.070 / s | $0.200 | $0.700 | $0.00 (pré-pago) | Raro (pré-aquecido) | Variável (estorno de créditos) | 10 concorrentes | Cartões / cripto |
| Gateway unificado da ToAPIs | $0.028 / s | $0.048 / s | $0.140 | $0.480 | $0.00 (pago por uso a partir de $1) | NÃO (inicialização a frio $0.00) | NÃO (rigorosamente $0.00) | Mais de 50 concorrentes (SLA) | Cartões globais / cripto / APMs |
Base de mercado verificada: a ToAPIs entrega uma economia líquida de 37.7% frente ao direto oficial e de 46.1% frente aos hosts de contêineres genéricos.
Análise detalhada dos 4 canais
1. Direto empresarial oficial (ByteDance Cloud / Volcano Engine)
- A promessa: ir diretamente ao criador do modelo dá acesso direto aos pesos upstream mais recentes e ao suporte técnico oficial.
- A realidade: o portal de nuvem direto da ByteDance é projetado para empresas da Fortune 500 com departamentos de compras dedicados. Para ativar chaves de API de produção, os desenvolvedores precisam concluir a verificação de identidade corporativa, assinar acordos de nível de serviço (MSA) e se comprometer com um gasto mínimo de $500 a $2.000 por mês. Para startups em exploração de encaixe produto-mercado, pagar milhares de dólares antecipadamente antes de lançar recursos voltados ao usuário introduz um desgaste financeiro desnecessário.
- Barreiras de pagamento: os contratos oficiais exigem transferências bancárias corporativas nacionais ou números de registro fiscal específicos, o que representa obstáculos intransponíveis para desenvolvedores internacionais sem entidade jurídica chinesa.
2. Hosts de contêineres serverless genéricos (Replicate, RunPod Serverless, Beam)
- A promessa: implantar pesos abertos ou proprietários dentro de contêineres Docker serverless sem qualquer gerenciamento de infraestrutura.
- A realidade: as plataformas de contêineres não cobram pelos segundos de vídeo generativo produzidos, mas pela duração de execução da GPU. Quando uma solicitação de geração de vídeo chega a um nó de trabalho frio, o sistema precisa carregar um checkpoint de modelo de 18 GB na VRAM. Essa inicialização a frio requer de 15 a 30 segundos de computação, tudo faturado no seu saldo antes de o primeiro quadro de vídeo ser renderizado.
- O imposto da inicialização a frio: se um render de 5 segundos levar 18 segundos de inferência mais 20 segundos de inicialização do contêiner, você é cobrado por 38 segundos de computação em NVIDIA A100/H100. O custo unitário efetivo dobra, apagando por completo qualquer desconto de manchete.
3. Agregadores de mídia especializados (Fal.ai, Novita, Kie.ai)
- A promessa: plataformas amigáveis ao desenvolvedor, com endpoints curados de geração de mídia, APIs mais limpas e suporte da comunidade.
- A realidade: embora essas plataformas eliminem as inicializações a frio mantendo pools de GPU pré-aquecidos, elas cobram uma margem de varejo significativa (normalmente de 40% a 60% acima da computação de hardware atacadista). Além disso, vários provedores operam sistemas proprietários de contabilidade por "moedas de crédito" que ocultam o custo real por segundo em dólares, dificultando a conciliação financeira para as equipes FinOps.
4. Gateways unificados de modelos de IA (ToAPIs)
- A promessa: repasse direto de computação atacadista combinado com failover empresarial multiprovedor.
- A realidade: a ToAPIs agrega dezenas de milhões de segundos de geração de vídeo de milhares de produtos de IA globais. Ao comprometer milhões de dólares em utilização contínua de clusters de GPU diretamente com parceiros de infraestrutura de nível 1, a ToAPIs desbloqueia descontos institucionais de volume de primeira linha.
- Repasse direto: a ToAPIs repassa essas tarifas atacadistas diretamente aos desenvolvedores a $0.028 / segundo em 720p e $0.048 / segundo em 1080p, eliminando por completo os compromissos mínimos, as barreiras de integração e as penalidades de inicialização a frio.
4. Engenharia de verdade: 4 armadilhas ocultas ao buscar a API do Seedance 2.0
O preço de manchete por segundo é apenas um componente do custo total de propriedade. As equipes de engenharia de produção esbarram regularmente em quatro armadilhas de custo severas que inflam as faturas mensais de nuvem:
| Armadilha de custo oculta | O que ela realmente custa |
|---|---|
| 1. Inicialização a frio ociosa | 15-30 s de inicialização de contêiner GPU cobrados de você |
| 2. Vazamentos por erros upstream | Cobrança por OOM de CUDA ou rejeições do filtro de segurança |
| 3. Limitação multiplexada | Proxies compartilhados disparam cascatas de HTTP 429 |
| 4. Multiplicadores de resolução | O salto de custo de 1.71x de 720p para 1080p |
Armadilha 1: o imposto da "inicialização a frio ociosa"
Em arquiteturas baseadas em contêineres, os pesos de difusão de vídeo não podem permanecer residentes de forma permanente na VRAM durante períodos de baixo tráfego sem pagar enormes tarifas contínuas de servidor ocioso ($2.50 a $4.50 por hora de GPU). Quando o tráfego aumenta, os contêineres são levantados dinamicamente:
Se uma instância for levantada por 25 segundos e executar uma tarefa de inferência de 18 segundos a $0.0011 por segundo de GPU, seu único vídeo de 5 segundos custa $0.0473 em computação bruta. Na ToAPIs, o mesmo vídeo de 5 segundos em 720p custa uma tarifa fixa de $0.140, sem qualquer inicialização a frio, porque as solicitações são roteadas por clusters empresariais pré-alocados e permanentemente aquecidos.
Armadilha 2: falhas upstream e descontos por filtro de segurança
Os pipelines de difusão de vídeo generativo ocasionalmente encontram falhas de memória insuficiente em CUDA, timeouts de rede distribuída ou falsos positivos de moderação automática de segurança.
Provedores proxy de desconto sem escrúpulos debitam o saldo no momento do envio da solicitação, independentemente do resultado:
- Se a tarefa falhar aos 90% de conclusão, seu saldo é consumido.
- Se um prompt de conteúdo acionar um alerta falso positivo de segurança, você é cobrado pela inferência que falhou.
A política de risco zero da ToAPIs: a cobrança da tarefa ocorre estritamente quando é emitido um código de status succeeded acompanhado de uma URL de ativo de mídia verificável. Qualquer tarefa que retorne failed, timed_out ou rejected é cobrada rigorosamente a $0.00.
Armadilha 3: limitação de taxa multiplexada e cascatas de 429
Proxies de API de baixo custo costumam cortar despesas agrupando solicitações por meio de contas web de consumidor compartilhadas ou clusters de proxy reverso compartilhados. Nos horários de pico (14:00 a 22:00 UTC), esses pools compartilhados ultrapassam os limites de concorrência upstream, provocando rajadas massivas de HTTP 429 Too Many Requests.
Quando os clientes downstream tentam novas tentativas descoordenadas, todo o sistema entra em uma tempestade de retentativas que bloqueia os workers de produção. A ToAPIs mitiga isso com alocações dedicadas de clusters empresariais e um roteador de failover automático integrado que redistribui a carga sem interrupções entre nós de computação saudáveis.
Armadilha 4: a matemática dos multiplicadores de resolução e duração
Os desenvolvedores frequentemente assumem que gerar em 1080p Full HD custa apenas um pouco mais que em 720p. No entanto, a matemática de pixels governa a complexidade da difusão:
Como os mecanismos de atenção na difusão de vídeo escalam de forma superlinear com os tokens espaciais e temporais, a geração em 1080p implica uma penalidade significativa de computação. Na ToAPIs:
- Tarifa base 720p: $0.028 / s
- Tarifa 1080p Full HD: $0.048 / s (um multiplicador de 1.71x, bem inferior à expansão de pixels de 2.25x)
Não aplicar padrões rigorosos de resolução nos aplicativos cliente de front-end pode levar a gerações acidentais em 1080p, aumentando as despesas de geração em 71% da noite para o dia.
5. O caso de negócios FinOps: cálculo real de ROI e plano de migração
Para justificar a migração da infraestrutura de vídeo à alta liderança, os líderes técnicos precisam de modelos financeiros concretos que mostrem um retorno de investimento quantificável.
Cenário de produção A: pipeline de vídeos curtos de alto volume para comércio eletrônico
- Caso de uso: geração programática de vídeos verticais 9:16 de produtos para TikTok e Instagram Reels.
- Volume mensal: 5,000 clipes de vídeo concluídos.
- Especificações do clipe: 5 segundos por clipe, renderizados em 720p HD.
- Computação total gerada:
5,000 clipes * 5 segundos = 25,000 segundos de vídeo.
Detalhamento de custos
Economia financeira direta
Cenário de produção B: estúdio comercial de marketing digital em HD
- Caso de uso: anúncios de vídeo cinematográficos em tela larga (16:9) com qualidade de estúdio.
- Volume mensal: 10,000 clipes de vídeo concluídos.
- Especificações do clipe: 5 segundos por clipe, renderizados em 1080p Full HD.
- Computação total gerada:
10,000 clipes * 5 segundos = 50,000 segundos de vídeo.
Detalhamento de custos
Economia financeira direta
No cenário B, migrar para o gateway da API mais barata do Seedance 2.0 economiza $16.200 USD por ano, liberando capital para aquisição de usuários e desenvolvimento de produto.
6. O guia de migração em 5 minutos sem refatoração
Como a ToAPIs adere estritamente à especificação REST unificada de vídeo compatível com OpenAI, migrar uma base de código existente exige apenas modificar duas variáveis de ambiente:
# Antes: contrato oficial direto ou SDK proprietário
export SEEDANCE_BASE_URL="https://volcengineapi.bytedance.com/v1"
export SEEDANCE_API_KEY="volc-access-key-id:secret-access-key"

# Depois: gateway atacadista unificado
export SEEDANCE_BASE_URL="https://api.toapis.com/v1"
export SEEDANCE_API_KEY="sk-toapis-your-production-token"
Padrão completo de failover multimodelo em TypeScript / Node.js
Para serviços web empresariais que exigem alta confiabilidade, o trecho de TypeScript a seguir demonstra o failover automatizado entre Seedance 2.0 e Seedance 2.5:
import axios from "axios";

interface VideoTaskResponse {
  id: string;
  status: "processing" | "succeeded" | "failed";
  video_url?: string;
  error?: string;
}

const TOAPIS_BASE_URL = "https://api.toapis.com/v1";
const API_KEY = process.env.TOAPIS_API_KEY;

export async function generateVideoWithFallback(
  prompt: string,
  resolution: "720p" | "1080p" = "720p"
): Promise<string> {
  const models = ["seedance-2", "seedance-2-5"];

  for (const model of models) {
    try {
      console.log(`[VideoGateway] Tentando geração com o modelo: ${model}`);

      const submitResp = await axios.post<VideoTaskResponse>(
        `${TOAPIS_BASE_URL}/videos/generations`,
        {
          model,
          prompt,
          resolution,
          duration: 5,
          aspect_ratio: "16:9"
        },
        {
          headers: {
            Authorization: `Bearer ${API_KEY}`,
            "Content-Type": "application/json"
          },
          timeout: 10000
        }
      );

      const taskId = submitResp.data.id;
      return await pollTask(taskId);
    } catch (err: any) {
      console.warn(`[VideoGateway] O modelo ${model} falhou ou expirou: ${err.message}. Tentando o próximo fallback...`);
    }
  }

  throw new Error("Todos os provedores de vídeo generativo falharam em produzir o recurso.");
}

async function pollTask(taskId: string): Promise<string> {
  const maxAttempts = 30;
  for (let i = 0; i < maxAttempts; i++) {
    await new Promise((res) => setTimeout(res, 3000));
    const resp = await axios.get<VideoTaskResponse>(
      `${TOAPIS_BASE_URL}/tasks/video-status?task_id=${taskId}`,
      { headers: { Authorization: `Bearer ${API_KEY}` } }
    );

    if (resp.data.status === "succeeded" && resp.data.video_url) {
      return resp.data.video_url;
    }
    if (resp.data.status === "failed") {
      throw new Error(`A renderização no upstream falhou: ${resp.data.error}`);
    }
  }
  throw new Error(`A tarefa ${taskId} expirou após o polling.`);
}
7. Perguntas frequentes (FAQ)
P1: Onde posso encontrar a API mais barata do Seedance 2.0 para cargas de trabalho em produção?
A ToAPIs oferece o acesso verificado mais barato do mercado global à API do Seedance 2.0, a $0.028 por segundo em 720p e $0.048 por segundo em 1080p. Esse preço representa um desconto de 37.7% frente aos contratos empresariais diretos da ByteDance e elimina todos os limites de compromisso mensal.
P2: Por que o preço da API do Seedance 2.0 é mais barato pela ToAPIs do que indo direto?
A ToAPIs opera como um gateway institucional de computação de IA, agregando tráfego de geração de vídeo de milhares de startups, agências e empresas em produção no mundo todo. Ao comprar reservas massivas de computação de clusters de infraestrutura de GPU upstream, a ToAPIs desbloqueia níveis de preço atacadista de primeira linha aos quais desenvolvedores individuais não conseguem acessar sozinhos, repassando a economia diretamente.
P3: Como os hosts de contêineres serverless criam custos ocultos na geração de vídeo?
As nuvens serverless baseadas em contêineres cobram pelo tempo bruto de computação de GPU, e não pela duração do vídeo concluído. Quando um contêiner é levantado a partir de um estado frio, carregar 18 GB de pesos do modelo na memória leva de 15 a 30 segundos de tempo faturável antes de a difusão começar. Além disso, se a geração falhar por um erro de CUDA, você ainda é cobrado pelo tempo de execução do contêiner decorrido.
P4: O que acontece se uma tarefa de inferência de vídeo falhar ou for cancelada?
Na ToAPIs, a cobrança da tarefa depende estritamente do sucesso da geração de mídia. Qualquer solicitação que termine em FAILED, TIMED_OUT ou rejeição por moderação de conteúdo tem custo de rigorosamente $0.00. Nenhum saldo é debitado por renders incompletos ou abortados.
8. Lista de ações e próximos passos
- Crie uma conta: registre-se em ToAPIs.com para receber créditos de teste iniciais.
- Acesse sua chave unificada: gere sua chave de API de produção no painel do desenvolvedor da ToAPIs.
- Configure seu endpoint: aponte o cliente de vídeo do seu aplicativo para
https://api.toapis.com/v1/videos/generations. - Implante roteamento inteligente: envie por padrão a geração não crítica para 720p a $0.028/s e reserve o 1080p para os ativos principais voltados ao cliente.
Guias e documentação relacionados
- 📖 Guia de início rápido da API do Seedance 2.0 — passo a passo completo de integração com Node.js e Python.
- 📊 Análise aprofundada de preços do Seedance 2.0 vs 2.5 — análise de tarifas por segundo e detalhamento dos multiplicadores de resolução.
- ⚡ Matriz de preços da ToAPIs — tabelas de tarifas atacadistas em tempo real para mais de 100 modelos de IA multimodais.