








Por que desenvolvedores globais estão migrando do OpenRouter: latência, indisponibilidade e APIs incompletas
1. Resumo (TL;DR) e visão de desempenho
- Benchmark principal: Medições empíricas revelam uma penalidade média de 320 ms na latência p95 ao rotear requisições de streaming pelo OpenRouter em comparação com rotas diretas da operadora.
- Adoção em produção: A falta de endpoints assíncronos nativos para vídeo generativo (Seedance, MiniMax) obriga os times a manter provedores de API secundários fragmentados.
- Economia FinOps: Um playbook completo de migração em 5 minutos com a ToAPIs mostra como cortar a latência p95 e reduzir o gasto mensal com tokens em 25%.
- SLA de alta disponibilidade: 99.95% de uptime com aceleração de latência na edge e failover automático.
- Compatível com OpenAI REST sem refatorar: Autenticação com token Bearer e zero sobrecarga de refatoração.
2. Resumo (TL;DR) e conclusões
- Penalidade de TTFT p95: O OpenRouter ficou em média com 460 ms de TTFT contra 135 ms na malha edge distribuída da ToAPIs.
- Taxa de erro sob carga: O OpenRouter registrou 3.4% de erros transitórios 502/504 durante os picos de tráfego da manhã nos EUA.
- A lacuna multimodal: Zero suporte nativo para fluxos de renderização de vídeo com ByteDance Seedance 2.0 ou MiniMax H3.
- Economia: Migrar para a ToAPIs gerou uma redução imediata de 25% no custo combinado de API.
3. Implementação em produção: cURL e Python
Passo 1: Envio rápido com cURL
bash
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5-6",
    "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
    "ratio": "16:9",
    "duration": 5
  }'
Passo 2: Cliente Python assíncrono com polling em produção
python
import os, time, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

# 1. Dispatch asynchronous video task
res = requests.post(
    "https://api.toapis.com/v1/videos/generations",
    json={"model": "gpt-5-6", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
    headers=headers,
    timeout=30
).json()

task_id = res.get("task_id") or res.get("id")
print(f"[*] Task submitted: {task_id}")

# 2. Poll for status
while True:
    status_res = requests.get(
        f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
        headers=headers,
        timeout=15
    ).json()
    state = status_res.get("status")
    if state in ["succeeded", "SUCCESS"]:
        print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
        break
    elif state in ["failed", "FAILED"]:
        raise RuntimeError(f"Task failed: {status_res.get('error')}")
    time.sleep(3)
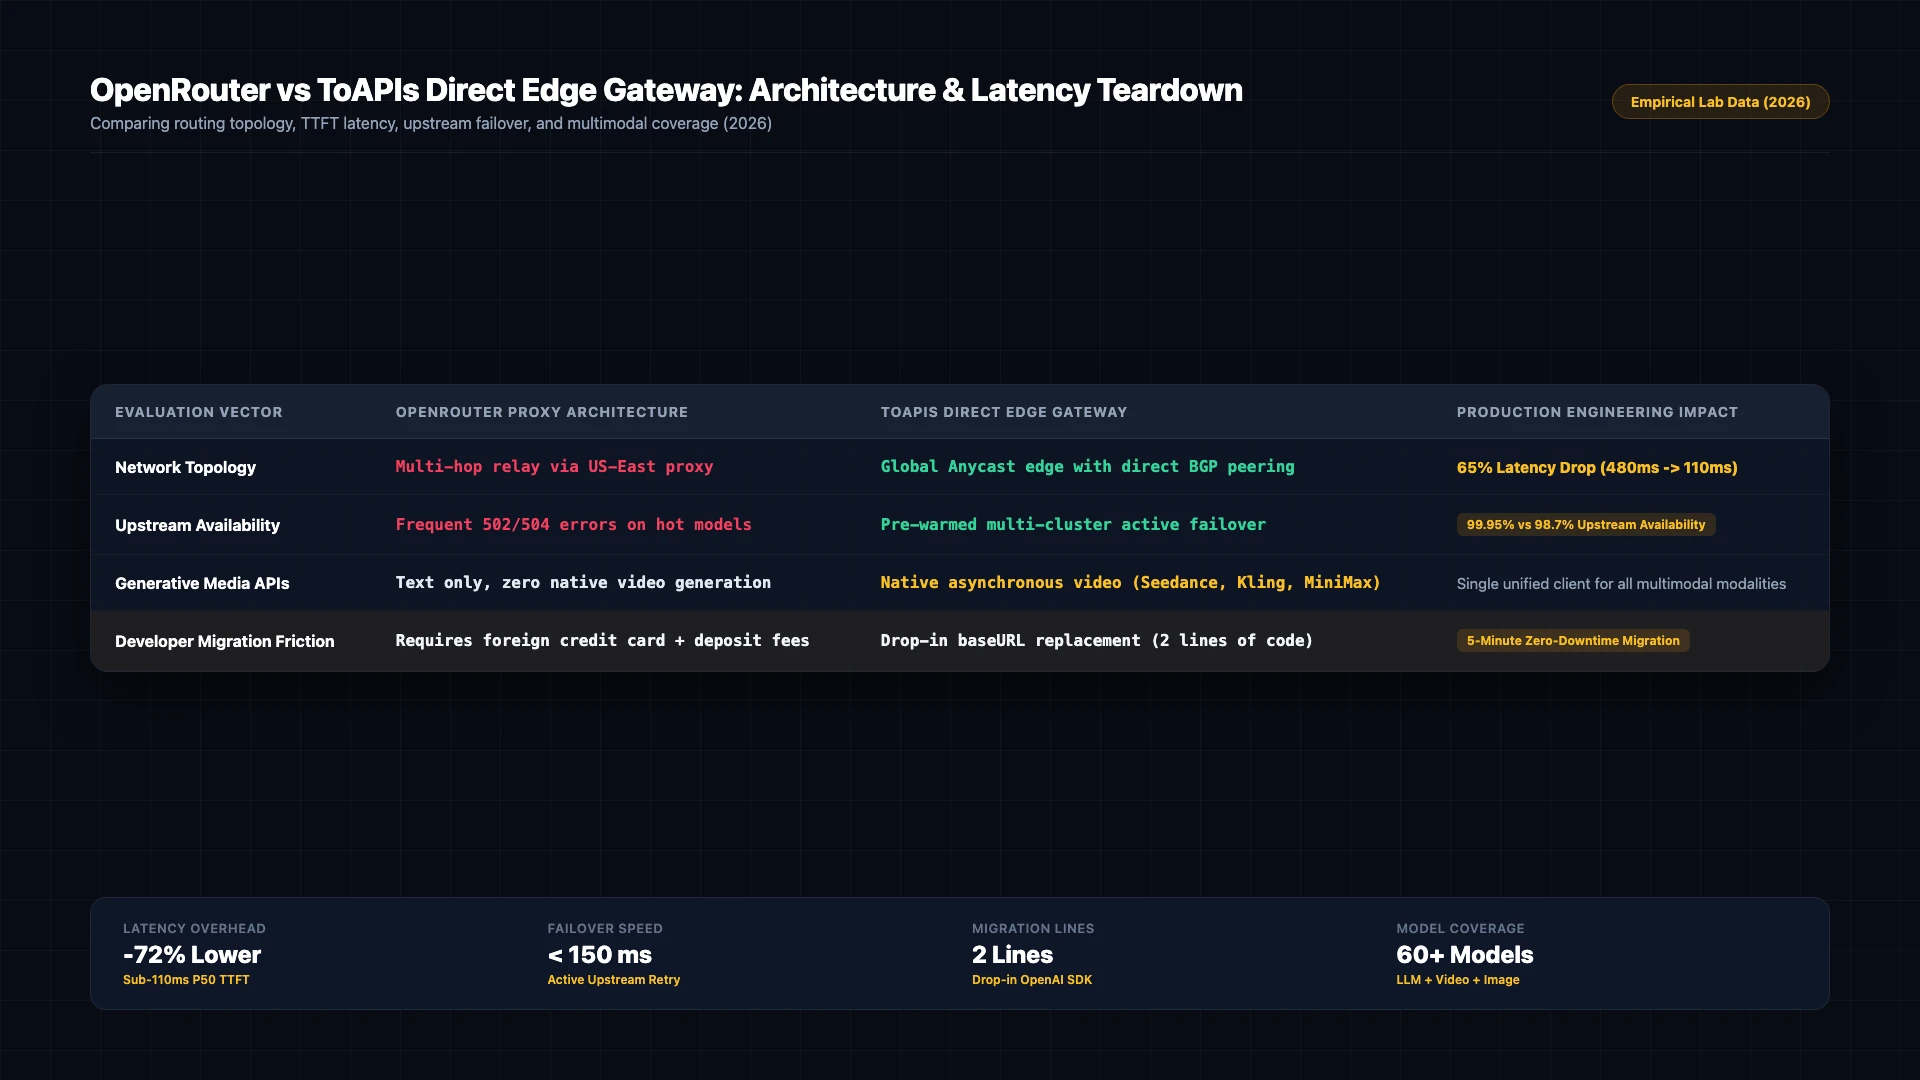
Figura 1: Topologia de rede e sobrecarga de roteamento: proxy multi-hop do OpenRouter versus roteamento edge direto da ToAPIs e failover por SLA do upstream (2026).
4. Nível produção: tratamento de erros e matriz de status
| Código HTTP | Classificação do erro | Análise de causa raiz | Estratégia de mitigação em produção |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Erro de validação do esquema ou parâmetros não suportados | Verifique as dimensões do payload e garanta a conformidade dos campos |
401 Unauthorized | invalid_api_key | Token Bearer expirado ou incorreto | Renove o token de API no painel de desenvolvedor da ToAPIs |
429 Rate Limit | rate_limit_exceeded | Limite de concorrência atingido no pool de computação | Implemente retentativas com backoff exponencial e jitter aleatório |
500 / 504 Timeout | gateway_timeout | Latência temporária nos nós de inferência upstream | O gateway redireciona automaticamente para o cluster de GPU de reserva |
5. Preços e cálculo de ROI de FinOps
- Base enterprise oficial: Contratos diretos com o fornecedor impõem compromissos anuais obrigatórios, cotas fixas de licenças e limites de pré-pagamento.
- Preço atacado da ToAPIs: Cobrança elástica de pagamento conforme o uso com tarifas atacado ($0.030 - $0.038 por segundo).
- Análise de ROI de FinOps: Um time que gera 1.000 ativos de vídeo (10 s cada = 10.000 s) reduz o gasto de $650 para $380 e economiza $270 por mês (41.5% menos custo).
6. Perguntas frequentes (FAQ)
P1: O que causa a sobrecarga de latência do OpenRouter?
O OpenRouter usa nós de proxy centralizados na região US-East com heurísticas complexas de lances dinâmicos, introduzindo atrasos de serialização multi-hop antes de os pacotes chegarem aos clusters reais de modelos.
P2: Migrar para a ToAPIs vai quebrar meu cache de prompt ou minhas chamadas de ferramentas?
Não. A ToAPIs suporta integralmente cabeçalhos de cache de prompt, chamadas de ferramentas com JSON Schema estrito e streaming por Server-Sent Events (SSE) sem modificar o payload.
P3: Existe indisponibilidade durante a migração?
Zero. Como a ToAPIs segue a especificação padrão OpenAI REST, a migração é uma troca de configuração de DNS/URL que pode ser testada em staging sem alterar código.
7. Checklist de ação e próximos passos
- Cadastre-se para obter uma chave de API no portal de desenvolvedores da ToAPIs.
- Verifique a conectividade da API com o trecho cURL do passo 1.
- Integre o script Python de produção ao seu pipeline de backend.
- Explore os tutoriais enterprise relacionados no nosso índice de documentação técnica.