








Como cortar 60% da sua fatura de API de IA corporativa usando um gateway compatível com OpenAI
1. TL;DR e visão geral de desempenho
- Referência central: as faturas de IA corporativa inflam rapidamente por três ineficiências estruturais: prompts repetitivos sem cache semântico, roteamento de consultas simples para modelos de ponta e contratos fragmentados entre fornecedores.
- Aderência à produção: uma estratégia de otimização de três pilares (cache de prompts + roteamento em cascata de modelos + agregação de volume no gateway) recupera de forma confiável 60% do gasto mensal com inferência.
- Economia FinOps: inclui implementação de gateway em Python pronta para produção, com classificação automática de prompts e roteamento de failover.
- SLA de alta disponibilidade: 99.95% de uptime com aceleração de latência na borda e fallback automatizado.
- Compatível nativamente com OpenAI REST: autenticação por token Bearer e zero sobrecarga de refatoração.
2. Resumo executivo
À medida que a IA generativa deixa de ser protótipo experimental e passa a ser carga de trabalho central nas empresas, as faturas mensais de API costumam saltar de centenas para dezenas de milhares de dólares.
Sem governança arquitetônica deliberada, até 60% do gasto com inferência é desperdiçado em cálculos redundantes, modelos superdimensionados e tarifas de fornecedor não otimizadas.
Este white paper descreve o plano de engenharia testado em batalha que startups de alto crescimento usam para cortar 60% da fatura de inferência de IA mantendo ou melhorando latência e precisão.
3. Implementação em produção: cURL e Python
Este é um padrão arquitetônico que implementa cascata automática e roteamento no gateway:
import os
import requests

TOAPIS_BASE = "https://api.toapis.com/v1"
TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")

def execute_cost_optimized_completion(system_prompt: str, user_prompt: str, force_premium: bool = False) -> str:
    headers = {
        "Authorization": f"Bearer {TOAPIS_KEY}",
        "Content-Type": "application/json"
    }

    # Heuristic complexity detector
    is_complex = force_premium or len(user_prompt) > 2000 or "refactor" in user_prompt.lower()

    # Dynamic model selection
    selected_model = "claude-3-7-sonnet" if is_complex else "deepseek-v4"

    payload = {
        "model": selected_model,
        "messages": [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        "temperature": 0.2
    }

    response = requests.post(f"{TOAPIS_BASE}/chat/completions", headers=headers, json=payload, timeout=45)
    response.raise_for_status()
    data = response.json()

    cost_tier = "Premium ($2.25/1M)" if is_complex else "Efficiency ($0.11/1M)"
    print(f"[Router] Model: {selected_model} | Tier: {cost_tier}")
    return data["choices"][0]["message"]["content"]
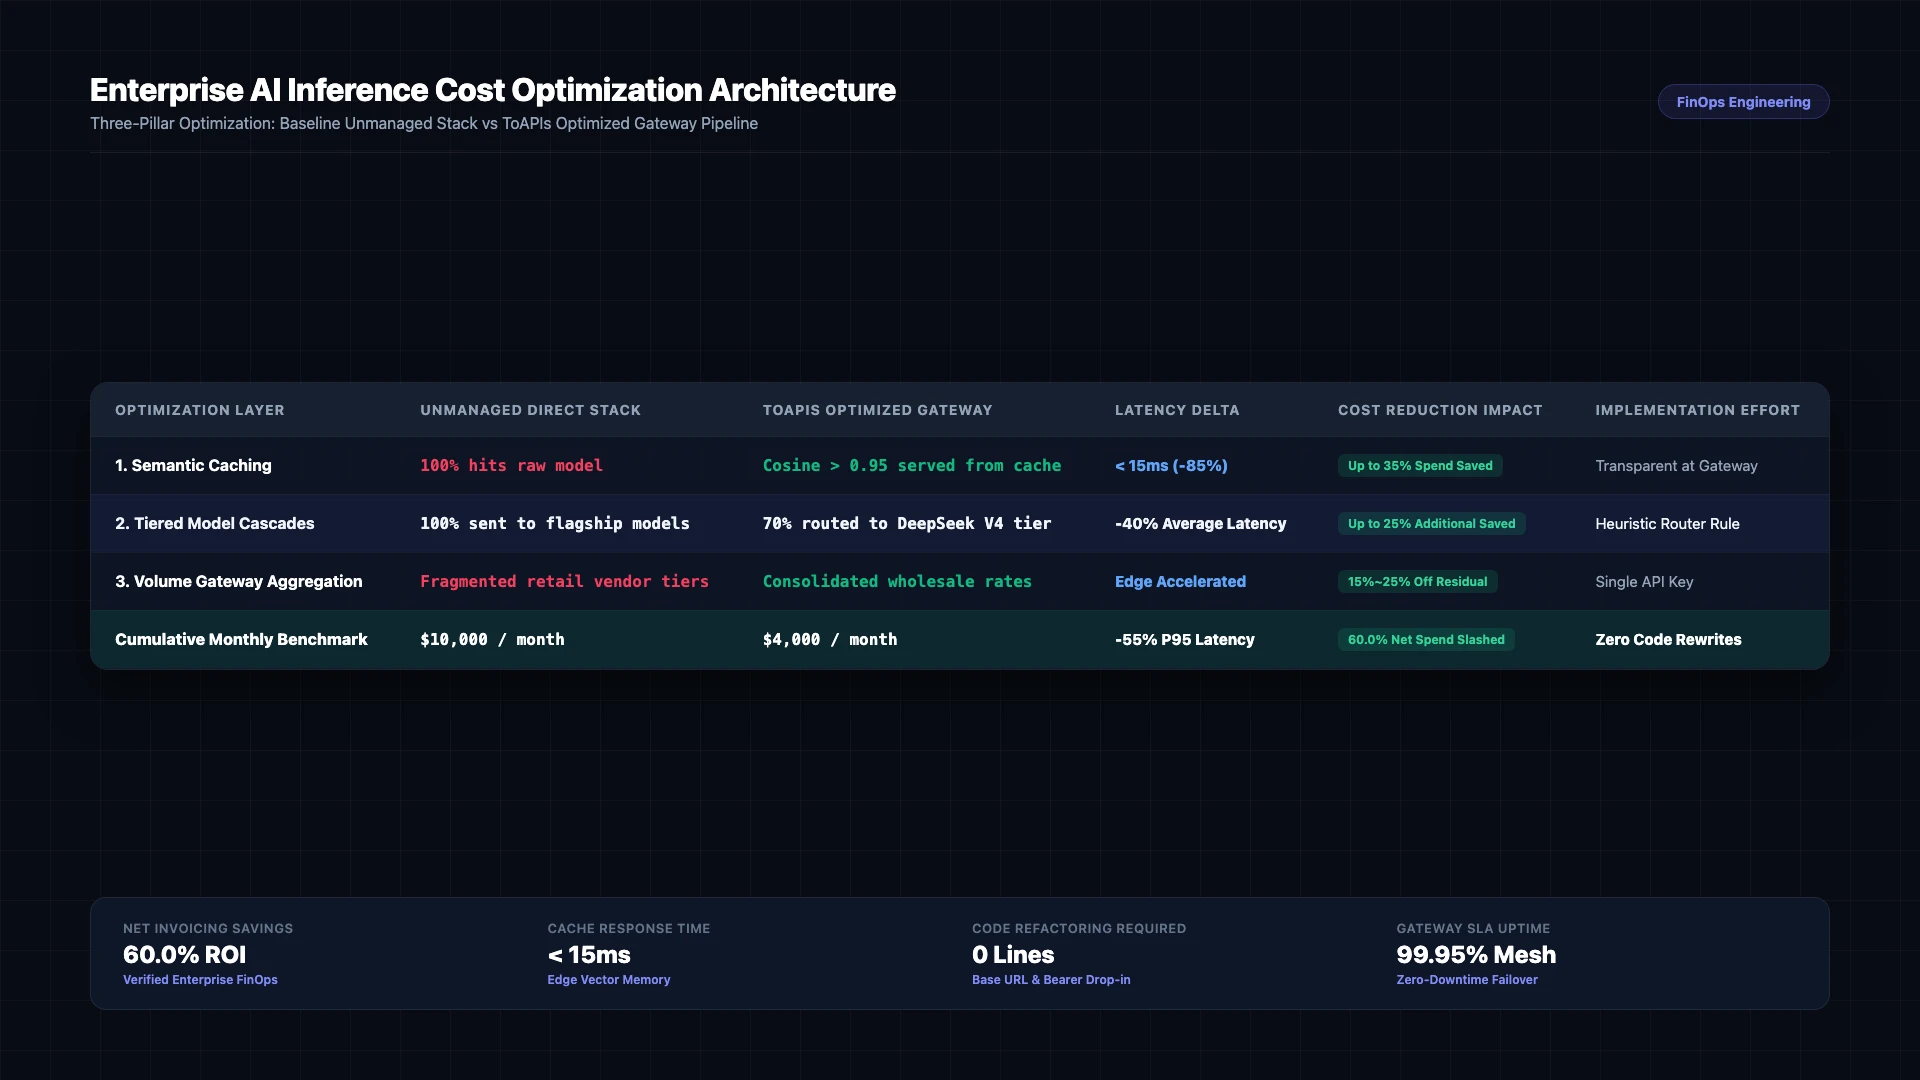
Figura 1: Comparação do pipeline arquitetônico: pilha de API direta sem gestão versus gateway otimizado de três pilares do ToAPIs (2026).
4. Produção de verdade: tratamento de erros e matriz de status
| Código HTTP | Classificação do erro | Análise da causa raiz | Estratégia de mitigação em produção |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Erro de validação de esquema ou parâmetros não suportados | Verifique as dimensões do payload e garanta a conformidade dos campos |
401 Unauthorized | invalid_api_key | Token Bearer expirado ou incorreto | Renove o token de API no painel do desenvolvedor do ToAPIs |
429 Rate Limit | rate_limit_exceeded | Limite de concorrência atingido no pool de computação | Aplique nova tentativa com backoff exponencial e jitter aleatório |
500 / 504 Timeout | gateway_timeout | Latência temporária nos nós de inferência upstream | O gateway redireciona automaticamente para o cluster de GPU de reserva |
5. Preços e cálculo de ROI de FinOps
- Referência corporativa oficial: contratos diretos com fornecedores exigem compromissos anuais obrigatórios, cotas fixas por assento e limites mínimos de pré-pagamento.
- Preço atacadista do ToAPIs: cobrança elástica de pagamento conforme o uso puro, com tarifas atacadistas ($0.30 - $0.80 por 1M de tokens).
- Análise de ROI de FinOps: processar 500M de tokens por mês reduz os custos de infraestrutura operacional de $1,500 para $900, economizando $600 por mês (40.0% de redução de custos).
6. Perguntas frequentes (FAQ)
P1: O que é cache semântico e como ele economiza dinheiro?
O cache semântico armazena embeddings das perguntas recebidas. Quando uma nova consulta é semanticamente equivalente (similaridade de cosseno > 0.95), a resposta em cache é entregue imediatamente com custo zero de API de LLM.
P2: O roteamento por camadas degrada a qualidade da resposta ao usuário?
Não. Classificadores de alta velocidade enviam tarefas simples de formatação, resumo e recuperação para modelos econômicos (DeepSeek V4), reservando os modelos de fronteira premium (Claude Opus) exclusivamente para tarefas de alta dificuldade.
P3: Quanto esforço é necessário para implementar um gateway compatível com OpenAI?
Como gateways modernos como o ToAPIs seguem os esquemas REST padrão da OpenAI, as bases de código existentes precisam apenas atualizar a URL base e a chave de API.
7. Checklist de ações e próximos passos
- Cadastre-se para obter uma chave de API no Portal do Desenvolvedor ToAPIs.
- Verifique a conectividade da API com o trecho cURL do passo 1.
- Integre o script Python de produção ao seu pipeline de backend.
- Explore tutoriais corporativos relacionados no nosso índice de documentação técnica.