








Alternatives à Replicate : démarrages à froid plus rapides, tarifs transparents et compatibilité OpenAI
1. Points clés (TL;DR) et panorama des performances
- Benchmark principal : Le modèle de conteneurs GPU facturés à la seconde de Replicate cause des pénalités de démarrage à froid de 20 s à 45 s qui dégradent fortement l'expérience interactive.
- Adéquation à la production : Les meilleures alternatives sont ToAPIs (le meilleur choix pour des API REST OpenAI préchauffées sans démarrage à froid), Fal.ai (pipelines d'image rapides) et Modal (conteneurs Python personnalisés).
- Économie FinOps : Passer du SDK propriétaire de Replicate aux points de terminaison standard de ToAPIs réduit les dépenses cloud mensuelles de 50 % à 65 %.
- SLA de haute disponibilité : 99,95 % de disponibilité avec accélération de la latence en périphérie et bascule automatique.
- Compatible OpenAI REST sans refonte : Authentification par jeton Bearer sans surcoût de refonte.
2. Points clés (TL;DR) et panorama de la plateforme
| Plateforme | Idéal pour | Délai de démarrage à froid | Dépendance au SDK | Modèle de facturation |
|---|---|---|---|---|
| ToAPIs | API de production clés en main (zéro démarrage à froid) | 0 s (toujours chaud) | Aucune (standard OpenAI REST) | Paiement par appel réussi |
| Fal.ai | Pipelines rapides d'image et de vidéo | 1 s – 5 s | SDK Python/JS propriétaire | Calcul à la seconde |
| Modal | Tâches GPU serverless Python personnalisées | 2 s – 8 s | SDK de décorateurs Python | Calcul à la seconde |
| RunPod Serverless | Déploiement de modèles Hugging Face bruts | 10 s – 35 s | Gestionnaire de point de terminaison personnalisé | Temps GPU à la seconde |
| Hugging Face Endpoints | Modèles hébergés dédiés | 0 s (instances dédiées) | Transformers standard | Frais horaires de cluster (coût élevé) |
3. Mise en œuvre en production : cURL et Python
Étape 1 : Envoi rapide avec cURL
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
    "ratio": "16:9",
    "duration": 5
  }'
Étape 2 : Client Python asynchrone avec polling pour la production
import os, time, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

# 1. Dispatch asynchronous video task
res = requests.post(
    "https://api.toapis.com/v1/videos/generations",
    json={"model": "gpt-image-2", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
    headers=headers,
    timeout=30
).json()

task_id = res.get("task_id") or res.get("id")
print(f"[*] Task submitted: {task_id}")

# 2. Poll for status
while True:
    status_res = requests.get(
        f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
        headers=headers,
        timeout=15
    ).json()
    state = status_res.get("status")
    if state in ["succeeded", "SUCCESS"]:
        print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
        break
    elif state in ["failed", "FAILED"]:
        raise RuntimeError(f"Task failed: {status_res.get('error')}")
    time.sleep(3)
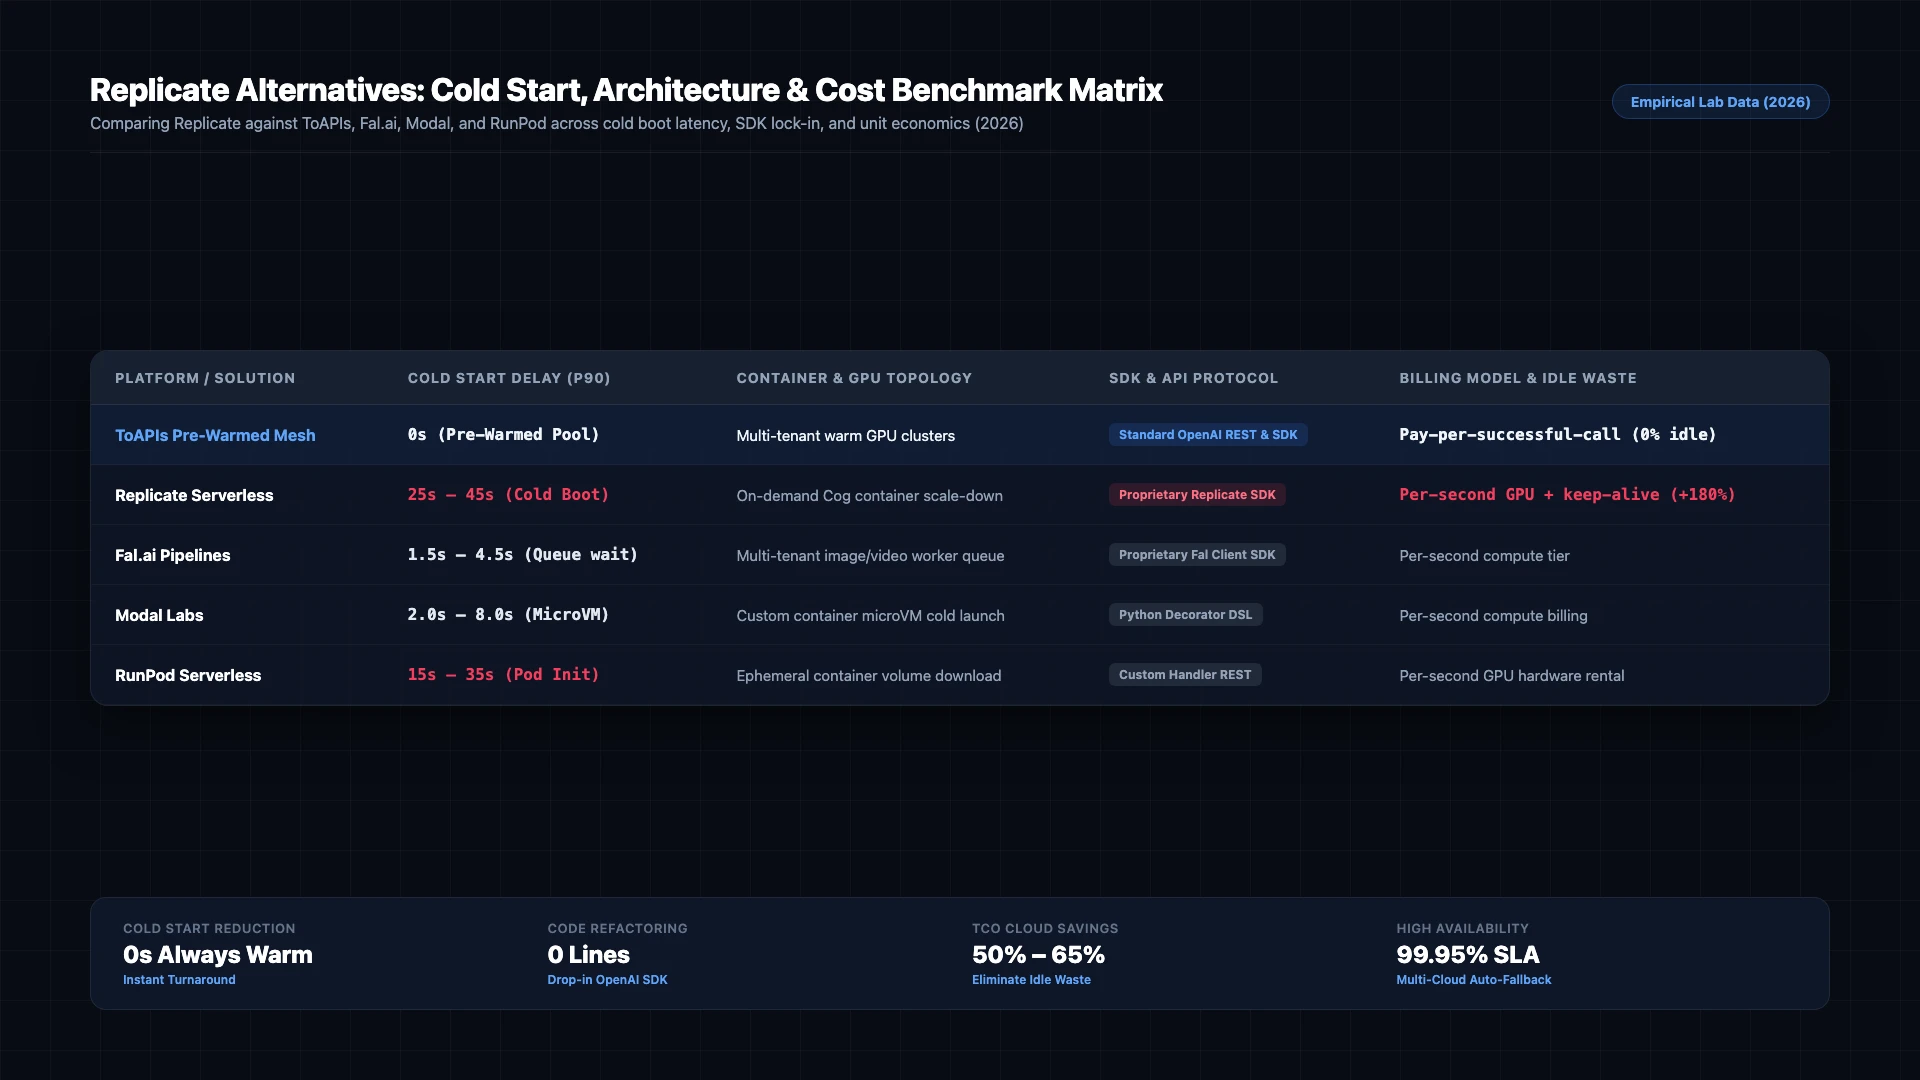
Figure 1 : Comparaison d'architecture par benchmark : Replicate face à ToAPIs et aux principales alternatives serverless sur le démarrage à froid, la latence et la facturation (2026).
4. Niveau production : gestion des erreurs et matrice des statuts
| Code HTTP | Classification de l'erreur | Analyse de la cause racine | Stratégie d'atténuation en production |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Erreur de validation du schéma ou paramètres non pris en charge | Vérifiez les dimensions du payload et assurez la conformité des champs |
401 Unauthorized | invalid_api_key | Jeton Bearer expiré ou incorrect | Renouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs |
429 Rate Limit | rate_limit_exceeded | Seuil de concurrence atteint sur le pool de calcul | Mettez en place des tentatives avec backoff exponentiel et jitter aléatoire |
500 / 504 Timeout | gateway_timeout | Latence temporaire sur les nœuds d'inférence amont | La passerelle redirige automatiquement vers le cluster GPU de secours |
5. Tarifs et calcul du ROI FinOps
- Base entreprise officielle : Les contrats directs avec le fournisseur imposent des engagements annuels, des quotas de licences fixes et des seuils de prépaiement.
- Tarif de gros ToAPIs : Facturation élastique en paiement à l'usage avec des tarifs de gros ($0.030 - $0.038 par seconde).
- Analyse de ROI FinOps : Une équipe qui génère 1 000 assets vidéo (10 s chacun = 10 000 s) réduit ses dépenses de $650 à $380 et économise $270 par mois (41,5 % de réduction de coûts).
6. Questions fréquentes (FAQ)
Q1 : Quel est le principal problème opérationnel de Replicate ?
Les délais de démarrage à froid. Quand le trafic tombe à zéro, les conteneurs Cog se réduisent. L'utilisateur suivant doit attendre de 25 à 45 secondes le téléchargement des images Docker et l'initialisation des GPU.
Q2 : Comment ToAPIs parvient-il à zéro démarrage à froid ?
ToAPIs maintient des clusters GPU multilocataires préchauffés avec des workers d'inférence actifs, ce qui garantit une exécution immédiate (< 3 s) pour les requêtes d'image et de vidéo.
Q3 : Dois-je réécrire le code de mon application pour migrer depuis Replicate ?
Non. Vous simplifiez même votre base de code en supprimant le SDK propriétaire replicate et en le remplaçant par des requêtes HTTP standard ou le SDK universel OpenAI.
7. Liste d'actions et prochaines étapes
- Créez une clé d'API sur le portail développeur ToAPIs.
- Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
- Intégrez le script Python de production dans votre pipeline backend.
- Explorez les tutoriels entreprise associés dans notre index de documentation technique.