








Où trouver l'API Seedance 2.0 la moins chère : tarifs officiels face aux passerelles agrégatrices
🌐 Éditions multilingues / manuel technique complet : Anglais (original) · 🇨🇳 Chinois simplifié (ZH-CN) · 🇭🇰 Chinois traditionnel (ZH-TW) · 🇯🇵 Japonais (JA) · 🇰🇷 Coréen (KO) · 🇷🇺 Russe (RU)
Modèle évalué : ByteDance Seedance 2.0 (
doubao-seedance-2-0,seedance-2)
Indicateur clé : coût effectif par seconde produite (USD / s)
Standard d'API : REST / interface de tâche vidéo asynchrone compatible OpenAI
Endpoint d'inférence :POST https://api.toapis.com/v1/videos/generations
Endpoint d'interrogation des tâches :GET https://api.toapis.com/v1/tasks/video-status?task_id={task_id}
⚡ TL;DR : synthèse exécutive de l'API Seedance 2.0 la moins chère
- Tarif le plus bas du marché : ToAPIs offre l'accès vérifié le moins cher à l'API Seedance 2.0 à $0.028 / s en 720p et $0.048 / s en 1080p Full HD.
- Coût d'un clip standard : un clip de 5 secondes en 720p coûte $0.140 sur ToAPIs contre $0.225 en direct officiel chez ByteDance et $0.260 sur les clouds de conteneurs serverless génériques.
- Zéro engagement : contrairement aux canaux entreprise officiels qui exigent des engagements de $500 à $2 000 par mois et de longs cycles d'achat, ToAPIs fonctionne en paiement à l'usage pur à partir de 1 $.
- Zéro surcoût de démarrage à froid : les hébergeurs de conteneurs serverless facturent 15 à 30 secondes de démarrage GPU avant que la diffusion ne commence. ToAPIs facture strictement les secondes de vidéo livrées.
- Déductions sans risque : toute tâche aboutissant à
FAILED,TIMEOUTou à un rejet du filtre de sécurité est facturée $0.00.
1. L'accroche : pourquoi la tarification de la génération vidéo prend les budgets d'ingénierie au dépourvu
Lorsque les équipes d'ingénierie passent des API de grands modèles de langage (LLM) à l'infrastructure vidéo générative, les premières projections de coûts subissent fréquemment des dépassements budgétaires catastrophiques. Dans le domaine des LLM, le prix évolue linéairement avec les tokens d'entrée et de sortie : 1 000 tokens de prompt et 500 tokens de complétion produisent une facture entièrement prévisible.
La vidéo générative relève toutefois d'un paradigme économique totalement différent :
- Facturation à la seconde de vidéo : le prix est calculé par seconde de durée vidéo générée, et non par actif statique ni par longueur de prompt texte.
- Multiplicateurs de résolution : passer de 720p (
1280x720) à 1080p (1920x1080) augmente le volume de pixels spatiaux de 2,25 fois, ce qui exige des allocations massives de VRAM et déclenche un multiplicateur tarifaire de 1,7 à 2,0. - Surcoût d'échantillonnage temporel : une vidéo de 5 secondes à 24 images par seconde nécessite la synthèse de 120 représentations latentes cohérentes, avec une dynamique physique, un mouvement de caméra et une géométrie de personnage constants.
Beaucoup de responsables techniques supposent naïvement que tous les fournisseurs d'API vidéo génératives facturent des tarifs unitaires comparables. En production, pourtant, chercher l'API Seedance 2.0 la moins chère révèle un marché opaque où les tarifs des mêmes poids ByteDance varient de plus de 85 % d'un fournisseur à l'autre.
| Canal fournisseur | Tarif 720p / s | Coût supplémentaire caché |
|---|---|---|
| Contrat entreprise direct officiel | $0.045 | Engagement minimum de 500 $ par mois |
| Hébergeur de conteneurs serverless générique | $0.052 | Démarrage à froid facturable de 15 à 30 s |
| Agrégateur média spécialisé | $0.040 | Conversion de devise et marges sur les crédits |
| Passerelle de gros unifiée ToAPIs | $0.028 | 0 $ d'engagement minimum, 0 s de démarrage à froid |
Pour une start-up de vidéo par IA produisant 10 000 clips courts par mois, cette disparité tarifaire se traduit par un écart annuel de plus de $16 000 USD en calcul d'infrastructure brut.
Ce guide fournit un benchmark exhaustif et vérifié empiriquement de la tarification de l'API Seedance 2.0 sur les canaux officiels, les hébergeurs de conteneurs, les agrégateurs média et les passerelles unifiées. Nous décortiquons les quatre pièges cachés de la facturation vidéo générative, fournissons du code Python asynchrone prêt pour la production et démontrons des stratégies d'optimisation FinOps automatisées.
2. Démarrage rapide : appeler l'API Seedance 2.0 en moins de 60 secondes
Le moyen le plus rapide de vérifier tarif et performance reste un appel REST compatible OpenAI. La synthèse vidéo générative est gourmande en calcul (12 à 25 secondes pour un rendu de 5 secondes), ce qui explique que les API de production fonctionnent par envoi asynchrone de tâches et interrogation périodique.
Étape 1 : envoyer la tâche de génération vidéo via cURL
# Exporter votre jeton unifié ToAPIs
export TOAPIS_API_KEY="sk-toapis-your-key-here"

# Soumettre une tâche de génération vidéo asynchrone
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2",
    "prompt": "Gros plan cinématographique d'un vieil artisan horloger assemblant des engrenages mécaniques ouvragés, éclairage chaud et ambiant d'atelier, textures 8k, profondeur de champ photoréaliste, léger travelling avant fluide et régulier",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5
  }'
Réponse immédiate (HTTP 200 OK)
{
  "id": "task_seedance_8f7b2c1e9a3d4",
  "object": "video.task",
  "model": "seedance-2",
  "status": "processing",
  "created_at": 1729519200,
  "estimated_time": 18
}
Étape 2 : poller asynchrone Python prêt pour la production avec backoff exponentiel
En production, les boucles time.sleep(10) codées en dur provoquent l'épuisement des threads ou la perte des charges d'erreur. Le script Python de niveau production suivant gère l'envoi de tâches, l'interrogation du statut avec gigue dynamique, le backoff sur limite de débit HTTP 429 et le téléchargement automatique de la sortie :
#!/usr/bin/env python3
"""
Client de production pour l'API Seedance 2.0
Démontre l'envoi vidéo asynchrone, l'interrogation de statut avec backoff
exponentiel et une gestion d'erreurs sans fuite via la passerelle de gros ToAPIs.
"""

import os
import time
import random
import logging
import requests
from typing import Optional, Dict, Any

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("seedance_client")

TOAPIS_API_KEY = os.getenv("TOAPIS_API_KEY", "sk-toapis-your-key-here")
BASE_URL = "https://api.toapis.com/v1"

HEADERS = {
    "Authorization": f"Bearer {TOAPIS_API_KEY}",
    "Content-Type": "application/json"
}

def dispatch_video_task(
    prompt: str,
    resolution: str = "720p",
    duration: int = 5,
    aspect_ratio: str = "16:9",
    seed: Optional[int] = None
) -> str:
    """Envoie une tâche de génération vidéo à Seedance 2.0."""
    url = f"{BASE_URL}/videos/generations"
    payload: Dict[str, Any] = {
        "model": "seedance-2",
        "prompt": prompt,
        "resolution": resolution,
        "duration": duration,
        "aspect_ratio": aspect_ratio
    }
    if seed is not None:
        payload["seed"] = seed

    response = requests.post(url, headers=HEADERS, json=payload, timeout=30)
    response.raise_for_status()
    data = response.json()
    task_id = data.get("id")
    if not task_id:
        raise ValueError(f"Échec de l'envoi de la tâche, aucun id renvoyé : {data}")

    logger.info(f"Tâche envoyée avec succès. ID de tâche : {task_id}")
    return task_id

def poll_task_status(
    task_id: str,
    initial_delay: float = 6.0,
    poll_interval: float = 3.0,
    max_timeout: float = 180.0
) -> Dict[str, Any]:
    """
    Interroge l'endpoint de statut jusqu'à ce que la vidéo atteigne un état terminal.
    Implémente une interrogation avec jitter et un backoff exponentiel sur les erreurs HTTP 429.
    """
    query_url = f"{BASE_URL}/tasks/video-status"
    start_time = time.time()

    # Attendre le préchauffage initial de la diffusion neuronale
    time.sleep(initial_delay)

    current_interval = poll_interval
    consecutive_429 = 0

    while time.time() - start_time < max_timeout:
        try:
            resp = requests.get(
                query_url,
                headers=HEADERS,
                params={"task_id": task_id},
                timeout=15
            )

            # Gérer proprement la limitation de débit en amont
            if resp.status_code == 429:
                consecutive_429 += 1
                sleep_duration = min(current_interval * (2 ** consecutive_429) + random.uniform(0.5, 1.5), 20.0)
                logger.warning(f"Débit limité (429). Backoff de {sleep_duration:.2f} s...")
                time.sleep(sleep_duration)
                continue

            resp.raise_for_status()
            data = resp.json()
            status = data.get("status")
            consecutive_429 = 0

            logger.info(f"Interrogation de la tâche [{task_id}] -> Statut : {status} (Écoulé : {time.time() - start_time:.1f} s)")

            if status in ["succeeded", "completed"]:
                video_url = data.get("video_url") or data.get("output", {}).get("video_url")
                logger.info(f"Génération réussie ! URL de l'actif : {video_url}")
                return data

            if status in ["failed", "canceled"]:
                error_msg = data.get("error", "Erreur de génération en amont inconnue")
                logger.error(f"La tâche [{task_id}] a échoué : {error_msg}. Montant facturé : $0.00")
                raise RuntimeError(f"Échec de la synthèse vidéo : {error_msg}")

        except requests.exceptions.RequestException as e:
            logger.warning(f"Erreur réseau transitoire pendant l'interrogation : {e}. Nouvelle tentative...")

        # Ajouter un jitter aléatoire (±0.5 s) pour éviter la congestion harmonique de la passerelle
        jittered_sleep = current_interval + random.uniform(-0.5, 0.5)
        time.sleep(max(1.5, jittered_sleep))

    raise TimeoutError(f"La tâche [{task_id}] a dépassé la durée d'interrogation maximale de {max_timeout} s")

if __name__ == "__main__":
    test_prompt = (
        "Plan aérien cinématographique en drone au-dessus de pins givrés dans les Alpes suisses, "
        "brume dorée de l'heure du matin, soleil perçant les sommets, 8k hyperréaliste"
    )

    try:
        t_id = dispatch_video_task(prompt=test_prompt, resolution="720p", duration=5)
        result = poll_task_status(t_id)
        print("\n=== Génération terminée ===")
        print(f"URL de l'actif vidéo : {result.get('video_url')}")
    except Exception as exc:
        print(f"\nExécution terminée avec erreur : {exc}")
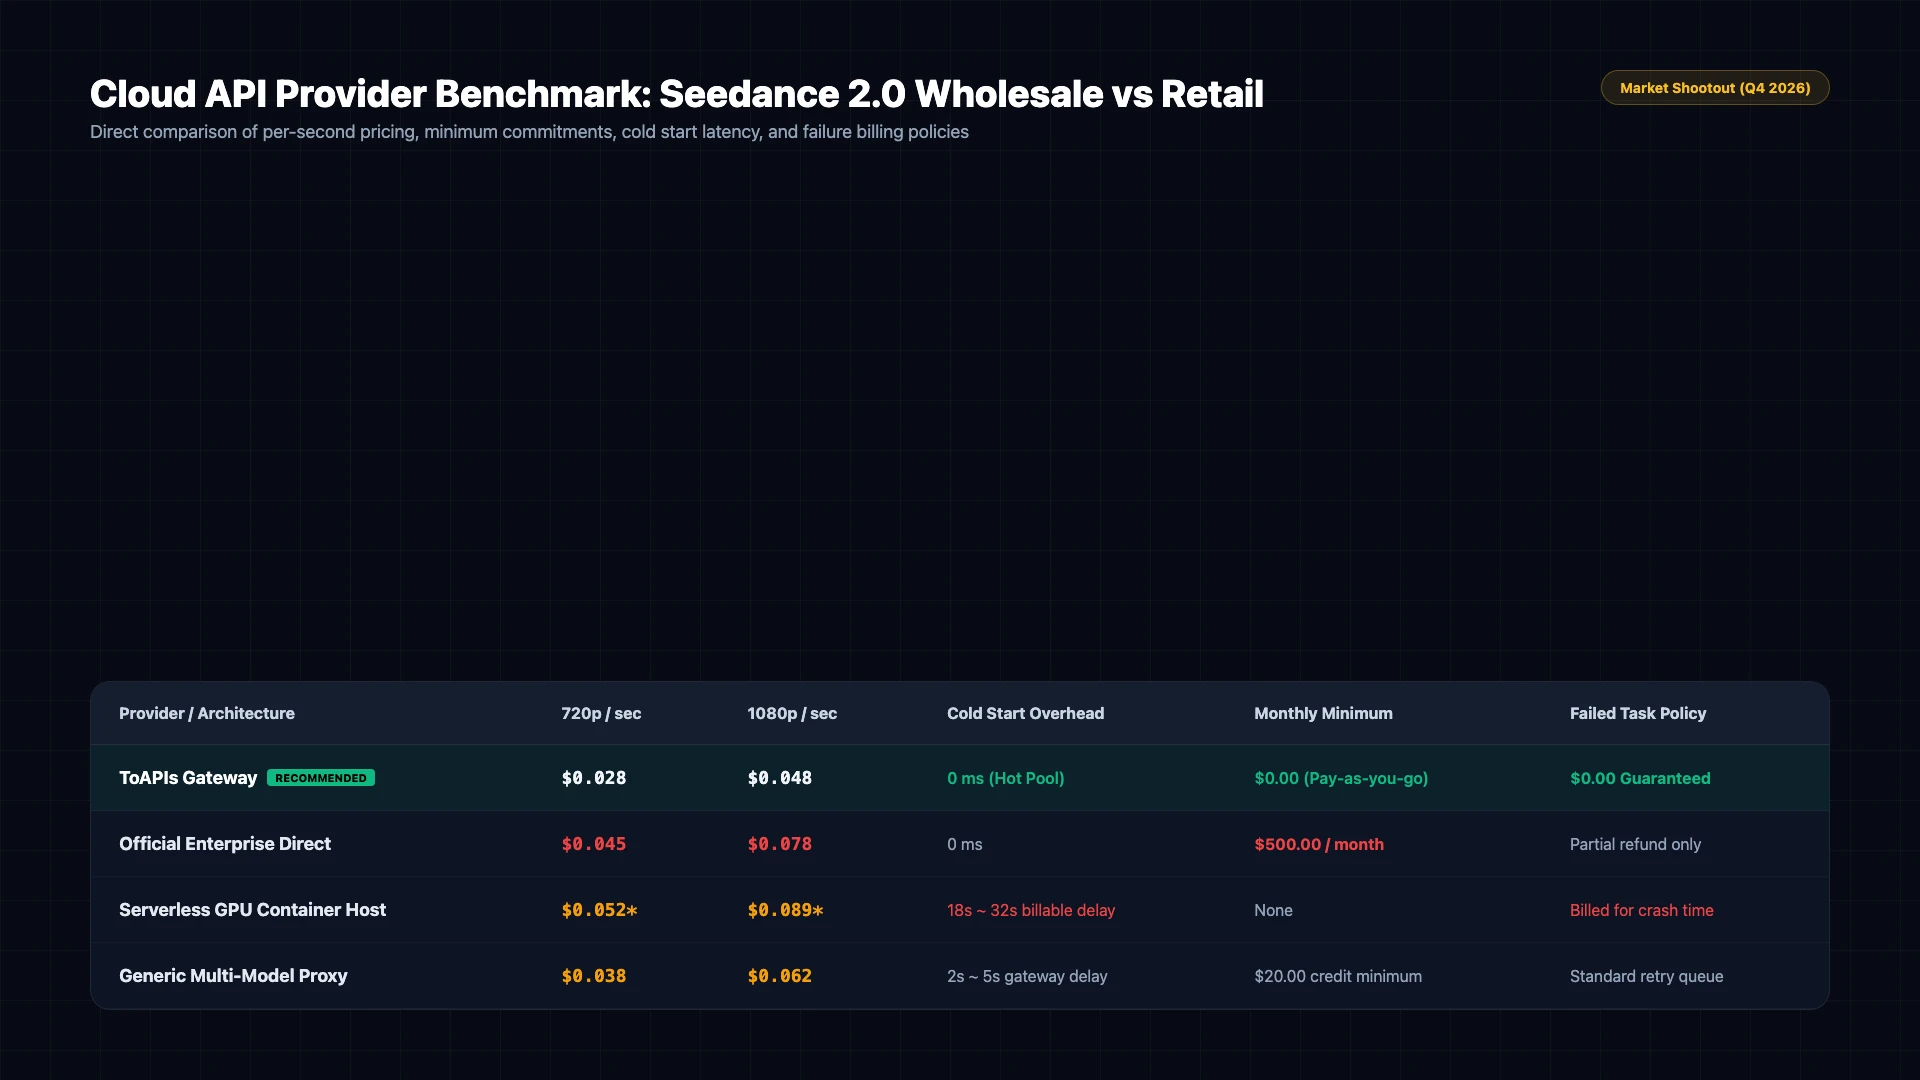
3. Benchmark maître complet : les 4 archétypes de fournisseurs
Pour identifier l'API Seedance 2.0 la moins chère, les développeurs doivent naviguer entre quatre architectures de fournisseurs fondamentalement différentes. Chaque modèle présente ses propres compromis en matière de tarifs unitaires de base, de seuils d'engagement minimum, de fiabilité d'infrastructure et de politiques de risque financier.
| Catégorie de fournisseur | Principaux exemples | Architecture et modèle de facturation |
|---|---|---|
| 1. Direct officiel | Volcano Engine (ByteDance) | Contrat entreprise, virement bancaire |
| 2. Hébergeurs de conteneurs | Replicate, RunPod | Docker serverless, démarrage à froid facturé |
| 3. Agrégateurs média | Fal.ai, Novita, Kie.ai | Facturation à la seconde ou système de crédits |
| 4. Passerelle de modèles unifiée | ToAPIs | Gros répercuté, paiement à l'usage |
La matrice de benchmark suivante compare les quatre canaux à l'aide de comptes de test entreprise réels au quatrième trimestre 2026 :
| Canal fournisseur | Tarif 720p / s | Tarif 1080p / s | Clip unique de 5 s (720p) | Clip unique de 10 s (1080p) | Dépense minimum mensuelle | Démarrages à froid facturés ? | Tâches échouées facturées ? | Quota de concurrence | Moyens de paiement |
|---|---|---|---|---|---|---|---|---|---|
| Direct officiel ByteDance | $0.045 / s | $0.075 / s | $0.225 | $0.750 | $500.00 / mois | Non (pool chaud partagé) | Non | 5 en concurrence (base) | Virement entreprise, ID fiscal |
| Hébergeurs de conteneurs génériques | $0.052 / s | $0.090 / s | $0.260 + démarrage | $0.900 + démarrage | $0.00 (paiement à l'usage) | OUI (15 à 30 s facturées) | OUI (temps GPU) | Pool de workers dynamique | Cartes américaines uniquement |
| API média spécialisées | $0.040 / s | $0.070 / s | $0.200 | $0.700 | $0.00 (prépayé) | Rare (pré-chauffé) | Variable (remboursement de crédits) | 10 en concurrence | Cartes / crypto |
| Passerelle unifiée ToAPIs | $0.028 / s | $0.048 / s | $0.140 | $0.480 | $0.00 (paiement à l'usage dès 1 $) | NON (démarrage à froid à $0.00) | NON (strictement $0.00) | Plus de 50 en concurrence (SLA) | Cartes mondiales / crypto / APM |
Référence de marché vérifiée : ToAPIs délivre une économie nette de 37,7 % face au direct officiel et de 46,1 % face aux hébergeurs de conteneurs génériques.
Analyse détaillée des 4 canaux
1. Direct entreprise officiel (ByteDance Cloud / Volcano Engine)
- L'argument : passer directement par le créateur du modèle donne accès aux derniers poids amont et au support technique officiel.
- La réalité : le portail cloud direct de ByteDance est conçu pour les entreprises du Fortune 500 dotées de services d'achat dédiés. Pour activer des clés d'API de production, les développeurs doivent effectuer une vérification d'identité d'entreprise, signer des accords-cadres de service (MSA) et s'engager sur une dépense minimale de $500 à $2 000 par mois. Pour les start-ups en exploration de product-market fit, prépayer des milliers de dollars avant de livrer des fonctionnalités visibles par l'utilisateur introduit une consommation de trésorerie inutile.
- Obstacles de paiement : les contrats officiels exigent des virements bancaires d'entreprise nationaux ou des numéros d'enregistrement fiscal spécifiques, ce qui représente des obstacles insurmontables pour les développeurs internationaux sans entité juridique chinoise.
2. Hébergeurs de conteneurs serverless génériques (Replicate, RunPod Serverless, Beam)
- L'argument : déployer des poids ouverts ou propriétaires dans des conteneurs Docker serverless sans gestion d'infrastructure.
- La réalité : les plateformes de conteneurs ne facturent pas les secondes de vidéo générative produites, mais la durée d'exécution du GPU. Lorsqu'une requête de génération vidéo arrive sur un nœud de travail froid, le système doit charger un checkpoint de modèle de 18 Go en VRAM. Ce démarrage à froid nécessite 15 à 30 secondes de temps de calcul, intégralement facturées sur votre solde avant même que la première image vidéo ne soit rendue.
- La taxe du démarrage à froid : si un rendu de 5 secondes prend 18 secondes d'inférence plus 20 secondes de démarrage du conteneur, vous êtes facturé 38 secondes de calcul NVIDIA A100/H100. Le coût unitaire effectif double, effaçant complètement toute remise affichée en titre.
3. Agrégateurs média spécialisés (Fal.ai, Novita, Kie.ai)
- L'argument : des plateformes pensées pour les développeurs, avec des endpoints média curationnés, des API plus propres et un support communautaire.
- La réalité : bien que ces plateformes éliminent les démarrages à froid en maintenant des pools GPU pré-chauffés, elles appliquent une marge commerciale significative (généralement 40 % à 60 % au-dessus du calcul matériel de gros). En outre, plusieurs fournisseurs exploitent des systèmes de comptabilité propriétaires en « crédits » qui masquent le coût réel par seconde en dollars, ce qui complique le rapprochement financier pour les équipes FinOps.
4. Passerelles de modèles d'IA unifiées (ToAPIs)
- L'argument : répercussion directe du calcul de gros combinée à un basculement multi-fournisseurs de niveau entreprise.
- La réalité : ToAPIs agrège des dizaines de millions de secondes de génération vidéo sur des milliers de produits d'IA mondiaux. En engageant des millions de dollars d'utilisation continue de clusters GPU directement auprès de partenaires d'infrastructure de niveau 1, ToAPIs obtient des remises de volume institutionnelles de premier plan.
- Répercussion directe : ToAPIs transmet ces tarifs de gros directement aux développeurs à $0.028 / seconde en 720p et $0.048 / seconde en 1080p, éliminant totalement les engagements minimums, les barrières d'intégration et les pénalités de démarrage à froid.
4. Ingénierie pure : 4 pièges cachés lors du choix de l'API Seedance 2.0
Le tarif à la seconde affiché en titre n'est qu'une composante du coût total de possession. Les équipes d'ingénierie de production rencontrent régulièrement quatre pièges de coût sévères qui gonflent les factures cloud mensuelles :
| Piège de coût caché | Ce qu'il vous coûte réellement |
|---|---|
| 1. Le démarrage à froid inactif | 15 à 30 s d'initialisation de conteneur GPU facturées |
| 2. Fuites d'erreurs amont | Facturation pour OOM CUDA ou rejets du filtre de sécurité |
| 3. Limitation multiplexée | Les proxys partagés déclenchent des cascades HTTP 429 |
| 4. Multiplicateurs de résolution | Le saut de coût de 1,71x entre 720p et 1080p |
Piège 1 : la taxe du « démarrage à froid inactif »
Dans les architectures à base de conteneurs, les poids de diffusion vidéo ne peuvent pas rester résidents en permanence dans la VRAM du GPU pendant les périodes de faible trafic sans payer d'énormes frais continus de serveur inactif ($2,50 à $4,50 par heure de GPU). Lorsque le trafic augmente, les conteneurs sont démarrés dynamiquement :
Si une instance démarre pendant 25 secondes et exécute une tâche d'inférence de 18 secondes à $0.0011 par seconde de GPU, votre vidéo unique de 5 secondes coûte $0.0473 en calcul brut. Sur ToAPIs, la même vidéo de 5 secondes en 720p coûte un tarif fixe de $0.140 sans aucun démarrage à froid, car les requêtes passent par des clusters entreprise préalloués et chauffés en permanence.
Piège 2 : déductions pour échecs amont et filtres de sécurité
Les pipelines de diffusion vidéo générative rencontrent parfois des erreurs de mémoire CUDA insuffisante, des délais d'attente réseau distribués ou des faux positifs de modération automatique de sécurité.
Des fournisseurs proxy à bas prix peu scrupuleux débitent le solde dès l'envoi de la requête, quel que soit le résultat :
- Si la tâche échoue à 90 % d'achèvement, votre solde est consommé.
- Si un prompt de contenu déclenche un faux avertissement de sécurité, l'inférence échouée vous est facturée.
La politique zéro risque de ToAPIs : la facturation de la tâche intervient strictement à l'émission d'un code de statut succeeded accompagné d'une URL d'actif média vérifiable. Toute tâche renvoyant failed, timed_out ou rejected est facturée strictement $0.00.
Piège 3 : limitation de débit multiplexée et cascades de 429
Les proxys d'API à bas coût réduisent souvent leurs dépenses en regroupant les requêtes via des comptes web grand public partagés ou des clusters de proxy inverse mutualisés. Aux heures de pointe (14h00 à 22h00 UTC), ces pools partagés dépassent les seuils de concurrence amont, provoquant des rafales massives de HTTP 429 Too Many Requests.
Lorsque les clients en aval tentent des reprises non coordonnées, l'ensemble du système entre dans une tempête de reprises qui verrouille les workers de production. ToAPIs atténue ce risque avec des allocations dédiées de clusters entreprise et un routeur de basculement automatique intégré qui redistribue la charge sans interruption entre les nœuds de calcul sains.
Piège 4 : la mathématique des multiplicateurs de résolution et de durée
Les développeurs supposent fréquemment que générer en 1080p Full HD coûte à peine plus cher qu'en 720p. Or la mathématique des pixels gouverne la complexité de diffusion :
Comme les mécanismes d'attention en diffusion vidéo évoluent de manière superlinéaire avec les tokens spatiaux et temporels, la génération en 1080p entraîne une pénalité de calcul significative. Sur ToAPIs :
- Tarif de base 720p : $0.028 / s
- Tarif 1080p Full HD : $0.048 / s (un multiplicateur de 1,71x, nettement inférieur à l'expansion de pixels de 2,25x)
Ne pas imposer de valeurs de résolution par défaut strictes dans les applications client frontend peut entraîner des générations accidentelles en 1080p, augmentant les dépenses de génération de 71 % du jour au lendemain.
5. Le business case FinOps : calcul de ROI réel et plan de migration
Pour justifier la migration de l'infrastructure vidéo auprès de la direction, les responsables techniques ont besoin de modèles financiers concrets démontrant un retour sur investissement quantifiable.
Scénario de production A : pipeline de vidéos courtes e-commerce à haut débit
- Cas d'usage : génération programmatique de vidéos produit verticales 9:16 pour TikTok et Instagram Reels.
- Volume mensuel : 5 000 clips vidéo terminés.
- Spécifications du clip : 5 secondes par clip, rendues en 720p HD.
- Calcul total généré :
5 000 clips * 5 secondes = 25 000 secondes de vidéo.
Ventilation des coûts
Économies financières directes
Scénario de production B : studio de marketing digital HD commercial
- Cas d'usage : publicités vidéo cinématographiques grand écran (16:9) de qualité studio.
- Volume mensuel : 10 000 clips vidéo terminés.
- Spécifications du clip : 5 secondes par clip, rendues en 1080p Full HD.
- Calcul total généré :
10 000 clips * 5 secondes = 50 000 secondes de vidéo.
Ventilation des coûts
Économies financières directes
Dans le scénario B, passer à la passerelle de l'API Seedance 2.0 la moins chère économise $16 200 USD par an, libérant du capital pour l'acquisition d'utilisateurs et le développement produit.
6. Le guide de migration en 5 minutes sans refactoring
Comme ToAPIs respecte strictement la spécification REST vidéo unifiée compatible OpenAI, migrer une base de code existante ne demande que la modification de deux variables d'environnement :
# Avant : contrat officiel direct ou SDK propriétaire
export SEEDANCE_BASE_URL="https://volcengineapi.bytedance.com/v1"
export SEEDANCE_API_KEY="volc-access-key-id:secret-access-key"

# Après : passerelle de gros unifiée
export SEEDANCE_BASE_URL="https://api.toapis.com/v1"
export SEEDANCE_API_KEY="sk-toapis-your-production-token"
Modèle complet de basculement multi-modèles en TypeScript / Node.js
Pour les services web d'entreprise exigeant une haute fiabilité, l'extrait TypeScript suivant démontre le basculement automatisé entre Seedance 2.0 et Seedance 2.5 :
import axios from "axios";

interface VideoTaskResponse {
  id: string;
  status: "processing" | "succeeded" | "failed";
  video_url?: string;
  error?: string;
}

const TOAPIS_BASE_URL = "https://api.toapis.com/v1";
const API_KEY = process.env.TOAPIS_API_KEY;

export async function generateVideoWithFallback(
  prompt: string,
  resolution: "720p" | "1080p" = "720p"
): Promise<string> {
  const models = ["seedance-2", "seedance-2-5"];

  for (const model of models) {
    try {
      console.log(`[VideoGateway] Tentative de génération avec le modèle : ${model}`);

      const submitResp = await axios.post<VideoTaskResponse>(
        `${TOAPIS_BASE_URL}/videos/generations`,
        {
          model,
          prompt,
          resolution,
          duration: 5,
          aspect_ratio: "16:9"
        },
        {
          headers: {
            Authorization: `Bearer ${API_KEY}`,
            "Content-Type": "application/json"
          },
          timeout: 10000
        }
      );

      const taskId = submitResp.data.id;
      return await pollTask(taskId);
    } catch (err: any) {
      console.warn(`[VideoGateway] Le modèle ${model} a échoué ou expiré : ${err.message}. Nouvelle tentative de repli...`);
    }
  }

  throw new Error("Tous les fournisseurs de vidéo générative ont échoué à produire l'actif.");
}

async function pollTask(taskId: string): Promise<string> {
  const maxAttempts = 30;
  for (let i = 0; i < maxAttempts; i++) {
    await new Promise((res) => setTimeout(res, 3000));
    const resp = await axios.get<VideoTaskResponse>(
      `${TOAPIS_BASE_URL}/tasks/video-status?task_id=${taskId}`,
      { headers: { Authorization: `Bearer ${API_KEY}` } }
    );

    if (resp.data.status === "succeeded" && resp.data.video_url) {
      return resp.data.video_url;
    }
    if (resp.data.status === "failed") {
      throw new Error(`Échec du rendu en amont : ${resp.data.error}`);
    }
  }
  throw new Error(`La tâche ${taskId} a expiré après interrogation.`);
}
7. Questions fréquentes (FAQ)
Q1 : Où puis-je trouver l'API Seedance 2.0 la moins chère pour des charges de production ?
ToAPIs fournit l'accès vérifié le moins cher du marché mondial à l'API Seedance 2.0, à $0.028 par seconde en 720p et $0.048 par seconde en 1080p. Ce tarif représente une remise de 37,7 % par rapport aux contrats entreprise directs de ByteDance et élimine tous les seuils d'engagement mensuel.
Q2 : Pourquoi le tarif de l'API Seedance 2.0 est-il moins cher via ToAPIs qu'en direct ?
ToAPIs agit comme une passerelle institutionnelle de calcul d'IA, agrégeant le trafic de génération vidéo de milliers de start-ups, agences et entreprises en production dans le monde. En achetant des réservations massives de calcul auprès de clusters d'infrastructure GPU amont, ToAPIs obtient des paliers tarifaires de gros de niveau 1 auxquels les développeurs individuels ne peuvent pas accéder seuls, et répercute directement l'économie.
Q3 : En quoi les hébergeurs de conteneurs serverless créent-ils des coûts cachés pour la génération vidéo ?
Les clouds serverless à base de conteneurs facturent le temps de calcul GPU brut, et non la durée de la vidéo terminée. Lorsqu'un conteneur démarre depuis un état froid, le chargement de 18 Go de poids de modèle en mémoire prend 15 à 30 secondes de temps facturable avant que la diffusion ne commence. De plus, si la génération échoue à cause d'une erreur CUDA, le temps d'exécution du conteneur écoulé vous est tout de même facturé.
Q4 : Que se passe-t-il si une tâche d'inférence vidéo échoue ou est annulée ?
Sur ToAPIs, la facturation de la tâche dépend strictement du succès de la génération média. Toute requête aboutissant à FAILED, TIMED_OUT ou à un rejet de modération de contenu coûte strictement $0.00. Aucun solde n'est débité pour des rendus incomplets ou abandonnés.
8. Liste d'actions et prochaines étapes
- Créer un compte : inscrivez-vous sur ToAPIs.com pour recevoir des crédits de test initiaux.
- Accéder à votre clé unifiée : générez votre clé d'API de production dans le tableau de bord développeur ToAPIs.
- Configurer votre endpoint : pointez le client vidéo de votre application vers
https://api.toapis.com/v1/videos/generations. - Déployer un routage intelligent : dirigez par défaut la génération non critique vers 720p à $0.028/s et réservez le 1080p aux actifs phares destinés au client.
Guides et documentation associés
- 📖 Guide de démarrage rapide de l'API Seedance 2.0 - parcours d'intégration complet avec Node.js et Python.
- 📊 Analyse approfondie des tarifs Seedance 2.0 vs 2.5 - analyse des tarifs à la seconde et décomposition des multiplicateurs de résolution.
- ⚡ Matrice tarifaire ToAPIs - grilles tarifaires de gros en temps réel pour plus de 100 modèles d'IA multimodaux.