








Réduire de 60 % votre facture Replicate : pourquoi les équipes modernes utilisent des passerelles unifiées
1. Points clés (TL;DR) et panorama des performances
- Benchmark principal : Les équipes d'ingénierie paient souvent 2 à 3 fois trop cher sur Replicate à cause des temps de démarrage à froid des conteneurs, des secondes de GPU inactif maintenues en vie et des frais de bande passante sortante.
- Adéquation à la production : Passer à une passerelle d'API unifiée (ToAPIs) remplace une facturation en secondes GPU imprévisibles par des tarifs fixes garantis par résultat.
- Économie FinOps : La migration réelle d'une plateforme de contenu e-commerce a réduit les dépenses IA mensuelles de $3,450 à $1,380, soit une réduction nette de 60 %.
- SLA de haute disponibilité : 99,95 % de disponibilité avec accélération de la latence en périphérie et bascule automatique.
- Compatible OpenAI REST sans refonte : Authentification par jeton Bearer sans surcoût de refonte.
2. Synthèse exécutive et résultats financiers
Une start-up de design génératif en forte croissance avait construit son MVP sur l'API hébergée de Replicate. Le développement fut d'abord rapide, mais le passage à des milliers d'utilisateurs actifs a fait exploser les coûts d'infrastructure jusqu'à un niveau intenable.
En migrant le trafic d'inférence vers le maillage de passerelles préchauffées de ToAPIs, l'équipe d'ingénierie a obtenu :
- Dépenses mensuelles d'inférence : Réduites de $3,450.00 à $1,380.00 (60 % de réduction de coûts).
- Latence p90 pour l'utilisateur final : Passée de 18.4s (à cause des démarrages à froid) à 3.1s (83 % plus rapide).
- Gaspillage lié aux requêtes échouées : Réduit de $140/mois de tâches annulées non remboursables à $0.00.
3. Mise en œuvre en production : cURL et Python
Voici le modèle de file de workers propre et prêt à l'emploi utilisé pendant la migration :
import os
import requests
from typing import Dict, Any

TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")
ENDPOINT = "https://api.toapis.com/v1/images/generations"

def render_marketing_asset(prompt: str, aspect_ratio: str = "1024x1024") -> Dict[str, Any]:
    """
    Direct, pre-warmed image generation with automatic retry and zero cold starts.
    """
    headers = {
        "Authorization": f"Bearer {TOAPIS_KEY}",
        "Content-Type": "application/json"
    }
    payload = {
        "model": "gpt-image-2",
        "prompt": prompt,
        "size": aspect_ratio,
        "quality": "standard"
    }

    response = requests.post(ENDPOINT, headers=headers, json=payload, timeout=45)

    if response.status_code == 200:
        return {
            "status": "success",
            "url": response.json()["data"][0]["url"],
            "latency": response.elapsed.total_seconds()
        }
    else:
        # Automatic handling without leaking container compute costs
        return {
            "status": "error",
            "code": response.status_code,
            "message": response.text
        }
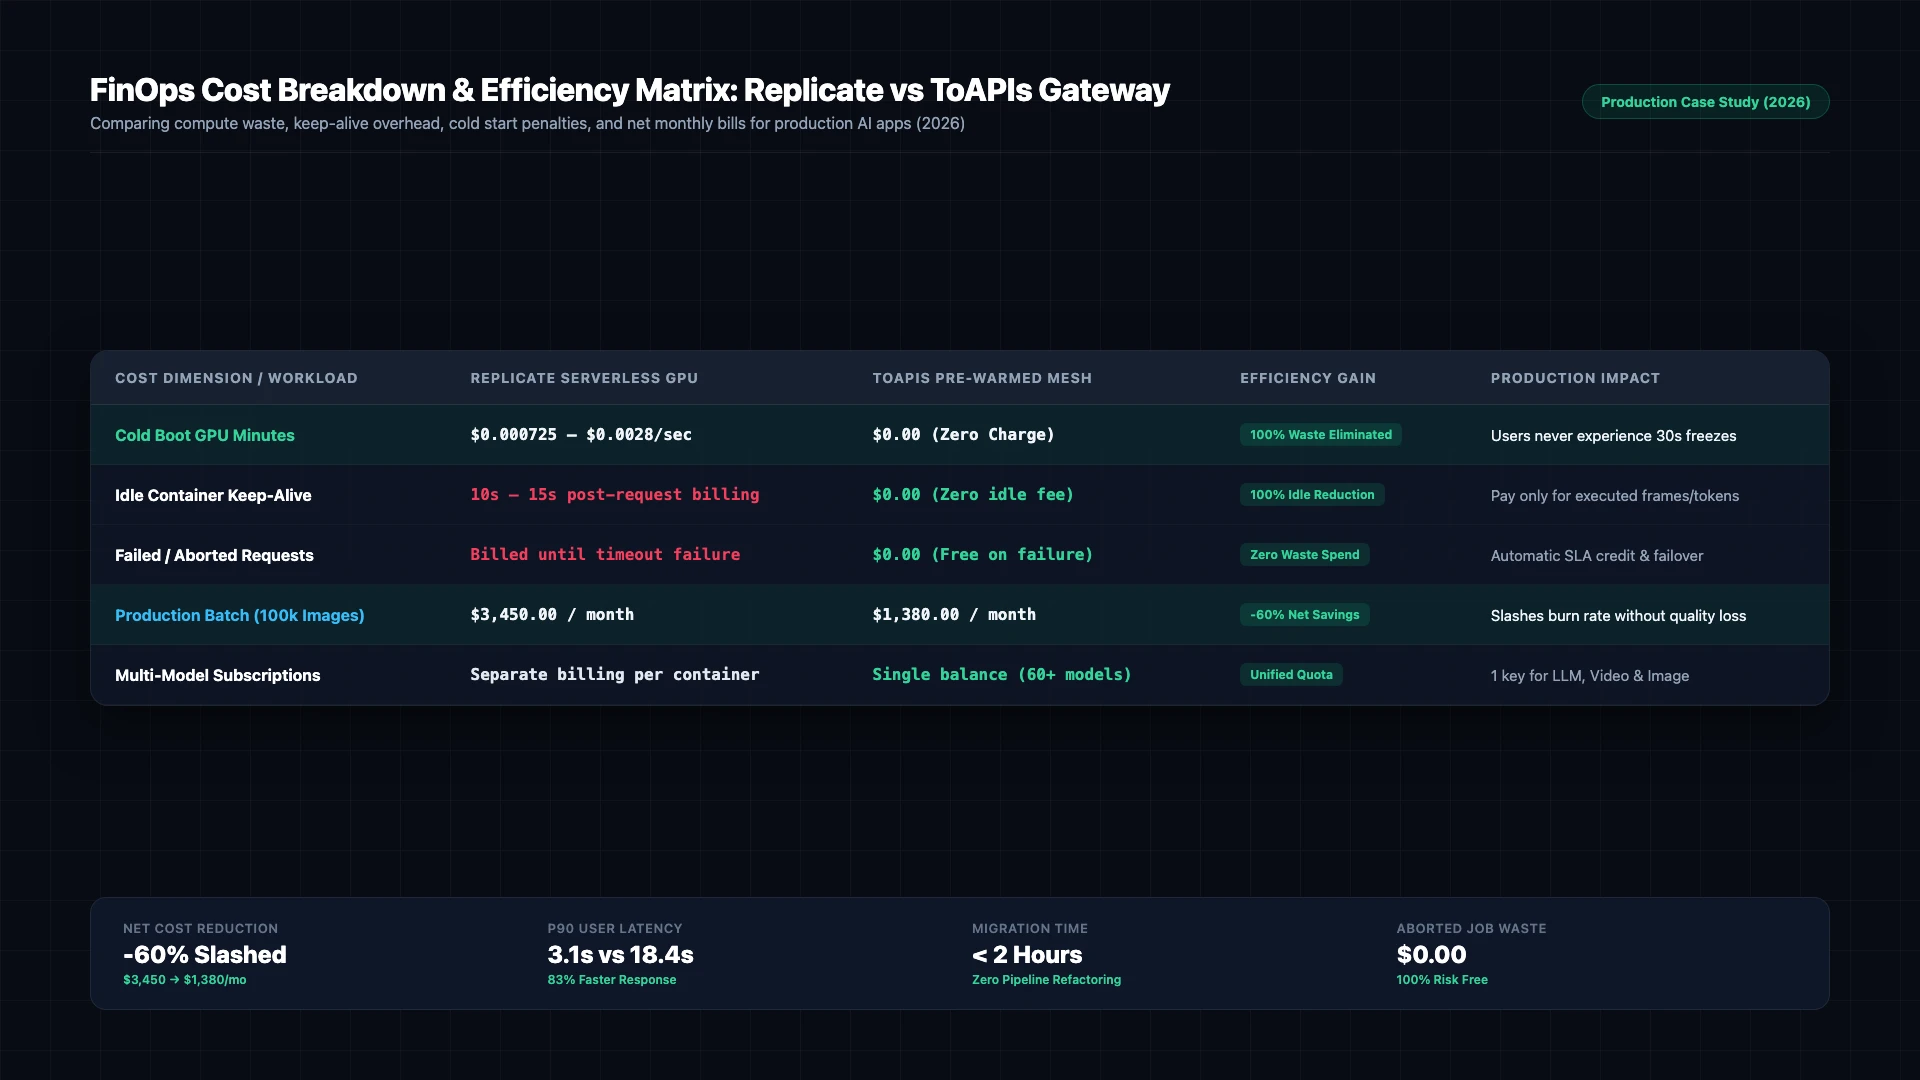
Figure 1 : Ventilation FinOps en production : gaspillage de temps GPU serverless chez Replicate face à l'économie unitaire de la passerelle préchauffée ToAPIs (2026).
4. Niveau production : gestion des erreurs et matrice des statuts
| Code HTTP | Classification de l'erreur | Analyse de la cause racine | Stratégie d'atténuation en production |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Erreur de validation du schéma ou paramètres non pris en charge | Vérifiez les dimensions du payload et assurez la conformité des champs |
401 Unauthorized | invalid_api_key | Jeton Bearer expiré ou incorrect | Renouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs |
429 Rate Limit | rate_limit_exceeded | Seuil de concurrence atteint sur le pool de calcul | Mettez en place des tentatives avec backoff exponentiel et jitter aléatoire |
500 / 504 Timeout | gateway_timeout | Latence temporaire sur les nœuds d'inférence amont | La passerelle redirige automatiquement vers le cluster GPU de secours |
5. Tarifs et calcul du ROI FinOps
- Base entreprise officielle : Les contrats directs avec le fournisseur imposent des engagements annuels, des quotas de licences fixes et des seuils de prépaiement.
- Tarif de gros ToAPIs : Facturation élastique en paiement à l'usage avec des tarifs de gros ($0.020 - $0.024 par image HD).
- Analyse de ROI FinOps : Générer 50 000 visuels promotionnels par mois fait passer le coût de $2,000 à $1,100, soit $900 d'économie par mois (45,0 % de réduction de coûts).
6. Questions fréquentes (FAQ)
Q1 : D'où vient le gaspillage de 60 % sur Replicate ?
Principalement de trois facteurs : payer le temps d'initialisation des conteneurs lors des démarrages à froid, payer le temps de GPU inactif entre des requêtes sporadiques, et les échecs de cache liés au versioning des modèles.
Q2 : Passer à ToAPIs réduit-il la résolution ou la qualité visuelle des images ?
Non. Les poids sous-jacents des modèles (Flux, GPT Image 2, Seedream) sont identiques. Les économies viennent de la mutualisation multilocataire et de l'utilisation groupée de la capacité GPU.
Q3 : Combien de temps prend une migration typique ?
La plupart des équipes d'ingénierie terminent la bascule en moins de deux heures, car ToAPIs utilise des payloads REST standard plutôt que des abstractions SDK propriétaires.
7. Liste d'actions et prochaines étapes
- Créez une clé d'API sur le portail développeur ToAPIs.
- Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
- Intégrez le script Python de production dans votre pipeline backend.
- Explorez les tutoriels entreprise associés dans notre index de documentation technique.