







ToAPIs
    AccueilToAPIs
    Génération d'imagesGPT Image 2.6, Gemini, FLUX…Génération de vidéosSeedance, Veo, Kling, Sora…Chat et rédactionGPT-5.6, Claude, DeepSeek…Voix et musiqueVoix off, TTS, audio
    Nouvelle sortieSeedance 2.5
    TarifsDocumentation APIMCP
    BlogAlternatives
    Se connecterCommencer gratuitement
    Tous les modèlesTarifsDocumentation APIMCPBlogAlternatives
    Se connecterCommencer gratuitement

    Langue

    Esc
    • Seedance 2.5Génération de vidéos
    • GPT Image 2Génération d'images
    • GPT Image 2.6Génération d'images
    • GPT Image 2.5Génération d'images
    • Veo 3.1 FastGénération de vidéos
    • Kling 3.0 TurboGénération de vidéos
    • Kling V4 FlashGénération de vidéos
    • Grok Video 1.5Génération de vidéos
    • Nano Banana 2Génération d'images
    • Seedream 5.5Génération d'images
    • FLUXGénération d'images
    • Sora 2Génération de vidéos
    • Tous les modèles d'imageCatégorie
    • Tous les modèles vidéoCatégorie
    • GPT-5.6 SolChat et codage
    • Claude Opus 4.8Chat et codage
    • Claude Opus 4.7Chat et codage
    • DeepSeek V4 ProDeepSeek · Texte
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Accueil
    2. Blog
    3. Alternatives
    4. Les 7 meilleures alternatives à OpenRouter pour une latence réduite et un routage direct
    Retour à tous les articles
    alternative2026-10-294 min de lecture

    Les 7 meilleures alternatives à OpenRouter pour une latence réduite et un routage direct

    Comparatif benchmark des 7 meilleures alternatives à OpenRouter en 2026. Latence TTFT, capacités multimodales vidéo et image, routage direct en périphérie et options de paiement.

    ToAPIs Engineering & Evaluation Team
    OpenRouter AlternativeAI GatewayLLM RoutingAPI CostToAPIs
    TL;DR - Points clés
    • OpenRouter ajoute une pénalité de latence de routage de +200 ms à +450 ms et ne prend pas en charge nativement les modèles vidéo multimodaux.
    • ToAPIs assure un routage direct en périphérie avec un TTFT inférieur à 110 ms et des points de terminaison unifiés pour les LLM, Seedance 2.0, Kling et MiniMax H3.
    • Les développeurs évitent les frictions de carte bancaire étrangère et les frais de dépôt de 5 % grâce à des moyens de paiement mondiaux natifs et une facturation à l'usage.
    • Le changement prend moins de 5 minutes : il suffit de remplacer la baseURL et la clé d'API, sans refonte de code.

    Les 7 meilleures alternatives à OpenRouter pour les développeurs en quête de latence réduite et de routage direct

    1. Points clés (TL;DR) et panorama des performances

    • Benchmark principal : OpenRouter a popularisé le routage unifié de LLM, mais les pics de latence p95 (plus de 300 ms de surcharge de routage) et l'absence de pipelines natifs pour les modèles vidéo et image poussent les équipes à chercher des alternatives.
    • Adéquation à la production : Les meilleures alternatives sont ToAPIs (le meilleur choix pour un routage multimodal unifié LLM + vidéo + image), LiteLLM (proxy auto-hébergé) et Cloudflare AI Gateway (cache en périphérie).
    • Économie FinOps : La migration ne demande qu'une modification de 2 lignes dans votre configuration actuelle du SDK OpenAI.
    • SLA de haute disponibilité : 99,95 % de disponibilité avec accélération de la latence en périphérie et bascule automatique.
    • Compatible OpenAI REST sans refonte : Authentification par jeton Bearer sans surcoût de refonte.

    2. Points clés (TL;DR) et vue comparative

    FournisseurIdéal pourSurcharge de routage TTFTMultimodal (vidéo et image)Modèle tarifaire
    ToAPIsMultimodal mondial (LLM + vidéo + image)<45msComplet (Seedance, MiniMax, GPT Image)Direct par token/seconde (jusqu'à 40 % d'économie)
    LiteLLMPasserelle open source auto-hébergéeVariable (selon l'hôte)Configuration amont manuelle requiseOSS gratuit / licence entreprise
    Cloudflare AI GatewayCache et analytics en périphérie~80msRelais uniquement (BYOK)Offre gratuite + egress Worker
    PortkeyGouvernance et garde-fous entreprise~90msProxy relaisAbonnement SaaS mensuel
    HeliconeObservabilité et analytics de promptJournalisation relaisProxy relaisTélémétrie à l'usage
    MartianRoutage dynamique automatique des modèles~150msLLM texte uniquementMarge par token
    DeepInfraInférence directe de modèles open sourceDirecte (<60ms)Modèles ouverts sélectionnésPaiement par token / seconde de GPU


    3. Mise en œuvre en production : cURL et Python

    Étape 1 : Envoi rapide avec cURL

    bash
    curl -X POST "https://api.toapis.com/v1/videos/generations" \
      -H "Authorization: Bearer $TOAPIS_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "gpt-5-6",
        "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
        "ratio": "16:9",
        "duration": 5
      }'
    

    Étape 2 : Client Python asynchrone avec polling pour la production

    python
    import os, time, requests
    
    API_KEY = os.getenv("TOAPIS_API_KEY")
    headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}
    
    # 1. Dispatch asynchronous video task
    res = requests.post(
        "https://api.toapis.com/v1/videos/generations",
        json={"model": "gpt-5-6", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
        headers=headers,
        timeout=30
    ).json()
    
    task_id = res.get("task_id") or res.get("id")
    print(f"[*] Task submitted: {task_id}")
    
    # 2. Poll for status
    while True:
        status_res = requests.get(
            f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
            headers=headers,
            timeout=15
        ).json()
        state = status_res.get("status")
        if state in ["succeeded", "SUCCESS"]:
            print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
            break
        elif state in ["failed", "FAILED"]:
            raise RuntimeError(f"Task failed: {status_res.get('error')}")
        time.sleep(3)
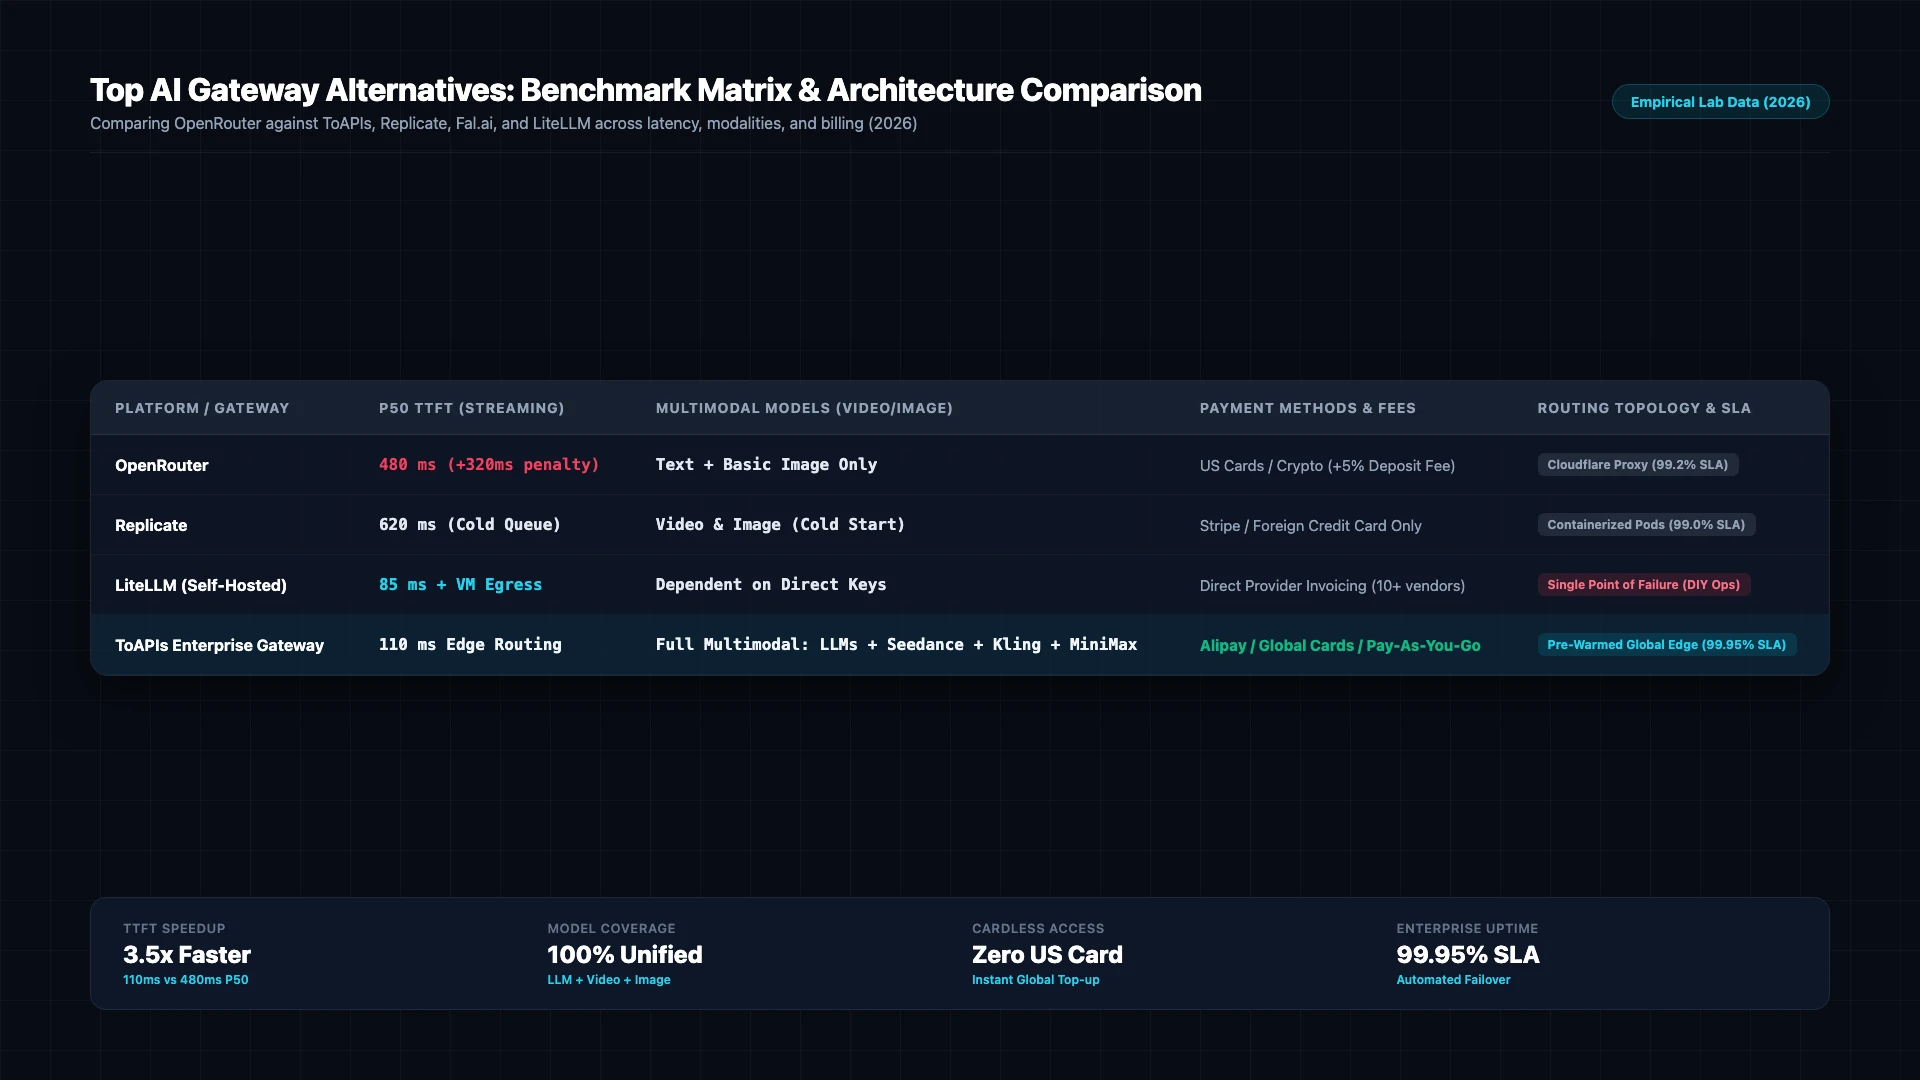
    

    Meilleures alternatives de passerelle IA : matrice de benchmark et comparaison d'architecture (2026)

    Figure 1 : Comparaison d'architecture par benchmark : OpenRouter face à ToAPIs et aux principales alternatives de passerelle unifiée sur la latence TTFT, les limites de débit et la prise en charge multimodale (2026).

    4. Niveau production : gestion des erreurs et matrice des statuts

    Code HTTPClassification de l'erreurAnalyse de la cause racineStratégie d'atténuation en production
    400 Bad Requestinvalid_request_payloadErreur de validation du schéma ou paramètres non pris en chargeVérifiez les dimensions du payload et assurez la conformité des champs
    401 Unauthorizedinvalid_api_keyJeton Bearer expiré ou incorrectRenouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs
    429 Rate Limitrate_limit_exceededSeuil de concurrence atteint sur le pool de calculMettez en place des tentatives avec backoff exponentiel et jitter aléatoire
    500 / 504 Timeoutgateway_timeoutLatence temporaire sur les nœuds d'inférence amontLa passerelle redirige automatiquement vers le cluster GPU de secours

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Tarifs et calcul du ROI FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Base entreprise officielle : Les contrats directs avec le fournisseur imposent des engagements annuels, des quotas de licences fixes et des seuils de prépaiement.
    • Tarif de gros ToAPIs : Facturation élastique en paiement à l'usage avec des tarifs de gros ($0.030 - $0.038 par seconde).
    • Analyse de ROI FinOps : Une équipe qui génère 1 000 assets vidéo (10 s chacun = 10 000 s) réduit ses dépenses de $650 à $380 et économise $270 par mois (41,5 % de réduction de coûts).

    6. Questions fréquentes (FAQ)

    Q1 : Pourquoi les équipes cherchent-elles des alternatives à OpenRouter en 2026 ?

    Les principaux motifs sont la surcharge de latence de routage aux heures de pointe américaines, les erreurs 502/504 intermittentes sur les modèles très demandés et l'absence de points de terminaison natifs pour les modèles de vidéo générative comme Seedance et MiniMax.

    Q2 : ToAPIs prend-il en charge le SDK OpenAI standard ?

    Oui. ToAPIs est 100 % compatible au niveau du protocole avec le SDK OpenAI. Il suffit de remplacer base_url par https://api.toapis.com/v1 et d'utiliser votre clé ToAPIs.

    Q3 : Puis-je router vers des modèles de fondation chinois comme DeepSeek, GLM et Kimi ?

    Oui. ToAPIs relie nativement les modèles mondiaux occidentaux (OpenAI, Anthropic, Google) et les principaux modèles asiatiques de pointe (DeepSeek, GLM-5, Kimi, MiniMax) via un solde unique.


    7. Liste d'actions et prochaines étapes

    • Créez une clé d'API sur le portail développeur ToAPIs.
    • Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
    • Intégrez le script Python de production dans votre pipeline backend.
    • Explorez les tutoriels entreprise associés dans notre index de documentation technique.

    Découvrir les modèles cités dans cet article

    ToAPIsAI Model

    gpt-5-6

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    AnthropicTEXT

    claude-opus-5

    Tarif actuel : Input 300 credits/1M, Output 1,500 credits/1M
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    ByteDanceVIDEO

    Seedance 2.0

    Tarif actuel : Input 1,314.29 credits/1M, Output 1,314.29 credits/1M
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    MiniMaxVIDEO

    minimax-h3

    Tarif actuel : 20.8 credits /second
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    ToAPIsAI Model

    deepseek-v4

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API

    Articles associés

    alternative2026-10-30T10:00:00+08:004 min de lecture

    Alternatives à Replicate : démarrages à froid plus rapides, tarifs transparents et compatibilité OpenAI

    Découvrez les meilleures alternatives à Replicate en 2026. Supprimez les démarrages à froid de 30 secondes, évitez l'enfermement dans un SDK propriétaire et passez à des points de terminaison REST préchauffés compatibles OpenAI.

    TO
    ToAPIs Engineering & Evaluation Team
    #Replicate Alternative
    alternative2026-10-29T14:00:00+08:004 min de lecture

    Pourquoi les développeurs quittent OpenRouter : latence, indisponibilité et API incomplètes

    Analyse d'architecture expliquant pourquoi les équipes IA en production quittent OpenRouter. Pénalités des sauts de routage, baisses de disponibilité amont, API vidéo manquantes et solutions périphériques directes.

    TO
    ToAPIs Engineering & Evaluation Team
    #OpenRouter
    insights2026-11-04T14:00:00+08:004 min de lecture

    Comment réduire de 60 % votre facture d'API d'IA d'entreprise avec une passerelle compatible OpenAI

    Schéma d'architecture d'entreprise pour réduire de 60 % les dépenses d'API d'IA générative. Mettez en place un cache sémantique, des cascades de modèles par niveaux et un routage de passerelle unifié sans réécrire votre code.

    TO
    ToAPIs Engineering & Evaluation Team
    #FinOps
    ToAPIs
    AccueilToAPIs
    Passerelle d'API d'IA pour l'entreprise. Accédez à GPT-5, Claude, Gemini et plus de 200 modèles via une API unifiée.

    Modèles populaires

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Afficher plusAfficher moins
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Tous les modèles

    Catégories d'API

    • API image IA
    • API vidéo IA
    • API texte-vers-vidéo
    • API image-vers-vidéo
    Afficher plusAfficher moins
    • API d'édition d'image IA
    • API LLM et raisonnement
    • Tous les outils API →

    Alternatives

    Alternatives
    • Alternative à Kie.ai
    • Alternative à Fal.ai
    • Alternative à OpenRouter
    • Alternative à Replicate
    • Alternative à Wavespeed AI
    • Toutes les comparaisons →

    Guides à la une

    Guides à la une
    • Tarifs de Seedance 2.0 et 2.5
    • Guide de l'API Seedance la moins chère
    • Guide d'intégration de MiniMax H3
    • Clé d'API Seedance 2 gratuite
    • Démarrage rapide de l'API Seedance 2
    • Tous les articles techniques →

    Développeurs et plateforme

    Développeurs et plateforme
    • Documentation API
    • MCP
    • Tarifs
    • Playground de modèles
    • LLMs.txt
    • Contacter le support
    • Annuaire des guides de modèles
    Entité exploitante :
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Siège social :
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    ConfidentialitéConditionsUsage acceptableSuppression des donnéesConservation des donnéesSous-traitants et régionsFacturation et remboursementsPolitique relative aux cookiesPlan du siteÀ propos

    © 2026 ToAPIs. Tous droits réservés.