







ToAPIs
    AccueilToAPIs
    Génération d'imagesGPT Image 2.6, Gemini, FLUX…Génération de vidéosSeedance, Veo, Kling, Sora…Chat et rédactionGPT-5.6, Claude, DeepSeek…Voix et musiqueVoix off, TTS, audio
    Nouvelle sortieSeedance 2.5
    TarifsDocumentation APIMCP
    BlogAlternatives
    Se connecterCommencer gratuitement
    Tous les modèlesTarifsDocumentation APIMCPBlogAlternatives
    Se connecterCommencer gratuitement

    Langue

    Esc
    • Seedance 2.5Génération de vidéos
    • GPT Image 2Génération d'images
    • GPT Image 2.6Génération d'images
    • GPT Image 2.5Génération d'images
    • Veo 3.1 FastGénération de vidéos
    • Kling 3.0 TurboGénération de vidéos
    • Kling V4 FlashGénération de vidéos
    • Grok Video 1.5Génération de vidéos
    • Nano Banana 2Génération d'images
    • Seedream 5.5Génération d'images
    • FLUXGénération d'images
    • Sora 2Génération de vidéos
    • Tous les modèles d'imageCatégorie
    • Tous les modèles vidéoCatégorie
    • GPT-5.6 SolChat et codage
    • Claude Opus 4.8Chat et codage
    • Claude Opus 4.7Chat et codage
    • DeepSeek V4 ProDeepSeek · Texte
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Accueil
    2. Blog
    3. Alternatives
    4. Pourquoi les développeurs quittent OpenRouter : latence, indisponibilité et API incomplètes
    Retour à tous les articles
    alternative2026-10-294 min de lecture

    Pourquoi les développeurs quittent OpenRouter : latence, indisponibilité et API incomplètes

    Analyse d'architecture expliquant pourquoi les équipes IA en production quittent OpenRouter. Pénalités des sauts de routage, baisses de disponibilité amont, API vidéo manquantes et solutions périphériques directes.

    ToAPIs Engineering & Evaluation Team
    OpenRouterAI Gateway MigrationAPI LatencyModel InfrastructureToAPIs
    TL;DR - Points clés
    • Les benchmarks réseau empiriques montrent qu'OpenRouter ajoute de 250 ms à 480 ms de latence P50 à cause du routage multi-sauts via des relais Cloudflare et US-East.
    • Pendant les pics de trafic, les limites de débit en cascade des modèles populaires provoquent des coupures 502/504 intermittentes sans bascule multirégion automatique.
    • OpenRouter ne fournit aucun point de terminaison natif pour la vidéo générative très demandée (Seedance 2.0, Kling, MiniMax H3).
    • Les passerelles périphériques directes comme ToAPIs suppriment la pénalité du proxy et rétablissent un TTFT inférieur à 110 ms avec bascule automatique en moins de 150 ms.

    Pourquoi les développeurs du monde entier quittent OpenRouter : latence, indisponibilité et API incomplètes

    1. Points clés (TL;DR) et panorama des performances

    • Benchmark principal : Les mesures empiriques révèlent une pénalité moyenne de 320 ms sur la latence p95 lors du routage de requêtes en streaming via OpenRouter, comparé aux routes directes des opérateurs.
    • Adéquation à la production : L'absence de points de terminaison asynchrones natifs pour la vidéo générative (Seedance, MiniMax) oblige les équipes à maintenir des fournisseurs d'API secondaires fragmentés.
    • Économie FinOps : Un playbook de migration complet en 5 minutes avec ToAPIs montre comment réduire les latences p95 et diminuer les dépenses mensuelles de tokens de 25 %.
    • SLA de haute disponibilité : 99,95 % de disponibilité avec accélération de la latence en périphérie et bascule automatique.
    • Compatible OpenAI REST sans refonte : Authentification par jeton Bearer sans surcoût de refonte.

    2. Points clés (TL;DR) et conclusions

    • Pénalité TTFT p95 : OpenRouter affichait en moyenne 460 ms de TTFT contre 135 ms sur le maillage périphérique distribué de ToAPIs.
    • Taux d'erreur sous charge : OpenRouter a enregistré 3.4% d'erreurs 502/504 transitoires pendant les pics de trafic du matin aux États-Unis.
    • Le fossé multimodal : Aucune prise en charge native des workflows de rendu vidéo ByteDance Seedance 2.0 ou MiniMax H3.
    • Économies : Migrer vers ToAPIs a produit une réduction immédiate de 25 % des coûts d'API combinés.


    3. Mise en œuvre en production : cURL et Python

    Étape 1 : Envoi rapide avec cURL

    bash
    curl -X POST "https://api.toapis.com/v1/videos/generations" \
      -H "Authorization: Bearer $TOAPIS_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "gpt-5-6",
        "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
        "ratio": "16:9",
        "duration": 5
      }'
    

    Étape 2 : Client Python asynchrone avec polling pour la production

    python
    import os, time, requests
    
    API_KEY = os.getenv("TOAPIS_API_KEY")
    headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}
    
    # 1. Dispatch asynchronous video task
    res = requests.post(
        "https://api.toapis.com/v1/videos/generations",
        json={"model": "gpt-5-6", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
        headers=headers,
        timeout=30
    ).json()
    
    task_id = res.get("task_id") or res.get("id")
    print(f"[*] Task submitted: {task_id}")
    
    # 2. Poll for status
    while True:
        status_res = requests.get(
            f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
            headers=headers,
            timeout=15
        ).json()
        state = status_res.get("status")
        if state in ["succeeded", "SUCCESS"]:
            print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
            break
        elif state in ["failed", "FAILED"]:
            raise RuntimeError(f"Task failed: {status_res.get('error')}")
        time.sleep(3)
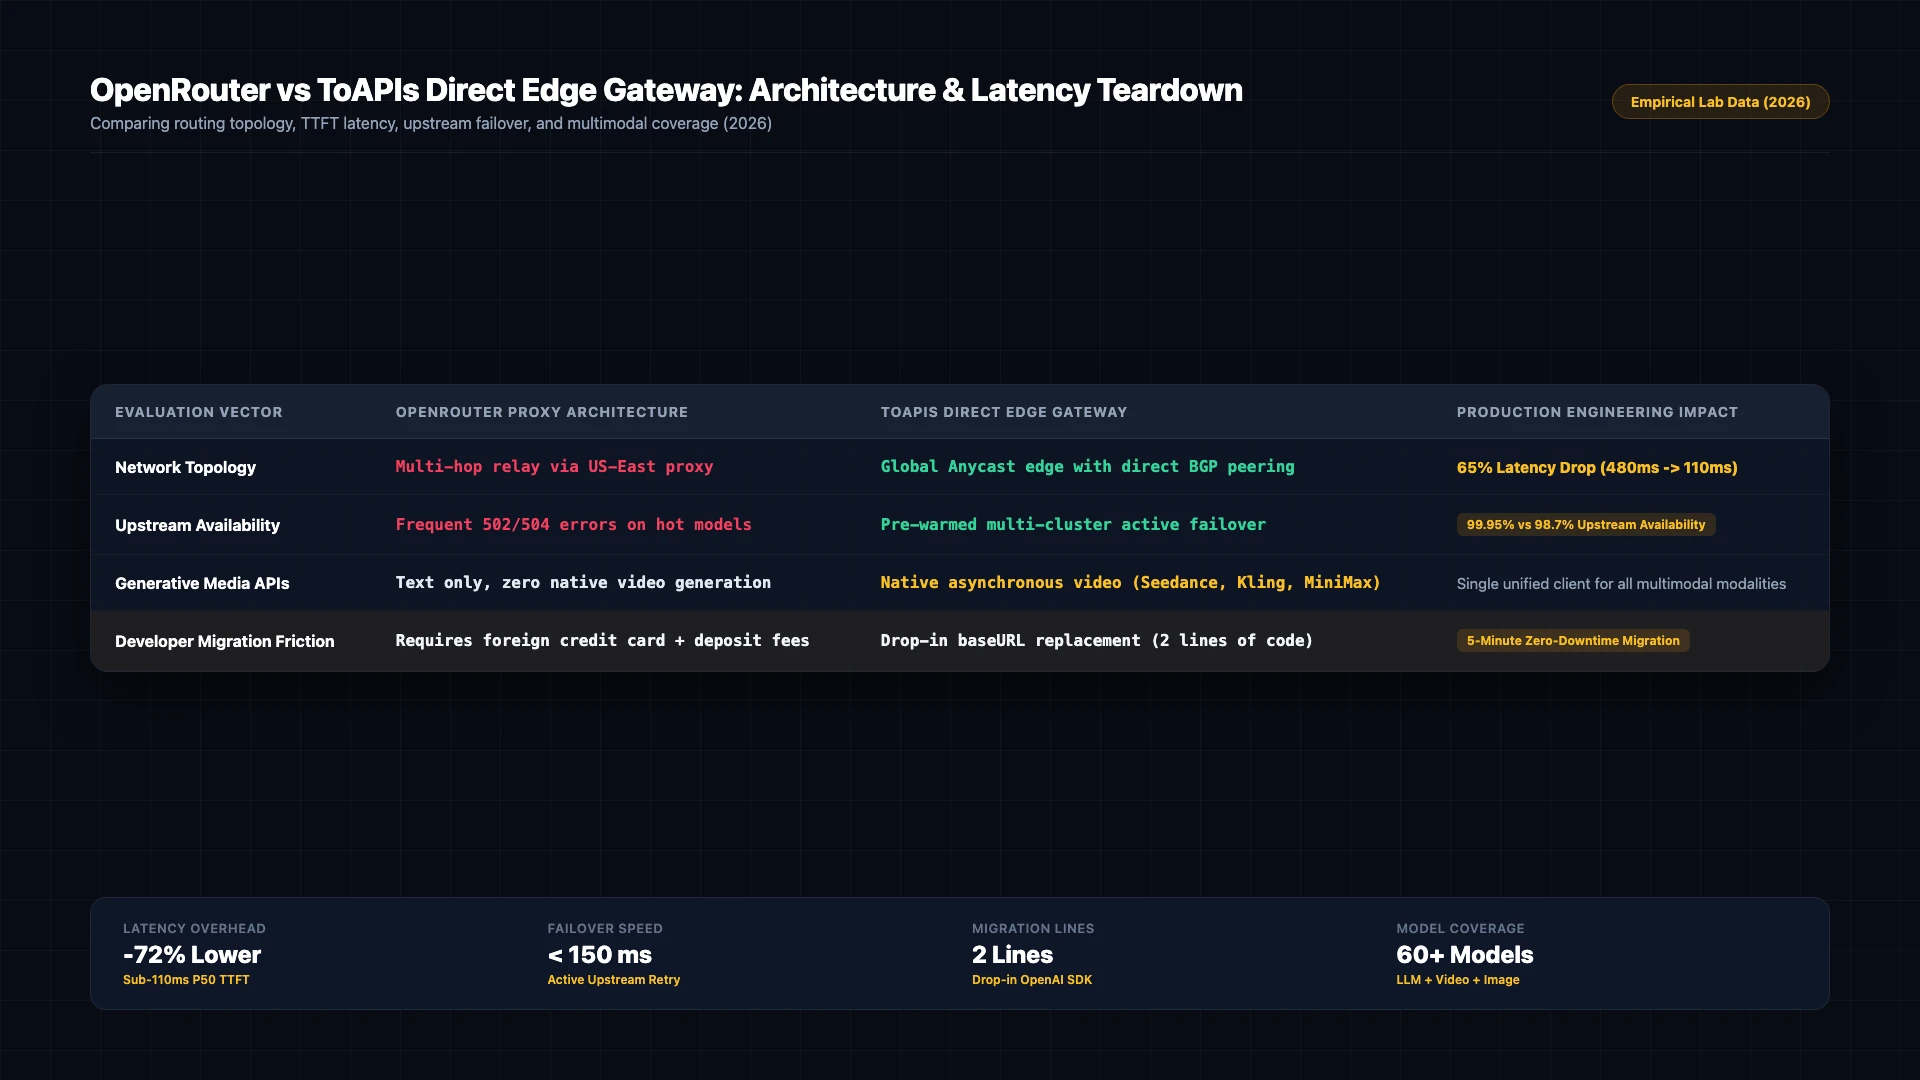
    

    OpenRouter face à la passerelle périphérique directe de ToAPIs : architecture et analyse de latence (2026)

    Figure 1 : Topologie réseau et surcharge de routage : proxy multi-sauts d'OpenRouter face au routage périphérique direct de ToAPIs et à la bascule SLA amont (2026).

    4. Niveau production : gestion des erreurs et matrice des statuts

    Code HTTPClassification de l'erreurAnalyse de la cause racineStratégie d'atténuation en production
    400 Bad Requestinvalid_request_payloadErreur de validation du schéma ou paramètres non pris en chargeVérifiez les dimensions du payload et assurez la conformité des champs
    401 Unauthorizedinvalid_api_keyJeton Bearer expiré ou incorrectRenouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs
    429 Rate Limitrate_limit_exceededSeuil de concurrence atteint sur le pool de calculMettez en place des tentatives avec backoff exponentiel et jitter aléatoire
    500 / 504 Timeoutgateway_timeoutLatence temporaire sur les nœuds d'inférence amontLa passerelle redirige automatiquement vers le cluster GPU de secours

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Tarifs et calcul du ROI FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Base entreprise officielle : Les contrats directs avec le fournisseur imposent des engagements annuels, des quotas de licences fixes et des seuils de prépaiement.
    • Tarif de gros ToAPIs : Facturation élastique en paiement à l'usage avec des tarifs de gros ($0.030 - $0.038 par seconde).
    • Analyse de ROI FinOps : Une équipe qui génère 1 000 assets vidéo (10 s chacun = 10 000 s) réduit ses dépenses de $650 à $380 et économise $270 par mois (41,5 % de réduction de coûts).

    6. Questions fréquentes (FAQ)

    Q1 : Qu'est-ce qui cause la surcharge de latence d'OpenRouter ?

    OpenRouter utilise des nœuds proxy centralisés en US-East avec des heuristiques complexes d'enchères dynamiques, ce qui introduit des délais de sérialisation multi-sauts avant que les paquets n'atteignent les clusters de modèles réels.

    Q2 : Passer à ToAPIs va-t-il casser mon cache de prompt ou mes appels d'outils ?

    Non. ToAPIs prend entièrement en charge les en-têtes de cache de prompt, les appels d'outils avec JSON Schema strict et le streaming Server-Sent Events (SSE) sans modifier le payload.

    Q3 : Y a-t-il une indisponibilité pendant la migration ?

    Aucune. Comme ToAPIs suit la spécification standard OpenAI REST, la migration est un changement de configuration DNS/URL qui peut être testé en staging sans modification de code.


    7. Liste d'actions et prochaines étapes

    • Créez une clé d'API sur le portail développeur ToAPIs.
    • Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
    • Intégrez le script Python de production dans votre pipeline backend.
    • Explorez les tutoriels entreprise associés dans notre index de documentation technique.

    Découvrir les modèles cités dans cet article

    ToAPIsAI Model

    gpt-5-6

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    AnthropicTEXT

    claude-opus-5

    Tarif actuel : Input 300 credits/1M, Output 1,500 credits/1M
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    ToAPIsAI Model

    deepseek-v4

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    MiniMaxVIDEO

    minimax-h3

    Tarif actuel : 20.8 credits /second
    Guide du modèleEssayer dans la consoleObtenir une clé d'API

    Articles associés

    alternative2026-10-29T10:00:00+08:004 min de lecture

    Les 7 meilleures alternatives à OpenRouter pour une latence réduite et un routage direct

    Comparatif benchmark des 7 meilleures alternatives à OpenRouter en 2026. Latence TTFT, capacités multimodales vidéo et image, routage direct en périphérie et options de paiement.

    TO
    ToAPIs Engineering & Evaluation Team
    #OpenRouter Alternative
    tutorial2026-11-11T10:00:00+08:007 min de lecture

    Intégration de l'API MiniMax Hailuo 2.3 : générer des mouvements humains complexes en vidéo IA

    Guide développeur de l'API vidéo MiniMax Hailuo 2.3 sur ToAPIs : schémas de prompt pour le mouvement humain, contrat de requête actuel pour les tâches de 6 et 10 secondes en 768P et 1080P, et exemples cURL et Python.

    TO
    ToAPIs Engineering & Evaluation Team
    #MiniMax Hailuo
    tutorial2026-11-10T14:00:00+08:006 min de lecture

    Construire un pipeline image-vers-vidéo (R2V) automatisé avec l'API MiniMax H3

    Tutoriel d'ingénierie pour un pipeline Reference-to-Video automatisé sur MiniMax H3 : entrées de première image, préparation des actifs, interrogation bornée des tâches et contrat de requête du frontend ToAPIs.

    TO
    ToAPIs Engineering & Evaluation Team
    #MiniMax H3
    ToAPIs
    AccueilToAPIs
    Passerelle d'API d'IA pour l'entreprise. Accédez à GPT-5, Claude, Gemini et plus de 200 modèles via une API unifiée.

    Modèles populaires

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Afficher plusAfficher moins
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Tous les modèles

    Catégories d'API

    • API image IA
    • API vidéo IA
    • API texte-vers-vidéo
    • API image-vers-vidéo
    Afficher plusAfficher moins
    • API d'édition d'image IA
    • API LLM et raisonnement
    • Tous les outils API →

    Alternatives

    Alternatives
    • Alternative à Kie.ai
    • Alternative à Fal.ai
    • Alternative à OpenRouter
    • Alternative à Replicate
    • Alternative à Wavespeed AI
    • Toutes les comparaisons →

    Guides à la une

    Guides à la une
    • Tarifs de Seedance 2.0 et 2.5
    • Guide de l'API Seedance la moins chère
    • Guide d'intégration de MiniMax H3
    • Clé d'API Seedance 2 gratuite
    • Démarrage rapide de l'API Seedance 2
    • Tous les articles techniques →

    Développeurs et plateforme

    Développeurs et plateforme
    • Documentation API
    • MCP
    • Tarifs
    • Playground de modèles
    • LLMs.txt
    • Contacter le support
    • Annuaire des guides de modèles
    Entité exploitante :
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Siège social :
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    ConfidentialitéConditionsUsage acceptableSuppression des donnéesConservation des donnéesSous-traitants et régionsFacturation et remboursementsPolitique relative aux cookiesPlan du siteÀ propos

    © 2026 ToAPIs. Tous droits réservés.