







ToAPIs
    AccueilToAPIs
    Génération d'imagesGPT Image 2.6, Gemini, FLUX…Génération de vidéosSeedance, Veo, Kling, Sora…Chat et rédactionGPT-5.6, Claude, DeepSeek…Voix et musiqueVoix off, TTS, audio
    Nouvelle sortieSeedance 2.5
    TarifsDocumentation APIMCP
    BlogAlternatives
    Se connecterCommencer gratuitement
    Tous les modèlesTarifsDocumentation APIMCPBlogAlternatives
    Se connecterCommencer gratuitement

    Langue

    Esc
    • Seedance 2.5Génération de vidéos
    • GPT Image 2Génération d'images
    • GPT Image 2.6Génération d'images
    • GPT Image 2.5Génération d'images
    • Veo 3.1 FastGénération de vidéos
    • Kling 3.0 TurboGénération de vidéos
    • Kling V4 FlashGénération de vidéos
    • Grok Video 1.5Génération de vidéos
    • Nano Banana 2Génération d'images
    • Seedream 5.5Génération d'images
    • FLUXGénération d'images
    • Sora 2Génération de vidéos
    • Tous les modèles d'imageCatégorie
    • Tous les modèles vidéoCatégorie
    • GPT-5.6 SolChat et codage
    • Claude Opus 4.8Chat et codage
    • Claude Opus 4.7Chat et codage
    • DeepSeek V4 ProDeepSeek · Texte
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Accueil
    2. Blog
    3. Analyses
    4. Comment réduire de 60 % votre facture d'API d'IA d'entreprise avec une passerelle compatible OpenAI
    Retour à tous les articles
    insights2026-11-044 min de lecture

    Comment réduire de 60 % votre facture d'API d'IA d'entreprise avec une passerelle compatible OpenAI

    Schéma d'architecture d'entreprise pour réduire de 60 % les dépenses d'API d'IA générative. Mettez en place un cache sémantique, des cascades de modèles par niveaux et un routage de passerelle unifié sans réécrire votre code.

    ToAPIs Engineering & Evaluation Team
    FinOpsCost ReductionAI GatewayEnterprise AIArchitecture
    TL;DR - Points clés
    • Les factures d'IA d'entreprise gonflent rapidement à cause de trois inefficacités structurelles : des prompts répétitifs sans cache sémantique, le routage de requêtes simples vers des modèles phares et des contrats fournisseurs fragmentés.
    • Une stratégie d'optimisation à trois piliers (cache de prompts + routage en cascade des modèles + agrégation de volume au niveau de la passerelle) récupère de façon fiable 60 % des dépenses mensuelles d'inférence.
    • Inclut une implémentation de passerelle en Python prête pour la production, avec classification automatique des prompts et routage de bascule.

    Comment réduire de 60 % votre facture d'API d'IA d'entreprise avec une passerelle compatible OpenAI

    1. TL;DR et vue d'ensemble des performances

    • Référence centrale : les factures d'IA d'entreprise gonflent rapidement à cause de trois inefficacités structurelles : des prompts répétitifs sans cache sémantique, le routage de requêtes simples vers des modèles phares et des contrats fournisseurs fragmentés.
    • Adhérence en production : une stratégie d'optimisation à trois piliers (cache de prompts + routage en cascade des modèles + agrégation de volume au niveau de la passerelle) récupère de façon fiable 60 % des dépenses mensuelles d'inférence.
    • Économie FinOps : inclut une implémentation de passerelle en Python prête pour la production, avec classification automatique des prompts et routage de bascule.
    • SLA de haute disponibilité : 99.95 % de disponibilité avec accélération de la latence en périphérie et bascule automatisée.
    • Compatible nativement avec OpenAI REST : authentification par jeton Bearer et zéro surcoût de refactorisation.

    2. Résumé pour la direction

    À mesure que l'IA générative passe des prototypes expérimentaux aux charges de travail centrales de l'entreprise, les factures d'API mensuelles grimpent souvent de quelques centaines à plusieurs dizaines de milliers de dollars.

    Sans gouvernance architecturale délibérée, jusqu'à 60 % des dépenses d'inférence sont gaspillées dans des calculs redondants, des modèles surdimensionnés et des tarifs fournisseurs non optimisés.

    Ce livre blanc présente le schéma d'ingénierie éprouvé que les startups à forte croissance utilisent pour réduire de 60 % leur facture d'inférence d'IA tout en maintenant ou en améliorant la latence et la précision.


    3. Mise en œuvre en production : cURL et Python

    Voici un schéma architectural qui implémente la cascade automatique et le routage au niveau de la passerelle :

    python
    import os
    import requests
    
    TOAPIS_BASE = "https://api.toapis.com/v1"
    TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")
    
    def execute_cost_optimized_completion(system_prompt: str, user_prompt: str, force_premium: bool = False) -> str:
        headers = {
            "Authorization": f"Bearer {TOAPIS_KEY}",
            "Content-Type": "application/json"
        }
    
        # Heuristic complexity detector
        is_complex = force_premium or len(user_prompt) > 2000 or "refactor" in user_prompt.lower()
        
        # Dynamic model selection
        selected_model = "claude-3-7-sonnet" if is_complex else "deepseek-v4"
    
        payload = {
            "model": selected_model,
            "messages": [
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_prompt}
            ],
            "temperature": 0.2
        }
    
        response = requests.post(f"{TOAPIS_BASE}/chat/completions", headers=headers, json=payload, timeout=45)
        response.raise_for_status()
        data = response.json()
        
        cost_tier = "Premium ($2.25/1M)" if is_complex else "Efficiency ($0.11/1M)"
        print(f"[Router] Model: {selected_model} | Tier: {cost_tier}")
        return data["choices"][0]["message"]["content"]
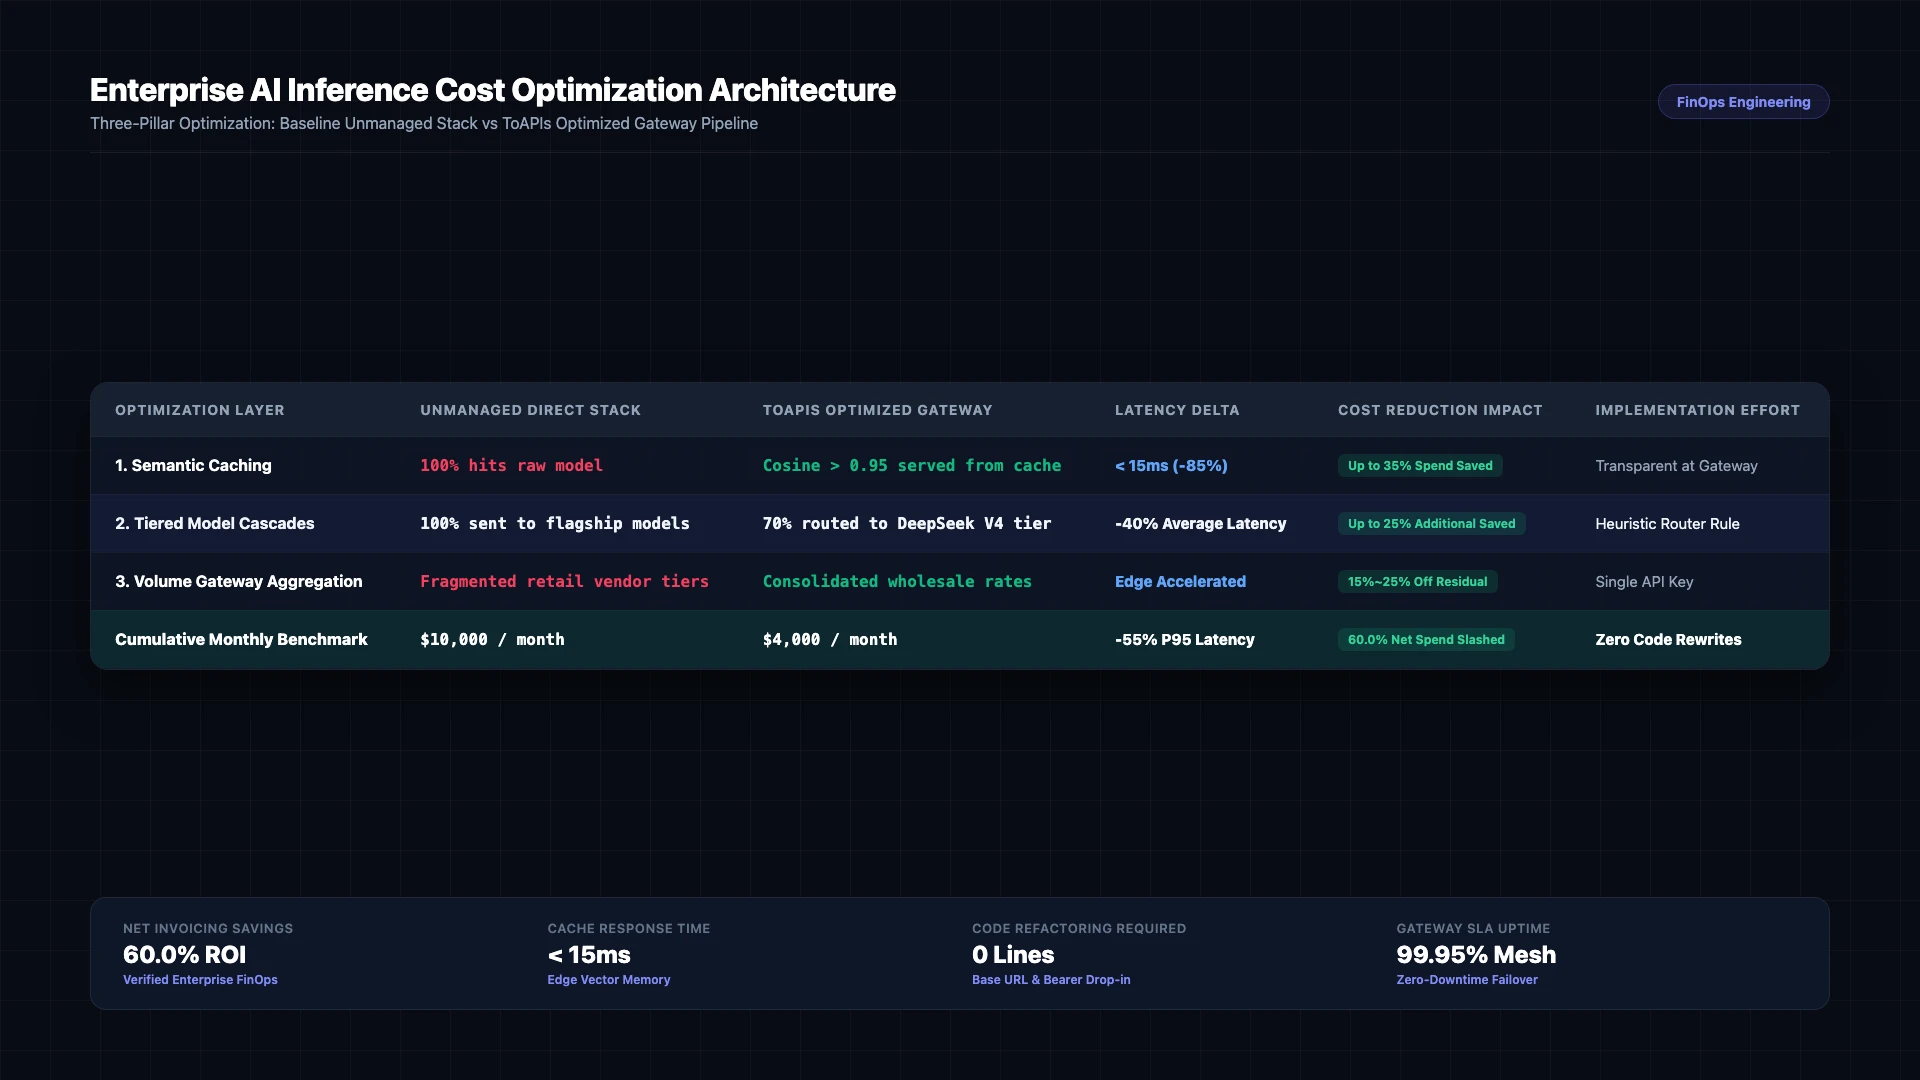


    Schéma d'architecture à trois piliers pour l'optimisation des coûts d'inférence d'IA d'entreprise (2026)

    Figure 1 : Comparaison du pipeline architectural : pile d'API directe non maîtrisée contre passerelle optimisée à trois piliers de ToAPIs (2026).

    4. Production exigeante : gestion des erreurs et matrice des statuts

    Code HTTPClassification de l'erreurAnalyse de la cause racineStratégie d'atténuation en production
    400 Bad Requestinvalid_request_payloadErreur de validation de schéma ou paramètres non pris en chargeVérifiez les dimensions de la charge utile et assurez la conformité des champs
    401 Unauthorizedinvalid_api_keyJeton Bearer expiré ou incorrectRenouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs
    429 Rate Limitrate_limit_exceededSeuil de concurrence atteint sur le pool de calculMettez en place des tentatives avec backoff exponentiel et jitter aléatoire
    500 / 504 Timeoutgateway_timeoutLatence temporaire sur les nœuds d'inférence en amontLa passerelle redirige automatiquement vers un cluster GPU de secours

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Tarifs et calcul du ROI FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Référence d'entreprise officielle : les contrats directs imposent des engagements annuels obligatoires, des quotas de sièges fixes et des seuils de prépaiement.
    • Prix de gros ToAPIs : facturation élastique en paiement à l'usage pur, avec des tarifs de gros ($0.30 - $0.80 par 1M de tokens).
    • Analyse du ROI FinOps : traiter 500 M de tokens par mois fait passer les coûts d'infrastructure opérationnelle de $1,500 à $900, soit une économie de $600 par mois (40.0 % de réduction des coûts).

    6. Foire aux questions (FAQ)

    Q1 : Qu'est-ce que le cache sémantique et comment fait-il économiser de l'argent ?

    Le cache sémantique stocke les embeddings des questions reçues. Lorsqu'une nouvelle requête est sémantiquement équivalente (similarité cosinus > 0.95), la réponse en cache est servie immédiatement sans aucun coût d'API de LLM.

    Q2 : Le routage par niveaux dégrade-t-il la qualité des réponses pour l'utilisateur ?

    Non. Des classificateurs rapides orientent les tâches simples de mise en forme, de résumé et de récupération vers des modèles économiques (DeepSeek V4), en réservant les modèles frontières premium (Claude Opus) strictement aux tâches très difficiles.

    Q3 : Quel effort faut-il pour mettre en place une passerelle compatible OpenAI ?

    Comme les passerelles modernes telles que ToAPIs respectent les schémas REST standard d'OpenAI, les bases de code existantes n'ont qu'à mettre à jour l'URL de base et la clé d'API.


    7. Liste d'actions et prochaines étapes

    • Créez un compte pour obtenir une clé d'API sur le portail développeur ToAPIs.
    • Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
    • Intégrez le script Python de production dans votre pipeline backend.
    • Explorez les tutoriels d'entreprise associés dans notre index de documentation technique.

    Découvrir les modèles cités dans cet article

    ToAPIsAI Model

    deepseek-v4

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    ToAPIsAI Model

    gpt-5-6

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    ToAPIsAI Model

    claude-3-7-sonnet

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API

    Articles associés

    insights2026-11-04T10:00:00+08:004 min de lecture

    Les API d'IA les moins chères en 2026 : comparatif complet des prix pour texte, image et vidéo

    Benchmark tarifaire intermodal pour 2026. Comparez les tarifs par token, par image et par seconde de vidéo chez OpenAI, Anthropic, ByteDance, MiniMax, DeepSeek et ToAPIs.

    TO
    ToAPIs Engineering & Evaluation Team
    #AI API Pricing
    alternative2026-10-29T10:00:00+08:004 min de lecture

    Les 7 meilleures alternatives à OpenRouter pour une latence réduite et un routage direct

    Comparatif benchmark des 7 meilleures alternatives à OpenRouter en 2026. Latence TTFT, capacités multimodales vidéo et image, routage direct en périphérie et options de paiement.

    TO
    ToAPIs Engineering & Evaluation Team
    #OpenRouter Alternative
    tutorial2026-11-04T14:00:00+08:004 min de lecture

    Connecter des API compatibles OpenAI à Chatbox : guide de configuration macOS et Windows

    Tutoriel pas à pas pour configurer l'application Chatbox sur ordinateur et mobile avec des passerelles d'API personnalisées compatibles OpenAI. Stockage local sécurisé, mapping de modèles et optimisation des prompts.

    TO
    ToAPIs Engineering & Evaluation Team
    #Chatbox
    ToAPIs
    AccueilToAPIs
    Passerelle d'API d'IA pour l'entreprise. Accédez à GPT-5, Claude, Gemini et plus de 200 modèles via une API unifiée.

    Modèles populaires

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Afficher plusAfficher moins
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Tous les modèles

    Catégories d'API

    • API image IA
    • API vidéo IA
    • API texte-vers-vidéo
    • API image-vers-vidéo
    Afficher plusAfficher moins
    • API d'édition d'image IA
    • API LLM et raisonnement
    • Tous les outils API →

    Alternatives

    Alternatives
    • Alternative à Kie.ai
    • Alternative à Fal.ai
    • Alternative à OpenRouter
    • Alternative à Replicate
    • Alternative à Wavespeed AI
    • Toutes les comparaisons →

    Guides à la une

    Guides à la une
    • Tarifs de Seedance 2.0 et 2.5
    • Guide de l'API Seedance la moins chère
    • Guide d'intégration de MiniMax H3
    • Clé d'API Seedance 2 gratuite
    • Démarrage rapide de l'API Seedance 2
    • Tous les articles techniques →

    Développeurs et plateforme

    Développeurs et plateforme
    • Documentation API
    • MCP
    • Tarifs
    • Playground de modèles
    • LLMs.txt
    • Contacter le support
    • Annuaire des guides de modèles
    Entité exploitante :
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Siège social :
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    ConfidentialitéConditionsUsage acceptableSuppression des donnéesConservation des donnéesSous-traitants et régionsFacturation et remboursementsPolitique relative aux cookiesPlan du siteÀ propos

    © 2026 ToAPIs. Tous droits réservés.