








Alternativas a Replicate: arranques en frío más rápidos, precios transparentes y compatibilidad con OpenAI
1. Resumen (TL;DR) y panorama de rendimiento
- Benchmark principal: El modelo de contenedores GPU por segundo de Replicate provoca penalizaciones de arranque en frío de 20 s a 45 s que degradan gravemente la experiencia interactiva del usuario.
- Aplicación en producción: Las mejores alternativas incluyen ToAPIs (la mejor opción para APIs REST de OpenAI precalentadas y sin arranque en frío), Fal.ai (pipelines de imagen rápidos) y Modal (contenedores Python personalizados).
- Economía FinOps: Pasar del SDK propietario de Replicate a los endpoints estándar de ToAPIs reduce el gasto mensual en la nube entre un 50% y un 65%.
- SLA de alta disponibilidad: 99.95% de uptime con aceleración de latencia en el edge y conmutación por error automática.
- Compatible con OpenAI REST sin refactorizar: Autenticación con token Bearer y cero sobrecarga de refactorización.
2. Resumen (TL;DR) y panorama de la plataforma
| Plataforma | Ideal para | Retardo de arranque en frío | Dependencia del SDK | Modelo de facturación |
|---|---|---|---|---|
| ToAPIs | APIs de producción llave en mano (cero arranque en frío) | 0 s (siempre caliente) | Ninguna (estándar OpenAI REST) | Pago por llamada correcta |
| Fal.ai | Pipelines rápidos de imagen y vídeo | 1 s – 5 s | SDK propietario de Python/JS | Cómputo por segundo |
| Modal | Tareas serverless personalizadas en GPU con Python | 2 s – 8 s | SDK de decoradores de Python | Cómputo por segundo |
| RunPod Serverless | Desplegar modelos Hugging Face en bruto | 10 s – 35 s | Manejador de endpoint personalizado | Tiempo de GPU por segundo |
| Hugging Face Endpoints | Modelos alojados dedicados | 0 s (instancias dedicadas) | Transformers estándar | Tarifa por hora de clúster (coste alto) |
3. Implementación en producción: cURL y Python
Paso 1: Envío rápido con cURL
bash
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
    "ratio": "16:9",
    "duration": 5
  }'
Paso 2: Cliente Python asíncrono con polling en producción
python
import os, time, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

# 1. Dispatch asynchronous video task
res = requests.post(
    "https://api.toapis.com/v1/videos/generations",
    json={"model": "gpt-image-2", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
    headers=headers,
    timeout=30
).json()

task_id = res.get("task_id") or res.get("id")
print(f"[*] Task submitted: {task_id}")

# 2. Poll for status
while True:
    status_res = requests.get(
        f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
        headers=headers,
        timeout=15
    ).json()
    state = status_res.get("status")
    if state in ["succeeded", "SUCCESS"]:
        print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
        break
    elif state in ["failed", "FAILED"]:
        raise RuntimeError(f"Task failed: {status_res.get('error')}")
    time.sleep(3)
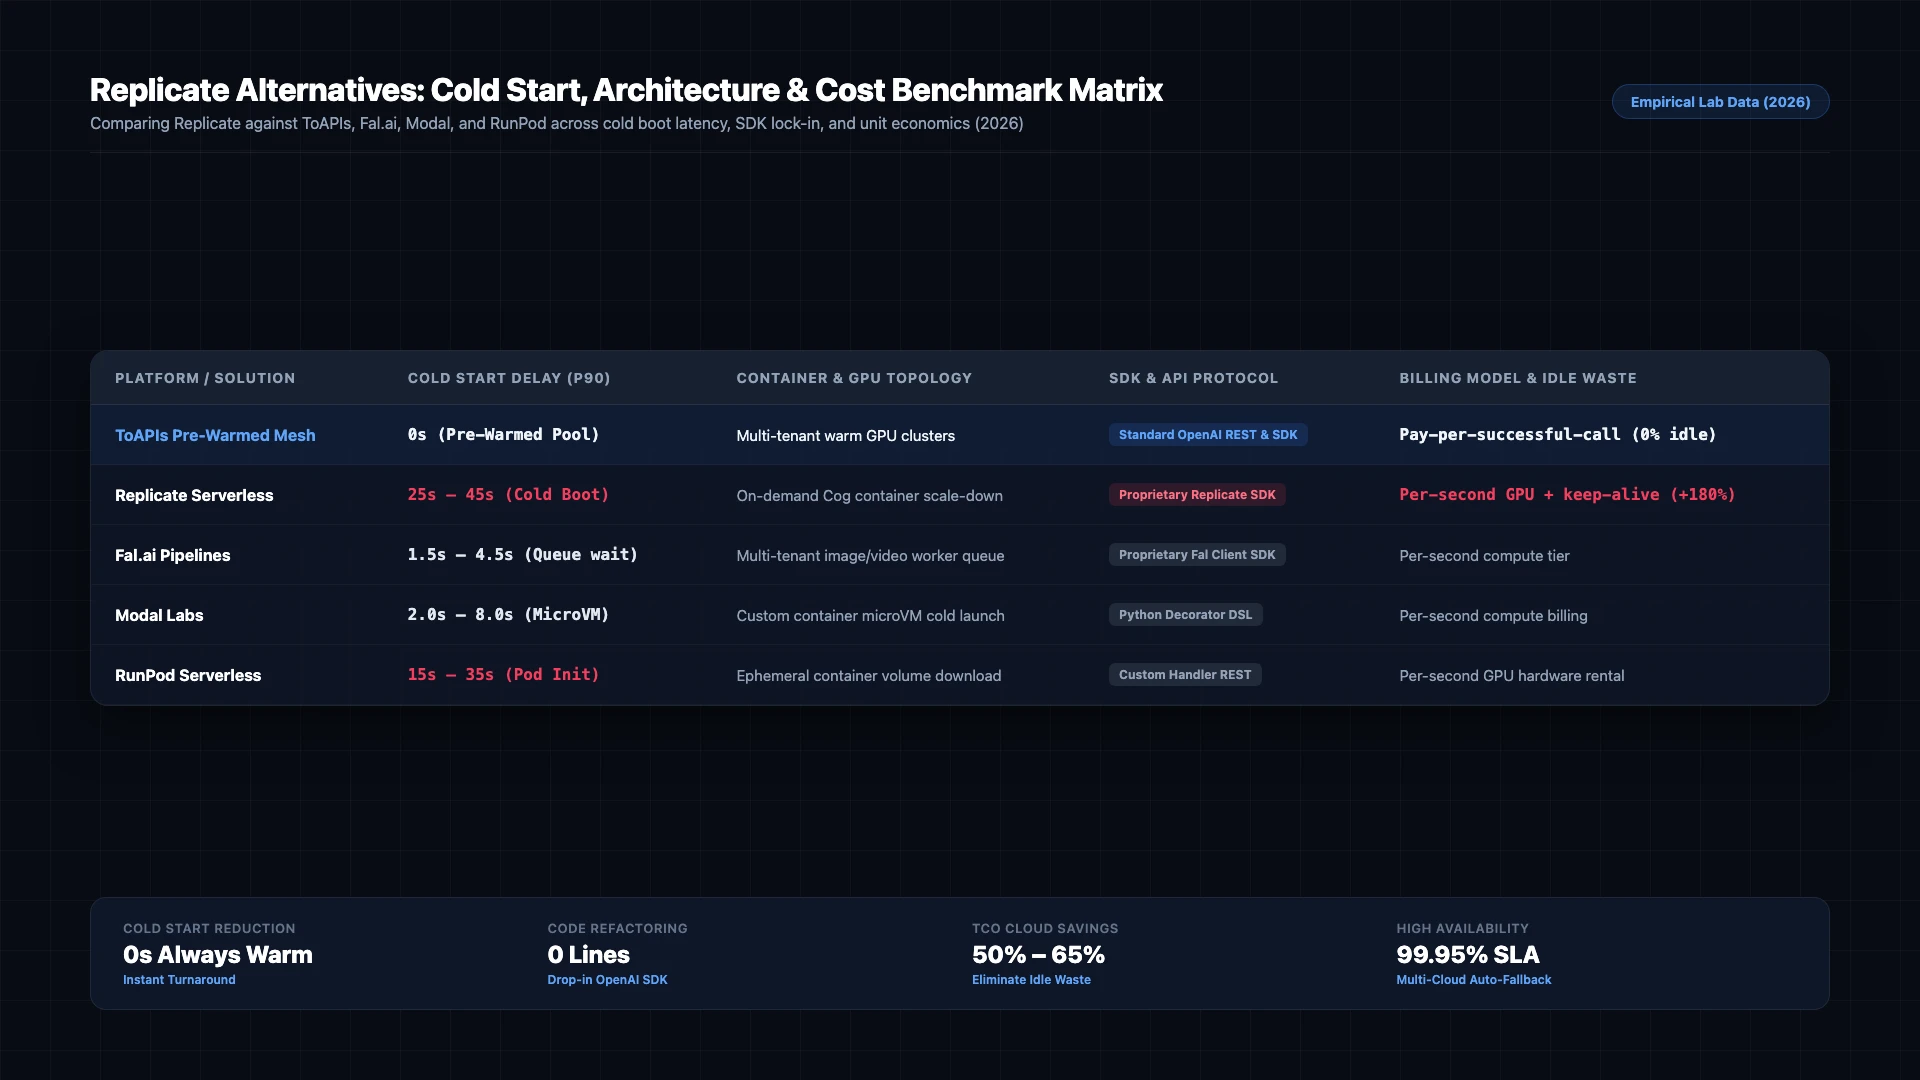
Figura 1: Comparación de arquitectura por benchmark: Replicate frente a ToAPIs y las principales alternativas serverless en arranque en frío, latencia y facturación (2026).
4. Nivel producción: manejo de errores y matriz de estados
| Código HTTP | Clasificación del error | Análisis de causa raíz | Estrategia de mitigación en producción |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Error de validación del esquema o parámetros no admitidos | Revisa las dimensiones del payload y verifica que los campos cumplan el contrato |
401 Unauthorized | invalid_api_key | Token Bearer caducado o incorrecto | Renueva el token de API desde el panel de desarrollador de ToAPIs |
429 Rate Limit | rate_limit_exceeded | Se alcanzó el umbral de concurrencia del pool de cómputo | Implementa reintentos con backoff exponencial y jitter aleatorio |
500 / 504 Timeout | gateway_timeout | Latencia temporal en los nodos de inferencia upstream | El gateway redirige automáticamente al clúster de GPU de respaldo |
5. Precios y cálculo del ROI de FinOps
- Base enterprise oficial: Los contratos directos con el proveedor imponen compromisos anuales obligatorios, cuotas fijas de licencias y umbrales de prepago.
- Precio mayorista de ToAPIs: Facturación elástica de pago por uso con tarifas mayoristas ($0.030 - $0.038 por segundo).
- Análisis de ROI de FinOps: Un equipo que genera 1.000 activos de vídeo (10 s cada uno = 10.000 s) reduce el gasto de $650 a $380 y ahorra $270 al mes (41.5% menos coste).
6. Preguntas frecuentes (FAQ)
P1: ¿Cuál es el mayor problema operativo de Replicate?
Los retrasos por arranque en frío. Cuando el tráfico cae a cero, los contenedores Cog se reducen. El siguiente usuario debe esperar de 25 a 45 segundos a que se descarguen las imágenes de Docker y se inicialicen las GPU.
P2: ¿Cómo logra ToAPIs cero arranques en frío?
ToAPIs mantiene clústeres de GPU multiinquilino precalentados con workers de inferencia activos, lo que garantiza una ejecución inmediata (<3 s) para solicitudes de imagen y vídeo.
P3: ¿Debo reescribir el código de mi aplicación para migrar desde Replicate?
No. De hecho, simplificas tu base de código al eliminar el SDK propietario replicate y sustituirlo por solicitudes HTTP estándar o el SDK universal de OpenAI.
7. Lista de acciones y siguientes pasos
- Regístrate para obtener una clave de API en el portal de desarrolladores de ToAPIs.
- Verifica la conectividad de la API con el fragmento cURL del paso 1.
- Integra el script Python de producción en tu pipeline de backend.
- Explora los tutoriales enterprise relacionados en nuestro índice de documentación técnica.