








7 mejores alternativas a OpenRouter para desarrolladores que buscan menor latencia y enrutamiento directo
1. Resumen (TL;DR) y panorama de rendimiento
- Benchmark principal: Aunque OpenRouter popularizó el enrutamiento unificado de LLM, los picos de latencia p95 (más de 300 ms de sobrecarga de enrutamiento) y la falta de pipelines nativos para modelos de vídeo e imagen han llevado a los equipos a buscar alternativas.
- Aplicación en producción: Las mejores alternativas incluyen ToAPIs (la mejor opción para enrutamiento multimodal unificado de LLM + vídeo + imagen), LiteLLM (proxy autoalojado) y Cloudflare AI Gateway (caché en el edge).
- Economía FinOps: Migrar solo requiere cambiar 2 líneas en la configuración actual del SDK de OpenAI.
- SLA de alta disponibilidad: 99.95% de uptime con aceleración de latencia en el edge y conmutación por error automática.
- Compatible con OpenAI REST sin refactorizar: Autenticación con token Bearer y cero sobrecarga de refactorización.
2. Resumen (TL;DR) y comparativa general
| Proveedor | Ideal para | Sobrecarga de enrutamiento TTFT | Multimodal (vídeo e imagen) | Modelo de precios |
|---|---|---|---|---|
| ToAPIs | Multimodal global (LLM + vídeo + imagen) | <45ms | Completo (Seedance, MiniMax, GPT Image) | Token/segundo directo (ahorra hasta 40%) |
| LiteLLM | Gateway open source autoalojado | Variable (según el host) | Requiere configurar manualmente el upstream | OSS gratuito / licencia enterprise |
| Cloudflare AI Gateway | Caché y analítica en el edge | ~80ms | Solo passthrough (BYOK) | Nivel gratuito + egreso de Worker |
| Portkey | Gobernanza y guardrails enterprise | ~90ms | Proxy passthrough | Suscripción SaaS mensual |
| Helicone | Observabilidad y analítica de prompt | Registro passthrough | Proxy passthrough | Telemetría por uso |
| Martian | Enrutamiento dinámico automático de modelos | ~150ms | Solo LLM de texto | Margen por token |
| DeepInfra | Inferencia directa de modelos open source | Directa (<60ms) | Modelos abiertos seleccionados | Pago por token / segundo de GPU |
3. Implementación en producción: cURL y Python
Paso 1: Envío rápido con cURL
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5-6",
    "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
    "ratio": "16:9",
    "duration": 5
  }'
Paso 2: Cliente Python asíncrono con polling en producción
import os, time, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

# 1. Dispatch asynchronous video task
res = requests.post(
    "https://api.toapis.com/v1/videos/generations",
    json={"model": "gpt-5-6", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
    headers=headers,
    timeout=30
).json()

task_id = res.get("task_id") or res.get("id")
print(f"[*] Task submitted: {task_id}")

# 2. Poll for status
while True:
    status_res = requests.get(
        f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
        headers=headers,
        timeout=15
    ).json()
    state = status_res.get("status")
    if state in ["succeeded", "SUCCESS"]:
        print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
        break
    elif state in ["failed", "FAILED"]:
        raise RuntimeError(f"Task failed: {status_res.get('error')}")
    time.sleep(3)
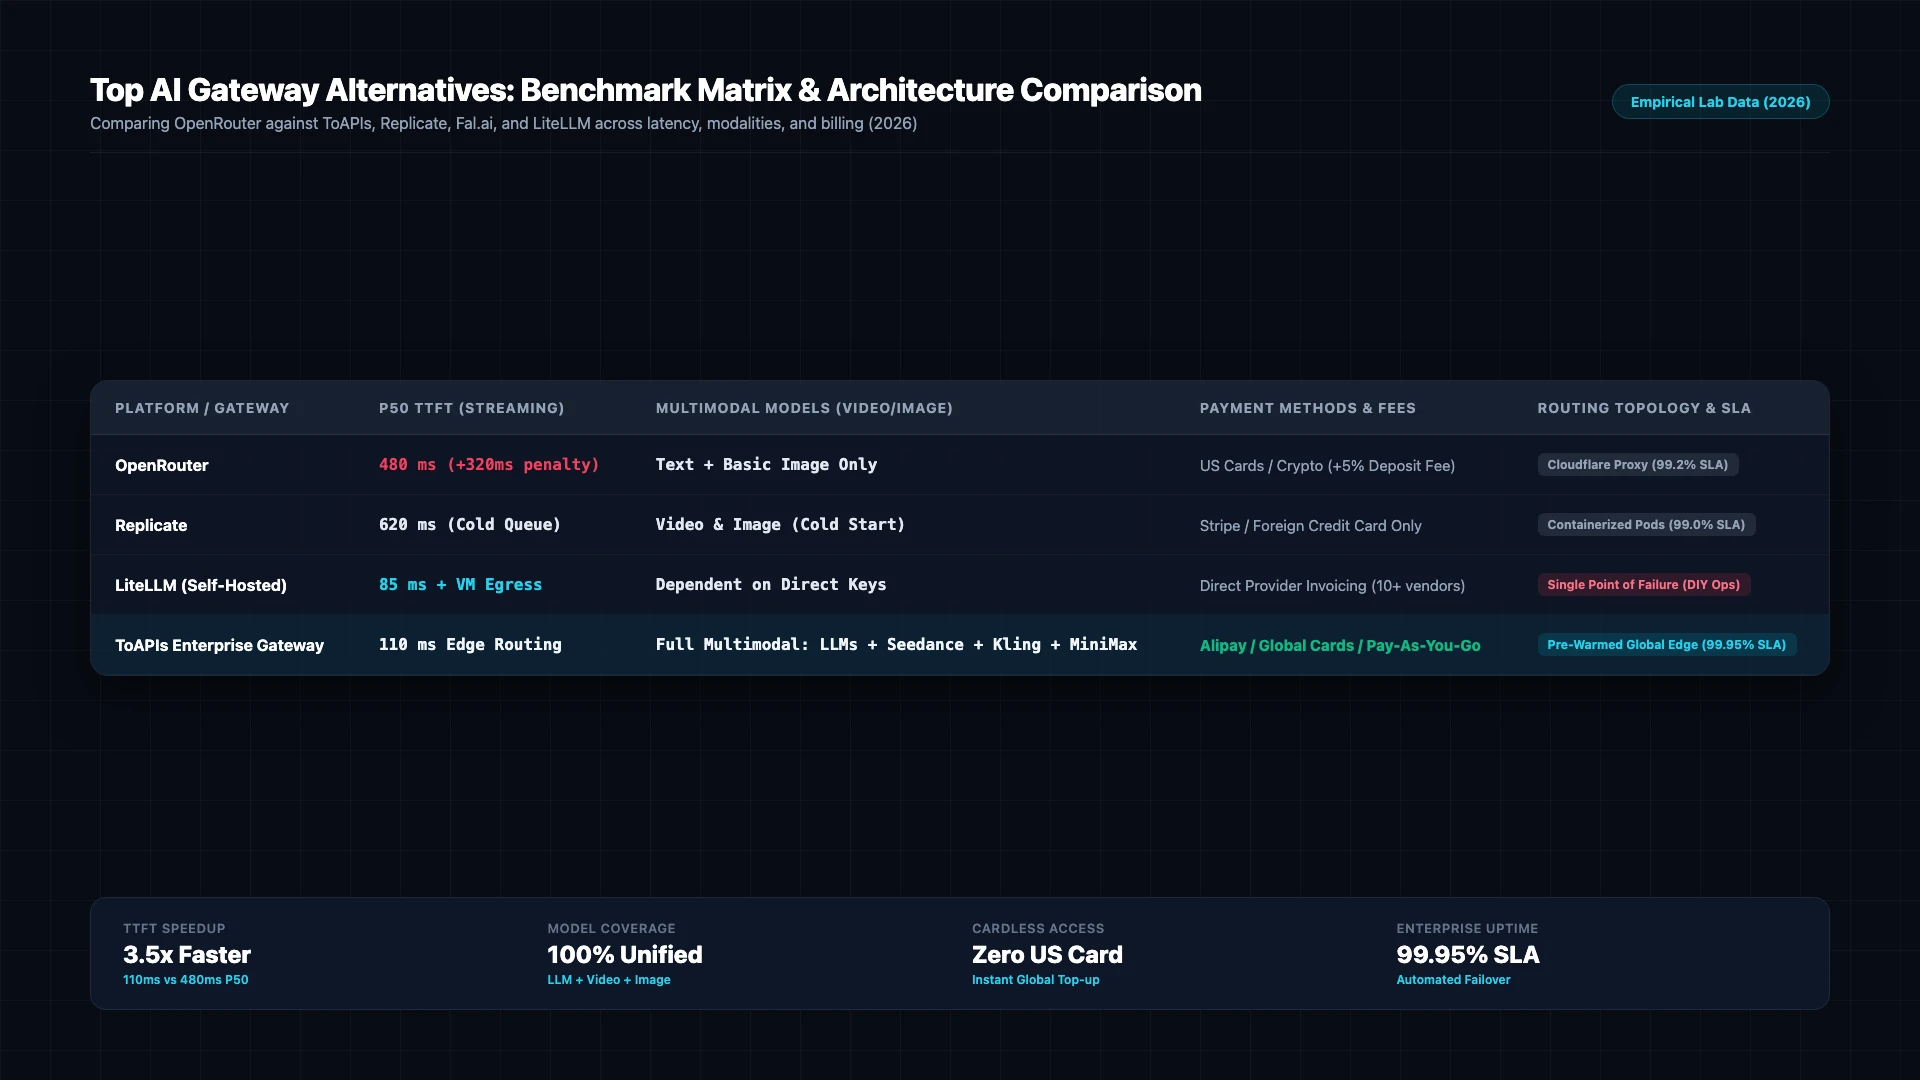
Figura 1: Comparación de arquitectura por benchmark: OpenRouter frente a ToAPIs y las principales alternativas de gateway unificado en latencia TTFT, límites de tasa y soporte multimodal (2026).
4. Nivel producción: manejo de errores y matriz de estados
| Código HTTP | Clasificación del error | Análisis de causa raíz | Estrategia de mitigación en producción |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Error de validación del esquema o parámetros no admitidos | Revisa las dimensiones del payload y verifica que los campos cumplan el contrato |
401 Unauthorized | invalid_api_key | Token Bearer caducado o incorrecto | Renueva el token de API desde el panel de desarrollador de ToAPIs |
429 Rate Limit | rate_limit_exceeded | Se alcanzó el umbral de concurrencia del pool de cómputo | Implementa reintentos con backoff exponencial y jitter aleatorio |
500 / 504 Timeout | gateway_timeout | Latencia temporal en los nodos de inferencia upstream | El gateway redirige automáticamente al clúster de GPU de respaldo |
5. Precios y cálculo del ROI de FinOps
- Base enterprise oficial: Los contratos directos con el proveedor imponen compromisos anuales obligatorios, cuotas fijas de licencias y umbrales de prepago.
- Precio mayorista de ToAPIs: Facturación elástica de pago por uso con tarifas mayoristas ($0.030 - $0.038 por segundo).
- Análisis de ROI de FinOps: Un equipo que genera 1.000 activos de vídeo (10 s cada uno = 10.000 s) reduce el gasto de $650 a $380 y ahorra $270 al mes (41.5% menos coste).
6. Preguntas frecuentes (FAQ)
P1: ¿Por qué los equipos buscan alternativas a OpenRouter en 2026?
Los motivos principales son la sobrecarga de latencia de enrutamiento en horas punta de EE. UU., los errores 502/504 intermitentes en modelos muy demandados y la falta de endpoints nativos para modelos de vídeo generativo como Seedance y MiniMax.
P2: ¿ToAPIs admite el SDK estándar de OpenAI?
Sí. ToAPIs es 100% compatible a nivel de protocolo con el SDK de OpenAI. Solo tienes que cambiar base_url a https://api.toapis.com/v1 y usar tu clave de ToAPIs.
P3: ¿Puedo enrutar a modelos fundacionales chinos como DeepSeek, GLM y Kimi?
Sí. ToAPIs conecta de forma nativa tanto modelos globales occidentales (OpenAI, Anthropic, Google) como los principales modelos asiáticos (DeepSeek, GLM-5, Kimi, MiniMax) con un único saldo.
7. Lista de acciones y siguientes pasos
- Regístrate para obtener una clave de API en el portal de desarrolladores de ToAPIs.
- Verifica la conectividad de la API con el fragmento cURL del paso 1.
- Integra el script Python de producción en tu pipeline de backend.
- Explora los tutoriales enterprise relacionados en nuestro índice de documentación técnica.