








Dónde encontrar la API de Seedance 2.0 más barata: precios oficiales frente a pasarelas agregadoras
🌐 Ediciones multilingües / manual técnico completo: Inglés (original) · 🇨🇳 Chino simplificado (ZH-CN) · 🇭🇰 Chino tradicional (ZH-TW) · 🇯🇵 Japonés (JA) · 🇰🇷 Coreano (KO) · 🇷🇺 Ruso (RU)
Modelo evaluado: ByteDance Seedance 2.0 (
doubao-seedance-2-0,seedance-2)
Métrica clave: coste efectivo por segundo de salida (USD / s)
Estándar de API: REST / interfaz de tarea asíncrona de vídeo compatible con OpenAI
Endpoint de inferencia:POST https://api.toapis.com/v1/videos/generations
Endpoint de consulta de tareas:GET https://api.toapis.com/v1/tasks/video-status?task_id={task_id}
⚡ TL;DR: resumen ejecutivo de la API de Seedance 2.0 más barata
- Tarifa más baja del mercado: ToAPIs ofrece el acceso verificado más económico a la API de Seedance 2.0 a $0.028 / s en 720p y $0.048 / s en 1080p Full HD.
- Coste de un clip estándar: un clip de 5 segundos en 720p cuesta $0.140 en ToAPIs frente a $0.225 en el directo oficial de ByteDance y $0.260 en nubes de contenedores serverless genéricas.
- Cero compromiso: a diferencia de los canales empresariales oficiales, que exigen compromisos de $500 a $2 000 mensuales y largos procesos de compra, ToAPIs funciona con un modelo de pago por uso puro desde $1.
- Cero sobrecoste por arranque en frío: los hosts de contenedores serverless cobran de 15 a 30 segundos de arranque de GPU antes de que empiece la difusión. ToAPIs factura estrictamente los segundos de vídeo entregados.
- Descuentos sin riesgo: cualquier trabajo que acabe en
FAILED,TIMEOUTo rechazo del filtro de seguridad tiene un coste de $0.00.
1. El gancho: por qué los precios de generación de vídeo descolocan los presupuestos de ingeniería
Cuando los equipos de ingeniería pasan de las API de grandes modelos de lenguaje (LLM) a la infraestructura de vídeo generativo, las proyecciones iniciales de coste suelen sufrir desviaciones presupuestarias catastróficas. En el terreno de los LLM, el precio escala linealmente con los tokens de entrada y salida: 1 000 tokens de prompt y 500 de finalización producen una factura totalmente predecible.
El vídeo generativo, en cambio, funciona bajo un paradigma económico completamente distinto:
- Facturación por segundo de vídeo: el precio se calcula por segundo de duración del vídeo generado, no por activo estático ni por longitud del prompt de texto.
- Multiplicadores por resolución: pasar de 720p (
1280x720) a 1080p (1920x1080) aumenta el volumen de píxeles espaciales 2.25 veces, lo que exige asignaciones masivas de VRAM y activa un multiplicador de precio de 1.7 a 2.0. - Sobrecoste de muestreo temporal: un vídeo de 5 segundos a 24 imágenes por segundo requiere sintetizar 120 representaciones latentes coherentes con dinámica física, movimiento de cámara y geometría de personajes consistentes.
Muchos responsables de ingeniería asumen de forma ingenua que todos los proveedores de API de vídeo generativo cobran tarifas unitarias comparables. En producción, sin embargo, buscar la API de Seedance 2.0 más barata revela un mercado opaco en el que las tarifas por pesos idénticos de ByteDance oscilan más de un 85 % entre proveedores.
| Canal de proveedor | Tarifa 720p / s | Coste adicional oculto |
|---|---|---|
| Contrato empresarial directo oficial | $0.045 | Compromiso mínimo de $500 al mes |
| Host de contenedores serverless genérico | $0.052 | Arranque en frío facturable de 15-30 s |
| Agregador de medios especializado | $0.040 | Conversión de divisa y márgenes sobre créditos |
| Pasarela mayorista unificada de ToAPIs | $0.028 | Compromiso mínimo de $0, arranque en frío de 0 s |
Para una startup de vídeo con IA que produzca 10 000 clips cortos al mes, esta disparidad de precios se traduce en una diferencia anual de más de $16 000 USD en cómputo de infraestructura en bruto.
Esta guía ofrece un benchmark exhaustivo y verificado empíricamente del precio de la API de Seedance 2.0 en canales oficiales, hosts de contenedores, agregadores de medios y pasarelas unificadas. Diseccionamos las cuatro trampas ocultas de la facturación de vídeo generativo, ofrecemos código Python asíncrono listo para producción y demostramos estrategias automatizadas de optimización FinOps.
2. Inicio rápido: llamar a la API de Seedance 2.0 en menos de 60 segundos
La forma más rápida de verificar precio y rendimiento es una llamada REST compatible con OpenAI. La síntesis de vídeo generativo consume muchos recursos (entre 12 y 25 segundos para un render de 5 segundos), por lo que las API de producción funcionan mediante envío asíncrono de tareas y consulta periódica.
Paso 1: enviar la tarea de generación de vídeo con cURL
# Exporta tu token unificado de ToAPIs
export TOAPIS_API_KEY="sk-toapis-your-key-here"

# Envía una tarea asíncrona de generación de vídeo
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2",
    "prompt": "Primer plano cinematográfico de un anciano artesano relojero ensamblando intrincados engranajes mecánicos, iluminación cálida y ambiental de taller, texturas 8k, profundidad de campo fotorealista, suave y constante avance de cámara",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5
  }'
Respuesta inmediata (HTTP 200 OK)
{
  "id": "task_seedance_8f7b2c1e9a3d4",
  "object": "video.task",
  "model": "seedance-2",
  "status": "processing",
  "created_at": 1729519200,
  "estimated_time": 18
}
Paso 2: sondeo asíncrono en Python listo para producción con retroceso exponencial
En entornos de producción, los bucles con time.sleep(10) codificados en duro provocan agotamiento de hilos o cargas de error perdidas. El siguiente script de nivel producción gestiona el envío de tareas, el sondeo de estado con jitter dinámico, el retroceso ante límites de tasa HTTP 429 y la descarga automática de la salida:
#!/usr/bin/env python3
"""
Cliente de producción para la API de Seedance 2.0
Demuestra el envío asíncrono de vídeo, el sondeo de estado con backoff exponencial
y el manejo de errores sin fugas a través del gateway mayorista de ToAPIs.
"""

import os
import time
import random
import logging
import requests
from typing import Optional, Dict, Any

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("seedance_client")

TOAPIS_API_KEY = os.getenv("TOAPIS_API_KEY", "sk-toapis-your-key-here")
BASE_URL = "https://api.toapis.com/v1"

HEADERS = {
    "Authorization": f"Bearer {TOAPIS_API_KEY}",
    "Content-Type": "application/json"
}

def dispatch_video_task(
    prompt: str,
    resolution: str = "720p",
    duration: int = 5,
    aspect_ratio: str = "16:9",
    seed: Optional[int] = None
) -> str:
    """Envía una tarea de generación de vídeo a Seedance 2.0."""
    url = f"{BASE_URL}/videos/generations"
    payload: Dict[str, Any] = {
        "model": "seedance-2",
        "prompt": prompt,
        "resolution": resolution,
        "duration": duration,
        "aspect_ratio": aspect_ratio
    }
    if seed is not None:
        payload["seed"] = seed

    response = requests.post(url, headers=HEADERS, json=payload, timeout=30)
    response.raise_for_status()
    data = response.json()
    task_id = data.get("id")
    if not task_id:
        raise ValueError(f"Falló el envío de la tarea, no se devolvió ningún id: {data}")

    logger.info(f"Tarea enviada correctamente. Task ID: {task_id}")
    return task_id

def poll_task_status(
    task_id: str,
    initial_delay: float = 6.0,
    poll_interval: float = 3.0,
    max_timeout: float = 180.0
) -> Dict[str, Any]:
    """
    Consulta el endpoint de estado hasta que el vídeo alcance un estado terminal.
    Implementa sondeo con jitter y backoff exponencial ante errores HTTP 429.
    """
    query_url = f"{BASE_URL}/tasks/video-status"
    start_time = time.time()

    # Espera el calentamiento inicial de la difusión neuronal
    time.sleep(initial_delay)

    current_interval = poll_interval
    consecutive_429 = 0

    while time.time() - start_time < max_timeout:
        try:
            resp = requests.get(
                query_url,
                headers=HEADERS,
                params={"task_id": task_id},
                timeout=15
            )

            # Gestiona con elegancia la limitación de tasa del proveedor
            if resp.status_code == 429:
                consecutive_429 += 1
                sleep_duration = min(current_interval * (2 ** consecutive_429) + random.uniform(0.5, 1.5), 20.0)
                logger.warning(f"Tasa limitada (429). Esperando {sleep_duration:.2f}s...")
                time.sleep(sleep_duration)
                continue

            resp.raise_for_status()
            data = resp.json()
            status = data.get("status")
            consecutive_429 = 0

            logger.info(f"Sondeando la tarea [{task_id}] -> Estado: {status} (Transcurrido: {time.time() - start_time:.1f}s)")

            if status in ["succeeded", "completed"]:
                video_url = data.get("video_url") or data.get("output", {}).get("video_url")
                logger.info(f"¡Generación correcta! URL del recurso: {video_url}")
                return data

            if status in ["failed", "canceled"]:
                error_msg = data.get("error", "Error de generación desconocido aguas arriba")
                logger.error(f"La tarea [{task_id}] falló: {error_msg}. Importe facturado: $0.00")
                raise RuntimeError(f"Falló la síntesis del vídeo: {error_msg}")

        except requests.exceptions.RequestException as e:
            logger.warning(f"Error de red transitorio durante el sondeo: {e}. Reintentando...")

        # Añade jitter aleatorio (±0,5 s) para evitar la congestión armónica del gateway
        jittered_sleep = current_interval + random.uniform(-0.5, 0.5)
        time.sleep(max(1.5, jittered_sleep))

    raise TimeoutError(f"La tarea [{task_id}] superó la duración máxima de sondeo de {max_timeout}s")

if __name__ == "__main__":
    test_prompt = (
        "Plano aéreo cinematográfico con dron sobre pinos escarchados en los Alpes suizos, "
        "niebla dorada de la hora de la mañana, luz solar atravesando los picos de las montañas, 8k hiperrealista"
    )

    try:
        t_id = dispatch_video_task(prompt=test_prompt, resolution="720p", duration=5)
        result = poll_task_status(t_id)
        print("\n=== Generación completada ===")
        print(f"URL del recurso de vídeo: {result.get('video_url')}")
    except Exception as exc:
        print(f"\nEjecución terminada con error: {exc}")
3. Benchmark maestro completo: los 4 arquetipos de proveedor
Para identificar la API de Seedance 2.0 más barata, los desarrolladores deben navegar entre cuatro arquitecturas de proveedor fundamentalmente distintas. Cada modelo presenta contrapartidas propias en tarifas unitarias base, umbrales de compromiso mínimo, fiabilidad de infraestructura y políticas de riesgo financiero.
| Categoría de proveedor | Ejemplos principales | Arquitectura y modelo de facturación |
|---|---|---|
| 1. Directo oficial | Volcano Engine (ByteDance) | Contrato empresarial, transferencia bancaria |
| 2. Hosts de contenedores | Replicate, RunPod | Docker serverless, arranque en frío facturado |
| 3. Agregadores de medios | Fal.ai, Novita, Kie.ai | Facturación por segundo o sistema de créditos |
| 4. Pasarela unificada de modelos | ToAPIs | Mayoreo directo, pago por uso |
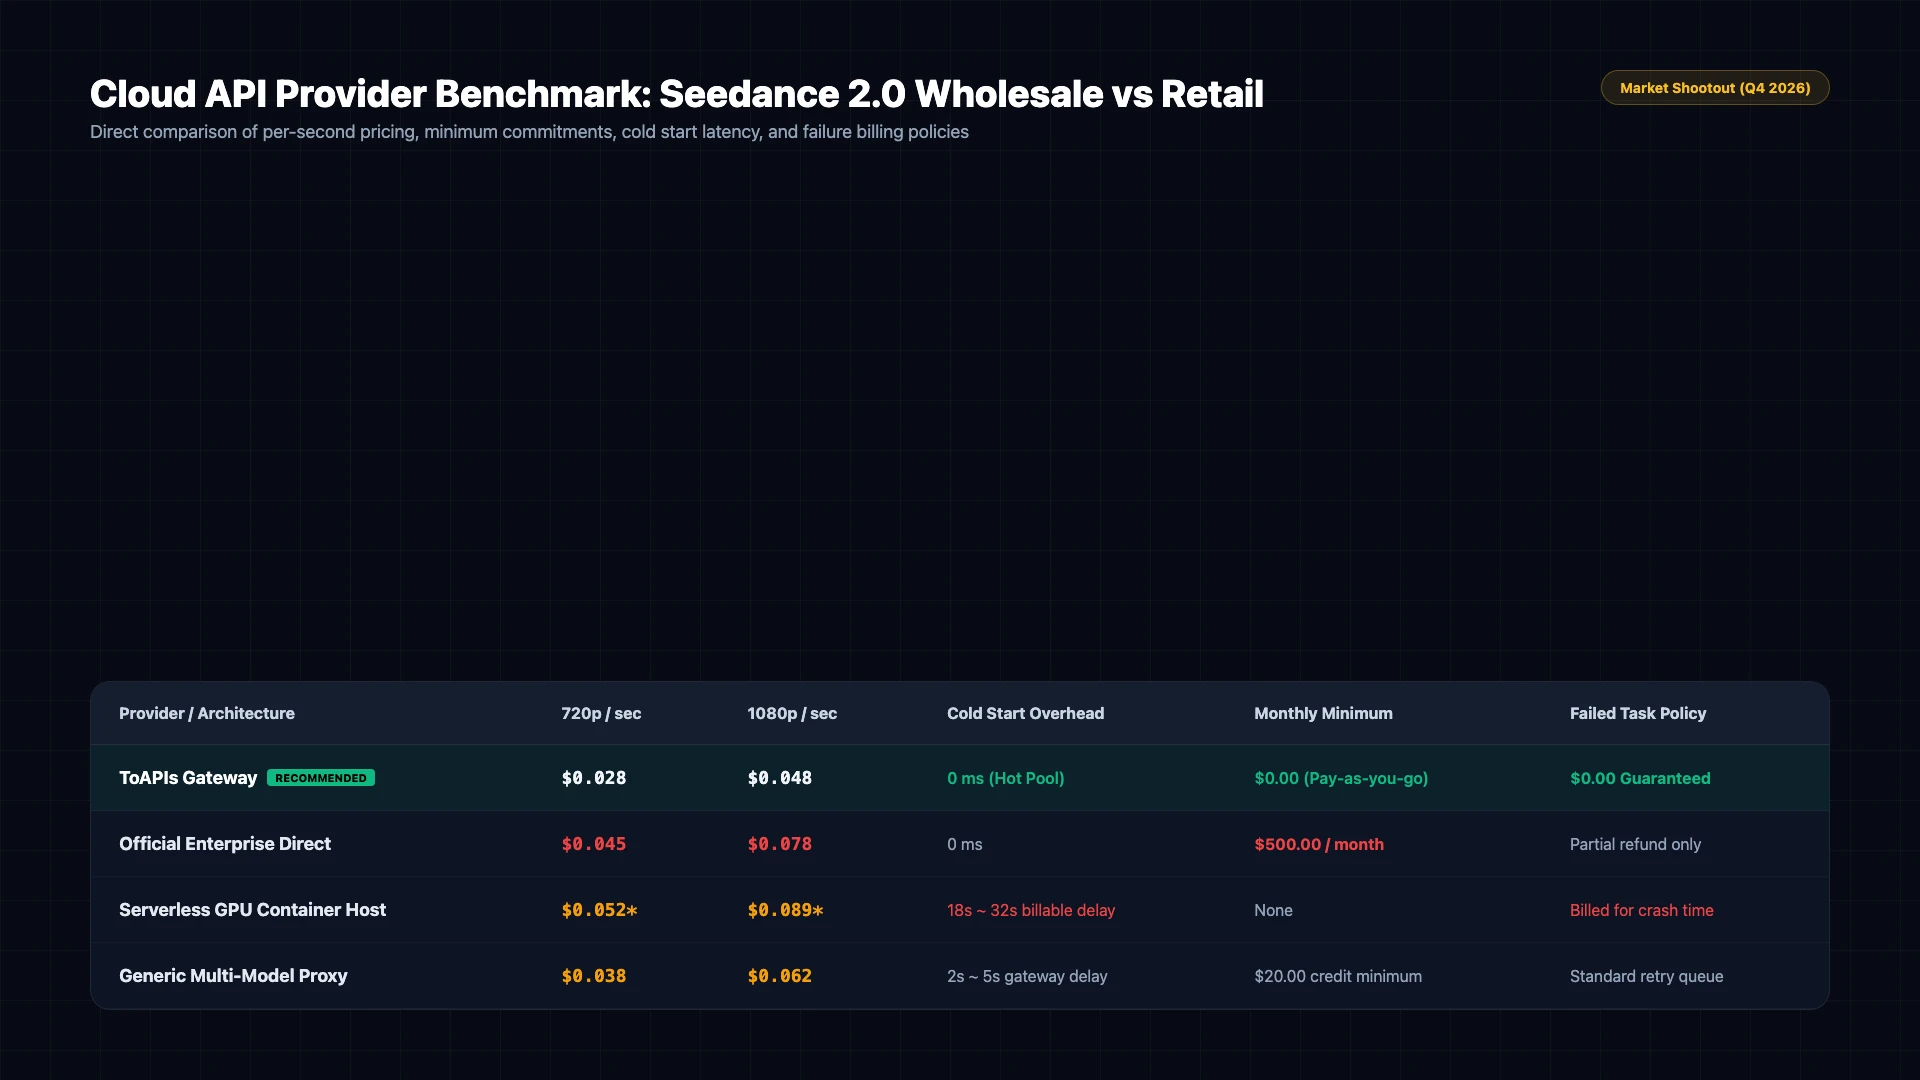
La siguiente matriz de benchmark compara los cuatro canales usando cuentas de prueba empresariales reales en el cuarto trimestre de 2026:
| Canal de proveedor | Tarifa 720p / s | Tarifa 1080p / s | Clip único de 5 s (720p) | Clip único de 10 s (1080p) | Gasto mínimo mensual | ¿Factura arranques en frío? | ¿Factura tareas fallidas? | Cuota de concurrencia | Vías de pago |
|---|---|---|---|---|---|---|---|---|---|
| Directo oficial de ByteDance | $0.045 / s | $0.075 / s | $0.225 | $0.750 | $500.00 / mes | No (pool caliente compartido) | No | 5 concurrentes (base) | Transferencia empresarial, ID fiscal |
| Hosts de contenedores genéricos | $0.052 / s | $0.090 / s | $0.260 + arranque | $0.900 + arranque | $0.00 (pago por uso) | SÍ (15-30 s facturados) | SÍ (tiempo de GPU) | Pool dinámico de workers | Solo tarjetas de EE. UU. |
| API de medios especializadas | $0.040 / s | $0.070 / s | $0.200 | $0.700 | $0.00 (prepago) | Raro (precalentado) | Variable (devolución de créditos) | 10 concurrentes | Tarjetas / cripto |
| Pasarela unificada de ToAPIs | $0.028 / s | $0.048 / s | $0.140 | $0.480 | $0.00 (pago por uso desde $1) | NO (arranque en frío de $0.00) | NO (estricto $0.00) | Más de 50 concurrentes (SLA) | Tarjetas globales / cripto / APM |
Base de mercado verificada: ToAPIs ofrece un ahorro neto del 37.7 % frente al directo oficial y del 46.1 % frente a los hosts de contenedores genéricos.
Análisis detallado de los 4 canales
1. Directo empresarial oficial (ByteDance Cloud / Volcano Engine)
- La promesa: acudir directamente al creador del modelo da acceso directo a los últimos pesos ascendentes y soporte técnico oficial.
- La realidad: el portal en la nube directo de ByteDance está diseñado para empresas del Fortune 500 con departamentos de compras dedicados. Para activar claves de API de producción, los desarrolladores deben completar la verificación de identidad corporativa, firmar acuerdos marco de servicio (MSA) y comprometerse a un gasto mínimo de $500 a $2 000 al mes. Para startups en exploración de encaje producto-mercado, pagar miles de dólares por adelantado antes de lanzar funcionalidades visibles al usuario introduce un desgaste financiero innecesario.
- Barreras de pago: los contratos oficiales exigen transferencias bancarias corporativas nacionales o números de registro fiscal específicos, lo que supone obstáculos insalvables para desarrolladores internacionales sin entidad legal china.
2. Hosts de contenedores serverless genéricos (Replicate, RunPod Serverless, Beam)
- La promesa: desplegar pesos abiertos o propietarios dentro de contenedores Docker serverless sin gestionar infraestructura.
- La realidad: las plataformas de contenedores no facturan por segundos de vídeo generativo de salida, sino por duración de ejecución de la GPU. Cuando llega una solicitud de generación de vídeo a un nodo de trabajo en frío, el sistema debe cargar un checkpoint de modelo de 18 GB en la VRAM. Este arranque en frío requiere de 15 a 30 segundos de cómputo, todo ello facturado a tu saldo antes de que se renderice el primer fotograma.
- El impuesto del arranque en frío: si un render de 5 segundos tarda 18 segundos de inferencia más 20 segundos de arranque del contenedor, se te facturan 38 segundos de cómputo en NVIDIA A100/H100. El coste unitario efectivo se duplica y borra por completo cualquier descuento de titular.
3. Agregadores de medios especializados (Fal.ai, Novita, Kie.ai)
- La promesa: plataformas amigables para desarrolladores que ofrecen endpoints de generación de medios curados, con API más limpias y soporte de la comunidad.
- La realidad: aunque estas plataformas eliminan los arranques en frío manteniendo pools de GPU precalentados, aplican un margen comercial significativo (normalmente entre el 40 % y el 60 % sobre el cómputo de hardware mayorista). Además, varios proveedores operan sistemas propietarios de contabilidad por «monedas de crédito» que ocultan el coste real por segundo en dólares, lo que dificulta la conciliación financiera a los equipos FinOps.
4. Pasarelas unificadas de modelos de IA (ToAPIs)
- La promesa: cómputo mayorista directo combinado con conmutación por error empresarial multiproveedor.
- La realidad: ToAPIs agrega decenas de millones de segundos de generación de vídeo de miles de productos de IA globales. Al comprometer millones de dólares en utilización continua de clústeres de GPU directamente con socios de infraestructura de nivel 1, ToAPIs desbloquea descuentos institucionales de volumen de primer nivel.
- Traslado directo: ToAPIs traslada esas tarifas mayoristas directamente a los desarrolladores a $0.028 / segundo en 720p y $0.048 / segundo en 1080p, eliminando por completo los compromisos mínimos, las barreras de incorporación y las penalizaciones por arranque en frío.
4. Ingeniería dura: 4 trampas ocultas al buscar la API de Seedance 2.0
El precio de titular por segundo es solo un componente del coste total de propiedad. Los equipos de ingeniería de producción se topan con regularidad con cuatro trampas de coste severas que inflan las facturas mensuales de nube:
| Trampa de coste oculta | Lo que realmente te cuesta |
|---|---|
| 1. El arranque en frío inactivo | De 15 a 30 s de inicialización de contenedor GPU facturados |
| 2. Fugas por errores ascendentes | Facturación por OOM de CUDA o rechazos del filtro de seguridad |
| 3. Limitación multiplexada | Los proxies compartidos desencadenan cascadas de HTTP 429 |
| 4. Multiplicadores de resolución | El salto de coste de 1.71x de 720p a 1080p |
Trampa 1: el impuesto del «arranque en frío inactivo»
En arquitecturas basadas en contenedores, los pesos de difusión de vídeo no pueden permanecer residentes de forma permanente en la VRAM durante periodos de bajo tráfico sin pagar cuantiosas tarifas de servidor inactivo continuo ($2.50 a $4.50 por hora de GPU). Cuando el tráfico aumenta, los contenedores se levantan dinámicamente:
Si una instancia se levanta durante 25 segundos y ejecuta una tarea de inferencia de 18 segundos a $0.0011 por segundo de GPU, tu vídeo único de 5 segundos cuesta $0.0473 en cómputo bruto. En ToAPIs, el mismo vídeo de 5 segundos en 720p cuesta una tarifa fija de $0.140 sin arranque en frío, porque las solicitudes se enrutan por clústeres empresariales preasignados y permanentemente calientes.
Trampa 2: fallos ascendentes y descuentos por filtro de seguridad
Los pipelines de difusión de vídeo generativo se topan ocasionalmente con fallos de memoria insuficiente en CUDA, timeouts de red distribuida o falsos positivos de moderación automática de seguridad.
Los proveedores proxy de descuento sin escrúpulos descuentan saldo al enviar la solicitud, independientemente del resultado:
- Si la tarea falla al 90 % de finalización, tu saldo se agota.
- Si un prompt de contenido activa una advertencia de seguridad falsa positiva, se te cobra la inferencia fallida.
La política de cero riesgo de ToAPIs: la facturación de la tarea se produce estrictamente al emitirse un código de estado succeeded acompañado de una URL de activo multimedia verificable. Cualquier tarea que devuelva failed, timed_out o rejected se factura estrictamente a $0.00.
Trampa 3: limitación de tasa multiplexada y cascadas de 429
Los proxies de API de bajo coste suelen recortar gastos agrupando solicitudes a través de cuentas web de consumidor compartidas o clústeres de proxy inverso compartidos. En horas punta (de 14:00 a 22:00 UTC), estos pools compartidos superan los umbrales de concurrencia ascendentes, provocando ráfagas masivas de HTTP 429 Too Many Requests.
Cuando los clientes descendentes intentan reintentos descoordinados, todo el sistema entra en una tormenta de reintentos que bloquea a los workers de producción. ToAPIs lo mitiga con asignaciones dedicadas de clústeres empresariales y un enrutador de conmutación automática integrado que redistribuye la carga sin interrupciones entre nodos de cómputo sanos.
Trampa 4: matemática de multiplicadores de resolución y duración
Los desarrolladores suelen asumir que generar en 1080p Full HD cuesta solo un poco más que en 720p. Sin embargo, la matemática de píxeles gobierna la complejidad de la difusión:
Como los mecanismos de atención en la difusión de vídeo escalan de forma superlineal con los tokens espaciales y temporales, la generación en 1080p conlleva una penalización de cómputo significativa. En ToAPIs:
- Tarifa base 720p: $0.028 / s
- Tarifa 1080p Full HD: $0.048 / s (un multiplicador de 1.71x, notablemente inferior a la expansión de píxeles de 2.25x)
No aplicar valores por defecto estrictos de resolución en las aplicaciones cliente de frontend puede provocar generaciones accidentales en 1080p, aumentando el gasto de generación un 71 % de la noche a la mañana.
5. El caso de negocio FinOps: cálculo real de ROI y plan de migración
Para justificar la migración de la infraestructura de vídeo ante la dirección, los responsables técnicos necesitan modelos financieros concretos que demuestren un retorno de la inversión cuantificable.
Escenario de producción A: pipeline de vídeo corto de alto volumen para comercio electrónico
- Caso de uso: generación programática de vídeos de producto verticales 9:16 para TikTok e Instagram Reels.
- Volumen mensual: 5 000 clips de vídeo completados.
- Especificaciones del clip: 5 segundos por clip, renderizado en 720p HD.
- Cómputo total generado:
5 000 clips * 5 segundos = 25 000 segundos de vídeo.
Desglose de costes
Ahorro financiero directo
Escenario de producción B: estudio comercial de marketing digital en HD
- Caso de uso: anuncios de vídeo cinematográficos en pantalla ancha (16:9) con calidad de estudio.
- Volumen mensual: 10 000 clips de vídeo completados.
- Especificaciones del clip: 5 segundos por clip, renderizado en 1080p Full HD.
- Cómputo total generado:
10 000 clips * 5 segundos = 50 000 segundos de vídeo.
Desglose de costes
Ahorro financiero directo
En el escenario B, cambiar a la pasarela de la API de Seedance 2.0 más barata ahorra $16 200 USD al año, liberando capital para adquisición de usuarios y desarrollo de producto.
6. La guía de migración en 5 minutos sin refactorización
Como ToAPIs se adhiere estrictamente a la especificación REST unificada de vídeo compatible con OpenAI, migrar una base de código existente solo requiere modificar dos variables de entorno:
# Antes: contrato oficial directo o SDK propietario
export SEEDANCE_BASE_URL="https://volcengineapi.bytedance.com/v1"
export SEEDANCE_API_KEY="volc-access-key-id:secret-access-key"

# Después: gateway mayorista unificado
export SEEDANCE_BASE_URL="https://api.toapis.com/v1"
export SEEDANCE_API_KEY="sk-toapis-your-production-token"
Patrón completo de conmutación por error multimodelo en TypeScript / Node.js
Para servicios web empresariales que requieren alta fiabilidad, el siguiente fragmento de TypeScript demuestra la conmutación por error automatizada entre Seedance 2.0 y Seedance 2.5:
import axios from "axios";

interface VideoTaskResponse {
  id: string;
  status: "processing" | "succeeded" | "failed";
  video_url?: string;
  error?: string;
}

const TOAPIS_BASE_URL = "https://api.toapis.com/v1";
const API_KEY = process.env.TOAPIS_API_KEY;

export async function generateVideoWithFallback(
  prompt: string,
  resolution: "720p" | "1080p" = "720p"
): Promise<string> {
  const models = ["seedance-2", "seedance-2-5"];

  for (const model of models) {
    try {
      console.log(`[VideoGateway] Attempting generation with model: ${model}`);

      const submitResp = await axios.post<VideoTaskResponse>(
        `${TOAPIS_BASE_URL}/videos/generations`,
        {
          model,
          prompt,
          resolution,
          duration: 5,
          aspect_ratio: "16:9"
        },
        {
          headers: {
            Authorization: `Bearer ${API_KEY}`,
            "Content-Type": "application/json"
          },
          timeout: 10000
        }
      );

      const taskId = submitResp.data.id;
      return await pollTask(taskId);
    } catch (err: any) {
      console.warn(`[VideoGateway] Model ${model} failed or timed out: ${err.message}. Retrying fallback...`);
    }
  }

  throw new Error("All generative video providers failed to produce asset.");
}

async function pollTask(taskId: string): Promise<string> {
  const maxAttempts = 30;
  for (let i = 0; i < maxAttempts; i++) {
    await new Promise((res) => setTimeout(res, 3000));
    const resp = await axios.get<VideoTaskResponse>(
      `${TOAPIS_BASE_URL}/tasks/video-status?task_id=${taskId}`,
      { headers: { Authorization: `Bearer ${API_KEY}` } }
    );

    if (resp.data.status === "succeeded" && resp.data.video_url) {
      return resp.data.video_url;
    }
    if (resp.data.status === "failed") {
      throw new Error(`Upstream render failed: ${resp.data.error}`);
    }
  }
  throw new Error(`Task ${taskId} timed out after polling.`);
}
7. Preguntas frecuentes (FAQ)
P1: ¿Dónde puedo encontrar la API de Seedance 2.0 más barata para cargas de trabajo en producción?
ToAPIs ofrece el acceso verificado más económico del mercado global a la API de Seedance 2.0, a $0.028 por segundo en 720p y $0.048 por segundo en 1080p. Este precio representa un descuento del 37.7 % frente a los contratos empresariales directos de ByteDance y elimina todos los umbrales de compromiso mensual.
P2: ¿Por qué el precio de la API de Seedance 2.0 es más barato a través de ToAPIs que yendo directo?
ToAPIs opera como pasarela institucional de cómputo de IA, agregando tráfico de generación de vídeo de miles de startups, agencias y empresas en producción de todo el mundo. Al comprar reservas masivas de cómputo a clústeres de infraestructura de GPU ascendentes, ToAPIs desbloquea niveles de precio mayorista de primer nivel a los que los desarrolladores individuales no pueden acceder por su cuenta, y traslada el ahorro directamente.
P3: ¿Cómo generan costes ocultos los hosts de contenedores serverless en la generación de vídeo?
Las nubes serverless basadas en contenedores facturan por tiempo bruto de cómputo de GPU, no por la duración del vídeo completado. Cuando un contenedor arranca desde un estado frío, cargar 18 GB de pesos del modelo en memoria requiere de 15 a 30 segundos de tiempo facturable antes de que empiece la difusión. Además, si la generación falla por un error de CUDA, se te sigue facturando el tiempo de ejecución del contenedor transcurrido.
P4: ¿Qué ocurre si una tarea de inferencia de vídeo falla o se cancela?
En ToAPIs, la facturación de la tarea depende estrictamente de que la generación de medios tenga éxito. Cualquier solicitud que acabe en FAILED, TIMED_OUT o rechazo por moderación de contenido tiene un coste de estrictamente $0.00. No se descuenta saldo por renders incompletos o abortados.
8. Lista de acciones y siguientes pasos
- Crea una cuenta: regístrate en ToAPIs.com para recibir créditos de prueba iniciales.
- Obtén tu clave unificada: genera tu clave de API de producción en el panel de desarrollador de ToAPIs.
- Configura tu endpoint: apunta el cliente de vídeo de tu aplicación a
https://api.toapis.com/v1/videos/generations. - Despliega enrutamiento inteligente: envía por defecto la generación no crítica a 720p a $0.028/s y reserva el 1080p para los activos principales de cara al cliente.
Guías y documentación relacionadas
- 📖 Guía de inicio rápido de la API de Seedance 2.0: recorrido de integración completo con Node.js y Python.
- 📊 Análisis profundo de precios de Seedance 2.0 vs 2.5: análisis de tarifas por segundo y desglose de multiplicadores de resolución.
- ⚡ Matriz de precios de ToAPIs: tarjetas de tarifas mayoristas en tiempo real para más de 100 modelos de IA multimodales.