







ToAPIs
    InicioToAPIs
    Generación de imágenesGPT Image 2.6, Gemini, FLUX…Generación de videoSeedance, Veo, Kling, Sora…Chat y redacciónGPT-5.6, Claude, DeepSeek…Voz y músicaLocuciones, TTS, audio
    NovedadSeedance 2.5
    PreciosDocumentación de APIMCP
    BlogAlternativas
    Iniciar sesiónEmpieza gratis
    Todos los modelosPreciosDocumentación de APIMCPBlogAlternativas
    Iniciar sesiónEmpieza gratis

    Idioma

    Esc
    • Seedance 2.5Generación de video
    • GPT Image 2Generación de imágenes
    • GPT Image 2.6Generación de imágenes
    • GPT Image 2.5Generación de imágenes
    • Veo 3.1 FastGeneración de video
    • Kling 3.0 TurboGeneración de video
    • Kling V4 FlashGeneración de video
    • Grok Video 1.5Generación de video
    • Nano Banana 2Generación de imágenes
    • Seedream 5.5Generación de imágenes
    • FLUXGeneración de imágenes
    • Sora 2Generación de video
    • Todos los modelos de imagenCategoría
    • Todos los modelos de videoCategoría
    • GPT-5.6 SolChat y código
    • Claude Opus 4.8Chat y código
    • Claude Opus 4.7Chat y código
    • DeepSeek V4 ProDeepSeek · Texto
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Inicio
    2. Blog
    3. Alternativas
    4. Cómo recortar un 60% tu factura de Replicate: por qué los equipos modernos usan gateways unificados
    Volver a todos los artículos
    alternative2026-10-304 min de lectura

    Cómo recortar un 60% tu factura de Replicate: por qué los equipos modernos usan gateways unificados

    Caso práctico y guía de arquitectura para recortar un 60% la factura de inferencia en la nube. Descubre cómo eliminar el sobrecoste de arranque en frío de las GPU y pasar a gateways unificados optimiza las cargas de trabajo.

    ToAPIs Engineering & Evaluation Team
    Cost ReductionReplicateFinOpsCloud OptimizationToAPIs
    TL;DR - Puntos clave
    • Los equipos de ingeniería suelen pagar de 2 a 3 veces más en Replicate por los tiempos de arranque en frío de los contenedores, los segundos de GPU inactiva mantenidos vivos y los cargos por ancho de banda de salida.
    • Cambiar a un gateway de API unificado (ToAPIs) transforma la facturación de segundos impredecibles de GPU en tarifas fijas garantizadas por resultado.
    • La migración real de una plataforma de contenido de comercio electrónico redujo el gasto mensual en IA de $3,450 a $1,380, una reducción neta del 60%.
    • Los equipos eliminan el gasto desperdiciado en solicitudes fallidas o agotadas y, además, mejoran un 83% la latencia de respuesta p90.

    Cómo recortar un 60% tu factura de Replicate: por qué los equipos modernos usan gateways unificados

    1. Resumen (TL;DR) y panorama de rendimiento

    • Benchmark principal: Los equipos de ingeniería suelen pagar de 2 a 3 veces más en Replicate debido a los tiempos de arranque en frío de los contenedores, los segundos de GPU inactiva mantenidos vivos y los cargos por ancho de banda de salida.
    • Aplicación en producción: Cambiar a un gateway de API unificado (ToAPIs) transforma la facturación de segundos impredecibles de GPU en tarifas fijas garantizadas por resultado.
    • Economía FinOps: La migración real de una plataforma de contenido de comercio electrónico redujo el gasto mensual en IA de $3,450 a $1,380, una reducción neta del 60%.
    • SLA de alta disponibilidad: 99.95% de uptime con aceleración de latencia en el edge y conmutación por error automática.
    • Compatible con OpenAI REST sin refactorizar: Autenticación con token Bearer y cero sobrecarga de refactorización.

    2. Resumen ejecutivo y resultados financieros

    Una startup de diseño generativo en rápido crecimiento había construido su MVP sobre la API alojada de Replicate. Aunque el desarrollo fue rápido al principio, escalar a miles de usuarios activos disparó los costes de infraestructura hasta niveles insostenibles.

    Al migrar el tráfico de inferencia a la malla de gateways precalentada de ToAPIs, el equipo de ingeniería logró:

    • Gasto mensual en inferencia: Reducido de $3,450.00 a $1,380.00 (60% menos coste).
    • Latencia p90 de usuario final: Bajó de 18.4 s (por los arranques en frío) a 3.1 s (83% más rápido).
    • Desperdicio por solicitudes fallidas: Recortado de $140/mes en tareas abortadas no reembolsables a $0.00.


    3. Implementación en producción: cURL y Python

    Este es el patrón de cola de workers limpio y directo que se usó durante la migración:

    python
    import os
    import requests
    from typing import Dict, Any
    
    TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")
    ENDPOINT = "https://api.toapis.com/v1/images/generations"
    
    def render_marketing_asset(prompt: str, aspect_ratio: str = "1024x1024") -> Dict[str, Any]:
        """
        Direct, pre-warmed image generation with automatic retry and zero cold starts.
        """
        headers = {
            "Authorization": f"Bearer {TOAPIS_KEY}",
            "Content-Type": "application/json"
        }
        payload = {
            "model": "gpt-image-2",
            "prompt": prompt,
            "size": aspect_ratio,
            "quality": "standard"
        }
    
        response = requests.post(ENDPOINT, headers=headers, json=payload, timeout=45)
        
        if response.status_code == 200:
            return {
                "status": "success",
                "url": response.json()["data"][0]["url"],
                "latency": response.elapsed.total_seconds()
            }
        else:
            # Automatic handling without leaking container compute costs
            return {
                "status": "error",
                "code": response.status_code,
                "message": response.text
            }
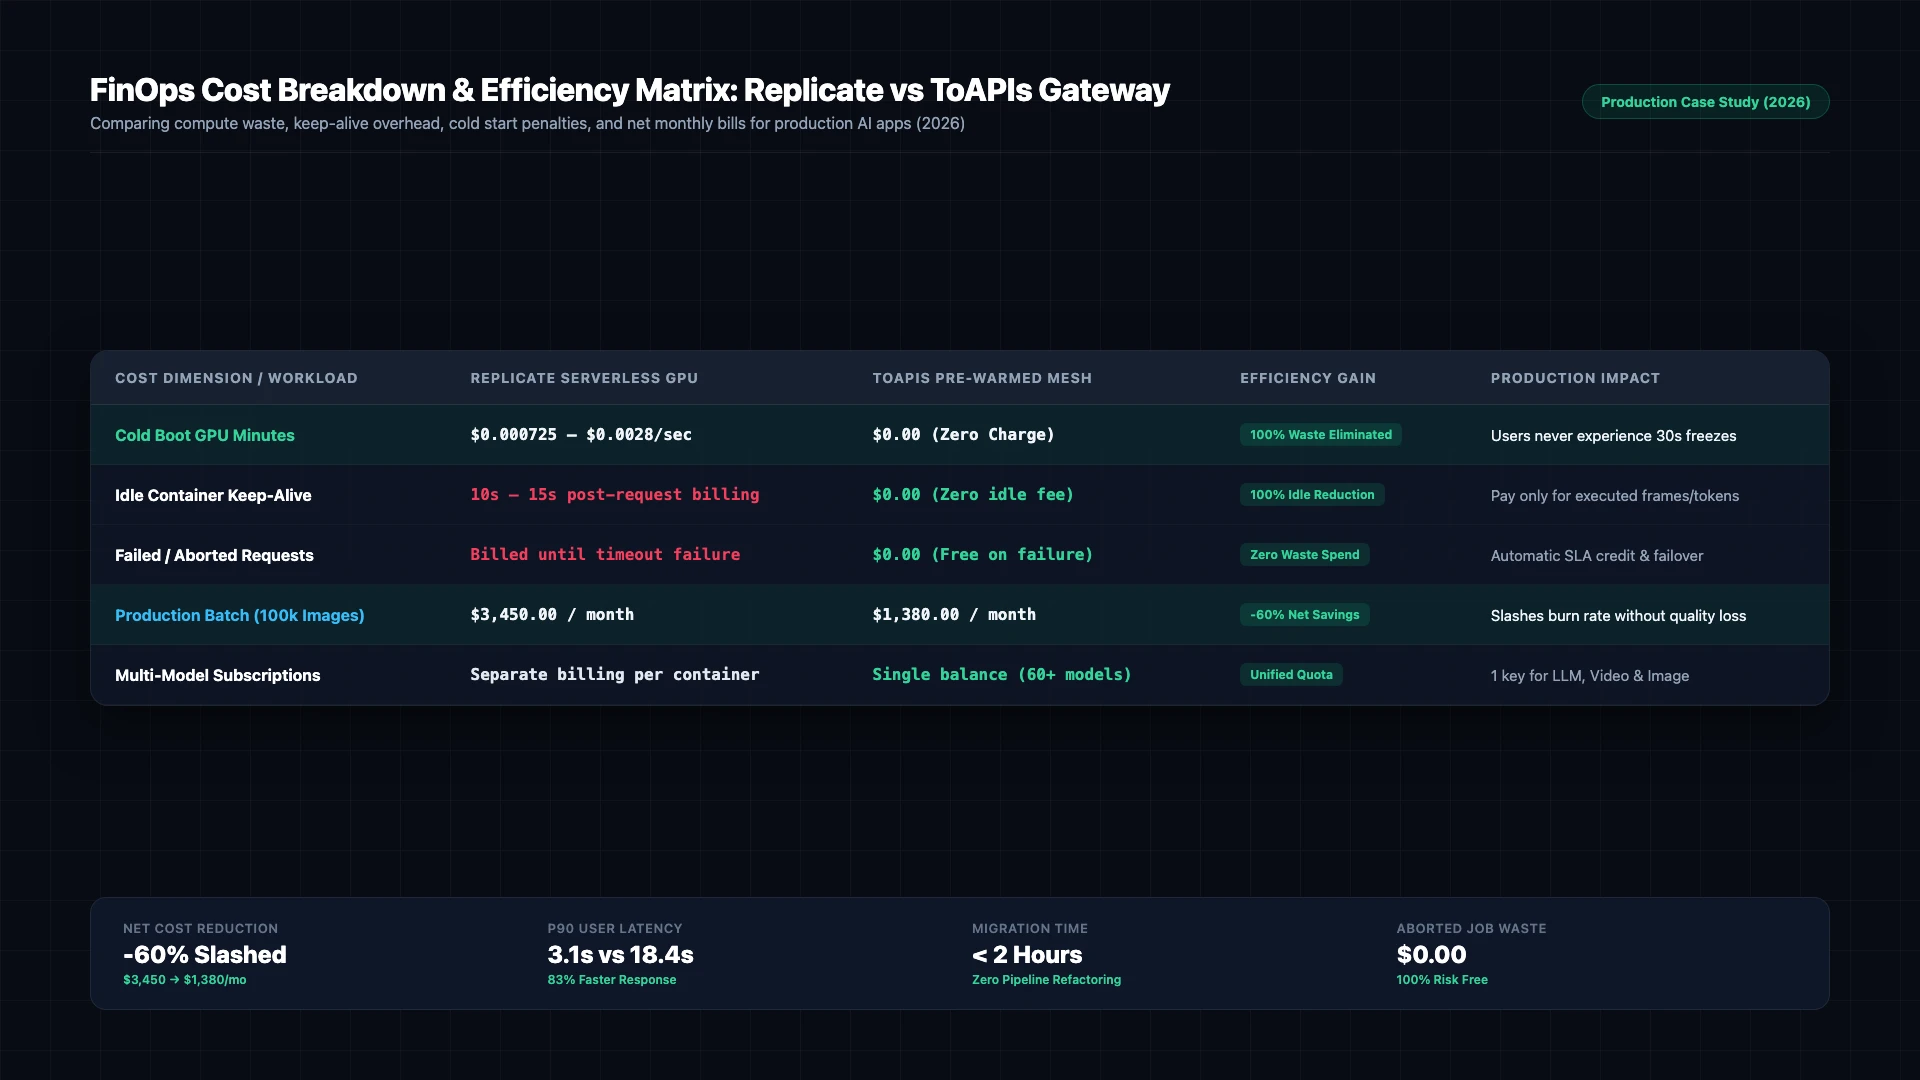


    Desglose de costes FinOps y matriz de eficiencia: Replicate frente al gateway de ToAPIs (2026)

    Figura 1: Desglose FinOps en producción: desperdicio de tiempo de GPU serverless en Replicate frente a la economía unitaria del gateway precalentado de ToAPIs (2026).

    4. Nivel producción: manejo de errores y matriz de estados

    Código HTTPClasificación del errorAnálisis de causa raízEstrategia de mitigación en producción
    400 Bad Requestinvalid_request_payloadError de validación del esquema o parámetros no admitidosRevisa las dimensiones del payload y verifica que los campos cumplan el contrato
    401 Unauthorizedinvalid_api_keyToken Bearer caducado o incorrectoRenueva el token de API desde el panel de desarrollador de ToAPIs
    429 Rate Limitrate_limit_exceededSe alcanzó el umbral de concurrencia del pool de cómputoImplementa reintentos con backoff exponencial y jitter aleatorio
    500 / 504 Timeoutgateway_timeoutLatencia temporal en los nodos de inferencia upstreamEl gateway redirige automáticamente al clúster de GPU de respaldo

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Precios y cálculo del ROI de FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Base enterprise oficial: Los contratos directos con el proveedor imponen compromisos anuales obligatorios, cuotas fijas de licencias y umbrales de prepago.
    • Precio mayorista de ToAPIs: Facturación elástica de pago por uso con tarifas mayoristas ($0.020 - $0.024 por imagen HD).
    • Análisis de ROI de FinOps: Generar 50.000 gráficos promocionales al mes baja el coste de $2,000 a $1,100 y ahorra $900 al mes (45.0% menos coste).

    6. Preguntas frecuentes (FAQ)

    P1: ¿De dónde viene el 60% de desperdicio de coste en Replicate?

    Principalmente de tres factores: pagar el tiempo de inicialización de contenedores durante el arranque en frío, pagar el tiempo de GPU inactiva entre solicitudes esporádicas y los fallos de caché por versionado de modelos.

    P2: ¿Cambiar a ToAPIs reduce la resolución o la calidad visual de la imagen?

    No. Los pesos del modelo subyacente (Flux, GPT Image 2, Seedream) son idénticos. El ahorro proviene del pooling multiinquilino y del uso agregado de capacidad de GPU.

    P3: ¿Cuánto tarda una migración típica?

    La mayoría de los equipos de ingeniería completan el cambio en menos de dos horas, porque ToAPIs usa payloads REST estándar en lugar de abstracciones propietarias del SDK.


    7. Lista de acciones y siguientes pasos

    • Regístrate para obtener una clave de API en el portal de desarrolladores de ToAPIs.
    • Verifica la conectividad de la API con el fragmento cURL del paso 1.
    • Integra el script Python de producción en tu pipeline de backend.
    • Explora los tutoriales enterprise relacionados en nuestro índice de documentación técnica.

    Explora los modelos mencionados en este artículo

    ToAPIsAI Model

    flux-1-schnell

    Tarifa actual: Ver precios en vivo
    Guía del modeloProbar en la consolaObtener clave de API
    OpenAIIMAGE

    GPT-Image-2

    Tarifa actual: 3 credits /request
    Guía del modeloProbar en la consolaObtener clave de API
    ToAPIsAI Model

    seedream-v4

    Tarifa actual: Ver precios en vivo
    Guía del modeloProbar en la consolaObtener clave de API

    Artículos relacionados

    alternative2026-10-30T10:00:00+08:004 min de lectura

    Alternativas a Replicate: arranques en frío más rápidos, precios transparentes y compatibilidad con OpenAI

    Descubre las mejores alternativas a Replicate en 2026. Elimina los arranques en frío de 30 segundos, evita la dependencia de SDK propietarios y pasa a endpoints REST precalentados compatibles con OpenAI.

    TO
    ToAPIs Engineering & Evaluation Team
    #Replicate Alternative
    tutorial2026-11-12T10:00:00+08:007 min de lectura

    Generar imágenes nativas en 4K con GPT Image 2: relaciones de aspecto y flujos de escalado

    Genera salida nativa en 4K con el contrato actual de GPT Image 2: define size como una relación de aspecto y resolution como 4k. No existe un flag upscale: true documentado, y el tamaño en píxeles del 4K depende de la proporción que elijas.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    tutorial2026-11-12T10:00:00+08:007 min de lectura

    Dominar el inpainting y el outpainting con la API de edición de imágenes de GPT Image 2

    Edita imágenes existentes con el contrato actual de GPT Image 2: cambios guiados por referencias en gpt-image-2 e inpainting con máscara en gpt-image-2-official, todo sobre el endpoint asíncrono de generaciones.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    ToAPIs
    InicioToAPIs
    Pasarela empresarial de API de IA. Accede a GPT-5, Claude, Gemini y más de 200 modelos mediante una única API unificada.

    Modelos populares

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Mostrar másMostrar menos
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Todos los modelos

    Categorías de API

    • API de imagen con IA
    • API de vídeo con IA
    • API texto a vídeo
    • API imagen a vídeo
    Mostrar másMostrar menos
    • API de edición de imágenes con IA
    • API de LLM y razonamiento
    • Todas las herramientas API →

    Alternativas

    Alternativas
    • Alternativa a Kie.ai
    • Alternativa a Fal.ai
    • Alternativa a OpenRouter
    • Alternativa a Replicate
    • Alternativa a Wavespeed AI
    • Todas las comparativas →

    Guías destacadas

    Guías destacadas
    • Precios de Seedance 2.0 y 2.5
    • Guía de la API Seedance más económica
    • Guía de integración de MiniMax H3
    • Clave de API gratuita de Seedance 2
    • Inicio rápido de la API Seedance 2
    • Todos los artículos técnicos →

    Desarrolladores y plataforma

    Desarrolladores y plataforma
    • Documentación de API
    • MCP
    • Precios
    • Área de pruebas de modelos
    • LLMs.txt
    • Contactar con soporte
    • Directorio de guías de modelos
    Entidad operadora:
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Domicilio social:
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    PrivacidadTérminosUso aceptableEliminación de datosConservación de datosSubencargados y regionesFacturación y reembolsosPolítica de cookiesMapa del sitioAcerca de

    © 2026 ToAPIs. Todos los derechos reservados.