
GPT-6.2 APIの統合は、モデル名の変更として扱う前に、契約仕様を検証する作業として扱ってください。 使用状況レポートのラベルは興味深い情報であっても、アプリケーションがどのリクエストを送信できるか、どのアカウントに送信権限があるか、実行した作業にいくらかかるかまでは教えてくれません。直近のエンジニアリング上の課題は、設定ファイルでは正しく見えても、プロバイダーとの境界で失敗するデプロイを避けることです。
レビュー日:2026年11月4日。 本記事では、競合他社APIYIの11月2日付と11月3日付の2本の記事を検討します。そこに記された展開の説明、スクリーンショット、デモのモデル帰属は、第三者による報告です。本調査環境からOpenAI公式のモデルディレクトリとAPI変更履歴に直接リクエストしたところ、HTTP 403が返されました。したがって、アクセスが遮断されたことを、存在する証拠にも存在しない証拠にも扱いません。私たちは、認証付きのGPT-6.2推論を実行しておらず、見積もりを取得しておらず、元のスクリーンショットを独自に検証してもいません。
概念図:展開の手掛かり、契約仕様の検証、統合準備は異なる段階です。公式発表やモデルの実測出力ではありません。
1. GPT-6.2の展開に関する報告から何が分かるか
APIYIの展開分析では、Codexの使用状況画面に表示されたとされるgpt-6.2-astraの項目、展開率の違い、レスポンスの断片、CLIでの実験について説明しています。また、公式確認がないことや、CLIの引数に依存することの根拠の弱さも論じています。これらは調査の手掛かりとして有用です。ただし、ToAPIsの記事チーム自身が観測したものではなく、本ガイドでは、報告された割合を検証済みのテレメトリとして転載しません。
重要なのは、どこかに名前が現れることと、安定した製品の契約仕様が存在することを区別することです。内部エイリアスは、公開で選択可能になる前にログへ記録される場合があります。クライアントが文字列を受け付けても、サーバー側ではまだ検証されていない場合があります。プロバイダーが、あるアカウントと別のアカウントとで異なるルーティングを行う場合もあります。これらの可能性のいずれも、GPT-6.2の実際の挙動を確定するものではありません。スクリーンショットだけでは重要な疑問が残る理由を説明するものです。
| 証拠 | 裏付けられること | 引き続き検証が必要なこと |
|---|---|---|
| 使用状況のスクリーンショットを引用した競合他社の記事 | 特定の日付で主張が公開されたこと | 元の文脈、真正性、アカウントの適用範囲、再現性 |
| CLIがモデル引数を受け付ける | ローカルクライアントが文字列を受け付けたこと | サーバーのサポート、認可、実際のレスポンスの識別情報 |
| modelフィールドを含む完了したレスポンス | そのリクエストに対し、報告された識別子が返ったこと | エイリアスの挙動、文書化された保証、課金、利用可能性 |
| モデルラベル付きの公開デモ | 制作者が成果物をそのラベルのモデルによるものとしていること | 入力全体、ツール、試行回数、設定、独立した再現 |
| プロバイダーのドキュメントと許可されたリクエスト | 文書化された特定のアカウント経路で動作すること | 運用上の制限、継続的な利用可能性、サポート条件 |
GPT-6.2のリリース日について慎重に答えるには、情報源とその適用範囲を明確にする必要があります。コミュニティの予測は予測であり、発表は発表です。APIアクセスのテストで確認できるのは、そのアカウントがその時点で何をできたかだけです。日付が異なる場合は、3つすべてを保持してください。「検証できなかった」を「存在し得ない」に変えてはならず、競合他社の見出しを公式ローンチの告知に置き換えてもいけません。
概念図:スクリーンショット、CLI入力、ドキュメント、リクエスト記録は、それぞれ証拠の適用範囲が異なります。
2. まずオフラインの評価パックを作成する
モデルの利用可能性が確定する前でも、有用な統合作業を準備できます。少数の代表的なタスクと、明示的な合格基準から始めてください。一度きりの見事なデモを作れるモデルでも、実際のワークフローでは必須のJSONフィールドを欠落させたり、安全でないツールを選んだりするかもしれません。こうした失敗を事前に定義することで、見栄えのよい出力に評価が引きずられるのを防げます。
以下のPython 3の例は、標準ライブラリだけを使用します。空の作業ディレクトリに保存し、ローカルで実行してください。3つのケースと、意図的に未記入にした契約仕様の記録を作成します。プロバイダーへの呼び出しは行わず、キーも不要で、GPT-6.2がこれらのタスクをサポートするという主張もしません。モデルフィールドが空なのは意図的です。実際に選ぶプロバイダーについて、文書化された識別子とアクセス権を確認した後にのみ置き換えてください。
import json
from pathlib import Path

cases = [
    {
        "id": "structured-01",
        "task": "structured_output",
        "prompt": "Extract item and quantity from: Please order 3 blue mugs.",
        "expected": {"item": "blue mugs", "quantity": 3},
        "checks": ["valid JSON", "exact keys", "integer quantity"],
    },
    {
        "id": "code-01",
        "task": "coding",
        "prompt": "Implement clamp(x, low, high); reject low greater than high.",
        "checks": ["boundary tests", "invalid bounds", "no network access"],
    },
    {
        "id": "tool-01",
        "task": "tool_selection",
        "prompt": "Check order status; no order ID was supplied.",
        "checks": ["ask for order ID", "do not invent an ID", "no write tool"],
    },
]
contract = {
    "provider": None,
    "documented_model_id": None,
    "request_documentation_url": None,
    "access_checked_at": None,
    "billing_unit": None,
}
Path("evaluation-cases.jsonl").write_text(
    "".join(json.dumps(case, ensure_ascii=False) + "\n" for case in cases),
    encoding="utf-8",
)
Path("provider-contract.json").write_text(
    json.dumps(contract, indent=2) + "\n", encoding="utf-8"
)
print(f"Prepared {len(cases)} offline cases; provider contract remains unverified.")
これらの例を、機密情報を取り除いたアプリケーションの実際の失敗パターンに合わせて拡充してください。既存の挙動を守るための簡単なケースと、候補間の違いを見極める難しいケースの両方を含めます。プロンプト、参照解答、スキーマ、テスト環境をまとめてバージョン管理してください。実行中に期待する答えを変更した場合は、合格率を黙って書き換えるのではなく、新しい評価リビジョンを開始します。
コーディングでは、意図した言語と依存関係を備えた使い捨て環境で実行することが受け入れテストです。もっともらしいパッチを読むだけでは不十分です。構造化抽出では、スキーマと意味の両方を検証してください。構文上正しいJSONでも、捏造された値が含まれることがあります。ツールでは、引数の妥当性、認可、確認の質問をすることが正しい行動だったかを確認します。これらの検査は、GPT-6.2がいつ利用可能になるかにかかわらず有用です。
3. GPT-6.2とFable 5.5のデモでモデルの順位を決められない理由
APIYIの2本目の記事、Fable 5.5とGPT-6.2 Astraの比較は、複数の公開デモを整理し、タスクが異なることを明示しています。Fable 5.5によるものとされる複数の作品と、GPT-6.2によるものとされるピクセルアニメーションのデモを紹介しています。本レビューでは、こうしたモデル帰属は引き続き制作者または競合他社の主張として扱います。私たちは成果物を再現しておらず、実際に応答したモデルを検証してもいません。
ゲーム、短編映画、アニメーションは、それぞれ異なるワークロードです。見た目の品質は、テストする価値のあるタスクを見つける助けにはなりますが、成功率、レイテンシー、コストを比較する共通の基準にはなりません。試行回数も重要です。選び抜かれた成功作だけでは、失敗の回数も、完成までに必要だった手作業での修正量も分かりません。
公平な比較では、実行前にタスク、入力、使用可能なツール、制限時間、出力の制約、再試行ポリシーを固定します。すべての試行について、文書化されたモデル識別子と推論設定を記録してください。要求した機能をモデルがサポートしていない場合は、その制限を明示します。表を埋めるために、黙って追加のツールを与えたり、異なる制約を適用したりしてはいけません。すべてのプロバイダーが同一のパラメーターを公開しているかのように扱うより、運用上の予算をそろえるほうが有用な場合が多くあります。
人間の判断が必要な場合は、ブラインドレビューを使用してください。レビュアーには、モデル名を示さずにタスクと合格基準を渡します。意見の相違を記録し、最終スコアを付ける前に検討してください。非決定的なタスクは繰り返し実行し、最良の出力だけでなく分布も保持します。小規模な予備評価は統合上の誤りを明らかにできますが、それをもって、GPT-6.2がコーディング、推論、エージェント作業で普遍的に優れていると広く主張すべきではありません。
概念図:同じタスク、ツール、予算で公平に評価します。実測結果やモデルの順位は示していません。
4. API境界で識別情報、ツール、失敗時の挙動を検証する
プロバイダーがGPT-6.2へのアクセスを文書化したら、最初の許可されたテストは小規模で読み取り専用にしてください。ドキュメントのURL、確認日、アカウントの適用範囲、正確なリクエスト識別子を保存します。レスポンスの識別子は、リクエストのラベルを上書きせず、別に記録してください。プロバイダーがエイリアスをサポートする場合は、その安定性についてどのように説明しているか、バージョンを固定できるかを記録します。返された名前は診断に役立つ証拠であり、基盤となるモデルの重みについての独立した保証ではありません。
| 契約仕様の項目 | 記録する内容 | 受け入れ時の確認事項 |
|---|---|---|
| リクエストのインターフェース | エンドポイント、SDKバージョン、文書化されたモデルID | この正確な組み合わせはサポートされているか? |
| アカウントのアクセス権 | プロバイダー、リージョン、プロジェクト、利用資格の適用範囲 | 本番で使用するアカウントにアクセス権があるか? |
| 出力の契約仕様 | ストリーミング、スキーマの挙動、完了および使用量のフィールド | アプリケーションは、完全で有効な結果を認識できるか? |
| ツールの契約仕様 | サポートされるツール、引数スキーマ、認可の境界 | アプリケーションは、無効または認可されていない呼び出しを拒否できるか? |
| 失敗時の契約仕様 | エラー分類、再試行の指針、キャンセル時の挙動 | アクションを重複実行せずに失敗を終了できるか? |
| 課金の契約仕様 | 入力、出力、キャッシュ、その他の課金対象単位 | 観測したリクエストと請求を照合できるか? |
使い慣れたSDKだからといって、すべてのオプションに移植性があると思い込まないでください。推論の設定、構造化出力モード、コンテキストの上限、ストリーミングイベント、ツールの意味論は、バージョンごとに検証する必要があります。本記事では、GPT-6.2のエンドポイントやSDKの呼び出し例を提示していません。ここでは独自に確認できたものがないためです。契約仕様を検証できたら、古いサンプルのモデル文字列を推測で差し替えるのではなく、適用範囲と日付を添えて、テスト済みの最小リクエストを追加してください。
タイムアウトと再試行には、独立した受け入れテストが必要です。クライアントのタイムアウトは、サーバーで実行が停止したことを証明しません。中断されたストリームには、不完全なツール呼び出しが含まれることがあります。レート制限に遭遇したら、無限ループではなく、プロバイダーが文書化した再試行ポリシーと回数に上限のある再試行を適用すべきです。一時的な容量不足のエラーを、無効な入力、アクセス権の不足、未対応のモデルと区別し、再試行が適切な分類のエラーだけを再試行してください。
外部に影響を及ぼす操作は、アプリケーションの認可を必須にしてください。モデルが生成した支払い、ファイル削除、外部へのメッセージ送信は、ツール呼び出しの形式が正しいというだけで実行してはいけません。読み取り専用の評価ツール、使い捨てのテスト用データ、製品で必要とされる場合は監査可能な承認を使用します。これはアプリケーション設計上の責任であり、GPT-6.2が特定の安全性やツール機能を備えるという主張ではありません。
可観測性のために、リクエストID、タイムスタンプ、終了状態、使用量の合計、機密情報を除去したエラー分類を保存してください。キーや不要な顧客コンテンツは保持しないでください。評価ログは、リグレッションを診断できるだけの具体性を持たせつつ、自社のデータ規則を守れる範囲に制限します。返される識別子や挙動が予期せず変わった場合は、新しい結果を以前のベースラインに混ぜるのではなく、本番への昇格を止めて調査してください。
5. GPT-6.2の料金:合格タスク当たりのコストを計算する
本レビューでは、GPT-6.2の確定した料金を確認していません。うわさの記事、別のバージョン、サブスクリプションプランに出てくる数値は、検証済みのAPI見積もりではありません。料金が文書化されたら、通貨、課金単位、適用開始日、リージョン、プロバイダーを確認してください。選択したプロバイダーが課金する場合、キャッシュ済み入力、出力、推論に関連する使用量、ツール実行、最低料金は、個別に扱う必要があるかもしれません。そうした項目が存在する、または存在しないと思い込まず、検証してください。
アプリケーションにとって有用な分母は、通常、合格したタスク数です。課金される場合は失敗や不合格の出力も含め、すべての試行に適用される料金を合算し、合格基準を満たした件数で割ります。測定に基づき一貫した算入方法がない限り、人手による修正コストは別にしてください。名目上のトークン単価が安くても、再試行や使えない結果が増えれば、合格した作業のコストは高くなり得ます。
以下の単独で実行できるスクリプトは、架空の単価を使って計算方法を示します。GPT-6.2の料金見積もりではなく、ToAPIsやOpenAIの課金を表すものでもありません。最初の例とは別に実行してください。出力は小さなJSONサマリーだけです。レビュアーが前提を確認できるよう、単価、ワークロード、合格件数をすべて意図的にコード内で宣言しています。
import json

input_tokens = 1_000_000
output_tokens = 200_000
input_rate_per_million = 2.00  # Hypothetical USD rate
output_rate_per_million = 8.00  # Hypothetical USD rate
billed_attempts = 100
accepted_tasks = 80
assert 0 < accepted_tasks <= billed_attempts

total = (
    input_tokens / 1_000_000 * input_rate_per_million
    + output_tokens / 1_000_000 * output_rate_per_million
)
print(json.dumps({
    "scenario": "hypothetical, not a provider quote",
    "billed_attempts": billed_attempts,
    "accepted_tasks": accepted_tasks,
    "total_usd": round(total, 4),
    "usd_per_accepted_task": round(total / accepted_tasks, 4),
}, indent=2))
| 仮定のシナリオ | 課金総額 | 合格タスク数 | 合格タスク当たりのコスト |
|---|---|---|---|
| 例A | $3.60 | 80 | $0.045 |
| 支出は同じで合格数が少ない場合 | $3.60 | 60 | $0.060 |
| 支出も合格数も多い場合 | $4.00 | 90 | 約$0.0444 |
この表は、品質が経済性を変える理由を示しています。条件をそろえた推論の実行結果に基づいていないため、実際のコストが最も低いモデルを確定することはできません。実際にGPT-6.2を評価する際は、合計と併せて、元の試行回数、課金対象の使用量、再試行ポリシー、不合格の理由を含めてください。レイテンシーは別に報告します。最初のトークンまでの時間、完了までの時間、合格タスクが得られるまでの時間は、それぞれ異なる問いに答えます。測定にネットワークのオーバーヘッド、ツールの処理、再試行を含むかどうかを明記してください。
6. 明示的な移行ゲートを通じて昇格させる
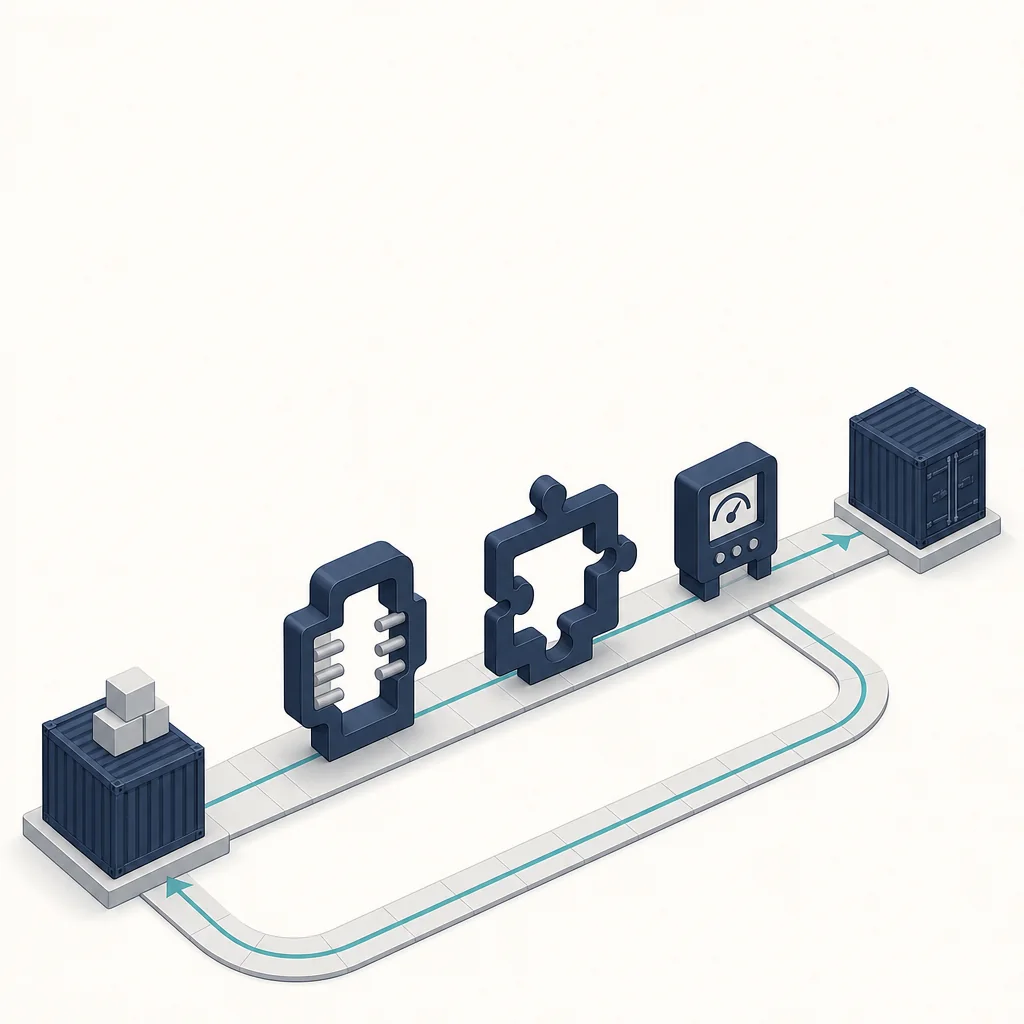
概念図:契約仕様、品質、運用の確認後に限定的な試行へ進み、ロールバック経路を確保します。
候補モデル用のアダプターを準備する間も、現在正常に動作しているモデルをベースラインとして維持してください。設定では、評価用のラベルと、実際に文書化されたプロバイダーの識別子を区別すべきです。未検証の候補は、本番の許可リストの外に置きます。これにより、チームは、推測したエイリアスに誤って顧客トラフィックを送ることなく、GPT-6.2の評価を準備できます。
3つのゲートを使用します。まず、契約仕様のゲートでは、サポートされるリクエスト、使用予定のアカウントのアクセス権、制限、課金を確認します。次に、品質のゲートでは、固定した評価セットを同じ基準と予算で比較します。最後に、運用のゲートでは、レイテンシー、失敗処理、プライバシー設定、監視、ロールバックを確認します。1つのゲートに合格しても、別のゲートの不合格は補えません。見事なデモでは未対応のリクエストスキーマを解決できず、低コストでは無効なツール操作を解決できません。
これらの確認を終えて初めて、範囲を明確に限定した小規模なパイロットに、適切なトラフィックを流すべきです。開始前に、エラーの急増、合格率の低下、予期しない識別情報の変化、予算超過など、パイロットの停止条件を定義してください。ロールバックはアプリケーションが制御できるようにします。フォールバックでも、ユーザーに約束した仕様を維持しなければなりません。代替モデルが必須の出力やプライバシーの制約を満たせない場合は、互換性のない挙動へ黙って置き換えるのではなく、制御された失敗として示してください。
モデルカタログ、料金ページ、APIドキュメントを使い、現在サポートされている統合経路を確認してください。これらのリンクは検証の入口であり、GPT-6.2が掲載されていることやアクセス可能であることを約束するものではありません。本ガイドだけを根拠に購入や移行を行わないでください。有用なローンチ更新では、読者が判断を再現できるよう、正確なドキュメント、テストの範囲、残っている制限を追加する必要があります。
7. 開発者が寄せるGPT-6.2への疑問
GPT-6.2 APIは今すぐ利用できますか?
本レビューでは、公開APIの利用可能性やToAPIsのサポートを確認していません。競合他社の記事ではCodexの展開の痕跡とされる情報を論じていますが、そのアクセス経路は公開APIと異なる可能性があります。プロバイダーのドキュメントと、使用予定のアカウントの認可を確認してください。本調査環境で公式ページを取得できないことは、不在の証明にはなりません。また、本記事は、非公開のデプロイが存在しないと主張するものでもありません。
CLIのモデル名で基盤モデルを確認できますか?
いいえ。クライアントが引数を受け付けても、確認できるのはローカルで入力が受理されたことだけです。返されたmodelフィールドは、特定のレスポンスに関する証拠を追加しますが、エイリアスの扱いやプロバイダーの保証は、引き続き文書で確認する必要があります。秘密情報を含めず、すべてのテスト条件を記録してください。アクセス手段として、利用できないモデル識別子を繰り返し推測することを推奨してはいけません。
リリース日と料金はどうなっていますか?
ここでは、公式リリース日も検証済みのGPT-6.2 API料金も独自に確認できていません。競合他社の記事は日付付きの報告であり、私たちによる公式確認ではありません。本記事の数値例は、仮定であることを明示しています。リリース日と料金に関する主張を更新する際は、情報源、日付、プロバイダーの適用範囲、該当する場合は再現可能な受け入れ検証の証拠を必ず添えてください。
コーディングではGPT-6.2のほうがFable 5.5より優れていますか?
引用したデモ比較では、この問いには答えられません。タスクとサンプル数が異なり、モデルの帰属も自己申告だからです。固定した環境、ツール、予算で同じコーディングタスクを実行し、正確性、修正の手間、合格タスク当たりのコスト、運用時の挙動を評価してください。限定的なサンプルを一般的な順位付けに変えるのではなく、結果の適用範囲を報告します。
情報源と更新方針
- APIYI:GPT-6.2 Astraの展開の兆候と疑問点、2026年11月2日付 — 競合他社による報道。元の主張の真正性は、ここでは独自に確認していません。
- APIYI:Fable 5.5とGPT-6.2 Astraの比較、2026年11月3日付 — 競合他社によるデモの考察。本チームによる条件を統制したベンチマークではありません。
- OpenAI APIモデルディレクトリ — 検証の入口。本レビュー中の直接取得ではHTTP 403が返されました。
- OpenAI API変更履歴 — 検証の入口。本レビュー中の直接取得ではHTTP 403が返されました。
今後の更新では、新たに検証できた契約仕様の詳細と、以前に報告された手掛かりを区別すべきです。正確な情報源と確認日を追加し、性能を主張する前に評価方法を公開し、明示した制限を保持してください。後から追加するイラストは、実際の再現可能なテストを記録するものではない限り、概念図として表示する必要があります。生成した画像を、製品のスクリーンショット、公式リリースの発表、実測したGPT-6.2の出力として提示してはいけません。