







ToAPIs
    AccueilToAPIs
    Génération d'imagesGPT Image 2.6, Gemini, FLUX…Génération de vidéosSeedance, Veo, Kling, Sora…Chat et rédactionGPT-5.6, Claude, DeepSeek…Voix et musiqueVoix off, TTS, audio
    Nouvelle sortieSeedance 2.5
    TarifsDocumentation APIMCP
    BlogAlternatives
    Se connecterCommencer gratuitement
    Tous les modèlesTarifsDocumentation APIMCPBlogAlternatives
    Se connecterCommencer gratuitement

    Langue

    Esc
    • Seedance 2.5Génération de vidéos
    • GPT Image 2Génération d'images
    • GPT Image 2.6Génération d'images
    • GPT Image 2.5Génération d'images
    • Veo 3.1 FastGénération de vidéos
    • Kling 3.0 TurboGénération de vidéos
    • Kling V4 FlashGénération de vidéos
    • Grok Video 1.5Génération de vidéos
    • Nano Banana 2Génération d'images
    • Seedream 5.5Génération d'images
    • FLUXGénération d'images
    • Sora 2Génération de vidéos
    • Tous les modèles d'imageCatégorie
    • Tous les modèles vidéoCatégorie
    • GPT-5.6 SolChat et codage
    • Claude Opus 4.8Chat et codage
    • Claude Opus 4.7Chat et codage
    • DeepSeek V4 ProDeepSeek · Texte
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Accueil
    2. Blog
    3. Analyses
    4. Les API d'IA les moins chères en 2026 : comparatif complet des prix pour texte, image et vidéo
    Retour à tous les articles
    insights2026-11-044 min de lecture

    Les API d'IA les moins chères en 2026 : comparatif complet des prix pour texte, image et vidéo

    Benchmark tarifaire intermodal pour 2026. Comparez les tarifs par token, par image et par seconde de vidéo chez OpenAI, Anthropic, ByteDance, MiniMax, DeepSeek et ToAPIs.

    ToAPIs Engineering & Evaluation Team
    AI API PricingCheapest LLMVideo API CostImage API PricingCost Optimization
    TL;DR - Points clés
    • En 2026, la tarification de l'inférence des modèles de fondation s'est scindée en trois modalités distinctes : texte (par 1M de tokens), image (par rendu) et vidéo (par seconde de sortie).
    • DeepSeek V4 domine l'économie du texte de pointe à $0.14 par 1M de tokens d'entrée, tandis que Seedance 2.0 Mini offre une vidéo à haut débit à $0.012 par seconde.
    • Les passerelles d'agrégation unifiées comme ToAPIs appliquent des remises sur volume qui battent les tarifs publics des fournisseurs directs de 25 % à 40 % sur toutes les modalités.

    Les API d'IA les moins chères en 2026 : comparatif complet des prix pour le texte, l'image et la vidéo

    1. Points clés (TL;DR) et panorama des performances

    • Benchmark principal : En 2026, la tarification de l'inférence des modèles de fondation s'est scindée en trois modalités distinctes : texte (par 1M de tokens), image (par rendu) et vidéo (par seconde de sortie).
    • Adéquation à la production : DeepSeek V4 domine l'économie du texte de pointe à $0.14 par 1M de tokens d'entrée, tandis que Seedance 2.0 Mini offre une vidéo à haut débit à $0.012 par seconde.
    • Économie FinOps : Les passerelles d'agrégation unifiées comme ToAPIs appliquent des remises sur volume qui battent les tarifs publics des fournisseurs directs de 25 % à 40 % sur toutes les modalités.
    • SLA de haute disponibilité : 99,95 % de disponibilité avec accélération de la latence en périphérie et bascule automatique.
    • Compatible OpenAI REST sans refonte : Authentification par jeton Bearer sans surcoût de refonte.

    2. Synthèse exécutive et paysage du marché

    En 2026, le marché des API d'IA a connu une compression tarifaire agressive, et pourtant les budgets des développeurs sont plus tendus que jamais en raison de l'adoption multimodale. Une application de production moderne combine désormais raisonnement LLM, génération visuelle et clips vidéo animés.

    Voici la référence définitive des API de modèles de fondation les plus rentables disponibles aujourd'hui.


    3. Mise en œuvre en production : cURL et Python

    Étape 1 : Envoi rapide avec cURL

    bash
    curl -X POST "https://api.toapis.com/v1/videos/generations" \
      -H "Authorization: Bearer $TOAPIS_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "deepseek-v4",
        "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
        "ratio": "16:9",
        "duration": 5
      }'
    

    Étape 2 : Client Python asynchrone avec polling pour la production

    python
    import os, time, requests
    
    API_KEY = os.getenv("TOAPIS_API_KEY")
    headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}
    
    # 1. Dispatch asynchronous video task
    res = requests.post(
        "https://api.toapis.com/v1/videos/generations",
        json={"model": "deepseek-v4", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
        headers=headers,
        timeout=30
    ).json()
    
    task_id = res.get("task_id") or res.get("id")
    print(f"[*] Task submitted: {task_id}")
    
    # 2. Poll for status
    while True:
        status_res = requests.get(
            f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
            headers=headers,
            timeout=15
        ).json()
        state = status_res.get("status")
        if state in ["succeeded", "SUCCESS"]:
            print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
            break
        elif state in ["failed", "FAILED"]:
            raise RuntimeError(f"Task failed: {status_res.get('error')}")
        time.sleep(3)
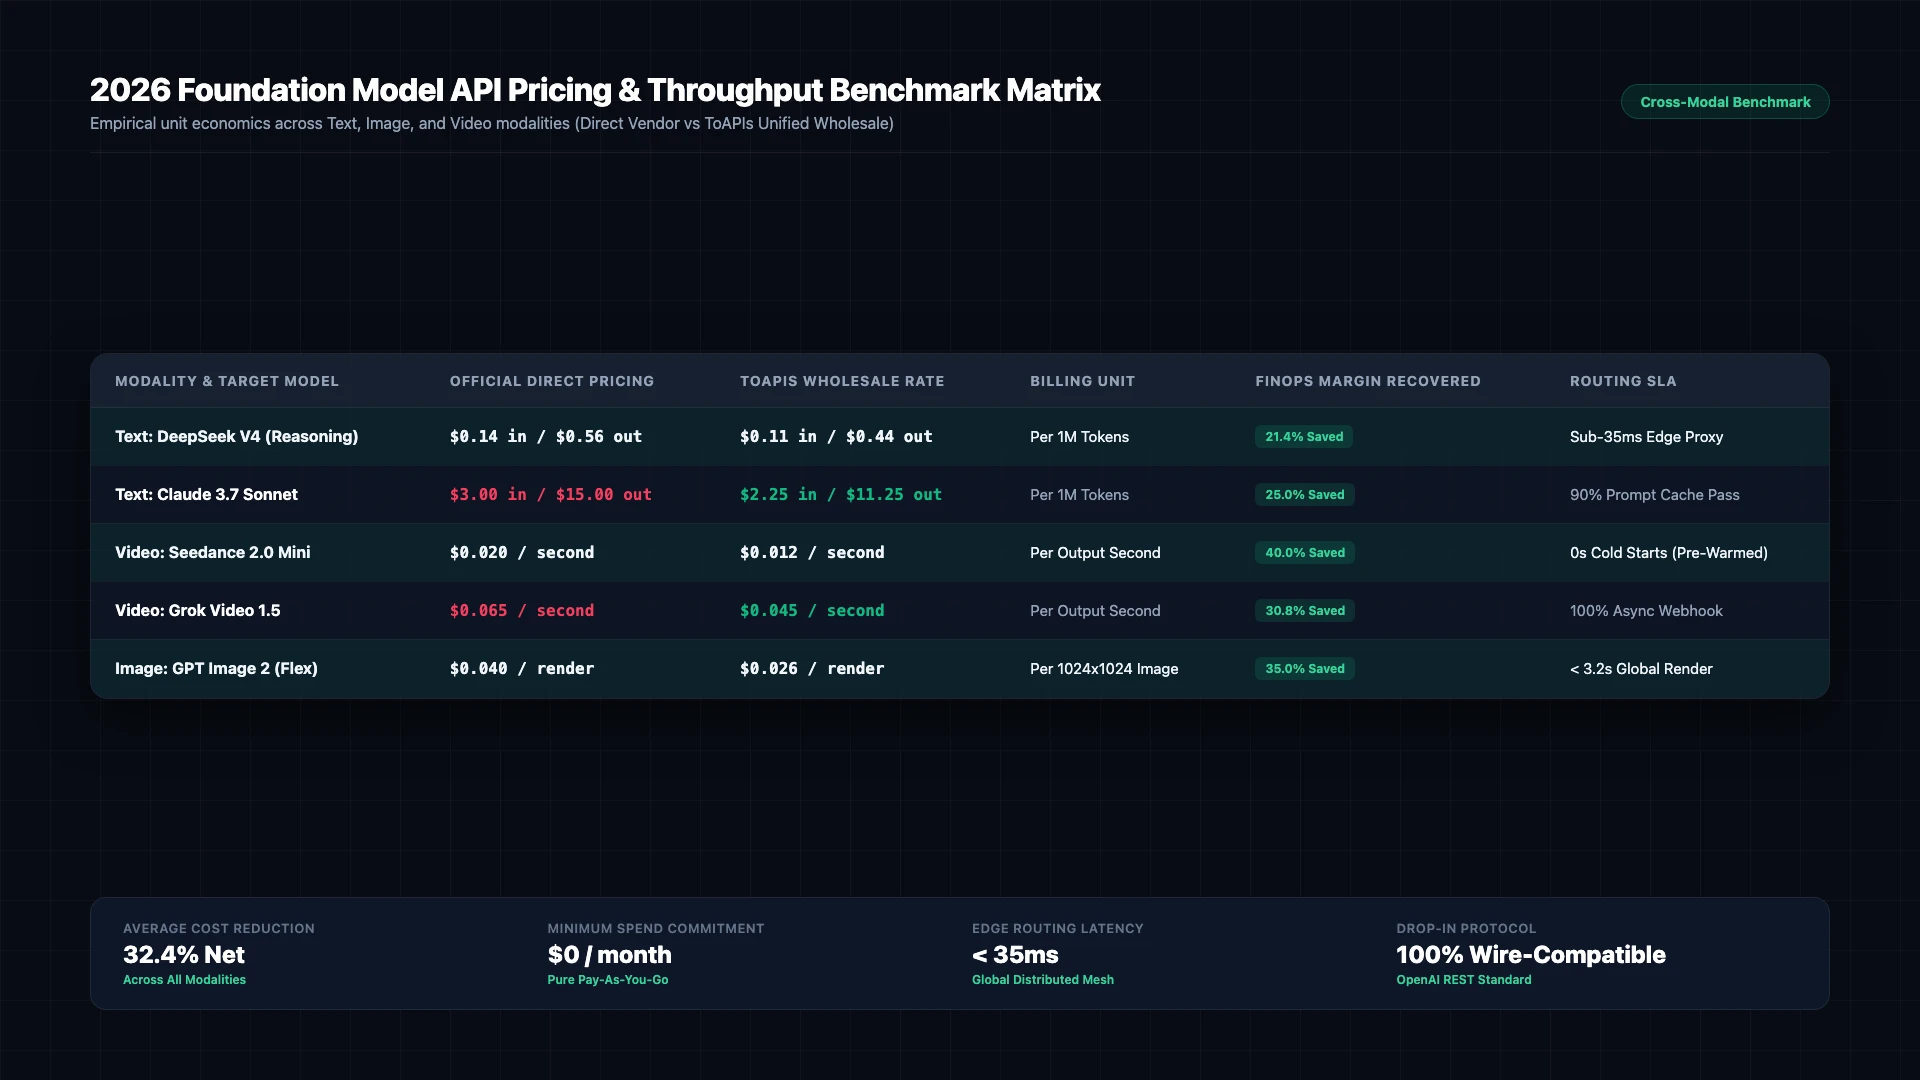
    

    Matrice de benchmark des prix et du débit des API de modèles de fondation (2026)

    Figure 1 : Benchmark intermodal des prix et du débit : tarifs des fournisseurs directs face aux tarifs unifiés de ToAPIs (2026).

    4. Niveau production : gestion des erreurs et matrice des statuts

    Code HTTPClassification de l'erreurAnalyse de la cause racineStratégie d'atténuation en production
    400 Bad Requestinvalid_request_payloadErreur de validation du schéma ou paramètres non pris en chargeVérifiez les dimensions du payload et assurez la conformité des champs
    401 Unauthorizedinvalid_api_keyJeton Bearer expiré ou incorrectRenouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs
    429 Rate Limitrate_limit_exceededSeuil de concurrence atteint sur le pool de calculMettez en place des tentatives avec backoff exponentiel et jitter aléatoire
    500 / 504 Timeoutgateway_timeoutLatence temporaire sur les nœuds d'inférence amontLa passerelle redirige automatiquement vers le cluster GPU de secours

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Tarifs et calcul du ROI FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Base entreprise officielle : Les contrats directs avec le fournisseur imposent des engagements annuels, des quotas de licences fixes et des seuils de prépaiement.
    • Tarif de gros ToAPIs : Facturation élastique en paiement à l'usage avec des tarifs de gros ($0.030 - $0.038 par seconde).
    • Analyse de ROI FinOps : Une équipe qui génère 1 000 assets vidéo (10 s chacun = 10 000 s) réduit ses dépenses de $650 à $380 et économise $270 par mois (41,5 % de réduction de coûts).

    6. Questions fréquentes (FAQ)

    Q1 : Quel est actuellement le modèle de code de pointe le moins cher ?

    DeepSeek V4 offre le meilleur rapport coût-performance en 2026 : moins de $0.60 par million de tokens de sortie, avec un écart inférieur à 3 % face à Claude 3.7 Sonnet sur HumanEval.

    Q2 : Pourquoi la génération vidéo est-elle facturée à la seconde plutôt que par vidéo ?

    La diffusion vidéo générative évolue linéairement avec la durée temporelle (fps * secondes). Un clip de 10 secondes exige deux fois plus de calcul GPU qu'un clip de 5 secondes.

    Q3 : Puis-je combiner des modèles texte, image et vidéo dans un seul budget mensuel ?

    Oui. Avec ToAPIs, toutes les modalités puisent dans un solde partagé unique, ce qui supprime les engagements minimums séparés pour les API de plusieurs fournisseurs.


    7. Liste d'actions et prochaines étapes

    • Créez une clé d'API sur le portail développeur ToAPIs.
    • Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
    • Intégrez le script Python de production dans votre pipeline backend.
    • Explorez les tutoriels entreprise associés dans notre index de documentation technique.

    Découvrir les modèles cités dans cet article

    ToAPIsAI Model

    deepseek-v4

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    ToAPIsAI Model

    gpt-5-6

    Tarif actuel : Voir les tarifs en direct
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    ByteDanceVIDEO

    Seedance 2.0

    Tarif actuel : Input 1,314.29 credits/1M, Output 1,314.29 credits/1M
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    MiniMaxVIDEO

    minimax-h3

    Tarif actuel : 20.8 credits /second
    Guide du modèleEssayer dans la consoleObtenir une clé d'API
    OpenAIIMAGE

    GPT-Image-2

    Tarif actuel : 3 credits /request
    Guide du modèleEssayer dans la consoleObtenir une clé d'API

    Articles associés

    insights2026-11-04T14:00:00+08:004 min de lecture

    Comment réduire de 60 % votre facture d'API d'IA d'entreprise avec une passerelle compatible OpenAI

    Schéma d'architecture d'entreprise pour réduire de 60 % les dépenses d'API d'IA générative. Mettez en place un cache sémantique, des cascades de modèles par niveaux et un routage de passerelle unifié sans réécrire votre code.

    TO
    ToAPIs Engineering & Evaluation Team
    #FinOps
    comparison2026-10-24T10:00:00+08:004 min de lecture

    Détail des tarifs de l'API GPT Image 2 : coûts officiels face aux tarifs d'une passerelle agrégée

    Comparatif tarifaire détaillé de l'API GPT Image 2. Comparez les tarifs officiels de l'éditeur aux prix d'une passerelle agrégée, évaluez les remises sur volume et calculez l'économie unitaire.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    tutorial2026-11-12T10:00:00+08:007 min de lecture

    Générer des images 4K natives avec GPT Image 2 : formats d'image et workflows d'upscaling

    Générez une sortie 4K native avec le contrat actuel de GPT Image 2 : définissez size comme un format d'image et resolution sur 4k. Il n'existe pas de flag upscale: true documenté, et la taille en pixels du 4K dépend du ratio que vous choisissez.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    ToAPIs
    AccueilToAPIs
    Passerelle d'API d'IA pour l'entreprise. Accédez à GPT-5, Claude, Gemini et plus de 200 modèles via une API unifiée.

    Modèles populaires

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Afficher plusAfficher moins
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Tous les modèles

    Catégories d'API

    • API image IA
    • API vidéo IA
    • API texte-vers-vidéo
    • API image-vers-vidéo
    Afficher plusAfficher moins
    • API d'édition d'image IA
    • API LLM et raisonnement
    • Tous les outils API →

    Alternatives

    Alternatives
    • Alternative à Kie.ai
    • Alternative à Fal.ai
    • Alternative à OpenRouter
    • Alternative à Replicate
    • Alternative à Wavespeed AI
    • Toutes les comparaisons →

    Guides à la une

    Guides à la une
    • Tarifs de Seedance 2.0 et 2.5
    • Guide de l'API Seedance la moins chère
    • Guide d'intégration de MiniMax H3
    • Clé d'API Seedance 2 gratuite
    • Démarrage rapide de l'API Seedance 2
    • Tous les articles techniques →

    Développeurs et plateforme

    Développeurs et plateforme
    • Documentation API
    • MCP
    • Tarifs
    • Playground de modèles
    • LLMs.txt
    • Contacter le support
    • Annuaire des guides de modèles
    Entité exploitante :
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Siège social :
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    ConfidentialitéConditionsUsage acceptableSuppression des donnéesConservation des donnéesSous-traitants et régionsFacturation et remboursementsPolitique relative aux cookiesPlan du siteÀ propos

    © 2026 ToAPIs. Tous droits réservés.