








Cómo recortar un 60 % tu factura de API de IA empresarial con una pasarela compatible con OpenAI
1. TL;DR y resumen de rendimiento
- Referencia principal: las facturas de IA empresarial crecen con rapidez por tres ineficiencias estructurales: prompts repetitivos sin caché semántica, enrutar consultas simples a modelos insignia y contratos fragmentados con varios proveedores.
- Adherencia a producción: una estrategia de optimización de tres pilares (caché de prompts + enrutamiento en cascada de modelos + agregación de volumen en la pasarela) recupera de forma fiable el 60 % del gasto mensual en inferencia.
- Economía FinOps: incluye una implementación de pasarela en Python lista para producción, con clasificación automática de prompts y enrutamiento de conmutación por error.
- SLA de alta disponibilidad: 99.95 % de uptime con aceleración de latencia en el borde y conmutación por error automatizada.
- Compatible directamente con OpenAI REST: autenticación con token Bearer y cero sobrecarga de refactorización.
2. Resumen ejecutivo
A medida que la IA generativa pasa de prototipos experimentales a cargas de trabajo empresariales centrales, las facturas mensuales de API escalan a menudo de cientos a decenas de miles de dólares.
Sin una gobernanza arquitectónica deliberada, hasta un 60 % del gasto en inferencia se desperdicia en cálculos redundantes, modelos sobredimensionados y tarifas de proveedor sin optimizar.
Este documento técnico describe el plano de ingeniería probado en batalla que usan las startups de alto crecimiento para recortar un 60 % la factura de inferencia de IA manteniendo o mejorando la latencia y la precisión.
3. Implementación en producción: cURL y Python
Este es un patrón arquitectónico que implementa cascada automática y enrutamiento en la pasarela:
import os
import requests

TOAPIS_BASE = "https://api.toapis.com/v1"
TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")

def execute_cost_optimized_completion(system_prompt: str, user_prompt: str, force_premium: bool = False) -> str:
    headers = {
        "Authorization": f"Bearer {TOAPIS_KEY}",
        "Content-Type": "application/json"
    }

    # Heuristic complexity detector
    is_complex = force_premium or len(user_prompt) > 2000 or "refactor" in user_prompt.lower()

    # Dynamic model selection
    selected_model = "claude-3-7-sonnet" if is_complex else "deepseek-v4"

    payload = {
        "model": selected_model,
        "messages": [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        "temperature": 0.2
    }

    response = requests.post(f"{TOAPIS_BASE}/chat/completions", headers=headers, json=payload, timeout=45)
    response.raise_for_status()
    data = response.json()

    cost_tier = "Premium ($2.25/1M)" if is_complex else "Efficiency ($0.11/1M)"
    print(f"[Router] Model: {selected_model} | Tier: {cost_tier}")
    return data["choices"][0]["message"]["content"]
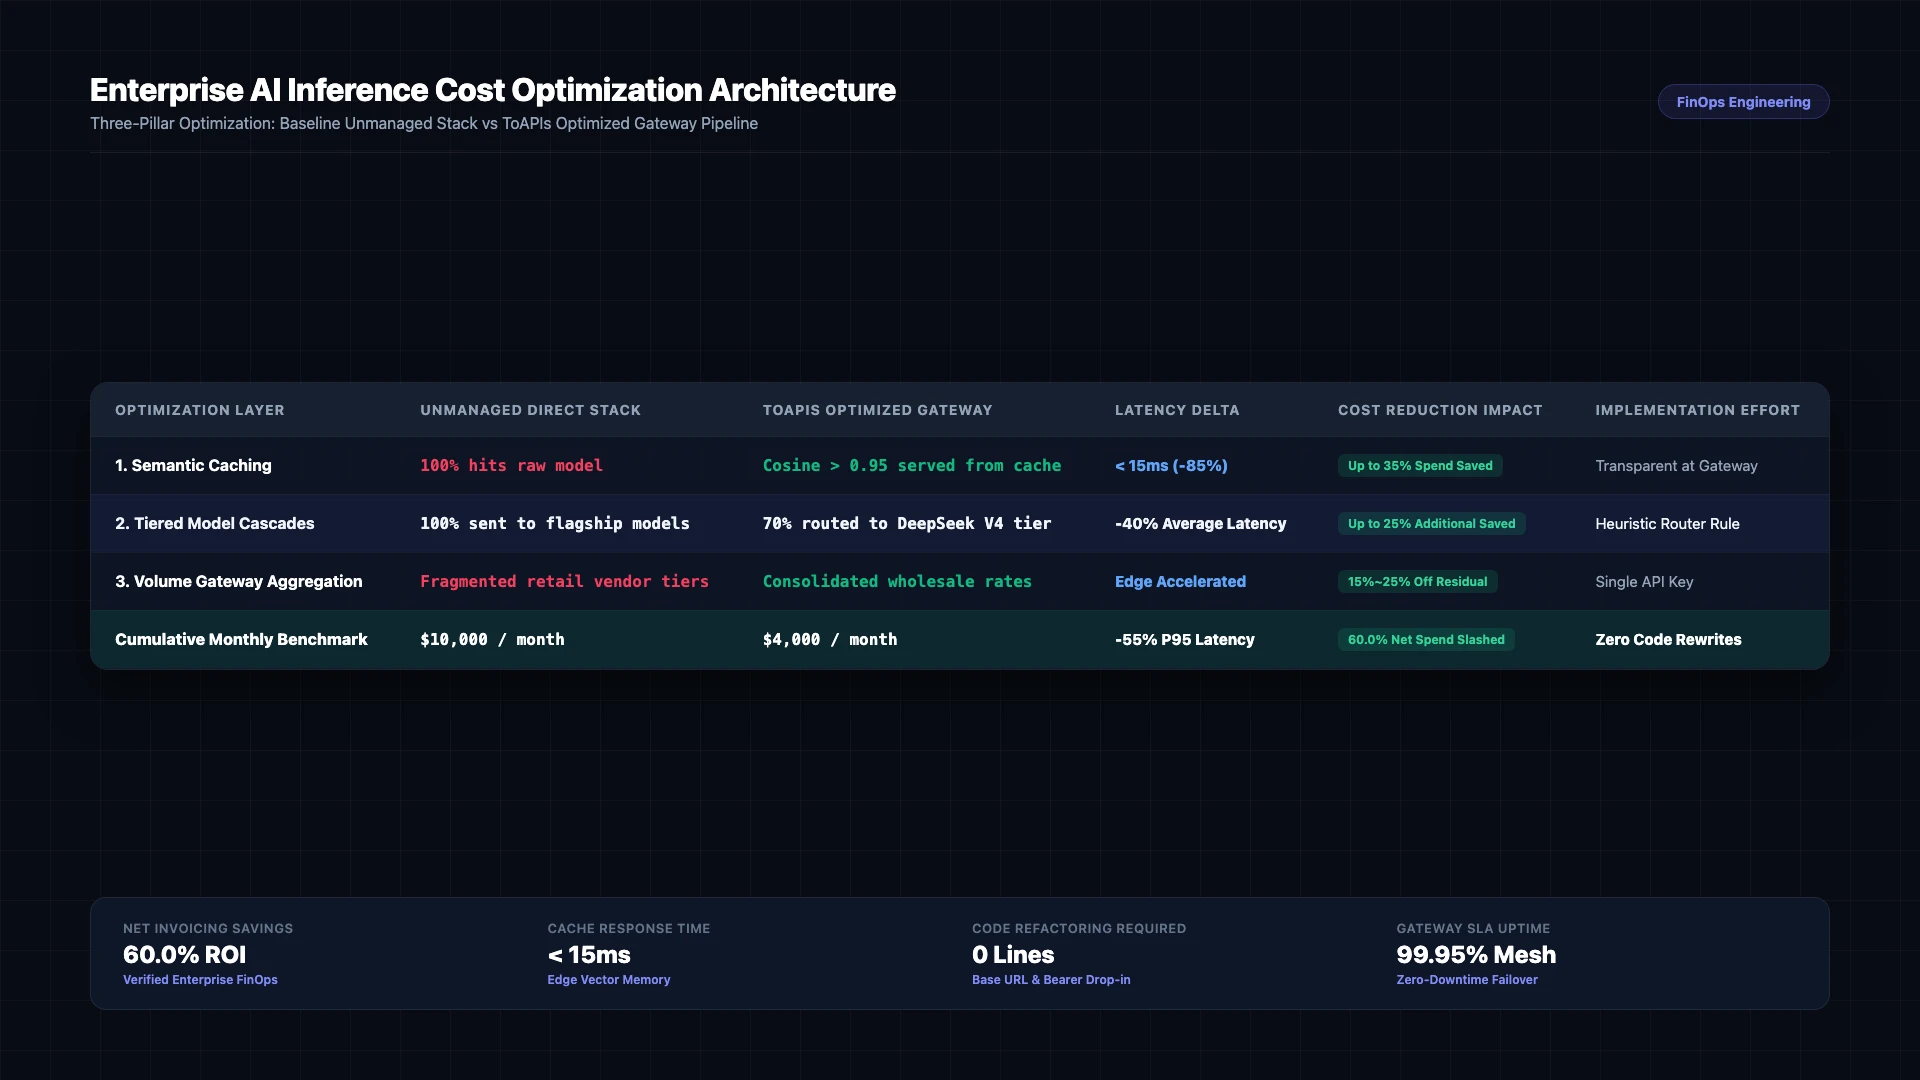
Figura 1: Comparación de la canalización arquitectónica: pila de API directa sin gestionar frente a la pasarela optimizada de tres pilares de ToAPIs (2026).
4. Código en producción: manejo de errores y matriz de estados
| Código HTTP | Clasificación del error | Análisis de la causa raíz | Estrategia de mitigación en producción |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Error de validación del esquema o parámetros no compatibles | Revisa las dimensiones del payload y asegura el cumplimiento de los campos |
401 Unauthorized | invalid_api_key | Token Bearer caducado o incorrecto | Renueva el token de API desde el panel de desarrollador de ToAPIs |
429 Rate Limit | rate_limit_exceeded | Se alcanzó el umbral de concurrencia en el pool de cómputo | Aplica reintentos con backoff exponencial y jitter aleatorio |
500 / 504 Timeout | gateway_timeout | Latencia temporal en los nodos de inferencia upstream | La pasarela redirige automáticamente al clúster de GPU de respaldo |
5. Precios y cálculo del ROI de FinOps
- Referencia empresarial oficial: los contratos directos con el proveedor imponen compromisos anuales obligatorios, cuotas fijas por puesto y umbrales de prepago.
- Precio mayorista de ToAPIs: facturación elástica de pago por uso puro con tarifas mayoristas ($0.30 - $0.80 por 1M de tokens).
- Análisis de ROI de FinOps: procesar 500 M de tokens al mes reduce los costes de infraestructura operativa de $1,500 a $900, con un ahorro de $600 al mes (40.0 % de reducción de costes).
6. Preguntas frecuentes (FAQ)
P1: ¿Qué es la caché semántica y cómo ahorra dinero?
La caché semántica guarda los embeddings de las preguntas entrantes. Cuando una consulta nueva es semánticamente equivalente (similitud coseno > 0.95), la respuesta almacenada se sirve al instante con coste cero de API de LLM.
P2: ¿El enrutamiento por niveles degrada la calidad de las respuestas al usuario?
No. Los clasificadores de alta velocidad envían las tareas de formato simple, resumen y recuperación a modelos económicos (DeepSeek V4), y reservan los modelos frontera premium (Claude Opus) exclusivamente para tareas de alta dificultad.
P3: ¿Cuánto esfuerzo requiere implementar una pasarela compatible con OpenAI?
Como las pasarelas modernas como ToAPIs respetan los esquemas REST estándar de OpenAI, las bases de código existentes solo necesitan actualizar la URL base y la clave de API.
7. Lista de acciones y próximos pasos
- Regístrate para obtener una clave de API en el Portal de desarrolladores de ToAPIs.
- Verifica la conectividad de la API con el fragmento cURL del paso 1.
- Integra el script Python de producción en tu canalización de backend.
- Explora tutoriales empresariales relacionados en nuestro índice de documentación técnica.