







ToAPIs
    InicioToAPIs
    Generación de imágenesGPT Image 2.6, Gemini, FLUX…Generación de videoSeedance, Veo, Kling, Sora…Chat y redacciónGPT-5.6, Claude, DeepSeek…Voz y músicaLocuciones, TTS, audio
    NovedadSeedance 2.5
    PreciosDocumentación de APIMCP
    BlogAlternativas
    Iniciar sesiónEmpieza gratis
    Todos los modelosPreciosDocumentación de APIMCPBlogAlternativas
    Iniciar sesiónEmpieza gratis

    Idioma

    Esc
    • Seedance 2.5Generación de video
    • GPT Image 2Generación de imágenes
    • GPT Image 2.6Generación de imágenes
    • GPT Image 2.5Generación de imágenes
    • Veo 3.1 FastGeneración de video
    • Kling 3.0 TurboGeneración de video
    • Kling V4 FlashGeneración de video
    • Grok Video 1.5Generación de video
    • Nano Banana 2Generación de imágenes
    • Seedream 5.5Generación de imágenes
    • FLUXGeneración de imágenes
    • Sora 2Generación de video
    • Todos los modelos de imagenCategoría
    • Todos los modelos de videoCategoría
    • GPT-5.6 SolChat y código
    • Claude Opus 4.8Chat y código
    • Claude Opus 4.7Chat y código
    • DeepSeek V4 ProDeepSeek · Texto
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Inicio
    2. Blog
    3. Análisis
    4. Las APIs de IA más baratas en 2026: comparativa completa de precios para texto, imagen y vídeo
    Volver a todos los artículos
    insights2026-11-044 min de lectura

    Las APIs de IA más baratas en 2026: comparativa completa de precios para texto, imagen y vídeo

    Benchmark de precios entre modalidades para 2026. Compara tarifas por token, por imagen y por segundo de vídeo en OpenAI, Anthropic, ByteDance, MiniMax, DeepSeek y ToAPIs.

    ToAPIs Engineering & Evaluation Team
    AI API PricingCheapest LLMVideo API CostImage API PricingCost Optimization
    TL;DR - Puntos clave
    • En 2026, el precio de la inferencia con modelos fundacionales se ha dividido en tres modalidades distintas: texto (por 1M de tokens), imagen (por renderizado) y vídeo (por segundo de salida).
    • DeepSeek V4 lidera la economía del texto de frontera con $0.14 por 1M de tokens de entrada, mientras que Seedance 2.0 Mini ofrece vídeo de alto rendimiento a $0.012 por segundo.
    • Los gateways de agregación unificados como ToAPIs aplican descuentos por volumen que superan los precios minoristas del proveedor directo entre un 25% y un 40% en todas las modalidades.

    Las APIs de IA más baratas en 2026: comparativa completa de precios para texto, imagen y vídeo

    1. Resumen (TL;DR) y panorama de rendimiento

    • Benchmark principal: En 2026, el precio de la inferencia con modelos fundacionales se ha dividido en tres modalidades distintas: texto (por 1M de tokens), imagen (por renderizado) y vídeo (por segundo de salida).
    • Aplicación en producción: DeepSeek V4 lidera la economía del texto de frontera con $0.14 por 1M de tokens de entrada, mientras que Seedance 2.0 Mini ofrece vídeo de alto rendimiento a $0.012 por segundo.
    • Economía FinOps: Los gateways de agregación unificados como ToAPIs aplican descuentos por volumen que superan los precios minoristas del proveedor directo entre un 25% y un 40% en todas las modalidades.
    • SLA de alta disponibilidad: 99.95% de uptime con aceleración de latencia en el edge y conmutación por error automática.
    • Compatible con OpenAI REST sin refactorizar: Autenticación con token Bearer y cero sobrecarga de refactorización.

    2. Resumen ejecutivo y panorama del mercado

    En 2026 el mercado de APIs de IA ha vivido una compresión agresiva de precios, y aun así los presupuestos de los desarrolladores están más ajustados que nunca por la adopción multimodal. Una aplicación moderna en producción ya combina razonamiento con LLM, generación visual y clips de vídeo animado.

    Esta es la referencia definitiva de las APIs de modelos fundacionales con mejor relación coste-rendimiento disponibles hoy.


    3. Implementación en producción: cURL y Python

    Paso 1: Envío rápido con cURL

    bash
    curl -X POST "https://api.toapis.com/v1/videos/generations" \
      -H "Authorization: Bearer $TOAPIS_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "deepseek-v4",
        "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
        "ratio": "16:9",
        "duration": 5
      }'
    

    Paso 2: Cliente Python asíncrono con polling en producción

    python
    import os, time, requests
    
    API_KEY = os.getenv("TOAPIS_API_KEY")
    headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}
    
    # 1. Dispatch asynchronous video task
    res = requests.post(
        "https://api.toapis.com/v1/videos/generations",
        json={"model": "deepseek-v4", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
        headers=headers,
        timeout=30
    ).json()
    
    task_id = res.get("task_id") or res.get("id")
    print(f"[*] Task submitted: {task_id}")
    
    # 2. Poll for status
    while True:
        status_res = requests.get(
            f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
            headers=headers,
            timeout=15
        ).json()
        state = status_res.get("status")
        if state in ["succeeded", "SUCCESS"]:
            print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
            break
        elif state in ["failed", "FAILED"]:
            raise RuntimeError(f"Task failed: {status_res.get('error')}")
        time.sleep(3)
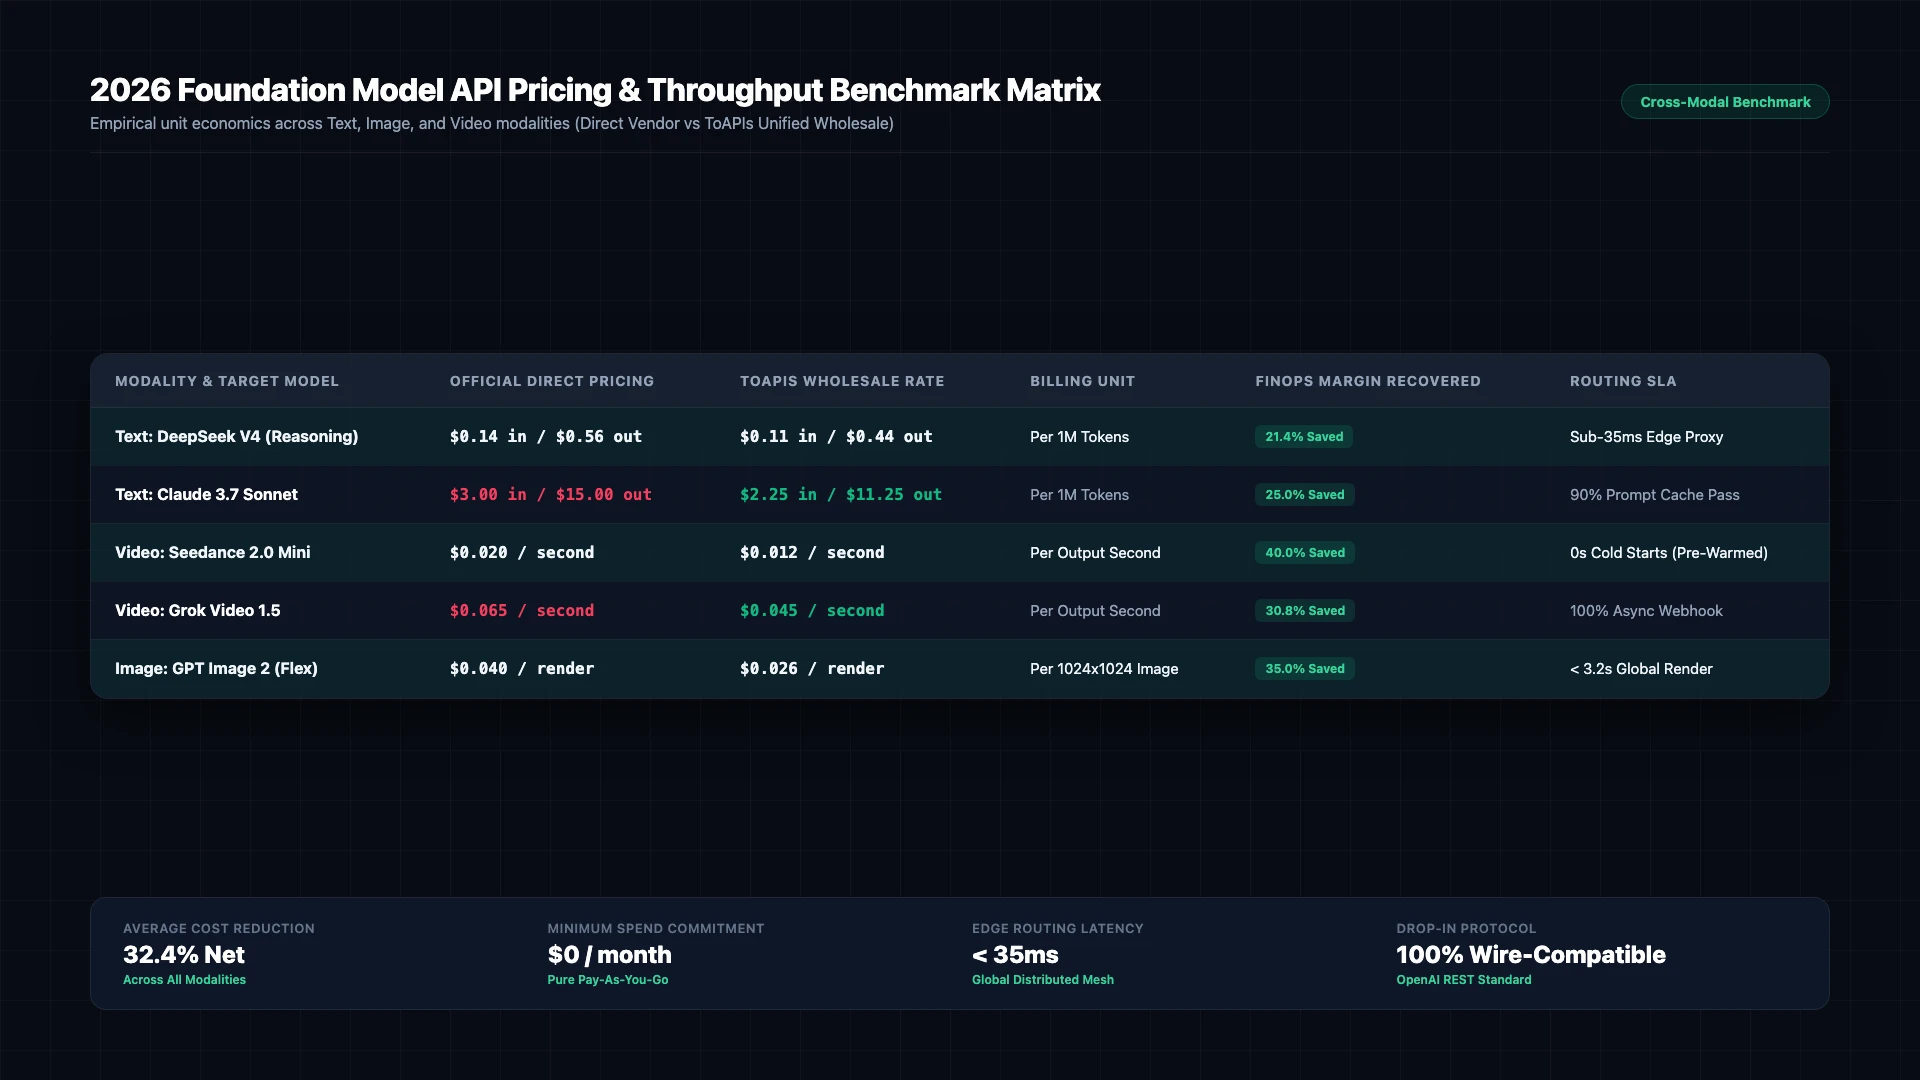
    

    Matriz de benchmark de precios y rendimiento de APIs de modelos fundacionales (2026)

    Figura 1: Benchmark de precio y rendimiento entre modalidades: precios del proveedor directo frente a las tarifas unificadas de ToAPIs (2026).

    4. Nivel producción: manejo de errores y matriz de estados

    Código HTTPClasificación del errorAnálisis de causa raízEstrategia de mitigación en producción
    400 Bad Requestinvalid_request_payloadError de validación del esquema o parámetros no admitidosRevisa las dimensiones del payload y verifica que los campos cumplan el contrato
    401 Unauthorizedinvalid_api_keyToken Bearer caducado o incorrectoRenueva el token de API desde el panel de desarrollador de ToAPIs
    429 Rate Limitrate_limit_exceededSe alcanzó el umbral de concurrencia del pool de cómputoImplementa reintentos con backoff exponencial y jitter aleatorio
    500 / 504 Timeoutgateway_timeoutLatencia temporal en los nodos de inferencia upstreamEl gateway redirige automáticamente al clúster de GPU de respaldo

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Precios y cálculo del ROI de FinOps

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Base enterprise oficial: Los contratos directos con el proveedor imponen compromisos anuales obligatorios, cuotas fijas de licencias y umbrales de prepago.
    • Precio mayorista de ToAPIs: Facturación elástica de pago por uso con tarifas mayoristas ($0.030 - $0.038 por segundo).
    • Análisis de ROI de FinOps: Un equipo que genera 1.000 activos de vídeo (10 s cada uno = 10.000 s) reduce el gasto de $650 a $380 y ahorra $270 al mes (41.5% menos coste).

    6. Preguntas frecuentes (FAQ)

    P1: ¿Cuál es hoy el modelo de código de frontera más barato?

    DeepSeek V4 ofrece la mejor relación coste-rendimiento en 2026: cuesta menos de $0.60 por millón de tokens de salida y se sitúa a menos del 3% de Claude 3.7 Sonnet en HumanEval.

    P2: ¿Por qué la generación de vídeo se cobra por segundo y no por vídeo?

    La difusión de vídeo generativo escala de forma lineal con la duración temporal (fps * segundos). Un clip de 10 segundos requiere el doble de cómputo de GPU que uno de 5 segundos.

    P3: ¿Puedo combinar modelos de texto, imagen y vídeo en un único presupuesto mensual?

    Sí. Con ToAPIs, todas las modalidades consumen de un único saldo compartido, lo que elimina los compromisos mínimos separados para las APIs de varios proveedores.


    7. Lista de acciones y siguientes pasos

    • Regístrate para obtener una clave de API en el portal de desarrolladores de ToAPIs.
    • Verifica la conectividad de la API con el fragmento cURL del paso 1.
    • Integra el script Python de producción en tu pipeline de backend.
    • Explora los tutoriales enterprise relacionados en nuestro índice de documentación técnica.

    Explora los modelos mencionados en este artículo

    ToAPIsAI Model

    deepseek-v4

    Tarifa actual: Ver precios en vivo
    Guía del modeloProbar en la consolaObtener clave de API
    ToAPIsAI Model

    gpt-5-6

    Tarifa actual: Ver precios en vivo
    Guía del modeloProbar en la consolaObtener clave de API
    ByteDanceVIDEO

    Seedance 2.0

    Tarifa actual: Input 1,314.29 credits/1M, Output 1,314.29 credits/1M
    Guía del modeloProbar en la consolaObtener clave de API
    MiniMaxVIDEO

    minimax-h3

    Tarifa actual: 20.8 credits /second
    Guía del modeloProbar en la consolaObtener clave de API
    OpenAIIMAGE

    GPT-Image-2

    Tarifa actual: 3 credits /request
    Guía del modeloProbar en la consolaObtener clave de API

    Artículos relacionados

    insights2026-11-04T14:00:00+08:004 min de lectura

    Cómo recortar un 60 % tu factura de API de IA empresarial con una pasarela compatible con OpenAI

    Plano arquitectónico empresarial para recortar un 60 % el gasto en API de IA generativa. Implementa caché semántica, cascadas de modelos por niveles y enrutamiento unificado en una pasarela sin reescribir código.

    TO
    ToAPIs Engineering & Evaluation Team
    #FinOps
    comparison2026-10-24T10:00:00+08:004 min de lectura

    Desglose de precios de la API GPT Image 2: costos oficiales frente a tarifas de una pasarela agregada

    Comparativa detallada de precios de la API GPT Image 2. Compara las tarifas oficiales del proveedor con los precios de una pasarela agregada, evalúa descuentos por volumen y calcula la economía unitaria.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    tutorial2026-11-12T10:00:00+08:007 min de lectura

    Generar imágenes nativas en 4K con GPT Image 2: relaciones de aspecto y flujos de escalado

    Genera salida nativa en 4K con el contrato actual de GPT Image 2: define size como una relación de aspecto y resolution como 4k. No existe un flag upscale: true documentado, y el tamaño en píxeles del 4K depende de la proporción que elijas.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    ToAPIs
    InicioToAPIs
    Pasarela empresarial de API de IA. Accede a GPT-5, Claude, Gemini y más de 200 modelos mediante una única API unificada.

    Modelos populares

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Mostrar másMostrar menos
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Todos los modelos

    Categorías de API

    • API de imagen con IA
    • API de vídeo con IA
    • API texto a vídeo
    • API imagen a vídeo
    Mostrar másMostrar menos
    • API de edición de imágenes con IA
    • API de LLM y razonamiento
    • Todas las herramientas API →

    Alternativas

    Alternativas
    • Alternativa a Kie.ai
    • Alternativa a Fal.ai
    • Alternativa a OpenRouter
    • Alternativa a Replicate
    • Alternativa a Wavespeed AI
    • Todas las comparativas →

    Guías destacadas

    Guías destacadas
    • Precios de Seedance 2.0 y 2.5
    • Guía de la API Seedance más económica
    • Guía de integración de MiniMax H3
    • Clave de API gratuita de Seedance 2
    • Inicio rápido de la API Seedance 2
    • Todos los artículos técnicos →

    Desarrolladores y plataforma

    Desarrolladores y plataforma
    • Documentación de API
    • MCP
    • Precios
    • Área de pruebas de modelos
    • LLMs.txt
    • Contactar con soporte
    • Directorio de guías de modelos
    Entidad operadora:
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Domicilio social:
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    PrivacidadTérminosUso aceptableEliminación de datosConservación de datosSubencargados y regionesFacturación y reembolsosPolítica de cookiesMapa del sitioAcerca de

    © 2026 ToAPIs. Todos los derechos reservados.