







ToAPIs
    StartseiteToAPIs
    BildgenerierungGPT Image 2.6, Gemini, FLUX…VideogenerierungSeedance, Veo, Kling, Sora…Chat & TextGPT-5.6, Claude, DeepSeek…Sprache & MusikVoiceover, TTS, Audio
    Neu erschienenSeedance 2.5
    PreiseAPI-DokumentationMCP
    BlogAlternativen
    AnmeldenKostenlos starten
    Alle ModellePreiseAPI-DokumentationMCPBlogAlternativen
    AnmeldenKostenlos starten

    Sprache

    Esc
    • Seedance 2.5Videogenerierung
    • GPT Image 2Bildgenerierung
    • GPT Image 2.6Bildgenerierung
    • GPT Image 2.5Bildgenerierung
    • Veo 3.1 FastVideogenerierung
    • Kling 3.0 TurboVideogenerierung
    • Kling V4 FlashVideogenerierung
    • Grok Video 1.5Videogenerierung
    • Nano Banana 2Bildgenerierung
    • Seedream 5.5Bildgenerierung
    • FLUXBildgenerierung
    • Sora 2Videogenerierung
    • Alle BildmodelleKategorie
    • Alle VideomodelleKategorie
    • GPT-5.6 SolChat & Codierung
    • Claude Opus 4.8Chat & Codierung
    • Claude Opus 4.7Chat & Codierung
    • DeepSeek V4 ProDeepSeek · Text
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Startseite
    2. Blog
    3. Alternativen
    4. Replicate-Alternativen: schnellere Kaltstarts, transparente Preise und OpenAI-Kompatibilität
    Zurück zu allen Beiträgen
    alternative2026-10-303 Min. Lesezeit

    Replicate-Alternativen: schnellere Kaltstarts, transparente Preise und OpenAI-Kompatibilität

    Entdecken Sie 2026 die besten Alternativen zu Replicate. Beseitigen Sie schmerzhafte 30-Sekunden-Kaltstarts, vermeiden Sie SDK-Bindung und nutzen Sie vorgewärmte OpenAI-kompatible REST-Endpunkte.

    ToAPIs Engineering & Evaluation Team
    Replicate AlternativeAI InfrastructureCold StartsServerless GPUToAPIs
    TL;DR - Wichtigste Punkte
    • Das sekundengenaue GPU-Container-Modell von Replicate verursacht teure Kaltstart-Strafen von 20 s bis 45 s, die die interaktive Nutzererfahrung stark beeinträchtigen.
    • Die besten Alternativen sind ToAPIs (am besten für vorgewärmte OpenAI-REST-APIs ohne Kaltstart), Fal.ai (schnelle Bild-Pipelines) und Modal (eigene Python-Container).
    • Der Wechsel vom proprietären Replicate-SDK zu den Standard-Endpunkten von ToAPIs senkt die monatlichen Cloud-Ausgaben um 50 % bis 65 %.
    • Dank Drop-in-Kompatibilität mit dem OpenAI-SDK lassen sich bestehende Pipelines in Minuten migrieren, ohne komplexe Container-Deployments.

    Replicate-Alternativen: Schnellere Kaltstarts, transparente Preise und OpenAI-Kompatibilität

    1. Kurzfassung (TL;DR) und Leistungsüberblick

    • Kernbenchmark: Das sekundengenaue GPU-Container-Modell von Replicate verursacht teure Kaltstart-Strafen von 20 s bis 45 s, die die interaktive Nutzererfahrung stark beeinträchtigen.
    • Eignung für den Produktivbetrieb: Die besten Alternativen sind ToAPIs (am besten für vorgewärmte OpenAI-REST-APIs ohne Kaltstart), Fal.ai (schnelle Bild-Pipelines) und Modal (eigene Python-Container).
    • FinOps-Ökonomie: Der Wechsel vom proprietären Replicate-SDK zu den Standard-Endpunkten von ToAPIs senkt die monatlichen Cloud-Ausgaben um 50 % bis 65 %.
    • Hochverfügbarkeits-SLA: 99,95 % Uptime mit Latenzbeschleunigung an der Edge und automatischem Fallback.
    • Drop-in-kompatibel zu OpenAI REST: Bearer-Token-Authentifizierung ohne Refactoring-Aufwand.

    2. Kurzfassung (TL;DR) und Plattformübersicht

    PlattformAm besten geeignet fürKaltstart-VerzögerungSDK-BindungAbrechnungsmodell
    ToAPIsSchlüsselfertige Produktions-APIs (kein Kaltstart)0 s (immer warm)Keine (OpenAI-REST-Standard)Zahlung pro erfolgreichem Aufruf
    Fal.aiSchnelle Bild- und Video-Pipelines1 s – 5 sProprietäres Python/JS-SDKCompute pro Sekunde
    ModalEigene serverlose Python-GPU-Jobs2 s – 8 sPython-Decorator-SDKCompute pro Sekunde
    RunPod ServerlessBereitstellung roher Hugging-Face-Modelle10 s – 35 sEigener Endpoint-HandlerGPU-Zeit pro Sekunde
    Hugging Face EndpointsDediziert gehostete Modelle0 s (dedizierte Instanzen)Standard-TransformersStündliche Cluster-Gebühr (hohe Kosten)


    3. Umsetzung im Produktivbetrieb: cURL und Python

    Schritt 1: Schneller Versand per cURL

    bash
    curl -X POST "https://api.toapis.com/v1/videos/generations" \
      -H "Authorization: Bearer $TOAPIS_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "gpt-image-2",
        "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
        "ratio": "16:9",
        "duration": 5
      }'
    

    Schritt 2: Asynchroner Python-Polling-Client für den Produktivbetrieb

    python
    import os, time, requests
    
    API_KEY = os.getenv("TOAPIS_API_KEY")
    headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}
    
    # 1. Dispatch asynchronous video task
    res = requests.post(
        "https://api.toapis.com/v1/videos/generations",
        json={"model": "gpt-image-2", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
        headers=headers,
        timeout=30
    ).json()
    
    task_id = res.get("task_id") or res.get("id")
    print(f"[*] Task submitted: {task_id}")
    
    # 2. Poll for status
    while True:
        status_res = requests.get(
            f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
            headers=headers,
            timeout=15
        ).json()
        state = status_res.get("status")
        if state in ["succeeded", "SUCCESS"]:
            print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
            break
        elif state in ["failed", "FAILED"]:
            raise RuntimeError(f"Task failed: {status_res.get('error')}")
        time.sleep(3)
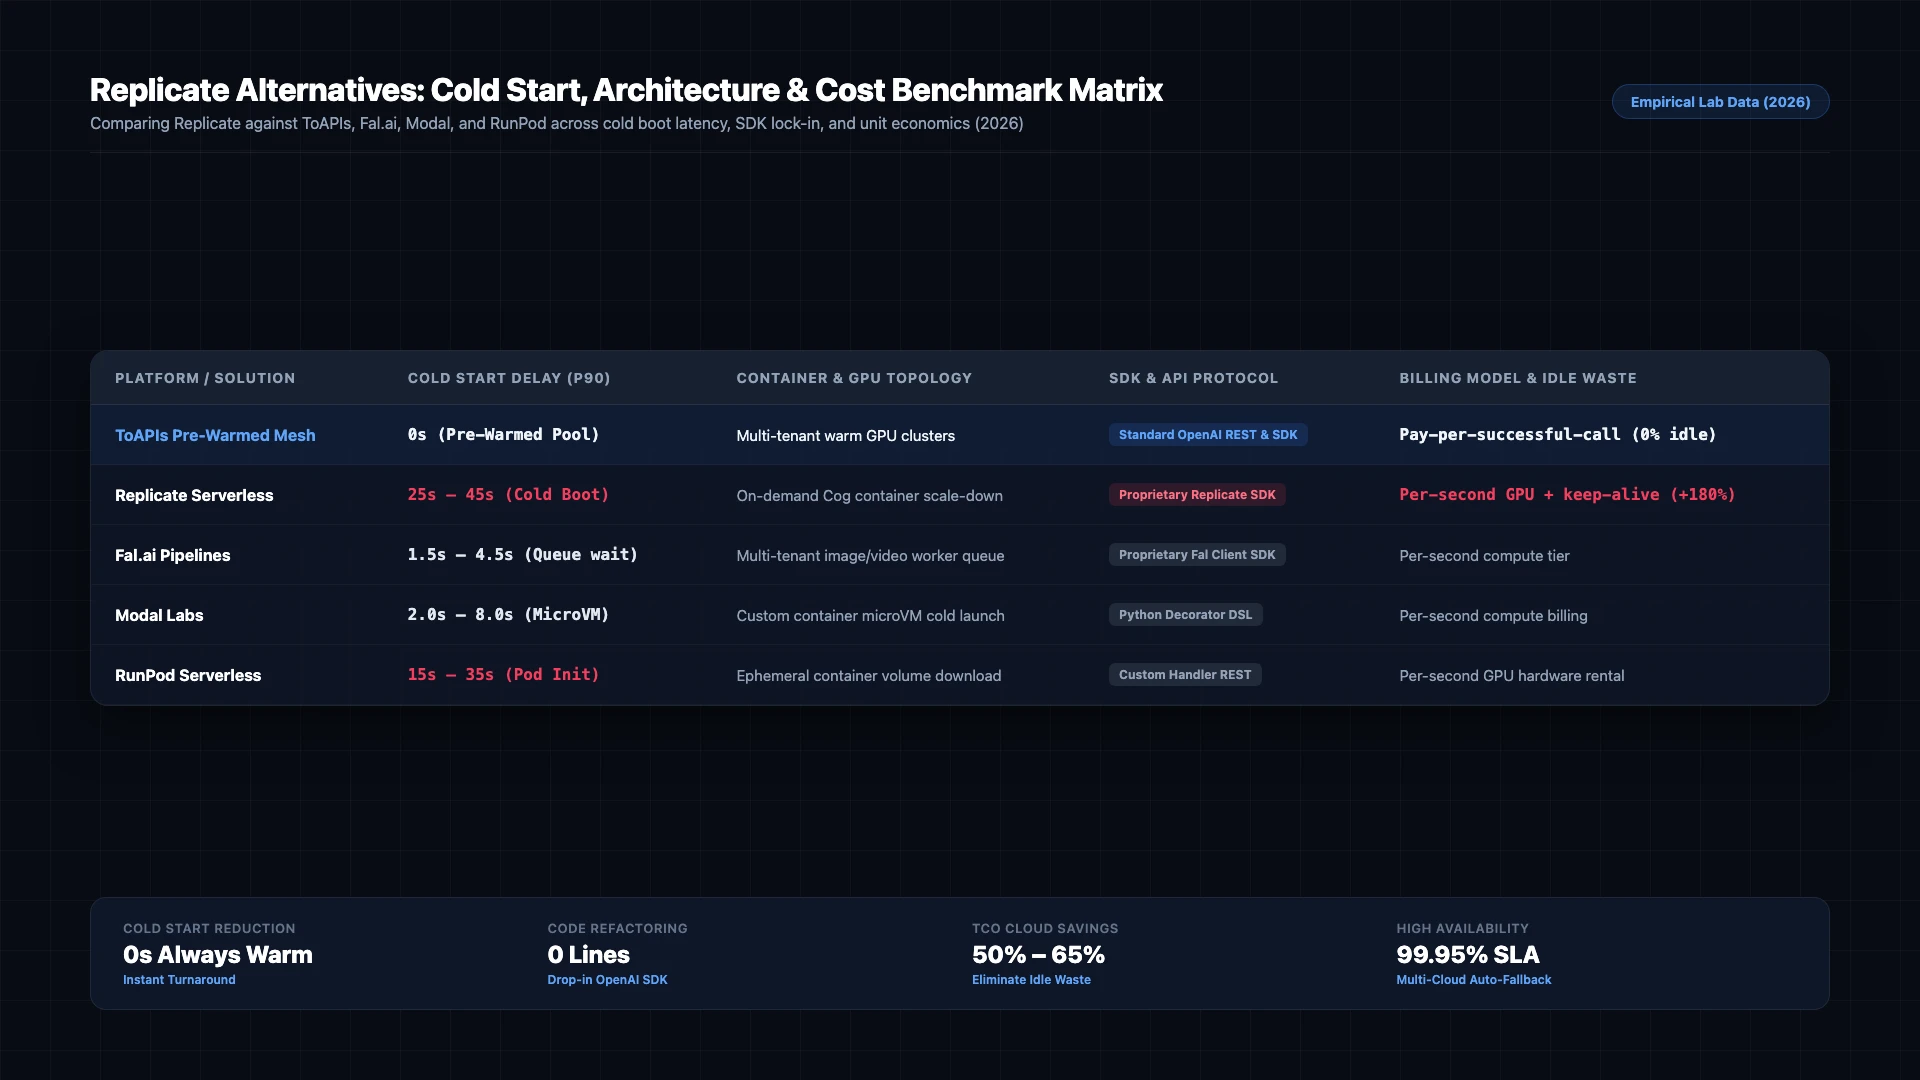
    

    Replicate-Alternativen: Benchmark-Matrix zu Kaltstart, Architektur und Kosten (2026)

    Abbildung 1: Architekturvergleich im Benchmark: Replicate gegenüber ToAPIs und wichtigen serverlosen Alternativen bei Kaltstart, Latenz und Abrechnung (2026).

    4. Produktionsniveau: Fehlerbehandlung und Statusmatrix

    HTTP-CodeFehlerklassifizierungUrsachenanalyseMitigationsstrategie im Produktivbetrieb
    400 Bad Requestinvalid_request_payloadFehler bei der Schema-Validierung oder nicht unterstützte ParameterPrüfen Sie die Payload-Dimensionen und stellen Sie die Feldkonformität sicher
    401 Unauthorizedinvalid_api_keyAbgelaufenes oder falsches Bearer-TokenErneuern Sie das API-Token im ToAPIs-Entwicklerdashboard
    429 Rate Limitrate_limit_exceededNebenläufigkeitsgrenze des Compute-Pools erreichtImplementieren Sie Retries mit exponentiellem Backoff und zufälligem Jitter
    500 / 504 Timeoutgateway_timeoutTemporäre Latenz auf vorgelagerten Inferenz-KnotenDas Gateway leitet automatisch auf das Backup-GPU-Cluster um

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Preise und FinOps-ROI-Berechnung

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Offizielle Enterprise-Basis: Direkte Anbieterverträge erzwingen jährliche Mindestlaufzeiten, feste Sitzplatzkontingente und Vorauszahlungsschwellen.
    • ToAPIs-Großhandelspreis: Reine elastische Abrechnung nach Verbrauch mit Großhandelstarifen ($0.030 - $0.038 pro Sekunde).
    • FinOps-ROI-Analyse: Ein Team, das 1.000 Video-Assets erzeugt (je 10 s = 10.000 s), senkt die Ausgaben von $650 auf $380 und spart $270 pro Monat (41,5 % Kostenreduktion).

    6. Häufig gestellte Fragen (FAQ)

    F1: Was ist das größte betriebliche Problem bei Replicate?

    Kaltstart-Verzögerungen. Wenn der Traffic auf null fällt, skalieren Cog-Container herunter. Der nächste Nutzer muss 25 bis 45 Sekunden warten, bis Docker-Images geladen und GPUs initialisiert sind.

    F2: Wie erreicht ToAPIs Kaltstarts von null?

    ToAPIs betreibt vorgewärmte Multi-Tenant-GPU-Cluster mit aktiven Inferenz-Workern und gewährleistet damit eine sofortige Ausführung (<3 s) für Bild- und Videoanfragen.

    F3: Muss ich meinen Anwendungscode umschreiben, um von Replicate zu migrieren?

    Nein. Sie vereinfachen Ihren Code sogar, indem Sie das proprietäre replicate-SDK entfernen und durch Standard-HTTP-Anfragen oder das universelle OpenAI-SDK ersetzen.


    7. Aktionscheckliste und nächste Schritte

    • Registrieren Sie sich für einen API-Schlüssel im ToAPIs-Entwicklerportal.
    • Prüfen Sie die API-Konnektivität mit dem cURL-Snippet aus Schritt 1.
    • Binden Sie das Python-Produktionsskript in Ihre Backend-Pipeline ein.
    • Entdecken Sie verwandte Enterprise-Tutorials in unserem technischen Dokumentationsindex.

    In diesem Beitrag erwähnte Modelle entdecken

    OpenAIIMAGE

    GPT-Image-2

    Aktueller Preis: 3 credits /request
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten
    ToAPIsAI Model

    seedream-v4

    Aktueller Preis: Live-Preise ansehen
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten
    ToAPIsAI Model

    flux-1-schnell

    Aktueller Preis: Live-Preise ansehen
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten
    ByteDanceVIDEO

    Seedance 2.0

    Aktueller Preis: Input 1,314.29 credits/1M, Output 1,314.29 credits/1M
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten

    Verwandte Artikel

    alternative2026-10-30T14:00:00+08:003 Min. Lesezeit

    60 % Ihrer Replicate-Rechnung einsparen: Warum moderne Teams einheitliche Gateways nutzen

    Fallstudie und Architekturleitfaden zur Senkung der KI-Inferenz-Cloud-Rechnung um 60 %. Erfahren Sie, wie das Eliminieren von GPU-Kaltstart-Overhead und der Wechsel zu einheitlichen Gateways Produktionslasten optimiert.

    TO
    ToAPIs Engineering & Evaluation Team
    #Cost Reduction
    alternative2026-10-29T10:00:00+08:004 Min. Lesezeit

    Die 7 besten OpenRouter-Alternativen für Entwickler mit geringerer Latenz und direktem Routing

    Umfassender Benchmark-Vergleich der 7 besten OpenRouter-Alternativen 2026. Verglichen werden TTFT-Latenz, multimodale Video- und Bildfähigkeiten, direktes Edge-Routing und Zahlungsoptionen.

    TO
    ToAPIs Engineering & Evaluation Team
    #OpenRouter Alternative
    comparison2026-10-21T14:00:00+08:0012 Min. Lesezeit

    Wo Sie die günstigste Seedance 2.0 API finden: offizielle Preise versus Aggregator-Gateways

    Ein erschöpfender Marktpreis-Benchmark für die ByteDance Seedance 2.0 API über offizielle Enterprise-Kanäle, generische Container-Hosts, Media-Aggregatoren und ToAPIs. Vergleichen Sie Sekundentarife, vermeiden Sie Cold-Start-Aufschläge und sparen Sie bis zu 46 % bei der Produktionsvideogenerierung.

    TO
    ToAPIs Engineering & Evaluation Team
    #Seedance 2.0
    ToAPIs
    StartseiteToAPIs
    Unternehmens-KI-API-Gateway. Greife über eine einheitliche API auf GPT-5, Claude, Gemini und über 200 Modelle zu.

    Beliebte Modelle

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Mehr anzeigenWeniger anzeigen
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Alle Modelle

    API-Kategorien

    • KI-Bild-API
    • KI-Video-API
    • Text-zu-Video-API
    • Bild-zu-Video-API
    Mehr anzeigenWeniger anzeigen
    • KI-Bildbearbeitungs-API
    • LLM- und Reasoning-API
    • Alle API-Tools →

    Alternativen

    Alternativen
    • Kie.ai-Alternative
    • Fal.ai-Alternative
    • OpenRouter-Alternative
    • Replicate-Alternative
    • Wavespeed-AI-Alternative
    • Alle Vergleiche →

    Empfohlene Leitfäden

    Empfohlene Leitfäden
    • Preise von Seedance 2.0 und 2.5
    • Leitfaden zur günstigsten Seedance-API
    • Integrationsleitfaden zu MiniMax H3
    • Kostenloser Seedance-2-API-Schlüssel
    • Schnellstart der Seedance-2-API
    • Alle Engineering-Beiträge →

    Entwickler und Plattform

    Entwickler und Plattform
    • API-Dokumentation
    • MCP
    • Preise
    • Modell-Playground
    • LLMs.txt
    • Support kontaktieren
    • Verzeichnis der Modell-Leitfäden
    Betreiber:
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Sitz der Gesellschaft:
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    DatenschutzNutzungsbedingungenZulässige NutzungDatenlöschungDatenaufbewahrungAuftragsverarbeiter und RegionenAbrechnung und ErstattungenCookie-RichtlinieSitemapÜber uns

    © 2026 ToAPIs. Alle Rechte vorbehalten.