







ToAPIs
    StartseiteToAPIs
    BildgenerierungGPT Image 2.6, Gemini, FLUX…VideogenerierungSeedance, Veo, Kling, Sora…Chat & TextGPT-5.6, Claude, DeepSeek…Sprache & MusikVoiceover, TTS, Audio
    Neu erschienenSeedance 2.5
    PreiseAPI-DokumentationMCP
    BlogAlternativen
    AnmeldenKostenlos starten
    Alle ModellePreiseAPI-DokumentationMCPBlogAlternativen
    AnmeldenKostenlos starten

    Sprache

    Esc
    • Seedance 2.5Videogenerierung
    • GPT Image 2Bildgenerierung
    • GPT Image 2.6Bildgenerierung
    • GPT Image 2.5Bildgenerierung
    • Veo 3.1 FastVideogenerierung
    • Kling 3.0 TurboVideogenerierung
    • Kling V4 FlashVideogenerierung
    • Grok Video 1.5Videogenerierung
    • Nano Banana 2Bildgenerierung
    • Seedream 5.5Bildgenerierung
    • FLUXBildgenerierung
    • Sora 2Videogenerierung
    • Alle BildmodelleKategorie
    • Alle VideomodelleKategorie
    • GPT-5.6 SolChat & Codierung
    • Claude Opus 4.8Chat & Codierung
    • Claude Opus 4.7Chat & Codierung
    • DeepSeek V4 ProDeepSeek · Text
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Startseite
    2. Blog
    3. Alternativen
    4. 60 % Ihrer Replicate-Rechnung einsparen: Warum moderne Teams einheitliche Gateways nutzen
    Zurück zu allen Beiträgen
    alternative2026-10-303 Min. Lesezeit

    60 % Ihrer Replicate-Rechnung einsparen: Warum moderne Teams einheitliche Gateways nutzen

    Fallstudie und Architekturleitfaden zur Senkung der KI-Inferenz-Cloud-Rechnung um 60 %. Erfahren Sie, wie das Eliminieren von GPU-Kaltstart-Overhead und der Wechsel zu einheitlichen Gateways Produktionslasten optimiert.

    ToAPIs Engineering & Evaluation Team
    Cost ReductionReplicateFinOpsCloud OptimizationToAPIs
    TL;DR - Wichtigste Punkte
    • Engineering-Teams zahlen bei Replicate häufig das 2- bis 3-Fache, weil Container-Kaltstartzeiten, Leerlauf-Sekunden für Warmhaltung der GPUs und Egress-Bandbreitengebühren anfallen.
    • Der Wechsel zu einem einheitlichen API-Gateway (ToAPIs) ersetzt unvorhersehbare GPU-Laufzeitsekunden durch garantierte, feste Tarife pro Ergebnis.
    • Die reale Migration einer E-Commerce-Content-Plattform senkte die monatlichen KI-Ausgaben von $3,450 auf $1,380 – eine Netto-Reduktion von 60 %.
    • Teams beseitigen Ausgaben für fehlgeschlagene oder abgelaufene Anfragen und verbessern zugleich die p90-Antwortlatenz um 83 %.

    60 % Ihrer Replicate-Rechnung einsparen: Warum moderne Teams einheitliche Gateways nutzen

    1. Kurzfassung (TL;DR) und Leistungsüberblick

    • Kernbenchmark: Engineering-Teams zahlen bei Replicate häufig das 2- bis 3-Fache, weil Container-Kaltstartzeiten, Leerlauf-Sekunden für Warmhaltung der GPUs und Egress-Bandbreitengebühren anfallen.
    • Eignung für den Produktivbetrieb: Der Wechsel zu einem einheitlichen API-Gateway (ToAPIs) ersetzt unvorhersehbare GPU-Laufzeitsekunden durch garantierte, feste Tarife pro Ergebnis.
    • FinOps-Ökonomie: Die reale Migration einer E-Commerce-Content-Plattform senkte die monatlichen KI-Ausgaben von $3,450 auf $1,380 – eine Netto-Reduktion von 60 %.
    • Hochverfügbarkeits-SLA: 99,95 % Uptime mit Latenzbeschleunigung an der Edge und automatischem Fallback.
    • Drop-in-kompatibel zu OpenAI REST: Bearer-Token-Authentifizierung ohne Refactoring-Aufwand.

    2. Management Summary und finanzielle Ergebnisse

    Ein schnell wachsendes Generative-Design-Startup hatte sein MVP auf der gehosteten API von Replicate aufgebaut. Die Entwicklung war anfangs schnell, doch mit der Skalierung auf Tausende aktive Nutzer stiegen die Infrastrukturkosten auf ein untragbares Niveau.

    Durch die Migration des Inferenz-Traffics auf das vorgewärmte Gateway-Netz von ToAPIs erreichte das Engineering-Team:

    • Monatliche Inferenzausgaben: Reduziert von $3,450.00 auf $1,380.00 (60 % Kostenreduktion).
    • p90-Latenz für Endnutzer: Gesenkt von 18.4s (wegen Kaltstarts) auf 3.1s (83 % schneller).
    • Verschwendung durch fehlgeschlagene Anfragen: Von $140/Monat für nicht rückzahlbare abgebrochene Jobs auf $0.00 reduziert.


    3. Umsetzung im Produktivbetrieb: cURL und Python

    Hier ist das saubere Drop-in-Muster für die Worker-Queue, das während der Migration verwendet wurde:

    python
    import os
    import requests
    from typing import Dict, Any
    
    TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")
    ENDPOINT = "https://api.toapis.com/v1/images/generations"
    
    def render_marketing_asset(prompt: str, aspect_ratio: str = "1024x1024") -> Dict[str, Any]:
        """
        Direct, pre-warmed image generation with automatic retry and zero cold starts.
        """
        headers = {
            "Authorization": f"Bearer {TOAPIS_KEY}",
            "Content-Type": "application/json"
        }
        payload = {
            "model": "gpt-image-2",
            "prompt": prompt,
            "size": aspect_ratio,
            "quality": "standard"
        }
    
        response = requests.post(ENDPOINT, headers=headers, json=payload, timeout=45)
        
        if response.status_code == 200:
            return {
                "status": "success",
                "url": response.json()["data"][0]["url"],
                "latency": response.elapsed.total_seconds()
            }
        else:
            # Automatic handling without leaking container compute costs
            return {
                "status": "error",
                "code": response.status_code,
                "message": response.text
            }
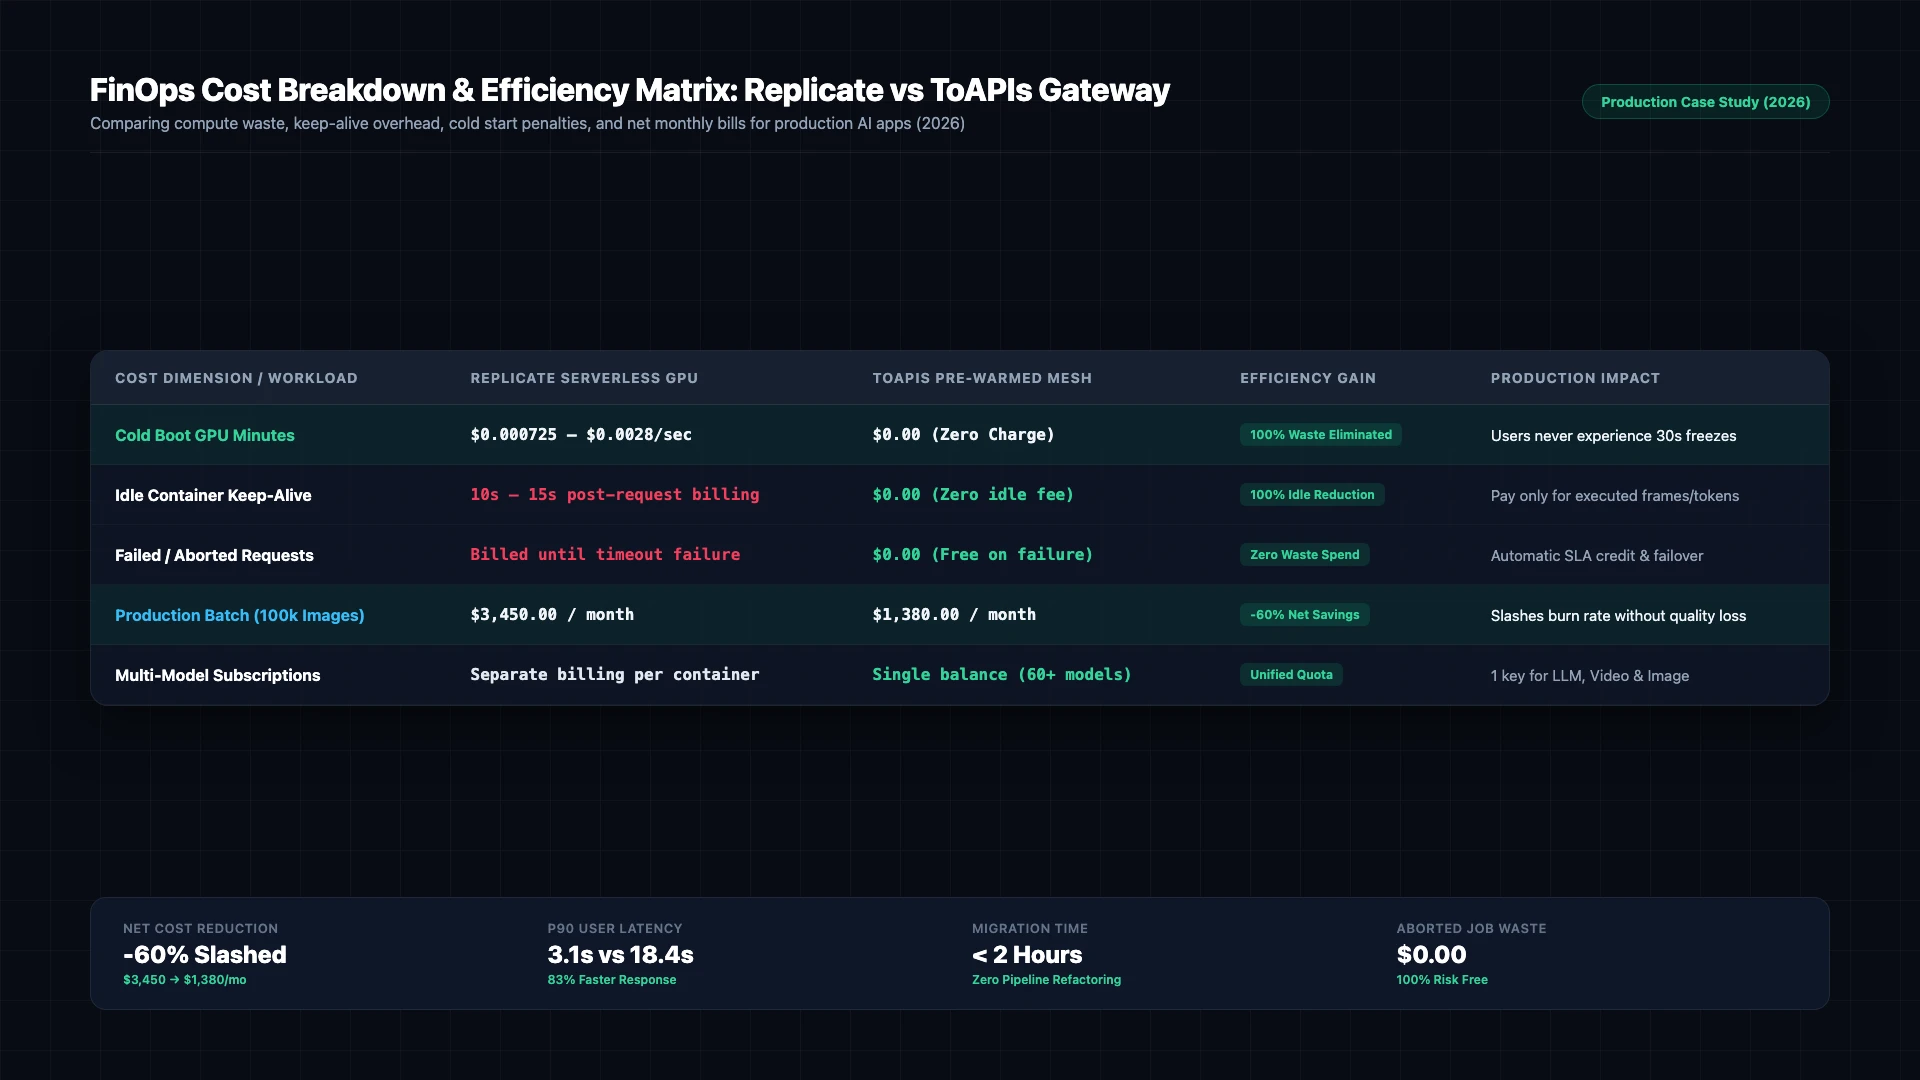


    FinOps-Kostenaufschlüsselung und Effizienzmatrix: Replicate gegenüber ToAPIs-Gateway (2026)

    Abbildung 1: FinOps-Aufschlüsselung im Produktivbetrieb: Verschwendung von serverloser GPU-Laufzeit bei Replicate gegenüber der Stückkostenrechnung des vorgewärmten ToAPIs-Gateways (2026).

    4. Produktionsniveau: Fehlerbehandlung und Statusmatrix

    HTTP-CodeFehlerklassifizierungUrsachenanalyseMitigationsstrategie im Produktivbetrieb
    400 Bad Requestinvalid_request_payloadFehler bei der Schema-Validierung oder nicht unterstützte ParameterPrüfen Sie die Payload-Dimensionen und stellen Sie die Feldkonformität sicher
    401 Unauthorizedinvalid_api_keyAbgelaufenes oder falsches Bearer-TokenErneuern Sie das API-Token im ToAPIs-Entwicklerdashboard
    429 Rate Limitrate_limit_exceededNebenläufigkeitsgrenze des Compute-Pools erreichtImplementieren Sie Retries mit exponentiellem Backoff und zufälligem Jitter
    500 / 504 Timeoutgateway_timeoutTemporäre Latenz auf vorgelagerten Inferenz-KnotenDas Gateway leitet automatisch auf das Backup-GPU-Cluster um

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Preise und FinOps-ROI-Berechnung

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Offizielle Enterprise-Basis: Direkte Anbieterverträge erzwingen jährliche Mindestlaufzeiten, feste Sitzplatzkontingente und Vorauszahlungsschwellen.
    • ToAPIs-Großhandelspreis: Reine elastische Abrechnung nach Verbrauch mit Großhandelstarifen ($0.020 - $0.024 pro HD-Bild).
    • FinOps-ROI-Analyse: Die Erstellung von 50.000 Werbegrafiken pro Monat senkt die Kosten von $2,000 auf $1,100 und spart $900 pro Monat (45,0 % Kostenreduktion).

    6. Häufig gestellte Fragen (FAQ)

    F1: Woher kommt die 60-prozentige Kostenverschwendung bei Replicate?

    Vor allem aus drei Faktoren: Zahlung für die Container-Initialisierung beim Kaltstart, Zahlung für Leerlauf-GPU-Zeit zwischen sporadischen Nutzeranfragen und Cache-Misses beim Modell-Versioning.

    F2: Verringert der Wechsel zu ToAPIs die Bildauflösung oder die visuelle Qualität?

    Nein. Die zugrunde liegenden Modellgewichte (Flux, GPT Image 2, Seedream) sind identisch. Die Einsparungen entstehen durch Multi-Tenant-Pooling und die Nutzung gebündelter GPU-Kapazität.

    F3: Wie lange dauert eine typische Migration?

    Die meisten Engineering-Teams schließen die Umstellung in unter zwei Stunden ab, weil ToAPIs Standard-REST-Payloads statt proprietärer SDK-Abstraktionen verwendet.


    7. Aktionscheckliste und nächste Schritte

    • Registrieren Sie sich für einen API-Schlüssel im ToAPIs-Entwicklerportal.
    • Prüfen Sie die API-Konnektivität mit dem cURL-Snippet aus Schritt 1.
    • Binden Sie das Python-Produktionsskript in Ihre Backend-Pipeline ein.
    • Entdecken Sie verwandte Enterprise-Tutorials in unserem technischen Dokumentationsindex.

    In diesem Beitrag erwähnte Modelle entdecken

    ToAPIsAI Model

    flux-1-schnell

    Aktueller Preis: Live-Preise ansehen
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten
    OpenAIIMAGE

    GPT-Image-2

    Aktueller Preis: 3 credits /request
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten
    ToAPIsAI Model

    seedream-v4

    Aktueller Preis: Live-Preise ansehen
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten

    Verwandte Artikel

    alternative2026-10-30T10:00:00+08:003 Min. Lesezeit

    Replicate-Alternativen: schnellere Kaltstarts, transparente Preise und OpenAI-Kompatibilität

    Entdecken Sie 2026 die besten Alternativen zu Replicate. Beseitigen Sie schmerzhafte 30-Sekunden-Kaltstarts, vermeiden Sie SDK-Bindung und nutzen Sie vorgewärmte OpenAI-kompatible REST-Endpunkte.

    TO
    ToAPIs Engineering & Evaluation Team
    #Replicate Alternative
    tutorial2026-11-12T10:00:00+08:006 Min. Lesezeit

    Native 4K-Bilder mit GPT Image 2 erzeugen: Seitenverhältnisse und Upscaling-Workflows

    Erzeugen Sie native 4K-Ausgaben mit dem aktuellen GPT Image 2-Vertrag: size als Seitenverhältnis und resolution als 4k. Ein dokumentiertes upscale: true-Flag gibt es nicht, und die 4K-Pixelgröße hängt vom gewählten Verhältnis ab.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    tutorial2026-11-12T10:00:00+08:006 Min. Lesezeit

    Inpainting und Outpainting mit der GPT Image 2 Bildbearbeitungs-API meistern

    Bearbeiten Sie bestehende Bilder mit dem aktuellen GPT Image 2-Vertrag: referenzgeführte Änderungen auf gpt-image-2 und maskenbasiertes Inpainting auf gpt-image-2-official — alles auf dem asynchronen Generierungsendpunkt.

    TO
    ToAPIs Engineering & Evaluation Team
    #GPT Image 2
    ToAPIs
    StartseiteToAPIs
    Unternehmens-KI-API-Gateway. Greife über eine einheitliche API auf GPT-5, Claude, Gemini und über 200 Modelle zu.

    Beliebte Modelle

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Mehr anzeigenWeniger anzeigen
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Alle Modelle

    API-Kategorien

    • KI-Bild-API
    • KI-Video-API
    • Text-zu-Video-API
    • Bild-zu-Video-API
    Mehr anzeigenWeniger anzeigen
    • KI-Bildbearbeitungs-API
    • LLM- und Reasoning-API
    • Alle API-Tools →

    Alternativen

    Alternativen
    • Kie.ai-Alternative
    • Fal.ai-Alternative
    • OpenRouter-Alternative
    • Replicate-Alternative
    • Wavespeed-AI-Alternative
    • Alle Vergleiche →

    Empfohlene Leitfäden

    Empfohlene Leitfäden
    • Preise von Seedance 2.0 und 2.5
    • Leitfaden zur günstigsten Seedance-API
    • Integrationsleitfaden zu MiniMax H3
    • Kostenloser Seedance-2-API-Schlüssel
    • Schnellstart der Seedance-2-API
    • Alle Engineering-Beiträge →

    Entwickler und Plattform

    Entwickler und Plattform
    • API-Dokumentation
    • MCP
    • Preise
    • Modell-Playground
    • LLMs.txt
    • Support kontaktieren
    • Verzeichnis der Modell-Leitfäden
    Betreiber:
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Sitz der Gesellschaft:
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    DatenschutzNutzungsbedingungenZulässige NutzungDatenlöschungDatenaufbewahrungAuftragsverarbeiter und RegionenAbrechnung und ErstattungenCookie-RichtlinieSitemapÜber uns

    © 2026 ToAPIs. Alle Rechte vorbehalten.