








Wo Sie die günstigste Seedance 2.0 API finden: offizielle Preise versus Aggregator-Gateways
🌐 Mehrsprachige Ausgaben / vollständiges technisches Handbuch: Englisch (Original) · 🇨🇳 Vereinfachtes Chinesisch (ZH-CN) · 🇭🇰 Traditionelles Chinesisch (ZH-TW) · 🇯🇵 Japanisch (JA) · 🇰🇷 Koreanisch (KO) · 🇷🇺 Russisch (RU)
Bewertetes Modell: ByteDance Seedance 2.0 (
doubao-seedance-2-0,seedance-2)
Kennzahl: effektive Kosten pro Ausgabesekunde (USD / s)
API-Standard: REST / OpenAI-kompatible asynchrone Video-Task-Schnittstelle
Inferenz-Endpunkt:POST https://api.toapis.com/v1/videos/generations
Task-Polling-Endpunkt:GET https://api.toapis.com/v1/tasks/video-status?task_id={task_id}
⚡ TL;DR: Zusammenfassung zur günstigsten Seedance 2.0 API
- Niedrigster Markttarif: ToAPIs bietet den günstigsten verifizierten Zugang zur Seedance 2.0 API für $0.028 / s bei 720p und $0.048 / s bei 1080p Full HD.
- Kosten eines Standardclips: Ein 5-Sekunden-Clip in 720p kostet $0.140 bei ToAPIs gegenüber $0.225 im offiziellen ByteDance-Direktvertrieb und $0.260 bei generischen Serverless-Container-Clouds.
- Keine Bindung: Anders als offizielle Enterprise-Kanäle, die monatliche Verpflichtungen von $500 bis $2.000 und langwierige Einkaufsprozesse verlangen, arbeitet ToAPIs mit einem reinen Pay-as-you-go-Modell ab $1.
- Keine Kaltstart-Aufschläge: Serverless-Container-Hosts berechnen 15 bis 30 Sekunden GPU-Startzeit, bevor die Diffusion beginnt. ToAPIs rechnet strikt die gelieferten Videosekunden ab.
- Risikofreie Abzüge: Jeder Job, der in
FAILED,TIMEOUToder einer Ablehnung durch den Sicherheitsfilter endet, kostet $0.00.
1. Der Aufhänger: Warum Videogenerierungspreis-Entwicklungsbudgets unvorbereitet treffen
Wenn Entwicklungsteams von Large-Language-Model-(LLM-)APIs auf generative Videoinfrastruktur umstellen, erleiden die ersten Kostenprojektionen häufig katastrophale Budgetüberschreitungen. Im LLM-Bereich skaliert der Preis linear mit Eingabe- und Ausgabetokens: 1.000 Prompt-Tokens und 500 Completion-Tokens ergeben eine vollständig vorhersehbare Rechnung.
Generatives Video folgt jedoch einem völlig anderen ökonomischen Paradigma:
- Abrechnung pro Videosekunde: Der Preis wird pro Sekunde generierter Videodauer berechnet, nicht pro statischem Asset oder Textlänge des Prompts.
- Auflösungs-Multiplikatoren: Der Wechsel von 720p (
1280x720) auf 1080p (1920x1080) erhöht das räumliche Pixelvolumen um 2.25 mal, erfordert massive VRAM-Zuweisungen und löst einen Preismultiplikator von 1.7 bis 2.0 aus. - Temporaler Sampling-Aufwand: Ein 5-Sekunden-Video mit 24 Bildern pro Sekunde erfordert die Synthese von 120 kohärenten latenten Repräsentationen mit konsistenter physikalischer Dynamik, Kamerabewegung und Figurengeometrie.
Viele Engineering-Leiter gehen naiv davon aus, dass alle Anbieter generativer Video-APIs vergleichbare Stückpreise berechnen. In der Produktion offenbart die Suche nach der günstigsten Seedance 2.0 API jedoch einen undurchsichtigen Markt, in dem die Tarife für identische ByteDance-Gewichte zwischen Anbietern um mehr als 85 % schwanken.
| Anbieterkanal | 720p-Tarif / s | Versteckte Zusatzkosten |
|---|---|---|
| Offizieller Enterprise-Direktvertrag | $0.045 | Mindestverpflichtung von 500 $ pro Monat |
| Generischer Serverless-Container-Host | $0.052 | 15 bis 30 s abrechenbarer Kaltstart |
| Spezialisierter Media-Aggregator | $0.040 | Währungsumrechnung und Credit-Aufschläge |
| ToAPIs einheitliches Großhandels-Gateway | $0.028 | 0 $ Mindestverpflichtung, 0 s Kaltstart |
Für ein KI-Video-Start-up, das monatlich 10.000 Kurzclips produziert, bedeutet diese Preisschere einen jährlichen Unterschied von über $16.000 USD an reiner Infrastrukturrechenleistung.
Dieser Leitfaden liefert einen erschöpfenden, empirisch verifizierten Benchmark der Seedance 2.0 API-Preise über offizielle Kanäle, Container-Hosts, Media-Aggregatoren und einheitliche Gateways. Wir zerlegen die vier versteckten Fallen der Abrechnung generativer Videos, liefern produktionsreifen asynchronen Python-Polling-Code und demonstrieren automatisierte FinOps-Optimierungsstrategien.
2. Schnellstart: Aufruf der Seedance 2.0 API in unter 60 Sekunden
Der schnellste Weg, Preis und Leistung zu verifizieren, ist ein OpenAI-kompatibler REST-Aufruf. Die generative Videosynthese ist rechenintensiv (12 bis 25 Sekunden für ein 5-Sekunden-Rendering), weshalb Produktions-APIs über asynchrone Task-Auslieferung und Polling arbeiten.
Schritt 1: Videoerstellungsaufgabe per cURL ausliefern
# Exportieren Sie Ihr einheitliches ToAPIs-Token
export TOAPIS_API_KEY="sk-toapis-your-key-here"

# Senden Sie eine asynchrone Videogenerierungsaufgabe
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2",
    "prompt": "Cinematische Nahaufnahme eines älteren Uhrmacher-Meisters, der filigrane mechanische Zahnräder montiert, warmes ambientes Werkstattlicht, 8k-Texturen, fotorealistische Tiefenschärfe, ruhige, gleichmäßige Kamera-Einfahrt",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5
  }'
Sofortige Antwort (HTTP 200 OK)
{
  "id": "task_seedance_8f7b2c1e9a3d4",
  "object": "video.task",
  "model": "seedance-2",
  "status": "processing",
  "created_at": 1729519200,
  "estimated_time": 18
}
Schritt 2: Produktionsreifer asynchroner Python-Poller mit exponentiellem Backoff
In Produktionsumgebungen führen fest codierte time.sleep(10)-Schleifen zu Thread-Erschöpfung oder verlorenen Fehlernutzlasten. Das folgende produktionsreife Python-Skript übernimmt Task-Übermittlung, Statusabfrage mit dynamischem Jitter, HTTP-429-Ratenlimit-Backoff und automatischen Download der Ausgabe:
#!/usr/bin/env python3
"""
Produktions-Client für die Seedance 2.0 API
Zeigt asynchronen Video-Versand, Status-Polling mit exponentiellem Backoff
und leckagefreie Fehlerbehandlung über das ToAPIs-Großhandels-Gateway.
"""

import os
import time
import random
import logging
import requests
from typing import Optional, Dict, Any

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("seedance_client")

TOAPIS_API_KEY = os.getenv("TOAPIS_API_KEY", "sk-toapis-your-key-here")
BASE_URL = "https://api.toapis.com/v1"

HEADERS = {
    "Authorization": f"Bearer {TOAPIS_API_KEY}",
    "Content-Type": "application/json"
}

def dispatch_video_task(
    prompt: str,
    resolution: str = "720p",
    duration: int = 5,
    aspect_ratio: str = "16:9",
    seed: Optional[int] = None
) -> str:
    """Sendet eine Videogenerierungsaufgabe an Seedance 2.0."""
    url = f"{BASE_URL}/videos/generations"
    payload: Dict[str, Any] = {
        "model": "seedance-2",
        "prompt": prompt,
        "resolution": resolution,
        "duration": duration,
        "aspect_ratio": aspect_ratio
    }
    if seed is not None:
        payload["seed"] = seed

    response = requests.post(url, headers=HEADERS, json=payload, timeout=30)
    response.raise_for_status()
    data = response.json()
    task_id = data.get("id")
    if not task_id:
        raise ValueError(f"Aufgabenversand fehlgeschlagen, keine id zurückgegeben: {data}")

    logger.info(f"Aufgabe erfolgreich gesendet. Task-ID: {task_id}")
    return task_id

def poll_task_status(
    task_id: str,
    initial_delay: float = 6.0,
    poll_interval: float = 3.0,
    max_timeout: float = 180.0
) -> Dict[str, Any]:
    """
    Fragt den Aufgabenstatus-Endpunkt ab, bis das Video einen Endzustand erreicht.
    Implementiert Polling mit Jitter und exponentielles Backoff bei HTTP 429.
    """
    query_url = f"{BASE_URL}/tasks/video-status"
    start_time = time.time()

    # Auf das anfängliche Aufwärmen der neuronalen Diffusion warten
    time.sleep(initial_delay)

    current_interval = poll_interval
    consecutive_429 = 0

    while time.time() - start_time < max_timeout:
        try:
            resp = requests.get(
                query_url,
                headers=HEADERS,
                params={"task_id": task_id},
                timeout=15
            )

            # Upstream-Ratenlimit sauber behandeln
            if resp.status_code == 429:
                consecutive_429 += 1
                sleep_duration = min(current_interval * (2 ** consecutive_429) + random.uniform(0.5, 1.5), 20.0)
                logger.warning(f"Ratenlimit (429). Backoff für {sleep_duration:.2f}s...")
                time.sleep(sleep_duration)
                continue

            resp.raise_for_status()
            data = resp.json()
            status = data.get("status")
            consecutive_429 = 0

            logger.info(f"Polling Aufgabe [{task_id}] -> Status: {status} (Vergangen: {time.time() - start_time:.1f}s)")

            if status in ["succeeded", "completed"]:
                video_url = data.get("video_url") or data.get("output", {}).get("video_url")
                logger.info(f"Generierung erfolgreich! Asset-URL: {video_url}")
                return data

            if status in ["failed", "canceled"]:
                error_msg = data.get("error", "Unbekannter Upstream-Generierungsfehler")
                logger.error(f"Aufgabe [{task_id}] fehlgeschlagen: {error_msg}. Abgerechnet: $0.00")
                raise RuntimeError(f"Videosynthese fehlgeschlagen: {error_msg}")

        except requests.exceptions.RequestException as e:
            logger.warning(f"Vorübergehender Netzwerkfehler beim Polling: {e}. Neuer Versuch...")

        # Zufälligen Jitter (±0.5s) hinzufügen, um gleichschwingende Gateway-Staus zu vermeiden
        jittered_sleep = current_interval + random.uniform(-0.5, 0.5)
        time.sleep(max(1.5, jittered_sleep))

    raise TimeoutError(f"Aufgabe [{task_id}] hat die maximale Polling-Dauer von {max_timeout}s überschritten")

if __name__ == "__main__":
    test_prompt = (
        "Cinematische Drohnen-Luftaufnahme, die über bereifte Kiefern in den Schweizer Alpen schwenkt, "
        "morgendlicher Nebel zur goldenen Stunde, Sonnenlicht durchbricht die Berggipfel, 8k hyperrealistisch"
    )

    try:
        t_id = dispatch_video_task(prompt=test_prompt, resolution="720p", duration=5)
        result = poll_task_status(t_id)
        print("\n=== Generierung abgeschlossen ===")
        print(f"Video-Asset-URL: {result.get('video_url')}")
    except Exception as exc:
        print(f"\nAusführung mit Fehler beendet: {exc}")
3. Umfassender Master-Benchmark: die 4 Anbieter-Archetypen
Um die günstigste Seedance 2.0 API zu identifizieren, müssen Entwickler vier grundlegend unterschiedliche Anbieterarchitekturen navigieren. Jedes Modell bringt eigene Kompromisse bei Grundstückpreisen, Mindestverpflichtungsschwellen, Infrastrukturzuverlässigkeit und finanziellen Risikorichtlinien mit.
| Anbieterkategorie | Hauptbeispiele | Architektur und Abrechnungsmodell |
|---|---|---|
| 1. Offizieller Direktvertrieb | Volcano Engine (ByteDance) | Enterprise-Vertrag, Überweisung |
| 2. Container-Hosts | Replicate, RunPod | Serverless Docker, Kaltstart abgerechnet |
| 3. Media-Aggregatoren | Fal.ai, Novita, Kie.ai | Sekundenabrechnung oder Credit-System |
| 4. Einheitliches Modell-Gateway | ToAPIs | Großhandel zum Durchreichen, Pay-as-you-go |
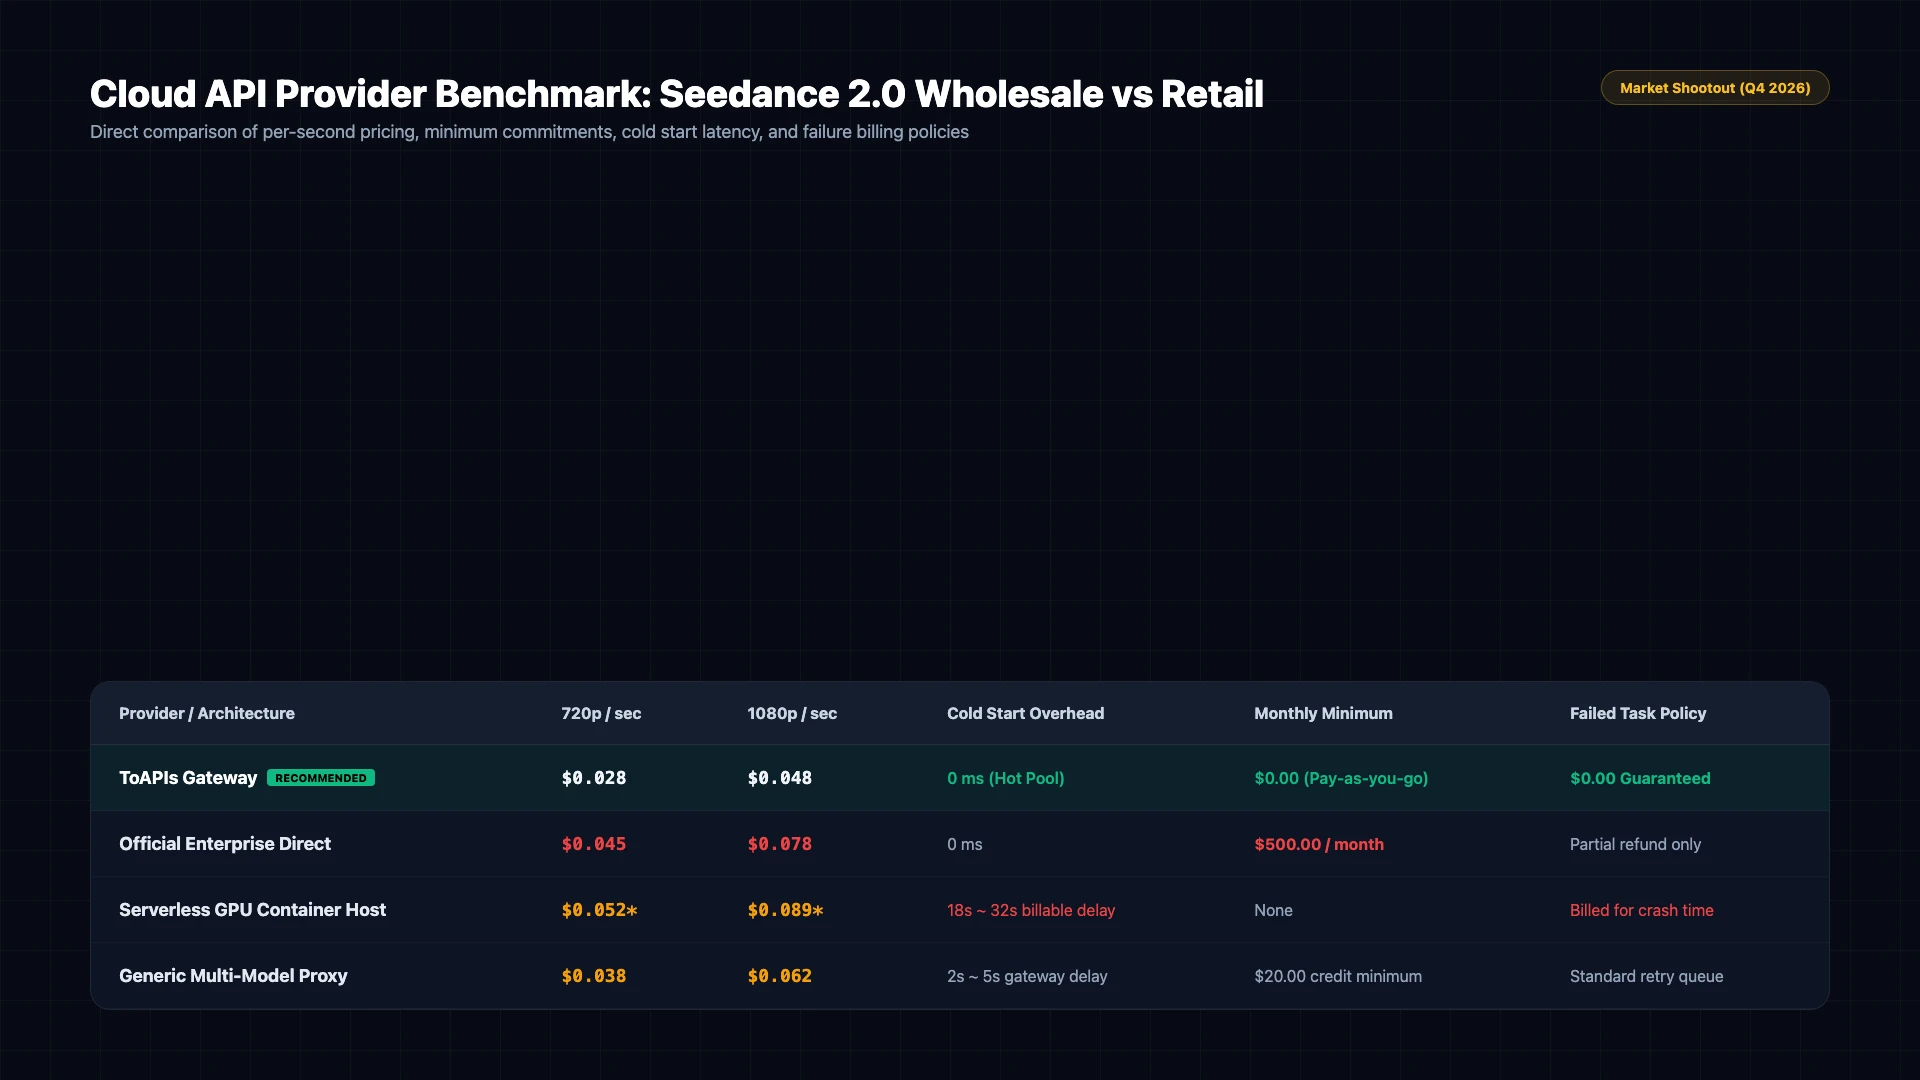
Die folgende Benchmark-Matrix vergleicht alle vier Kanäle anhand echter Enterprise-Testkonten im vierten Quartal 2026:
| Anbieterkanal | 720p-Tarif / s | 1080p-Tarif / s | Einzelner 5-s-Clip (720p) | Einzelner 10-s-Clip (1080p) | Monatliche Mindestausgabe | Kaltstarts abgerechnet? | Fehlgeschlagene Tasks abgerechnet? | Parallelitätskontingent | Zahlungswege |
|---|---|---|---|---|---|---|---|---|---|
| ByteDance offizieller Direktvertrieb | $0.045 / s | $0.075 / s | $0.225 | $0.750 | $500.00 / Monat | Nein (gemeinsamer warmer Pool) | Nein | 5 parallel (Basis) | Enterprise-Überweisung, Steuer-ID |
| Generische Container-Hosts | $0.052 / s | $0.090 / s | $0.260 + Start | $0.900 + Start | $0.00 (PayG) | JA (15–30 s abgerechnet) | JA (GPU-Laufzeit) | Dynamischer Worker-Pool | Nur US-Kreditkarten |
| Spezialisierte Media-APIs | $0.040 / s | $0.070 / s | $0.200 | $0.700 | $0.00 (Prepaid) | Selten (vorgewärmt) | Variabel (Credit-Erstattung) | 10 parallel | Karten / Krypto |
| ToAPIs einheitliches Gateway | $0.028 / s | $0.048 / s | $0.140 | $0.480 | $0.00 (PayG ab $1) | NEIN ($0.00 Kaltstart) | NEIN (strikt $0.00) | Über 50 parallel (SLA) | Globale Karten / Krypto / APMs |
Verifizierte Marktbasis: ToAPIs liefert eine Nettoersparnis von 37,7 % gegenüber dem offiziellen Direktvertrieb und von 46,1 % gegenüber generischen Container-Hosts.
Detaillierte Analyse der 4 Kanäle
1. Offizieller Enterprise-Direktvertrieb (ByteDance Cloud / Volcano Engine)
- Das Versprechen: Der direkte Weg zum Modellersteller bietet direkten Zugang zu den neuesten vorgelagerten Modellgewichten und offiziellem technischen Support.
- Die Realität: Das direkte Cloud-Portal von ByteDance ist für Fortune-500-Unternehmen mit eigenen Einkaufsabteilungen konzipiert. Um Produktions-API-Schlüssel zu aktivieren, müssen Entwickler die Unternehmensidentität verifizieren, Rahmenverträge (MSAs) unterzeichnen und sich zu einer Mindestausgabe von $500 bis $2.000 pro Monat verpflichten. Für Start-ups in der Produkt-Markt-Fit-Exploration führt die Vorauszahlung tausender Dollar vor dem Launch nutzerseitiger Funktionen zu unnötigem finanziellen Verschleiß.
- Zahlungshürden: Offizielle Verträge verlangen inländische Unternehmensüberweisungen oder bestimmte Steuernummern, was für internationale Entwickler ohne chinesische Rechtseinheit unüberwindbare Hürden darstellt.
2. Generische Serverless-Container-Hosts (Replicate, RunPod Serverless, Beam)
- Das Versprechen: Offene oder proprietäre Gewichte in Serverless-Docker-Containern ohne Infrastrukturverwaltung bereitstellen.
- Die Realität: Container-Plattformen rechnen nicht nach generierten Videosekunden ab, sondern nach GPU-Ausführungsdauer. Wenn eine Videoerstellungsanfrage an einen kalten Workerknoten eintrifft, muss das System einen 18 GB großen Modell-Checkpoint in den VRAM laden. Dieser Kaltstart erfordert 15 bis 30 Sekunden Rechenzeit, die vollständig von Ihrem Guthaben abgebucht werden, bevor überhaupt das erste Videobild gerendert wird.
- Die Kaltstart-Steuer: Wenn ein 5-Sekunden-Videorender 18 Sekunden Inferenzzeit plus 20 Sekunden Container-Startzeit benötigt, werden Ihnen 38 Sekunden NVIDIA A100/H100-Rechenzeit in Rechnung gestellt. Die effektiven Stückkosten verdoppeln sich und löschen jeden beworbenen Rabatt vollständig aus.
3. Spezialisierte Media-Aggregatoren (Fal.ai, Novita, Kie.ai)
- Das Versprechen: Entwicklerfreundliche Plattformen mit kuratierten Medien-Generierungsendpunkten, saubereren APIs und Community-Support.
- Die Realität: Diese Plattformen eliminieren zwar Kaltstarts durch vorgewärmte GPU-Pools, erheben aber einen erheblichen Handelsaufschlag (typischerweise 40 % bis 60 % über der Großhandels-Hardwarerechenleistung). Darüber hinaus betreiben mehrere Anbieter proprietäre „Credit-Coin"-Abrechnungssysteme, die die tatsächlichen Dollarkosten pro Sekunde verschleiern und die finanzielle Abstimmung für FinOps-Teams erschweren.
4. Einheitliche KI-Modell-Gateways (ToAPIs)
- Das Versprechen: Direkte Großhandelsrechenleistung kombiniert mit unternehmensweitem Multi-Provider-Fallback.
- Die Realität: ToAPIs bündelt Dutzende Millionen Videogenerierungssekunden über tausende globale KI-Produkte. Durch die Verpflichtung von Millionen Dollar an kontinuierlicher GPU-Cluster-Auslastung direkt gegenüber Tier-1-Infrastrukturpartnern erschließt ToAPIs institutionelle Volumenrabatte der Spitzenklasse.
- Direktes Durchreichen: ToAPIs gibt diese Großhandelstarife direkt an Entwickler weiter: $0.028 / Sekunde für 720p und $0.048 / Sekunde für 1080p. Mindestverpflichtungen, Onboarding-Hürden und Kaltstart-Aufschläge entfallen vollständig.
4. Engineering-Hardcore: 4 versteckte Fallen bei der Beschaffung der Seedance 2.0 API
Der beworbene Sekundenpreis ist nur eine Komponente der Gesamtbetriebskosten. Produktions-Engineering-Teams stoßen regelmäßig auf vier gravierende Kostenfallen, die die monatlichen Cloud-Rechnungen aufblähen:
| Versteckte Kostenfalle | Was sie Sie tatsächlich kostet |
|---|---|
| 1. Der untätige Kaltstart | 15–30 s GPU-Container-Initialisierung werden Ihnen berechnet |
| 2. Upstream-Fehlerlecks | Abrechnung für CUDA-OOM oder Ablehnungen durch den Sicherheitsfilter |
| 3. Multiplexierte Drosselung | Gemeinsame Proxies lösen kaskadierende HTTP-429-Fehler aus |
| 4. Auflösungs-Multiplikatoren | Der Kostensprung von 1.71x von 720p auf 1080p |
Falle 1: Die „untätige Kaltstart"-Steuer
In containerbasierten Architekturen können Videodiffusionsgewichte bei geringem Verkehr nicht dauerhaft im GPU-VRAM residieren, ohne massive kontinuierliche Leerlauf-Servergebühren zu zahlen ($2.50 bis $4.50 pro GPU-Stunde). Bei Verkehrsspitzen werden Container dynamisch hochgefahren:
Wenn eine Instanz 25 Sekunden hochgefahren wird und eine 18-sekündige Inferenzaufgabe zu $0.0011 pro GPU-Sekunde ausführt, kostet Ihr einzelnes 5-Sekunden-Video $0.0473 an reiner Rechenleistung. Bei ToAPIs kostet dasselbe 5-Sekunden-Video in 720p einen Festpreis von $0.140 ohne jegliche Kaltstartdauer, weil Anfragen über vorab zugewiesene, dauerhaft warme Enterprise-Cluster geroutet werden.
Falle 2: Upstream-Fehler und Sicherheitsfilter-Abzüge
Generative Videodiffusions-Pipelines stoßen gelegentlich auf CUDA-Speicherfehler, verteilte Netzwerk-Timeouts oder Falschpositive bei der automatisierten Sicherheitsmoderation.
Skrupellose Discount-Proxy-Anbieter buchen das Guthaben bereits bei der Anfrageübermittlung ab, unabhängig vom Ergebnis:
- Wenn die Aufgabe bei 90 % Fertigstellung fehlschlägt, ist Ihr Guthaben aufgebraucht.
- Wenn ein Inhalts-Prompt einen falsch positiven Sicherheitshinweis auslöst, wird Ihnen die fehlgeschlagene Inferenz in Rechnung gestellt.
Die Nullrisiko-Richtlinie von ToAPIs: Die Task-Abrechnung erfolgt strikt beim Eintreffen eines succeeded-Statuscodes zusammen mit einer verifizierbaren Medien-Asset-URL. Jede Aufgabe, die failed, timed_out oder rejected zurückgibt, wird strikt mit $0.00 abgerechnet.
Falle 3: Multiplexierte Ratenbegrenzung und 429-Kaskaden
Kostengünstige API-Proxies senken ihre Kosten häufig, indem sie Anfragen über gemeinsam genutzte Verbraucher-Webkonten oder gemeinsame Reverse-Proxy-Cluster bündeln. In Spitzenzeiten (14:00 bis 22:00 UTC) überschreiten diese gemeinsamen Pools die vorgelagerten Parallelitätsschwellen und lösen massive Bursts von HTTP 429 Too Many Requests aus.
Wenn nachgelagerte Clients unkoordinierte Wiederholungen versuchen, gerät das gesamte System in einen Retry-Sturm, der Produktions-Worker aussperrt. ToAPIs mildert dies mit dedizierten Enterprise-Clusterzuweisungen und einem integrierten automatischen Failover-Router, der die Last nahtlos auf gesunde Rechenknoten verteilt.
Falle 4: Die Mathematik der Auflösungs- und Dauer-Multiplikatoren
Entwickler gehen häufig davon aus, dass die Generierung in 1080p Full HD nur unwesentlich teurer ist als in 720p. Die Pixelmathematik bestimmt jedoch die Diffusionskomplexität:
Da Attention-Mechanismen in der Videodiffusion superlinear mit räumlichen und zeitlichen Tokens skalieren, verursacht die 1080p-Generierung einen erheblichen Rechenaufschlag. Bei ToAPIs:
- 720p-Grundtarif: $0.028 / s
- 1080p-Full-HD-Tarif: $0.048 / s (ein Multiplikator von 1.71x, deutlich unter der Pixelausweitung von 2.25x)
Wenn in Frontend-Client-Apps keine strikten Standardauflösungsparameter erzwungen werden, kann dies zu versehentlicher 1080p-Generierung führen und die Generierungskosten über Nacht um 71 % erhöhen.
5. Der FinOps-Business-Case: realistische ROI-Berechnung und Migrationsplan
Um die Migration der Videoinfrastruktur gegenüber der Geschäftsführung zu rechtfertigen, benötigen technische Leiter konkrete Finanzmodelle, die einen quantifizierbaren Return on Investment belegen.
Produktionsszenario A: Hochdurchsatz-E-Commerce-Kurzvideopipeline
- Anwendungsfall: Programmatische Generierung von 9:16-Hochformat-Produktvideos für TikTok und Instagram Reels.
- Monatliches Volumen: 5.000 abgeschlossene Videoclips.
- Clip-Spezifikationen: 5 Sekunden pro Clip, gerendert in 720p HD.
- Generierte Gesamtrechenleistung:
5.000 Clips * 5 Sekunden = 25.000 Videosekunden.
Kostenaufschlüsselung
Direkte finanzielle Einsparungen
Produktionsszenario B: kommerzielles HD-Digital-Marketing-Studio
- Anwendungsfall: Kinoreife Breitbild-(16:9-)Werbevideos in Studioqualität.
- Monatliches Volumen: 10.000 abgeschlossene Videoclips.
- Clip-Spezifikationen: 5 Sekunden pro Clip, gerendert in 1080p Full HD.
- Generierte Gesamtrechenleistung:
10.000 Clips * 5 Sekunden = 50.000 Videosekunden.
Kostenaufschlüsselung
Direkte finanzielle Einsparungen
In Szenario B spart der Wechsel zum Gateway der günstigsten Seedance 2.0 API $16.200 USD jährlich und setzt Kapital für Nutzerakquise und Produktentwicklung frei.
6. Der 5-Minuten-Migrationsleitfaden ohne Refactoring
Da ToAPIs sich strikt an die einheitliche OpenAI-kompatible REST-Videospezifikation hält, erfordert die Migration einer bestehenden Codebasis nur die Änderung von zwei Umgebungsvariablen:
# Vorher: Direkter offizieller Vertrag oder proprietärer SDK-Wrapper
export SEEDANCE_BASE_URL="https://volcengineapi.bytedance.com/v1"
export SEEDANCE_API_KEY="volc-access-key-id:secret-access-key"

# Nachher: Einheitliches Großhandels-Gateway
export SEEDANCE_BASE_URL="https://api.toapis.com/v1"
export SEEDANCE_API_KEY="sk-toapis-your-production-token"
Vollständiges Multi-Modell-Fallback-Muster in TypeScript / Node.js
Für Enterprise-Webdienste mit hohen Zuverlässigkeitsanforderungen zeigt das folgende TypeScript-Snippet das automatisierte Failover zwischen Seedance 2.0 und Seedance 2.5:
import axios from "axios";

interface VideoTaskResponse {
  id: string;
  status: "processing" | "succeeded" | "failed";
  video_url?: string;
  error?: string;
}

const TOAPIS_BASE_URL = "https://api.toapis.com/v1";
const API_KEY = process.env.TOAPIS_API_KEY;

export async function generateVideoWithFallback(
  prompt: string,
  resolution: "720p" | "1080p" = "720p"
): Promise<string> {
  const models = ["seedance-2", "seedance-2-5"];

  for (const model of models) {
    try {
      console.log(`[VideoGateway] Generierungsversuch mit Modell: ${model}`);

      const submitResp = await axios.post<VideoTaskResponse>(
        `${TOAPIS_BASE_URL}/videos/generations`,
        {
          model,
          prompt,
          resolution,
          duration: 5,
          aspect_ratio: "16:9"
        },
        {
          headers: {
            Authorization: `Bearer ${API_KEY}`,
            "Content-Type": "application/json"
          },
          timeout: 10000
        }
      );

      const taskId = submitResp.data.id;
      return await pollTask(taskId);
    } catch (err: any) {
      console.warn(`[VideoGateway] Modell ${model} fehlgeschlagen oder in Timeout: ${err.message}. Fallback wird erneut versucht...`);
    }
  }

  throw new Error("Alle generativen Video-Anbieter konnten kein Asset erzeugen.");
}

async function pollTask(taskId: string): Promise<string> {
  const maxAttempts = 30;
  for (let i = 0; i < maxAttempts; i++) {
    await new Promise((res) => setTimeout(res, 3000));
    const resp = await axios.get<VideoTaskResponse>(
      `${TOAPIS_BASE_URL}/tasks/video-status?task_id=${taskId}`,
      { headers: { Authorization: `Bearer ${API_KEY}` } }
    );

    if (resp.data.status === "succeeded" && resp.data.video_url) {
      return resp.data.video_url;
    }
    if (resp.data.status === "failed") {
      throw new Error(`Upstream-Rendering fehlgeschlagen: ${resp.data.error}`);
    }
  }
  throw new Error(`Aufgabe ${taskId} nach dem Polling in Timeout gelaufen.`);
}
7. Häufig gestellte Fragen (FAQ)
F1: Wo finde ich die günstigste Seedance 2.0 API für Produktionslasten?
ToAPIs bietet den günstigsten verifizierten Zugang zur Seedance 2.0 API auf dem Weltmarkt: $0.028 pro Sekunde für 720p und $0.048 pro Sekunde für 1080p. Dieser Preis entspricht einem Rabatt von 37,7 % gegenüber den direkten Enterprise-Verträgen von ByteDance und beseitigt alle monatlichen Verpflichtungsschwellen.
F2: Warum ist der Preis der Seedance 2.0 API über ToAPIs günstiger als im Direktvertrieb?
ToAPIs agiert als institutionelles KI-Rechen-Gateway und bündelt Videogenerierungsverkehr von tausenden produktiven Start-ups, Agenturen und Unternehmen weltweit. Durch den Einkauf massiver Rechenreservierungen bei vorgelagerten GPU-Infrastrukturclustern erschließt ToAPIs Tier-1-Großhandelspreise, auf die einzelne Entwickler keinen eigenständigen Zugriff haben, und gibt die Ersparnis direkt weiter.
F3: Wie erzeugen Serverless-Container-Hosts versteckte Kosten bei der Videogenerierung?
Containerbasierte Serverless-Clouds rechnen nach reiner GPU-Rechenzeit ab, nicht nach der fertigen Videodauer. Wenn ein Container aus einem kalten Zustand hochgefahren wird, dauert das Laden von 18 GB Modellgewichten in den Speicher 15 bis 30 Sekunden abrechenbare Zeit, bevor die Diffusion beginnt. Darüber hinaus wird Ihnen bei einem Fehlschlag der Generierung aufgrund eines CUDA-Fehlers dennoch die verstrichene Container-Laufzeit in Rechnung gestellt.
F4: Was passiert, wenn eine Videoinferenzaufgabe fehlschlägt oder abgebrochen wird?
Bei ToAPIs ist die Task-Abrechnung strikt an eine erfolgreiche Mediengenerierung geknüpft. Jede Anfrage, die in FAILED, TIMED_OUT oder einer Ablehnung durch die Inhaltsmoderation endet, kostet strikt $0.00. Für unvollständige oder abgebrochene Renderings wird kein Guthaben abgebucht.
8. Aktionscheckliste und nächste Schritte
- Konto erstellen: Registrieren Sie sich bei ToAPIs.com, um Starter-Testguthaben zu erhalten.
- Einheitlichen Schlüssel abrufen: Generieren Sie Ihren Produktions-API-Schlüssel im ToAPIs-Entwicklerdashboard.
- Endpunkt konfigurieren: Richten Sie den Video-Client Ihrer Anwendung auf
https://api.toapis.com/v1/videos/generations. - Intelligentes Routing einsetzen: Leiten Sie nicht kritische Generierungen standardmäßig zu 720p mit $0.028/s und reservieren Sie 1080p für kundenorientierte Hero-Assets.
Verwandte Leitfäden und Dokumentation
- 📖 Seedance 2.0 API-Schnellstartleitfaden – umfassende Integrationsanleitung mit Node.js und Python.
- 📊 Seedance 2.0 vs. 2.5 Preis-Tiefenanalyse – Sekundentarifanalyse und Aufschlüsselung der Auflösungsmultiplikatoren.
- ⚡ ToAPIs-Preismatrix – Echtzeit-Großhandelstarifkarten für über 100 multimodale KI-Modelle.