








So erhalten Sie einen kostenlosen Seedance 2.0 API-Schlüssel und testen die Videogenerierung ohne Kreditkarte
🌐 Mehrsprachige Ausgaben / vollständiges technisches Handbuch: Englisch (Original) · 🇨🇳 Vereinfachtes Chinesisch (ZH-CN) · 🇭🇰 Traditionelles Chinesisch (ZH-TW) · 🇯🇵 Japanisch (JA) · 🇰🇷 Koreanisch (KO) · 🇷🇺 Russisch (RU)
Inferenz-Endpunkt:
https://api.toapis.com/v1/videos/generations
Task-Inspektionsendpunkt:https://api.toapis.com/v1/tasks/video-status?task_id={task_id}
Kontostandsendpunkt:https://api.toapis.com/v1/account/token-balance
Authentifizierungsheader:Authorization: Bearer $TOAPIS_API_KEY
Primäre Evaluierungsmodelle:doubao-seedance-2-0,doubao-seedance-2-5,doubao-seedance-2-0-mini
⚡ TL;DR: Zusammenfassung der kostenlosen Seedance 2.0 API-Evaluierung
- Null Abrechnungsreibung: Fordern Sie Entwickler-Evaluierungsguthaben sofort über GitHub OAuth oder E-Mail an; umgehen Sie Gewerbelizenzen aus dem chinesischen Festland, manuelle Vertriebsgespräche und Prüfungen ausländischer Kreditkarten.
- Standardisierte OpenAI-Kompatibilität: Verbinden Sie sich über einheitliche REST-Standards mit Seedance 2.0 und nutzen Sie die vertraute Bearer-Token-Authentifizierung, ohne eigene Signaturgenerierung oder proprietären SDK-Ballast.
- Tests mit vollem Funktionsumfang: Kostenlose Konten evaluieren echte 720p- und 1080p-Generierung, variable Seitenverhältnisse (
16:9,9:16,1:1), Text-to-Video (T2V) und Reference-to-Video (R2V) ohne Downsampling oder Wasserzeichen.- Produktionsreifer Code inklusive: Vollständige, kopierbare Terminal-Verifikationsbefehle und ein asynchrones Python-Polling-Skript mit Statusvalidierung, Fehlererkennung und Kontostandsprüfungen.
- Elastischer Übergang zur Skalierung: Wenn Sie über Testguthaben hinauswachsen, laden Sie bedarfsgerecht ab 1 $ mit Multi-Währungs-Checkout auf und erzielen 37 % direkte Ersparnis gegenüber inländischen Enterprise-Listenpreisen.
1. Der Aufhänger: Warum das Testen von Videogenerierungs-APIs ohne Kreditkarte 2026 nahezu unmöglich ist
Die Videogenerierung mit künstlicher Intelligenz stellt 2026 die rechenintensivste Grenze der modernen Softwareentwicklung dar. Während moderne Large Language Models (LLMs) Tokens zu vernachlässigbaren marginalen GPU-Kosten ausgeben, erfordert die Generierung eines einzigen 5-Sekunden-Videoclips mit 60 fps Milliarden von Gleitkommaoperationen auf spezialisierten Clustern von NVIDIA H100- und H200-SXM5-GPUs. Unter der Haube müssen hybride Diffusion-Transformer-Modelle (DiT) hochdimensionale latente Repräsentationen gleichzeitig über zeitliche und räumliche Dimensionen hinweg iterativ entrauschen.
Aufgrund dieses intensiven Ressourcenverbrauchs schützen Cloud-Anbieter und Entwickler von Fundamentmodellen ihre Inferenzinfrastruktur aggressiv. Wenn ein unabhängiger Entwickler, Forschungsingenieur oder technischer Gründer versucht, einen Seedance 2.0 API-Schlüssel direkt über offizielle Upstream-Kanäle wie ByteDances Volcengine zu erhalten, prallt er sofort auf vier institutionelle Hürden:
Die vier institutionellen Hürden für direkten Zugang
- Inländische Unternehmensverifizierung (Gewerbelizenz chinesisches Festland und Verifizierung der juristischen Person)
- Restriktive internationale Zahlungswege (Ablehnungen bei virtuellen oder Prepaid-Kreditkarten)
- Hohe Mindestverpflichtungsschwellen (verpflichtende Vorabverträge über 500 bis 5.000 $)
- „Kostenlose Testversion"-Lockangebote (360p-Vorschauen in niedriger Auflösung, Wasserzeichen, kein REST-API-Zugang)
Die Unternehmensverifizierungsmauer
Die Enterprise-Cloud-Plattform von ByteDance verlangt für den Modellzugang ein rechtsgültiges Unternehmens-Onboarding. Entwickler müssen beglaubigte Gewerberegistrierungsunterlagen einreichen, eine inländische Identitätsprüfung durchlaufen und manuelle Enterprise-Vertriebsprüfungen bestehen. Für internationale Teams, Freelancer und unabhängige Entwickler bildet diese Anforderung eine unüberwindbare Barriere.
Prüfung ausländischer Kreditkarten und Zahlungsreibung
Für Entwickler außerhalb des chinesischen Festlands setzen ausländische Abrechnungssysteme automatisierte Betrugserkennungsalgorithmen ein, die virtuelle Karten, internationale Debitkarten und Fintech-Dienste wie Revolut oder Wise routinemäßig ablehnen. Entwickler sind gezwungen, temporäre Kartensperrungen zu autorisieren oder nicht rückzahlbare Guthaben einzuzahlen, bevor sie auch nur einen einzigen curl-Befehl ausführen können.
Hohe finanzielle Vorabverpflichtungen
Offizielle Enterprise-Stufen sind für Firmenkunden mit hohen Ausgaben konzipiert. Sie verlangen monatliche Mindestverpflichtungen zwischen 500 und 5.000 $ sowie maßgeschneiderte Service-Level-Vereinbarungen (SLAs). Wenn Ihr Ziel lediglich darin besteht, die Zeichenkonsistenz von Seedance 2.0 gegen Kling 3.0 Omni oder MiniMax H3 zu benchmarken, ist die Vorabverpflichtung über hunderte Dollar finanziell nicht zu rechtfertigen.
Das Playground-Lockangebot
Viele Aggregator-Seiten Dritter versprechen in Suchergebnissen „kostenlose Seedance-Generierung", nur um Entwickler in geschlossenen Webformularen zu fangen. Diese Verbraucherportale geben stark mit Wasserzeichen versehene, heruntergesampelte 360p-MP4-Dateien mit künstlichen Frame-Aussetzern aus. Schlimmer noch: Sie bieten keine programmatischen REST-API-Endpunkte, wodurch es unmöglich ist, die Videogenerierung in automatisierte Produktions-Backends zu integrieren.
Die Lösung: das ToAPIs-Entwickler-Gateway
ToAPIs beseitigt diese Hürden mit einem hochgradig parallelen, einheitlichen API-Gateway, das die standardmäßige OpenAI-Entwicklererfahrung abbildet. Durch die Registrierung mit einer E-Mail-Adresse oder einem GitHub-Konto erhalten Entwickler sofort kostenlose Testguthaben für den Seedance 2.0 API-Schlüssel. Sie können die Inferenzqualität validieren, die API-Latenz messen und den Task-Status von Ihrem Terminal aus in 60 Sekunden abfragen – ohne eine Kreditkarte zu hinterlegen.
2. Schritt-für-Schritt-Anleitung: Anforderung Ihres kostenlosen Seedance 2.0 API-Schlüssels
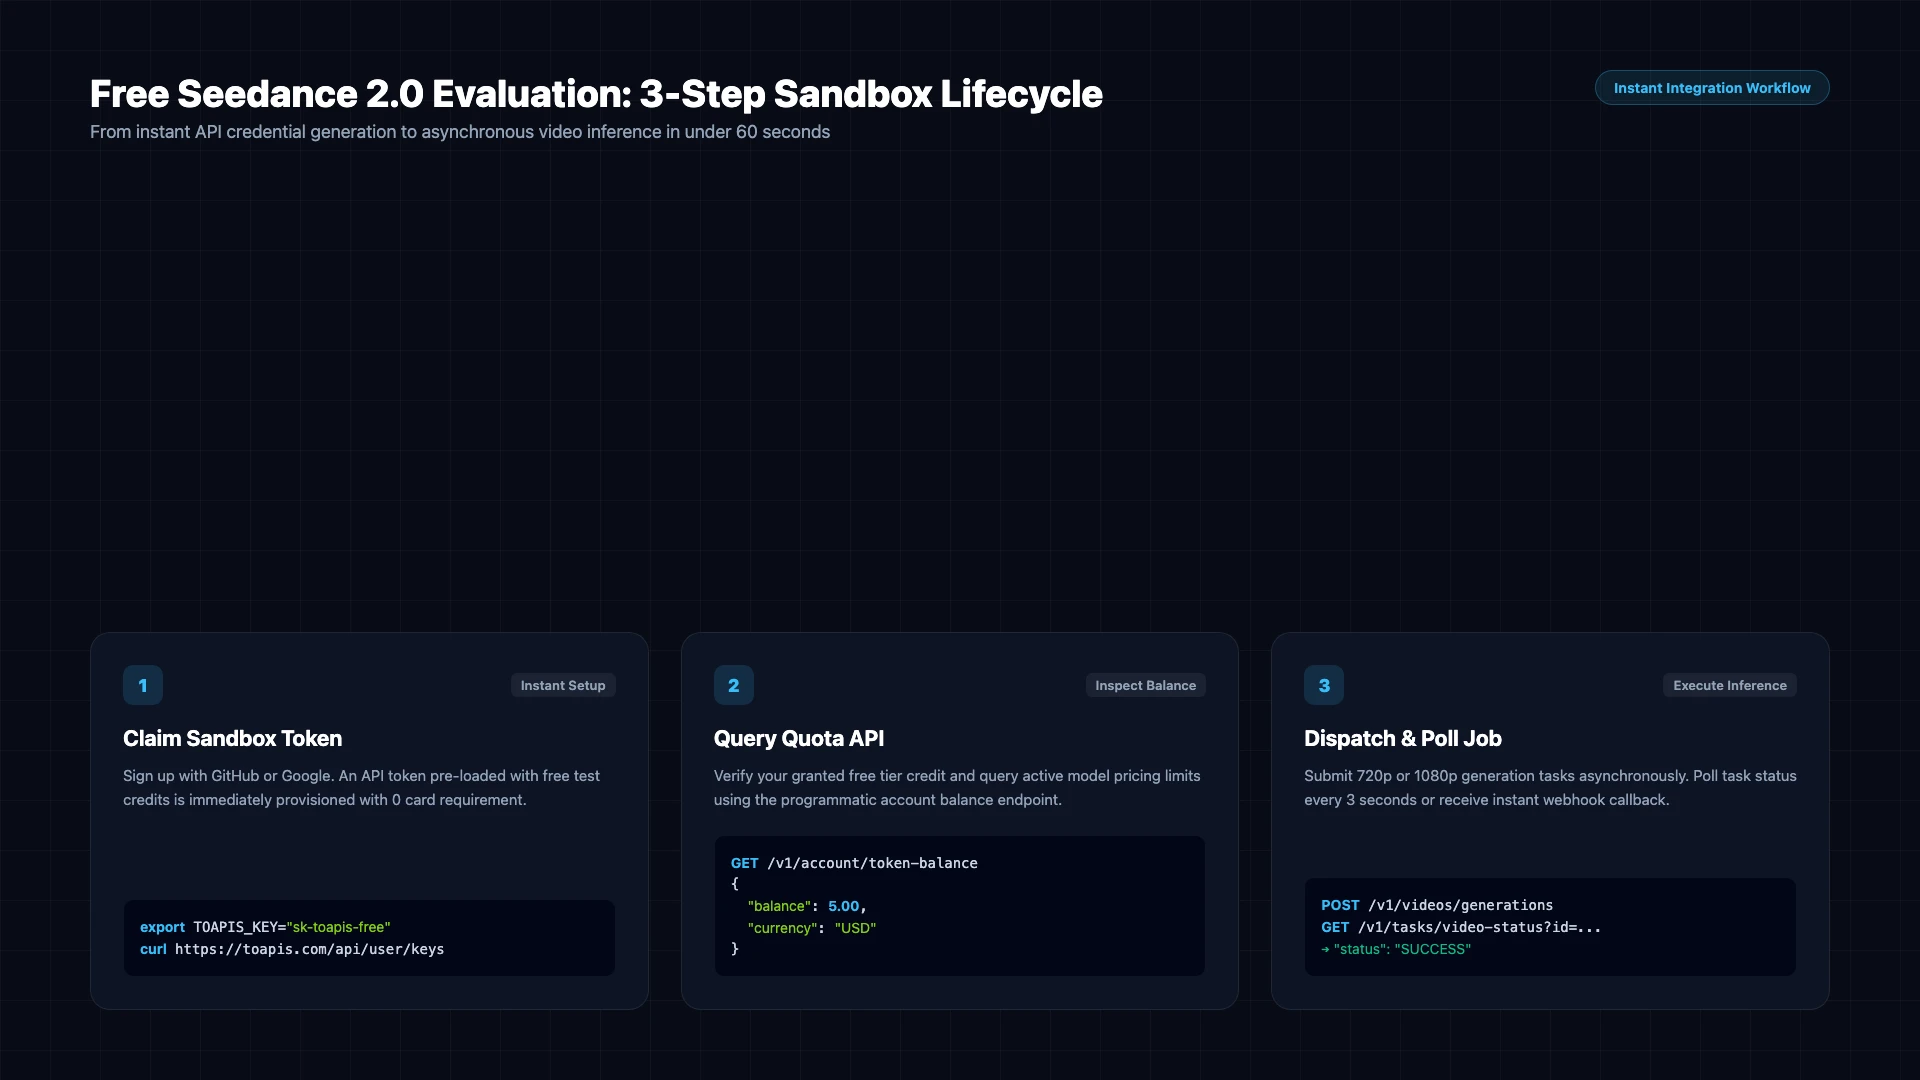
Die Sicherung Ihres kostenlosen Seedance 2.0 API-Schlüssels bei ToAPIs erfordert keine Unternehmensunterlagen, keine Kreditkartensperren und keine Vertragsunterschriften. Der gesamte Onboarding-Prozess dauert weniger als zwei Minuten:
Schritt 1: Erstellen Sie Ihr Entwicklerkonto
Navigieren Sie zur ToAPIs-Entwicklerkonsole. Klicken Sie auf Mit GitHub fortfahren oder geben Sie Ihre Entwickler-E-Mail-Adresse ein.
Neue Entwicklerkonten erhalten nach der E-Mail-Verifizierung automatisch ein Startguthaben für Tests. Es werden keine Kreditkartendaten, Telefonnummern oder Wohnadressen erfasst.
Schritt 2: Generieren Sie Ihren einheitlichen geheimen API-Schlüssel
Nach der Anmeldung im Dashboard navigieren Sie zu Konsole → API-Schlüssel:
- Klicken Sie auf die Schaltfläche + Neuen geheimen Schlüssel erstellen.
- Vergeben Sie ein beschreibendes Label (z. B.
seedance-2-eval-sandbox). - Legen Sie bei Bedarf Ratenlimit- oder Ausgabenwarnungen fest.
- Klicken Sie auf Schlüssel generieren und kopieren Sie Ihre Token-Zeichenkette (im Format
sk-toapis-xxxxxxxxxxxxxxxxxxxxxxxx).
[!IMPORTANT] Ihr geheimer Token wird nur einmal bei der Erstellung angezeigt. Speichern Sie ihn in einem sicheren Passwortmanager oder injizieren Sie ihn direkt in Ihre lokale Shell-Umgebung. Dieser einzelne Schlüssel gewährt einheitlichen Zugang nicht nur zu Seedance 2.0 und Seedance 2.5, sondern auch zu Sora 2, Kling 3.0 Omni und FLUX.1.
Schritt 3: Verifizieren Sie den interaktiven Playground (ohne Code)
Bevor Sie Integrationscode schreiben, verifizieren Sie Ihren Token im interaktiven ToAPIs-Video-Playground:
- Wählen Sie
doubao-seedance-2-0aus dem Modell-Dropdown. - Geben Sie einen Benchmark-Prompt ein:
A cinematic macro shot of dew drops glistening on an emerald monstera leaf at sunrise, soft wind motion, 4k photorealistic, 24fps. - Wählen Sie ein Seitenverhältnis (
16:9Breitbild oder9:16Hochformat). - Klicken Sie auf Video generieren, um die Echtzeit-GPU-Warteschlange, den Rendering-Fortschritt und den fertigen MP4-Stream direkt im Browser zu sehen.
Schritt 4: Exportieren Sie Ihre Umgebungsvariable
Konfigurieren Sie Ihren Schlüssel in Ihrem lokalen Terminal oder Entwicklungscontainer:
# macOS und Linux (zsh / bash)
export TOAPIS_API_KEY="sk-toapis-your-actual-api-key-here"

# Prüfen Sie, ob die Variable gesetzt ist
echo $TOAPIS_API_KEY
Für Windows PowerShell:
$env:TOAPIS_API_KEY="sk-toapis-your-actual-api-key-here"
3. 60-Sekunden-Schnellstart: sofortige Verifizierung über cURL und Python
Da die Videosynthese eine schwere asynchrone Arbeitslast ist, gibt die Seedance 2.0 API keine rohen Videobinärdaten synchron über eine einzelne HTTP-Verbindung zurück. Stattdessen folgt die Inferenzpipeline einem standardmäßigen zweiphasigen Lebenszyklus:
- Task-Übermittlung (
POST /v1/videos/generations): Übermitteln Sie Prompt, Abmessungen und Modellkennung. Das Gateway reiht die Anfrage ein und gibt eine HTTP-202 Accepted-Antwort mit einer eindeutigentask_idzurück. - Task-Polling (
GET /v1/tasks/video-status?task_id={task_id}): Prüfen Sie periodisch den Ausführungsstatus (QUEUED→PROCESSING→SUCCESSoderFAILED). Bei Abschluss enthält die Antwort die sichere CDN-URL des gerenderten MP4-Videos.
┌──────────────────┐               ┌──────────────────────┐               ┌──────────────────────────┐
│ Client-Terminal  │               │ ToAPIs Cloud-Gateway │               │ ByteDance GPU-Farm       │
└────────┬─────────┘               └──────────┬───────────┘               └────────────┬─────────────┘
         │                                    │                                        │
         │ 1. POST /v1/videos/generations     │                                        │
         │    {"model":"doubao-seedance-2-0"} │                                        │
         ├───────────────────────────────────►│ 2. Auftrag in Cluster-Queue geben      │
         │                                    ├───────────────────────────────────────►│
         │ 3. HTTP 202 Accepted               │                                        │
         │    {"task_id": "task_seedance_..."}│                                        │
         │◄───────────────────────────────────┤                                        │
         │                                    │                                        │
         │ 4. 3 Sekunden warten               │                                        │
         │                                    │                                        │
         │ 5. GET /v1/tasks/video-status      │ 6. GPU-Worker-Status abfragen          │
         │    ?task_id=task_seedance_...      ├───────────────────────────────────────►│
         ├───────────────────────────────────►│                                        │
         │ 7. HTTP 200 (PROCESSING, 45%)      │◄───────────────────────────────────────┤
         │◄───────────────────────────────────┤                                        │
         │                                    │                                        │
         │ 8. 3 Sekunden warten               │                                        │
         │                                    │                                        │
         │ 9. GET /v1/tasks/video-status      │ 10. Worker fertig (CDN-Upload)         │
         ├───────────────────────────────────►├───────────────────────────────────────►│
         │ 11. HTTP 200 (SUCCESS, video_url)  │◄───────────────────────────────────────┤
         │◄───────────────────────────────────┤                                        │
3.1 Sofortiger Terminal-Test über cURL
Öffnen Sie Ihr Terminal und fügen Sie den folgenden Befehl ein, um Ihre erste Seedance 2.0-Generierungsaufgabe auszuliefern:
curl -s -X POST "https://api.toapis.com/v1/videos/generations"   -H "Authorization: Bearer $TOAPIS_API_KEY"   -H "Content-Type: application/json"   -d '{
    "model": "doubao-seedance-2-0",
    "prompt": "Cinematische Tracking-Aufnahme eines Astronauten, der über einen biolumineszenten Alien-Strand läuft, neonviolette Wellen brechen sich, hyperrealistisch, flüssige Bewegung in 4k 24fps",
    "aspect_ratio": "16:9",
    "duration": 5,
    "seed": 42
  }'
Erwartete HTTP-202-Übermittlungsnutzlast
Das Gateway antwortet innerhalb von 150 Millisekunden:
{
  "code": 0,
  "message": "Aufgabe erfolgreich eingereiht",
  "data": {
    "task_id": "task_seedance_20261022_9f8a3b1c",
    "status": "PROCESSING",
    "model": "doubao-seedance-2-0",
    "created_at": 1729587600
  }
}
Kopieren Sie die zurückgegebene task_id (task_seedance_20261022_9f8a3b1c), um den Fortschritt manuell zu prüfen:
curl -s -X GET "https://api.toapis.com/v1/tasks/video-status?task_id=task_seedance_20261022_9f8a3b1c" -H "Authorization: Bearer $TOAPIS_API_KEY"
3.2 Produktionsreifes asynchrones Python-Polling-Skript
Für Produktionspipelines ist das Schreiben einer robusten asynchronen Polling-Schleife mit angemessenen Warteintervallen, Timeout-Grenzen und Statusvalidierung unerlässlich.
Speichern Sie den folgenden Code als test_seedance_video.py:
"""
Asynchroner Client für Videogenerierung und Polling der Seedance 2.0 API
Voraussetzung: pip install requests
"""

import os
import sys
import time
import requests

TOAPIS_API_KEY = os.getenv("TOAPIS_API_KEY")
if not TOAPIS_API_KEY:
    print("[FEHLER] Die Umgebungsvariable TOAPIS_API_KEY ist nicht gesetzt.")
    print("Ausführen mit: export TOAPIS_API_KEY='sk-toapis-your-key'")
    sys.exit(1)

BASE_URL = "https://api.toapis.com/v1"
HEADERS = {
    "Authorization": f"Bearer {TOAPIS_API_KEY}",
    "Content-Type": "application/json"
}

def generate_video(prompt: str, duration: int = 5, aspect_ratio: str = "16:9") -> str:
    """Sendet eine asynchrone Videogenerierungsaufgabe und gibt die task_id zurück."""
    url = f"{BASE_URL}/videos/generations"
    payload = {
        "model": "doubao-seedance-2-0",
        "prompt": prompt,
        "aspect_ratio": aspect_ratio,
        "duration": duration,
        "seed": 1024
    }

    print(f"[*] Übermittlung der Videogenerierungsaufgabe an {url}...")
    response = requests.post(url, headers=HEADERS, json=payload, timeout=30)

    if response.status_code not in (200, 201, 202):
        print(f"[!] Aufgabe konnte nicht eingereiht werden. Status: {response.status_code}")
        print(f"[!] Antwort: {response.text}")
        response.raise_for_status()

    resp_data = response.json()
    task_id = resp_data.get("data", {}).get("task_id")
    if not task_id:
        raise ValueError(f"Keine task_id in der Antwort zurückgegeben: {resp_data}")

    print(f"[✔] Aufgabe erfolgreich eingereiht! Task-ID: {task_id}")
    return task_id

def poll_task_status(task_id: str, poll_interval: int = 3, timeout: int = 180) -> dict:
    """
    Fragt den Aufgabenstatus ab, bis SUCCESS oder FAILED erreicht ist.
    Empfohlenes Intervall: 3 Sekunden. Standard-Timeout: 180 Sekunden.
    """
    query_url = f"{BASE_URL}/tasks/video-status"
    start_time = time.time()
    params = {"task_id": task_id}

    print(f"[*] Polling-Start für Aufgabe {task_id} (Intervall={poll_interval}s, max_wait={timeout}s)...")

    while True:
        elapsed = int(time.time() - start_time)
        if elapsed > timeout:
            raise TimeoutError(f"Aufgabe {task_id} hat das maximale Timeout von {timeout} Sekunden überschritten.")

        try:
            resp = requests.get(query_url, headers=HEADERS, params=params, timeout=15)
            resp.raise_for_status()
            data = resp.json().get("data", {})
        except requests.exceptions.RequestException as e:
            print(f"[WARNUNG] Netzwerkfehler bei der Statusabfrage ({e}). Neuer Versuch in {poll_interval}s...")
            time.sleep(poll_interval)
            continue

        status = data.get("status", "UNKNOWN").upper()
        progress = data.get("progress", 0)

        if status in ("SUCCESS", "COMPLETED", "SUCCEEDED"):
            print(f"
[✔] Video erfolgreich in {elapsed}s gerendert!")
            return data
        elif status in ("FAILED", "ERROR"):
            error_msg = data.get("error_message", "Unbekannter Inferenzfehler aufgetreten.")
            raise RuntimeError(f"Videogenerierung fehlgeschlagen: {error_msg}")
        elif status in ("PROCESSING", "RUNNING", "QUEUED"):
            sys.stdout.write(f"
[-] Status: {status} | Fortschritt: {progress}% | Vergangen: {elapsed}s")
            sys.stdout.flush()
        else:
            print(f"
[?] Unerwarteter Status zurückgegeben: {status}")

        time.sleep(poll_interval)

if __name__ == "__main__":
    test_prompt = (
        "Rallyeauto mit Vollgas im Drift durch verschneiten skandinavischen Kiefernwald, "
        "intensive Reifenspritzer, volumetrisches cinematisches Sonnenuntergangslicht, 4k 60fps"
    )

    try:
        t_id = generate_video(prompt=test_prompt, duration=5, aspect_ratio="16:9")
        result = poll_task_status(t_id)

        video_url = result.get("video_url") or result.get("output", {}).get("video_url")
        print("
" + "=" * 60)
        print("🎬 Fertiger Seedance 2.0 Render geliefert:")
        print(f"🔗 Video-URL:     {video_url}")
        print(f"⏱ Dauer:         {result.get('duration', 5)} Sekunden")
        print(f"📐 Auflösung:     {result.get('resolution', '1280x720')}")
        print("=" * 60)
    except Exception as exc:
        print(f"
[FATAL] Ausführung abgebrochen: {exc}")
        sys.exit(1)
Führen Sie das Skript aus:
python3 test_seedance_video.py
Erwartete Terminal-Ausgabe
[*] Übermittlung der Videogenerierungsaufgabe an https://api.toapis.com/v1/videos/generations...
[✔] Aufgabe erfolgreich eingereiht! Task-ID: task_seedance_20261022_9f8a3b1c
[*] Polling-Start für Aufgabe task_seedance_20261022_9f8a3b1c (Intervall=3s, max_wait=180s)...
[-] Status: PROCESSING | Fortschritt: 68% | Vergangen: 21s
[✔] Video erfolgreich in 27s gerendert!

============================================================
🎬 Fertiger Seedance 2.0 Render geliefert:
🔗 Video-URL:     https://cdn.toapis.com/outputs/seedance_20261022_9f8a3b1c.mp4
⏱ Dauer:         5 Sekunden
📐 Auflösung:     1280x720
============================================================
Endgültige HTTP-200-Erfolgsnutzlast
{
  "code": 0,
  "message": "Aufgabe erfolgreich abgeschlossen",
  "data": {
    "task_id": "task_seedance_20261022_9f8a3b1c",
    "status": "SUCCESS",
    "model": "doubao-seedance-2-0",
    "video_url": "https://cdn.toapis.com/outputs/seedance_20261022_9f8a3b1c.mp4",
    "duration": 5,
    "resolution": "1280x720",
    "cost": 0.14,
    "metrics": {
      "queue_time_ms": 1420,
      "inference_time_ms": 25800,
      "total_time_ms": 27220
    }
  }
}
3.3 Asynchrones Polling-Beispiel in Node.js / TypeScript
Für Teams, die auf Next.js, Node.js-Mikroservices oder Edge Workers aufbauen, folgt hier die äquivalente moderne TypeScript-Implementierung mit standardmäßigem fetch:
import process from "node:process";

const API_KEY = process.env.TOAPIS_API_KEY;
if (!API_KEY) {
  console.error("TOAPIS_API_KEY fehlt in den Umgebungsvariablen.");
  process.exit(1);
}

const BASE_URL = "https://api.toapis.com/v1";

interface TaskResponse {
  task_id: string;
  status: "QUEUED" | "PROCESSING" | "SUCCESS" | "FAILED";
  video_url?: string;
  error_message?: string;
  duration?: number;
}

async function runSeedanceGeneration() {
  // 1. Videogenerierungsauftrag senden
  console.log("[*] Übermittlung der Seedance 2.0 Generierungsaufgabe...");
  const dispatchRes = await fetch(`${BASE_URL}/videos/generations`, {
    method: "POST",
    headers: {
      Authorization: `Bearer ${API_KEY}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      model: "doubao-seedance-2-0",
      prompt: "Drohnenaufnahme der Küstenklippen von Amalfi in der Dämmerung, türkisfarbenes Wasser, warmes Villenlicht, 4k 30fps",
      aspect_ratio: "16:9",
      duration: 5,
    }),
  });

  if (!dispatchRes.ok) {
    const errText = await dispatchRes.text();
    throw new Error(`Versand fehlgeschlagen (${dispatchRes.status}): ${errText}`);
  }

  const dispatchData = await dispatchRes.json();
  const taskId = dispatchData.data?.task_id;
  console.log(`[✔] Aufgabe erstellt: ${taskId}`);

  // 2. Aufgabenstatus abfragen
  const startTime = Date.now();
  const maxWaitMs = 180_000;

  while (Date.now() - startTime < maxWaitMs) {
    await new Promise((resolve) => setTimeout(resolve, 3000));

    const pollRes = await fetch(`${BASE_URL}/tasks/video-status?task_id=${taskId}`, {
      headers: { Authorization: `Bearer ${API_KEY}` },
    });

    if (!pollRes.ok) {
      console.warn(`[!] Polling-Wiederholung wegen HTTP ${pollRes.status}`);
      continue;
    }

    const payload = await pollRes.json();
    const task: TaskResponse = payload.data;

    console.log(`[-] Polling-Status: ${task.status} (${Math.round((Date.now() - startTime) / 1000)}s)`);

    if (task.status === "SUCCESS") {
      console.log(`
🎉 Generierung abgeschlossen!`);
      console.log(`🔗 Video-Stream: ${task.video_url}`);
      return task.video_url;
    }

    if (task.status === "FAILED") {
      throw new Error(`Video-Rendering fehlgeschlagen: ${task.error_message || "Unbekannter Fehler"}`);
    }
  }

  throw new Error("Aufgabe nach 180 Sekunden in Timeout gelaufen.");
}

runSeedanceGeneration().catch((err) => {
  console.error("[FATAL]", err.message);
  process.exit(1);
});
4. Kontostands-API, FinOps-Tracking und Kontingentplanung
Ein disziplinierter FinOps-Workflow erfordert eine automatisierte Kontostandsprüfung, bevor ressourcenintensive Testchargen gestartet werden. ToAPIs bietet einen dedizierten leichtgewichtigen Endpunkt, um verbleibende Guthaben, Kontostatus und Währungssalden programmatisch abzufragen.
4.1 Programmatische Prüfung des Token-Guthabens
Fragen Sie Ihr Live-Entwicklerguthaben über GET /v1/account/token-balance ab:
import os
import requests

API_KEY = os.getenv("TOAPIS_API_KEY")

response = requests.get(
    "https://api.toapis.com/v1/account/token-balance",
    headers={"Authorization": f"Bearer {API_KEY}"},
    timeout=10
)
response.raise_for_status()

account_data = response.json().get("data", {})
balance = account_data.get("balance", 0.0)
currency = account_data.get("currency", "USD")
status = account_data.get("status", "ACTIVE")

print(f"[*] Kontostatus:          {status}")
print(f"[*] Verfügbares Guthaben: ${balance:.4f} {currency}")
print(f"[*] Parallelitätslimit:   {account_data.get('max_concurrency', 5)} aktive Aufgaben")
Erwartete Guthaben-Antwortnutzlast
{
  "code": 0,
  "message": "Erfolg",
  "data": {
    "account_id": "acc_dev_882910a",
    "status": "ACTIVE",
    "currency": "USD",
    "balance": 1.5000,
    "frozen_balance": 0.0000,
    "max_concurrency": 5,
    "tier": "DEVELOPER_TRIAL"
  }
}
4.2 Planung des Startguthaben-Kontingents: Wie viele Videos können Sie testen?
Um den Wert Ihres kostenlosen Seedance 2.0 API-Schlüssels zu maximieren, planen Sie Ihre Testläufe entsprechend den Modellspezifikationen und Auflösungsstufen. Anders als Anbieter, die die Leerlauf-Startzeit von GPU-Containern berechnen, rechnet ToAPIs strikt die generierten Ausgabesekunden ab. Fehlgeschlagene oder abgebrochene Aufgaben ziehen genau $0.00 ab.
Die Stückökonomie von Seedance 2.0 wird bestimmt durch:
- Ausgabevideodauer: Standard 5 Sekunden; erweiterbar bis 10 Sekunden.
- Pixelauflösung: 720p-Grundtarif versus 1080p-Hochauflösungstarif.
- Modell-Checkpoint: Standard
seedance-2.0versus Hochgeschwindigkeitseedance-2-miniversus nächste Generationseedance-2.5.
| Modellspezifikation | Auflösung | Effektiver Tarif / s | Kosten für einen 5-s-Clip | Kosten für einen 10-s-Clip | Testertrag mit 1.50 $ Startguthaben |
|---|---|---|---|---|---|
| Seedance 2.0 Mini | 720p (1280x720) | $0.018 / s | $0.090 | $0.180 | ~16 vollständige Videoclips |
| Seedance 2.0 Standard | 720p (1280x720 / 720x1280) | $0.028 / s | $0.140 | $0.280 | ~10 vollständige Videoclips |
| Seedance 2.0 Standard | 1080p Full HD (1920x1080) | $0.048 / s | $0.240 | $0.480 | ~6 vollständige Videoclips |
| Seedance 2.5 Pro | 720p (1280x720) | $0.038 / s | $0.190 | $0.380 | ~7 vollständige Videoclips |
| Seedance 2.5 Pro | 1080p Full HD (1920x1080) | $0.065 / s | $0.325 | $0.650 | ~4 vollständige Videoclips |
[!TIP] Empfohlene Evaluierungsstrategie: Führen Sie Prompt-Engineering-Iterationen und die Ausrichtung des Seitenverhältnisses auf Seedance 2.0 Mini oder Seedance 2.0 720p durch. Sobald Ihre Kamerabewegungs-Prompts und negativen Constraints finalisiert sind, wechseln Sie zu 1080p oder Seedance 2.5 Pro für die Produktion von Hero-Assets.
4.3 Marktpreisvergleich: offizieller Direktvertrieb versus ToAPIs-Gateway
Wenn Teams von vorläufigen Tests in die kommerzielle Produktion übergehen, ist der Vergleich langfristiger Stückkosten entscheidend. Der folgende Benchmark zeigt die Kostendifferenz zwischen Direktverträgen und der Großhandelsaggregation von ToAPIs:
| Evaluierungsdimension | Offizieller Enterprise-Direktvertrieb (ByteDance) | ToAPIs einheitliches Gateway | Nutzen für Entwickler |
|---|---|---|---|
| Vorab-Onboarding-Einzahlung | 500 bis 5.000 $ verpflichtend | $0.00 (kostenloses Startguthaben) | Sofortige reibungslose Sandbox |
| Kreditkartenpflicht | Firmenkarte chinesisches Festland oder SWIFT | Keine (unterstützt Krypto, PayPal, Stripe) | Umgeht Bankablehnungen |
| Mindestaufladung | 500 $ pro Vertragszyklus | $1.00 (Pay-as-you-go) | Null Kapitalbindung |
| Seedance 2.0 720p Kosten / s | $0.045 / s | $0.028 / s | 37.7 % direkte Ersparnis |
| Seedance 2.0 1080p Kosten / s | $0.075 / s | $0.048 / s | 36.0 % direkte Ersparnis |
| Garantie bei fehlgeschlagener Inferenz | Rückerstattung über manuelles Support-Ticket | Automatischer Abzug von $0.00 | Null verschwendetes Rechenbudget |
| Startuntergrenze der Parallelität | 1 bis 2 parallele Streams | 5 parallele Streams (elastische Skalierung) | 2.5x höherer Testdurchsatz |
Monatliche Kostenersparnisberechnung
Betrachten Sie eine Produktionsanwendung, die monatlich 4.000 5-Sekunden-Videoclips in 720p generiert:
Durch den Wechsel zu ToAPIs erzielen Entwicklungsteams eine sofortige Reduktion der Cloud-Rechenkosten um 37.7 % bei null Infrastrukturaufwand.
5. Produktions-Engineering: Ratenbegrenzung, Parallelität und Hochverfügbarkeit
Die Überführung generativer Videopipelines in automatisierte, nutzerseitige Umgebungen erfordert robustes defensives Engineering. Anders als Text-Chat-Anwendungen halten Videoaufgaben GPU-Worker-Zuweisungen für 20 bis 50 Sekunden. Wenn eingehender Verkehr ohne Schutz ansteigt, löst Ihr Backend HTTP 429 Too Many Requests aus.
┌───────────────────────────────────────────────────────────────────────────────────────┐
│                                PRODUKTIONS-SCHUTZMATRIX                               │
├─────────────────────┬───────────────────────────────┬─────────────────────────────────┤
│ Fehlerfall          │ Ursache                       │ Architektonische Gegenmaßnahme  │
├─────────────────────┼───────────────────────────────┼─────────────────────────────────┤
│ HTTP 429 Fehler     │ Konto-Parallelität zu hoch    │ Exponentielles Backoff + Jitter │
│ HTTP 504 Timeout    │ Synchrone Verbindung blockt   │ Asynchroner Polling-Zyklus      │
│ Upstream-Queue-Stau │ Regionale Cluster-Lastspitze  │ Dynamischer Modell-Fallback     │
│ Payload-Fehler      │ Ungültiges Seitenverhältnis   │ JSON-Schema-Prüfung im Client   │
└─────────────────────┴───────────────────────────────┴─────────────────────────────────┘
5.1 Umgang mit HTTP 429 durch exponentielles Backoff und zufälligen Jitter
Versuchen Sie beim Aufbau von Queue-Dispatchern niemals, in einem festen Intervall zu wiederholen (z. B. jede Sekunde). Feste Wiederholungen verursachen „Thundering Herd"-Spitzen, die Queue-Blockaden verlängern. Setzen Sie stattdessen einen exponentiellen Backoff-Algorithmus mit zufälligem dekorreliertem Jitter ein:
import time
import random
import requests

def dispatch_with_backoff(payload: dict, max_retries: int = 5) -> dict:
    url = "https://api.toapis.com/v1/videos/generations"
    headers = {
        "Authorization": f"Bearer {os.getenv('TOAPIS_API_KEY')}",
        "Content-Type": "application/json"
    }

    base_delay = 2.0  # anfängliche Wartezeit in Sekunden
    max_delay = 30.0

    for attempt in range(1, max_retries + 1):
        try:
            response = requests.post(url, headers=headers, json=payload, timeout=30)

            if response.status_code == 200 or response.status_code == 202:
                return response.json()

            if response.status_code == 429:
                # Exponentielle Wartezeit mit zufälligem Jitter berechnen
                jitter = random.uniform(-0.5, 0.5)
                delay = min(max_delay, (base_delay * (2 ** (attempt - 1)))) + jitter
                delay = max(1.0, delay)
                print(f"[!] Ratenlimit 429 erreicht. Versuch {attempt}/{max_retries}. Backoff für {delay:.2f}s...")
                time.sleep(delay)
                continue

            response.raise_for_status()

        except requests.exceptions.RequestException as e:
            print(f"[WARNUNG] Verbindungsfehler bei Versuch {attempt}: {e}")
            time.sleep(base_delay)

    raise RuntimeError(f"Aufgabenversand nach {max_retries} Versuchen wegen anhaltendem Ratenlimit fehlgeschlagen.")
5.2 Dynamische Multi-Modell-Fallback-Strategie
In Produktionssystemen mit strengen Service Level Objectives (SLOs) kann die Abhängigkeit von einem einzigen Upstream-Modellcluster zu Ausfallzeiten in Spitzenverkehrsstunden führen. Da ToAPIs über mehrere Videogenerierungsanbieter hinweg eine einheitliche Payload-Formatierung beibehält, können Sie mit minimalem Code ein nahtloses Modell-Fallback implementieren:
FALLBACK_CASCADE = [
    "doubao-seedance-2-0",       # Primäres Produktionsmodell
    "doubao-seedance-2-0-mini",  # Schneller Fallback mit hohem Durchsatz
    "kling-3-omni"               # Anbieterübergreifender Hochverfügbarkeits-Fallback
]

def dispatch_resilient_generation(prompt: str, aspect_ratio: str = "16:9") -> dict:
    headers = {
        "Authorization": f"Bearer {os.getenv('TOAPIS_API_KEY')}",
        "Content-Type": "application/json"
    }

    for model_name in FALLBACK_CASCADE:
        print(f"[*] Versandversuch mit Engine: {model_name}...")
        payload = {
            "model": model_name,
            "prompt": prompt,
            "aspect_ratio": aspect_ratio,
            "duration": 5
        }

        try:
            res = requests.post(
                "https://api.toapis.com/v1/videos/generations",
                headers=headers,
                json=payload,
                timeout=25
            )

            if res.status_code in (200, 201, 202):
                data = res.json()
                print(f"[✔] Erfolgreich auf Engine {model_name} eingereiht (Task-ID: {data['data']['task_id']})")
                return data

            print(f"[!] Engine {model_name} antwortete mit Status {res.status_code}. Weiter zum nächsten Kandidaten...")
        except requests.exceptions.RequestException as err:
            print(f"[!] Netzwerkfehler bei {model_name}: {err}. Weiter zum Fallback...")

    raise SystemError("Kritischer Fehler: Alle Video-Generierungs-Engines der Kaskade erschöpft.")
6. Häufig gestellte Fragen (Entwickler-FAQ)
F1: Ist eine Vorautorisierung per Kreditkarte oder Bankkonto erforderlich, um Seedance 2.0 zu testen?
Nein. Entwickler können sich bei ToAPIs über GitHub OAuth oder eine E-Mail-Adresse registrieren. Neue Konten erhalten sofort Willkommensguthaben für Tests. Sie müssen weder eine inländische noch eine ausländische Kreditkarte hinterlegen, Bankdaten eingeben oder ein Unternehmens-KYC durchlaufen, um die Seedance 2.0-Generierung zu evaluieren.
F2: Wie behandelt die Seedance 2.0 Video-API fehlgeschlagene Generierungen?
ToAPIs betreibt eine strikte Nur-Erfolg-Abrechnungsrichtlinie. Wenn eine Inferenzaufgabe mit dem Status FAILED endet, upstream abläuft oder vor Beginn des Renderings abgebrochen wird, werden genau $0.00 von Ihrem Konto abgebucht. Guthaben werden nur berechnet, wenn eine vollständige, abspielbare MP4-URL generiert und geliefert wurde.
F3: Wie hoch ist die durchschnittliche Generierungslatenz für ein 5-Sekunden-Video?
Für einen 5-Sekunden-Clip in 720p auf doubao-seedance-2-0 liegt die durchschnittliche Inferenzzeit je nach Tiefe des globalen GPU-Clusters zwischen 22 und 45 Sekunden. Die P95-Latenz bleibt unter 60 Sekunden. Für beschleunigtes Rendering liefert doubao-seedance-2-0-mini fertige Clips in 14 bis 20 Sekunden.
F4: Kann ich Image-to-Video (I2V) und Reference-to-Video (R2V) in der kostenlosen Testphase ausprobieren?
Ja. Der kostenlose Test-API-Schlüssel gewährt vollen Zugriff auf alle Seedance 2.0-Funktionen. Sie können Keyframe-Bilder über öffentliche HTTPS-URLs oder Base64-Datenstrings mit dem Parameter image_url in der Nutzlast Ihrer POST /v1/videos/generations-Anfrage übermitteln.
7. Aktionscheckliste: Skalierung von der Sandbox in die Produktion
- 🚀 Fordern Sie Ihren kostenlosen Seedance 2.0 API-Schlüssel an: Registrieren Sie sich über GitHub oder E-Mail, um Ihr Willkommensguthaben für Tests sofort zu aktivieren.
- ⚡ Erkunden Sie den interaktiven Playground: Benchmarken Sie Prompt-Treue, Kameraschwenks und Bewegungsstabilität, ohne eine einzige Codezeile zu schreiben.
- 📖 Lesen Sie den vollständigen Schnellstartleitfaden: Tauchen Sie tiefer in Webhook-Callbacks, benutzerdefinierte Kamerabahnen und feingranulare Bildratensteuerung ein.
- 📊 Vergleichen Sie die Preise von Seedance 2.0 vs. 2.5: Analysieren Sie Kosten pro Sekunde gegenüber der Auflösung, bevor Sie in die Massenproduktion skalieren.