
在把 GPT-6.2 API 整合視為模型名稱變更之前,先將其視為契約驗證任務。 使用報告中的標籤可能很有趣,但它不會告訴你應用程式可以傳送哪個請求、哪個帳戶有權傳送,或產生的工作成本是多少。眼前的工程問題,是避免部署在設定檔中看似正確,卻在供應商邊界失敗。
檢視日期:2026 年 11 月 4 日。 本文檢視了兩篇 APIYI 競品文章,日期為 11 月 2 日與 11 月 3 日。它們對推出情況的描述、截圖與示範歸因都是第三方報告。研究環境中直接請求官方 OpenAI 模型目錄與 API 變更日誌時回傳 HTTP 403。因此,我們不把這種被阻擋的存取視為存在或不存在的證據。我們未進行已驗證的 GPT-6.2 推理、取得報價,也未獨立驗證來源截圖。
概念圖:推出線索、契約驗證與整合準備是不同階段,不代表官方發布或模型實測輸出。
1. GPT-6.2 推出報告:它們能確立什麼
APIYI 的推出分析描述了 Codex 使用檢視中所謂的 gpt-6.2-astra 項目、不同的推出比例、一段回應片段與 CLI 實驗。文章也討論缺少官方確認,以及依賴 CLI 參數的薄弱性。這些是有用的研究線索。它們不是 ToAPIs 文章團隊所作的觀察,本指南也不會把所報導的百分比重現為已驗證的遙測資料。
重要的區分,在於某個名稱出現在某處,與穩定的產品契約之間。內部別名可能在公開可選之前就被記錄。用戶端可能在伺服器驗證字串之前就接受它。供應商對不同帳戶的路由可能不同。這些可能性都不能決定 GPT-6.2 的實際行為;它們說明了為什麼單張截圖仍會留下重要問題。
| 證據 | 可支持的內容 | 仍需驗證的內容 |
|---|---|---|
| 引用使用截圖的競品文章 | 某項主張在特定日期被發布 | 原始情境、真實性、帳戶範圍與可重複性 |
| CLI 接受模型參數 | 本機用戶端接受了一個字串 | 伺服器支援、授權與實際回應身分 |
| 帶有模型欄位的已完成回應 | 該請求回傳了一個被報導的識別碼 | 別名行為、文件化保證、計費與可用性 |
| 帶有模型標籤的公開示範 | 創作者將某項成果歸因於該標籤 | 完整輸入、工具、嘗試次數、設定與獨立重現 |
| 供應商文件加上獲准的請求 | 特定文件化帳戶路徑可運作 | 操作限制、持續可用性與支援條款 |
謹慎回答 GPT-6.2 的發布日期時,應指出來源與範圍。社群預測是預測;公告是公告;API 存取測試只確立該帳戶當時能做什麼。當三者日期不同時,全部保留。不要把「我們無法驗證」轉化為「它不可能存在」,也不要把競品標題轉化為官方發布通知。
概念圖:截圖、CLI 輸入、文件與請求紀錄各有不同證據範圍,不能互相替代。
2. 先建立離線評估套件
在模型可用性尚未確定前,你仍可準備有用的整合工作。先從一小組具代表性的任務與明確的接受規則開始。能寫出令人印象深刻的一次性示範的模型,仍可能漏掉必要的 JSON 欄位,或在你的工作流程中做出不安全的工具選擇。預先定義這些失敗,可防止評估偏向看起來最精緻的輸出。
下面的 Python 3 範例只使用標準函式庫。將它儲存在空的工作目錄中,然後在本機執行。它建立三個案例與一筆刻意留空的契約紀錄。它不會呼叫任何供應商、不需要金鑰,也不宣稱 GPT-6.2 支援這些任務。空白的 model 欄位是刻意的:只有在檢查你實際選擇之供應商的文件化識別碼與存取權後,才替換它。
import json
from pathlib import Path

cases = [
    {
        "id": "structured-01",
        "task": "structured_output",
        "prompt": "Extract item and quantity from: Please order 3 blue mugs.",
        "expected": {"item": "blue mugs", "quantity": 3},
        "checks": ["valid JSON", "exact keys", "integer quantity"],
    },
    {
        "id": "code-01",
        "task": "coding",
        "prompt": "Implement clamp(x, low, high); reject low greater than high.",
        "checks": ["boundary tests", "invalid bounds", "no network access"],
    },
    {
        "id": "tool-01",
        "task": "tool_selection",
        "prompt": "Check order status; no order ID was supplied.",
        "checks": ["ask for order ID", "do not invent an ID", "no write tool"],
    },
]
contract = {
    "provider": None,
    "documented_model_id": None,
    "request_documentation_url": None,
    "access_checked_at": None,
    "billing_unit": None,
}
Path("evaluation-cases.jsonl").write_text(
    "".join(json.dumps(case, ensure_ascii=False) + "\n" for case in cases),
    encoding="utf-8",
)
Path("provider-contract.json").write_text(
    json.dumps(contract, indent=2) + "\n", encoding="utf-8"
)
print(f"Prepared {len(cases)} offline cases; provider contract remains unverified.")
使用應用程式的真實失敗模式擴充這些範例,並移除機密輸入。加入能保護既有行為的簡單案例,以及能區分候選模型的困難案例。將提示、參考答案、結構與測試環境一起版本化。如果在一次執行中變更預期答案,請開始新的評估版本,不要默默編輯通過率。
對程式設計而言,接受測試是在具備預期語言與相依套件的隔離環境中執行。閱讀看似合理的修補不足以完成驗證。對結構化擷取而言,同時驗證結構與意義:語法有效的 JSON 仍可能包含捏造值。對工具而言,檢查參數有效性、授權,以及提出澄清問題是否為正確行動。無論 GPT-6.2 何時可用,這些檢查都很有價值。
3. 為什麼 GPT-6.2 與 Fable 5.5 的示範無法排列模型排名
第二篇 APIYI 文章《Fable 5.5 與 GPT-6.2 Astra》整理了數個公開示範,並明確指出任務不同。文章描述多項歸因於 Fable 5.5 的作品,以及一個歸因於 GPT-6.2 的像素動畫示範。在本次檢視中,這些歸因仍是創作者或競品的主張。我們未重現成果,也未驗證服務中的模型。
遊戲、短片與動畫是不同的工作負載。它們可見的品質能幫你發現值得測試的任務,但不能提供成功率、延遲或成本的共同分母。嘗試次數也很重要。選中的成功成果既不會揭示失敗次數,也不會揭示產出它所需的人工修復量。
公平比較應在執行前固定任務、輸入、可用工具、時間限制、輸出約束與重試政策。每次嘗試都記錄文件化模型識別碼與推理設定。當模型不支援所要求的功能時,明確報告該限制;不要默默給予額外工具或不同約束,使表格看起來完整。匹配的操作預算通常比假裝每個供應商都暴露相同參數更有用。
需要人類判斷時,使用盲評。只提供任務與接受評分規範,不提供模型標籤給評審。記錄分歧並在給出最終分數前檢查。重複非確定性任務,保留分布而不只是最佳輸出。小型試點可以揭露整合錯誤,但不應變成 GPT-6.2 在程式設計、推理或代理工作上普遍更好的廣泛主張。
概念圖:公平評估需固定任務、工具與預算;圖中沒有實測結果或模型排名。
4. 在 API 邊界驗證身分、工具與失敗行為
一旦供應商文件化 GPT-6.2 存取權,先進行小型且唯讀的首次獲准測試。保存文件 URL、檢查日期、帳戶範圍與精確的請求識別碼。分開記錄回應識別碼,不要覆寫請求標籤。如果供應商支援別名,記錄它如何描述別名的穩定性,以及是否可用固定版本。回傳名稱是有用的診斷證據,不是對底層模型權重的獨立保證。
| 契約欄位 | 要記錄的內容 | 接受問題 |
|---|---|---|
| 請求介面 | 端點、SDK 版本與文件化模型識別碼 | 這個精確組合受到支援嗎? |
| 帳戶存取 | 供應商、區域、專案與權限範圍 | 預定的正式環境帳戶有存取權嗎? |
| 輸出契約 | 串流、結構行為、完成與使用量欄位 | 應用程式能辨識完整且有效的結果嗎? |
| 工具契約 | 支援的工具、參數結構與授權邊界 | 應用程式能拒絕無效或未授權呼叫嗎? |
| 失敗契約 | 錯誤類別、重試指引與取消行為 | 失敗能在不重複操作的情況下終止嗎? |
| 計費契約 | 輸入、輸出、快取及任何額外計費單位 | 觀察到的請求能與帳單核對嗎? |
不要假設熟悉的 SDK 會讓每個選項都可攜。推理設定、結構化輸出模式、上下文限制、串流事件與工具語意都需要按版本驗證。本文未提供 GPT-6.2 端點或 SDK 呼叫,因為目前沒有任何一項在此獨立確立。契約驗證後,加入一個附帶範圍與日期的最小化測試請求,不要猜測新的模型字串來改寫舊範例。
逾時與重試值得單獨接受測試。用戶端逾時不代表伺服器執行已停止。中斷的串流可能包含不完整的工具呼叫。速率限制應導向供應商文件化的重試政策與有界重試預算,而不是無限迴圈。區分暫時容量錯誤、無效輸入、缺少存取權與不支援的模型;只重試適合重試的類別。
讓外部副作用受到應用程式授權控制。模型產生的付款、檔案刪除或外發訊息,絕不能僅因工具呼叫格式正確就執行。使用唯讀評估工具、一次性測試資料與可稽核的核准流程(產品需要時)。這是應用程式設計責任;這不是 GPT-6.2 具備特定安全性或工具能力的主張。
對可觀測性而言,儲存請求 ID、時間戳記、完成狀態、使用量總計與經過清理的錯誤類別。避免保留金鑰或不必要的客戶內容。讓評估日誌足夠具體,能診斷回歸;同時限制內容,以符合你自己的資料規則。如果回傳識別碼或行為意外改變,暫停推進並調查,不要把新結果與先前基線合併。
5. GPT-6.2 定價:計算每個接受任務的成本
本次檢視未確立任何已確認的 GPT-6.2 定價。傳聞文章、不同版本或訂閱方案中的數字,不是經驗證的 API 報價。定價有文件後,檢查貨幣、計費單位、生效日期、區域與供應商。如果所選供應商對快取輸入、輸出、推理相關用量、工具執行與最低收費分開計費,可能需要分別處理。請驗證這些類別,而不要假定它們存在或不存在。
對應用程式而言,有用的分母通常是已接受任務。把每次嘗試的所有適用費用相加,包括若有計費的失敗或拒絕輸出,再除以通過接受評分規範的數量。除非你有可測量且一致的方法納入,否則將人工修復成本分開。即使名義 token 費率較低,只要重試或不可用結果增加,也可能讓已接受工作更昂貴。
以下獨立腳本用虛構費率示範算術。它不是 GPT-6.2 的價格估算,也不代表 ToAPIs 或 OpenAI 的計費。請與第一個範例分開執行;它唯一的輸出是小型 JSON 摘要。費率、工作負載與接受數量都刻意在程式碼中宣告,讓評審能檢查假設。
import json

input_tokens = 1_000_000
output_tokens = 200_000
input_rate_per_million = 2.00  # Hypothetical USD rate
output_rate_per_million = 8.00  # Hypothetical USD rate
billed_attempts = 100
accepted_tasks = 80
assert 0 < accepted_tasks <= billed_attempts

total = (
    input_tokens / 1_000_000 * input_rate_per_million
    + output_tokens / 1_000_000 * output_rate_per_million
)
print(json.dumps({
    "scenario": "hypothetical, not a provider quote",
    "billed_attempts": billed_attempts,
    "accepted_tasks": accepted_tasks,
    "total_usd": round(total, 4),
    "usd_per_accepted_task": round(total / accepted_tasks, 4),
}, indent=2))
| 假設情境 | 總計費支出 | 接受任務 | 每個接受任務的成本 |
|---|---|---|---|
| 範例 A | $3.60 | 80 | $0.045 |
| 相同支出,較低接受率 | $3.60 | 60 | $0.060 |
| 較高支出,較高接受率 | $4.00 | 90 | 約 $0.0444 |
此表說明品質如何改變經濟性。它不能確立哪個模型的真實成本最低,因為背後沒有匹配的推理執行。在實際 GPT-6.2 評估中,將原始嘗試數、計費用量、重試政策與拒絕原因和總額一併記錄。分開報告延遲:首個 token 時間、完成時間與獲得接受任務答案的時間回答不同問題。說明測量是否包含網路開銷、工具工作與重試。
6. 透過明確的遷移門檻推進
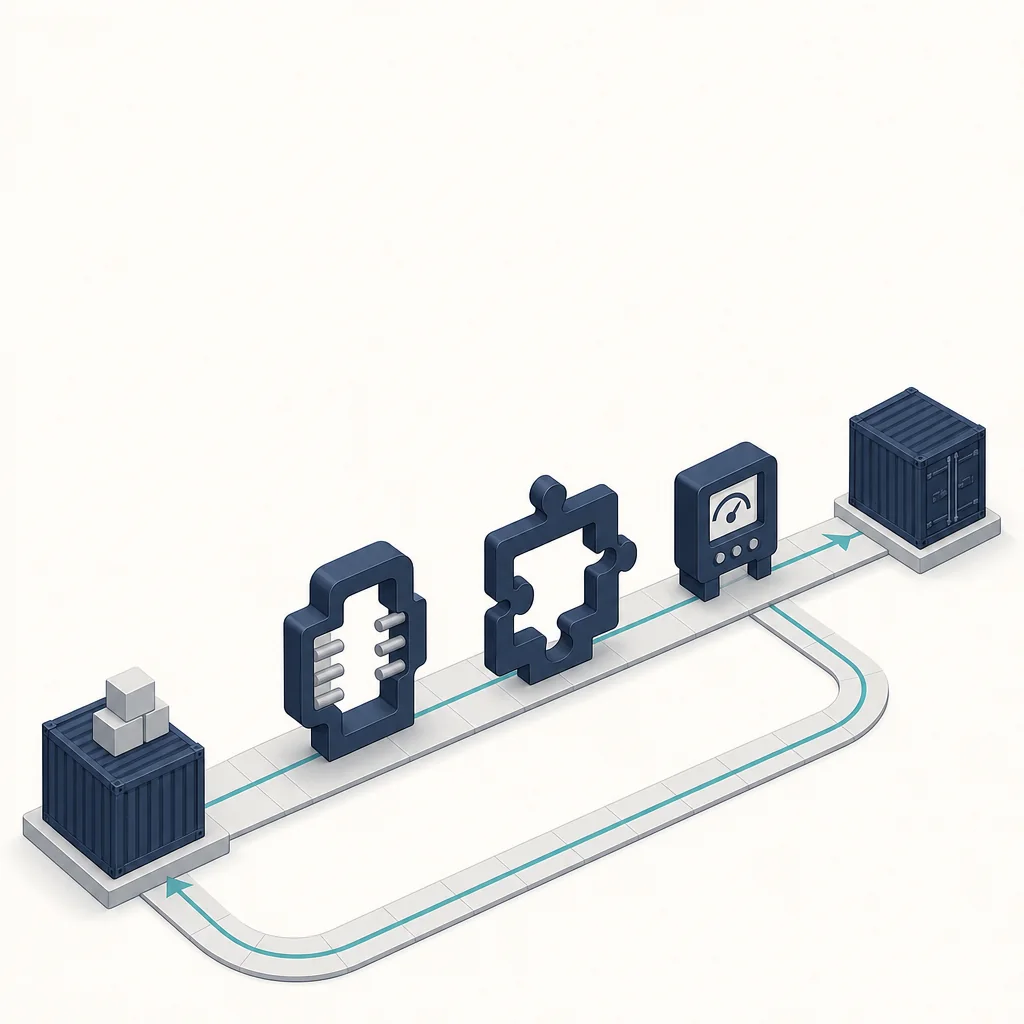
概念圖:通過契約、品質與操作檢查後才進入受限試行,並保留回復路徑。
準備候選適配器時,保留目前運作的模型作為基線。設定應區分評估標籤與實際文件化的供應商識別碼。將未驗證候選項目放在正式環境允許清單之外。這能讓團隊準備 GPT-6.2 評估,而不會意外把客戶流量送到猜測的別名。
使用三道門檻。第一,契約門檻確認支援的請求、預定帳戶存取權、限制與計費。第二,品質門檻使用相同評分規範與預算比較固定的評估集。第三,操作門檻檢查延遲、失敗處理、隱私設定、監控與回滾。通過一道門檻不能補償另一道的失敗:漂亮的示範無法修復不支援的請求結構,低成本也無法修復無效的工具操作。
只有在這些檢查完成後,小型且明確有界的試點才應接收適當流量。在開始前定義試點停止條件,包括錯誤激增、接受率降低、身分意外變更與預算超支。將回滾置於應用程式控制之下。備援必須保留使用者可見契約;如果備援無法滿足必要輸出或隱私限制,應呈現受控失敗,而不是默默替換成不相容行為。
使用模型目錄、定價頁面與 API 文件檢查目前支援的整合路徑。這些連結是驗證入口,不代表 GPT-6.2 一定列出或可存取。不要僅根據本指南購買或遷移。有用的發布更新應加入精確文件、測試範圍與剩餘限制,讓讀者能重現決策。
7. 開發者正在提出的 GPT-6.2 問題
GPT-6.2 API 現在可用嗎?
本次檢視不確立公開 API 可用性或 ToAPIs 支援。競品文章討論所謂 Codex 推出痕跡,其存取路徑可能不同於公開 API。請檢查供應商文件與預定帳戶的授權。研究環境無法擷取官方頁面,不代表不存在;本文也沒有聲稱不存在任何私有部署。
CLI 模型名稱能確認底層模型嗎?
不能。用戶端接受參數只確立本機輸入被接受。回傳的模型欄位增加了關於特定回應的證據,但別名與供應商保證仍需文件支持。記錄完整測試條件,但不要記錄機密。不要鼓勵反覆猜測不可用的模型識別碼作為存取策略。
發布日期與價格是多少?
本文未獨立確立官方發布日期或已驗證的 GPT-6.2 API 價格。競品文章是有日期的報導,不是我們的官方確認。本文的數值範例明確是假設性的。只有在具備來源、日期、供應商範圍,以及適用時的可重現接受證據時,才更新發布與定價主張。
GPT-6.2 在程式設計上比 Fable 5.5 好嗎?
引用的示範比較無法回答這個問題,因為任務與樣本數不同,模型歸因也是自我報告。使用固定環境、工具與預算執行相同程式設計任務,然後評估正確性、修復工作量、接受任務成本與操作行為。報告結果範圍,不要把狹窄樣本變成一般排名。
來源與更新政策
- APIYI:GPT-6.2 Astra 推出訊號與疑點,日期為 2026 年 11 月 2 日——競品報導;來源主張未在此獨立驗證。
- APIYI:Fable 5.5 與 GPT-6.2 Astra,日期為 2026 年 11 月 3 日——競品示範討論;不是本團隊進行的受控基準測試。
- OpenAI API 模型目錄——驗證入口;本次檢視期間直接擷取回傳 HTTP 403。
- OpenAI API 變更日誌——驗證入口;本次檢視期間直接擷取回傳 HTTP 403。
未來更新應區分新近驗證的契約細節與先前報導的線索。加入精確來源與檢查日期,在提出效能主張前發布評估方法,並保留明確限制。日後加入的插圖應標示為概念圖,除非它們記錄了真實且可重現的測試。不得將生成圖稿呈現為產品截圖、官方發布公告或實測 GPT-6.2 輸出。