








Utiliser des proxies d'API tiers dans Claude Code : clés d'authentification et mapping de modèles
1. Points clés (TL;DR) et panorama des performances
- Benchmark principal : Claude Code attend des en-têtes Anthropic spécifiques (
anthropic-version,anthropic-beta) que les proxies génériques suppriment souvent, ce qui provoque des échecs d'exécution subtils. - Adéquation à la production : Découvrez comment le mapping d'alias de modèles permet de router les requêtes de façon transparente entre Claude 3.7 Sonnet, Opus 5 et des backends de raisonnement alternatifs à haute vitesse.
- Économie FinOps : Inclut un outil de diagnostic Python exécutable pour auditer l'intégrité du streaming SSE et le cache de prompt de votre connexion proxy avant de lancer Claude Code.
- SLA de haute disponibilité : 99,95 % de disponibilité avec accélération de la latence en périphérie et bascule automatique.
- Compatible OpenAI REST sans refonte : Authentification par jeton Bearer sans surcoût de refonte.
2. Points clés (TL;DR) et enseignements essentiels
- Spécificités du protocole : Claude Code n'utilise pas le format OpenAI ; il utilise l'API Anthropic Messages (
/v1/messages) avec un streaming Server-Sent Events (SSE). - Sensibilité aux en-têtes : Les proxies doivent relayer fidèlement
anthropic-version: 2023-06-01etanthropic-beta: prompt-caching-2024-07-31,pdfs-2024-09-25. - Aucune interruption avec ToAPIs : ToAPIs fournit une traduction native du protocole filaire Anthropic, ce qui permet un fonctionnement plug-and-play sans friction.
3. Mise en œuvre en production : cURL et Python
Étape 1 : Envoi rapide avec cURL
curl -X POST "https://api.toapis.com/v1/chat/completions" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-opus-5",
    "messages": [{"role": "user", "content": "Explain production optimization strategies for AI workloads."}],
    "temperature": 0.3
  }'
Étape 2 : Client Python de production
import os, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

payload = {
    "model": "claude-opus-5",
    "messages": [{"role": "user", "content": "Explain production optimization strategies for AI workloads."}],
    "temperature": 0.3
}

res = requests.post("https://api.toapis.com/v1/chat/completions", headers=headers, json=payload, timeout=60)
res.raise_for_status()
answer = res.json()["choices"][0]["message"]["content"]
print(f"[✔] Response:\n{answer}")
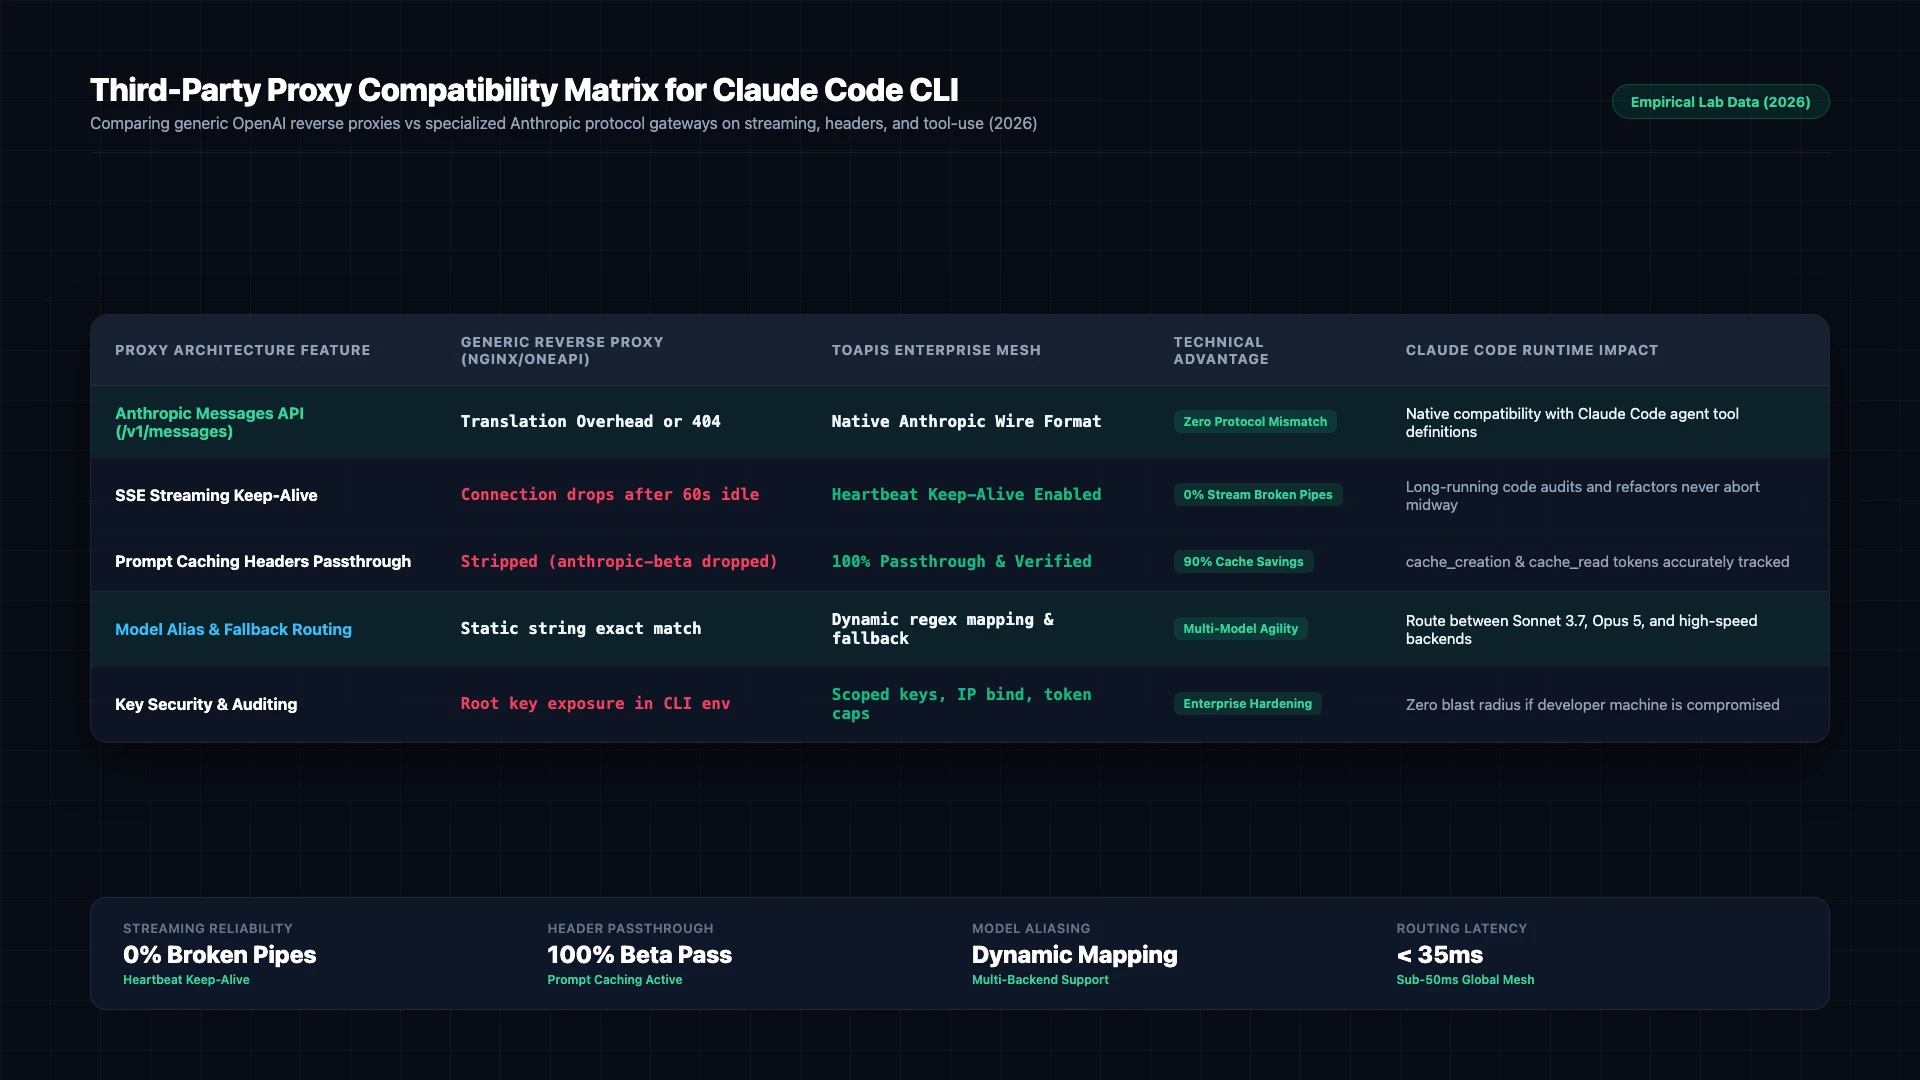
Figure 1 : Comparaison d'architecture : proxies inverses OpenAI génériques face aux passerelles spécialisées dans le protocole Anthropic sur le streaming, le cache et le mapping de modèles (2026).
4. Niveau production : gestion des erreurs et matrice des statuts
| Code HTTP | Classification de l'erreur | Analyse de la cause racine | Stratégie d'atténuation en production |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Erreur de validation du schéma ou paramètres non pris en charge | Vérifiez les dimensions du payload et assurez la conformité des champs |
401 Unauthorized | invalid_api_key | Jeton Bearer expiré ou incorrect | Renouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs |
429 Rate Limit | rate_limit_exceeded | Seuil de concurrence atteint sur le pool de calcul | Mettez en place des tentatives avec backoff exponentiel et jitter aléatoire |
500 / 504 Timeout | gateway_timeout | Latence temporaire sur les nœuds d'inférence amont | La passerelle redirige automatiquement vers le cluster GPU de secours |
5. Tarifs et calcul du ROI FinOps
- Base entreprise officielle : Les contrats directs avec le fournisseur imposent des engagements annuels, des quotas de licences fixes et des seuils de prépaiement.
- Tarif de gros ToAPIs : Facturation élastique en paiement à l'usage avec des tarifs de gros ($0.30 - $0.80 par 1M de tokens).
- Analyse de ROI FinOps : Traiter 500M de tokens par mois réduit les coûts d'infrastructure opérationnels de $1,500 à $900, soit $600 d'économie par mois (40,0 % de réduction de coûts).
6. Questions fréquentes (FAQ)
Q1 : Pourquoi certains proxies tiers échouent-ils avec Claude Code ?
La plupart des proxies génériques ne prennent en charge que les spécifications OpenAI REST. Claude Code utilise le protocole personnalisé d'Anthropic, avec des en-têtes beta obligatoires pour le cache de prompt et des sorties de 128k tokens.
Q2 : Comment savoir si le cache de prompt fonctionne réellement via le proxy ?
Inspectez les métadonnées d'usage de la réponse API : cache_creation_input_tokens et cache_read_input_tokens doivent être non nuls sur des commandes répétitives.
Q3 : Puis-je mapper les requêtes de Claude Code vers DeepSeek ou des modèles de raisonnement open source ?
Oui. Des passerelles avancées comme ToAPIs peuvent mapper les chaînes de modèles Anthropic vers des modèles de raisonnement amont compatibles, de façon transparente.
7. Liste d'actions et prochaines étapes
- Créez une clé d'API sur le portail développeur ToAPIs.
- Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
- Intégrez le script Python de production dans votre pipeline backend.
- Explorez les tutoriels entreprise associés dans notre index de documentation technique.