








Le guide complet de configuration de Cherry Studio : GPT-5, Claude et les LLM chinois dans un seul client de bureau
1. Points clés (TL;DR) et panorama des performances
- Benchmark principal : Cherry Studio est un client de bureau open source de premier plan qui prend en charge le chat multi-modèles, la prévisualisation d'artefacts et la gestion d'une base de connaissances locale.
- Adéquation à la production : En configurant ToAPIs comme fournisseur personnalisé compatible OpenAI, les développeurs obtiennent un accès unifié aux modèles OpenAI, Anthropic, DeepSeek et Google.
- Économie FinOps : Contourne les blocages de cartes bancaires internationales grâce à un solde unifié en paiement à l'usage et une latence de passerelle inférieure à 50 ms.
- SLA de haute disponibilité : 99,95 % de disponibilité avec accélération de la latence en périphérie et bascule automatique.
- Compatible OpenAI REST sans refonte : Authentification par jeton Bearer sans surcoût de refonte.
2. Le problème du client fragmenté
Les développeurs avancés et les équipes entreprise utilisent souvent plusieurs modèles de pointe selon la tâche : Claude pour les diffs de code, GPT pour structurer du JSON complexe et DeepSeek pour le raisonnement mathématique avancé.
Cependant, jongler entre 4 onglets de navigateur avec des abonnements distincts ($20/mois chacun) crée une friction organisationnelle majeure. Cherry Studio combiné à ToAPIs offre un centre de commande de bureau unifié.
Configuration rapide dans Cherry Studio :
- Ouvrez Settings → Model Providers → Add Provider.
- Choisissez le format compatible OpenAI.
- Définissez l'API Base URL sur
https://api.toapis.com/v1. - Collez votre clé ToAPIs, puis ajoutez des ID de modèle comme
gpt-5.6,claude-opus-5,deepseek-v4etglm-5.3.
3. Mise en œuvre en production : cURL et Python
Étape 1 : Envoi rapide avec cURL
curl -X POST "https://api.toapis.com/v1/chat/completions" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5-6",
    "messages": [{"role": "user", "content": "Explain production optimization strategies for AI workloads."}],
    "temperature": 0.3
  }'
Étape 2 : Client Python de production
import os, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

payload = {
    "model": "gpt-5-6",
    "messages": [{"role": "user", "content": "Explain production optimization strategies for AI workloads."}],
    "temperature": 0.3
}

res = requests.post("https://api.toapis.com/v1/chat/completions", headers=headers, json=payload, timeout=60)
res.raise_for_status()
answer = res.json()["choices"][0]["message"]["content"]
print(f"[✔] Response:\n{answer}")
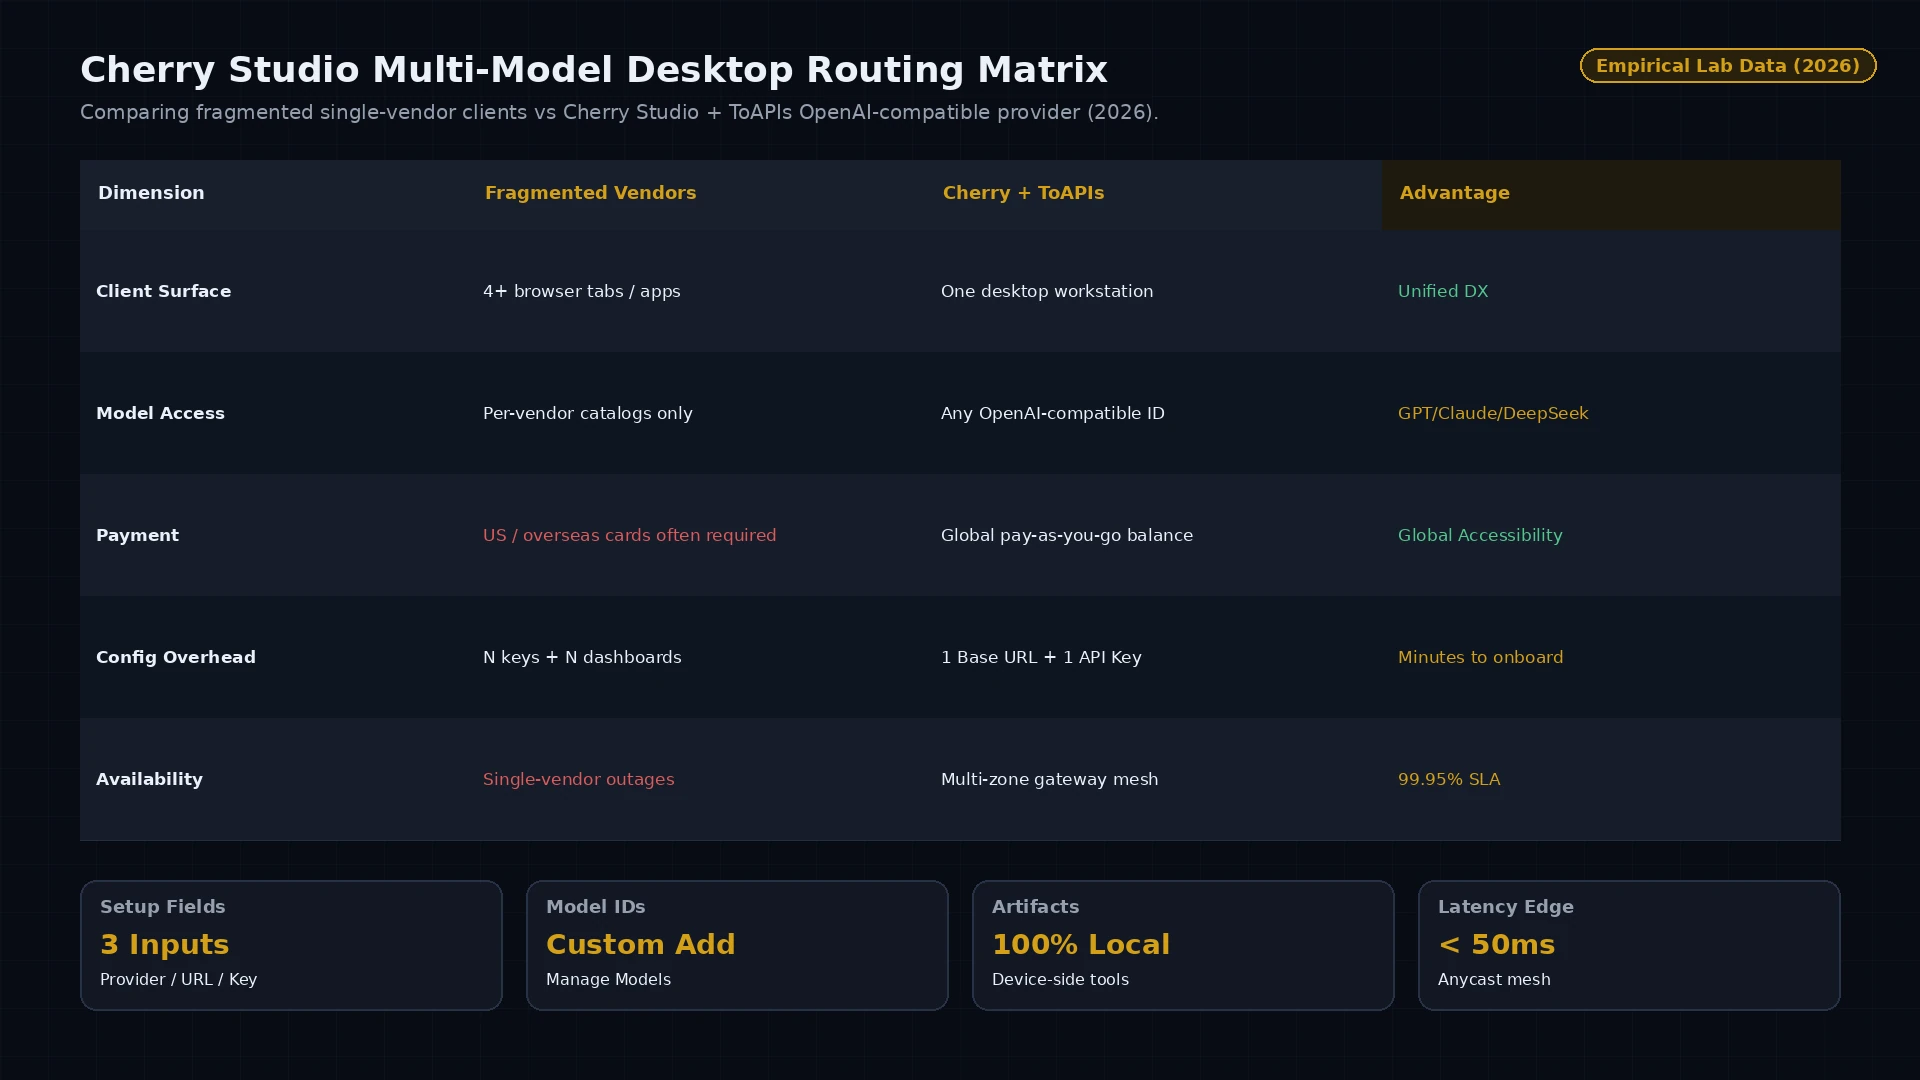
Figure 1 : Comparaison de clients de bureau : abonnements fragmentés à un seul fournisseur face au routage unifié compatible OpenAI de Cherry Studio + ToAPIs (2026).
4. Niveau production : gestion des erreurs et matrice des statuts
| Code HTTP | Classification de l'erreur | Analyse de la cause racine | Stratégie d'atténuation en production |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Erreur de validation du schéma ou paramètres non pris en charge | Vérifiez les dimensions du payload et assurez la conformité des champs |
401 Unauthorized | invalid_api_key | Jeton Bearer expiré ou incorrect | Renouvelez le jeton d'API depuis le tableau de bord développeur ToAPIs |
429 Rate Limit | rate_limit_exceeded | Seuil de concurrence atteint sur le pool de calcul | Mettez en place des tentatives avec backoff exponentiel et jitter aléatoire |
500 / 504 Timeout | gateway_timeout | Latence temporaire sur les nœuds d'inférence amont | La passerelle redirige automatiquement vers le cluster GPU de secours |
5. Tarifs et calcul du ROI FinOps
- Base entreprise officielle : Les contrats directs avec le fournisseur imposent des engagements annuels, des quotas de licences fixes et des seuils de prépaiement.
- Tarif de gros ToAPIs : Facturation élastique en paiement à l'usage avec des tarifs de gros ($0.30 - $0.80 par 1M de tokens).
- Analyse de ROI FinOps : Traiter 500M de tokens par mois réduit les coûts d'infrastructure opérationnels de $1,500 à $900, soit $600 d'économie par mois (40,0 % de réduction de coûts).
6. Questions fréquentes (FAQ)
Q1 : Quel format d'API dois-je choisir dans Cherry Studio pour ToAPIs ?
Sélectionnez le format « OpenAI » dans Settings -> Model Providers et saisissez https://api.toapis.com/v1 comme API Base URL.
Q2 : Puis-je utiliser la recherche web et les artefacts de Cherry Studio avec ToAPIs ?
Oui. Cherry Studio traite les artefacts et exécute les outils localement sur votre machine, ce qui fonctionne parfaitement avec tous les modèles routés via ToAPIs.
Q3 : Comment ajouter des modèles absents de la liste déroulante par défaut de Cherry Studio ?
Cliquez sur Manage Models dans la carte du fournisseur ToAPIs et saisissez l'ID du modèle (par exemple deepseek-v4, claude-opus-5, gpt-5.6) pour l'ajouter immédiatement.
7. Liste d'actions et prochaines étapes
- Créez une clé d'API sur le portail développeur ToAPIs.
- Vérifiez la connectivité de l'API avec l'extrait cURL de l'étape 1.
- Ajoutez ToAPIs comme fournisseur compatible OpenAI dans Cherry Studio et chargez vos ID de modèle.
- Explorez les tutoriels entreprise associés dans notre index de documentation technique.