
GPT-Image-2.6 API 指南:Flare、Sunburst、GIF 与 SVG
毁掉一次图像冲刺的,很少是主视觉图本身,而是后续追问:“同一个调用能返回 GIF 吗?能把 logo 给成 SVG 吗?设计能不能把马克杯左移两英寸,而不用重生成整个场景?”围绕一张扁平 PNG 搭建的流水线,面对这三种诉求都只能另起项目。
OpenAI 于 2026 年 11 月 4 日发布 Images 2.6,API 现在覆盖了这些诉求:两个模型变体、GIF 与 SVG 输出、标记引导编辑,以及独立的复杂度控制。问题在于,新能力上线的速度快过了每一页参考文档的更新速度。本指南给出一套可运行的 GPT-Image-2.6 API 集成,然后标出那些在硬编码前应先确认限制的具体位置。
TL;DR
- 两个模型,一张价目表。
gpt-image-2.6-flare是快速迭代路径;gpt-image-2.6-sunburst面向更高质量、更多细节,并在中等/高质量下提供更强的编辑一致性。两者使用相同的 token 费率。- 新增 API 能力。 GIF 输出、SVG 输出、标记引导编辑,以及
complexity参数。生成与编辑仍是独立端点。- 按 token 计费,而非按张计费。 图像输出为每 1M token $30;图像输入为每 1M token $8(缓存 $2);文本输入为每 1M token $5(缓存 $1.25)。
- 文档在三处存在冲突。 GIF 的
frame_count、markup 的模型支持范围,以及部分质量/尺寸参考。上线任何硬性限制前,请先在你的账户上验证。
上线状态: GPT-Image-2.6 即将在 ToAPIs 上线。以下代码示例已准备好,最新开放状态请查看 模型页。
1. GPT-Image-2.6 API 发布了什么
Images 2.6 是 2026 年 11 月 4 日的生成版本,在 ChatGPT、Codex 和 API 中可用。OpenAI 表示,它生成图像的速度比上一代快 50%。这是厂商关于生成速度的说法,不是对你 p95 延迟的承诺,也没有说明价格:计费仍按 token 进行。
两个模型 ID 服务于不同任务:
gpt-image-2.6-flare为快速迭代而设计。在quality=low下,OpenAI 称生成最快约需 6 秒,这使它成为提示词探索、缩略图和 UI 预览的默认选择——在这些场景里,“现在够好”胜过“以后完美”。gpt-image-2.6-sunburst面向更高质量和细节,在quality=medium或high时具有更强的编辑一致性。用于最终素材,以及未改动区域必须保留的编辑。
两个模型共享 token 费率,所以选择取决于采纳率和延迟,而不是更便宜的模型 ID。如果你正从上一代迁移,GPT Image 2 API 指南解释了共享的请求结构;本文聚焦 2.6 新增的内容。GPT-Image-2.6 模型指南则是查看你账户可用性的地方。
该 API 兼容 OpenAI。以下示例指向 https://api.toapis.com/v1;如果你把它们指向另一个兼容的 base URL,请保留请求载荷,只更改 base URL 和密钥。
2. 你的第一个 GPT-Image-2.6 API 请求
从生成开始。这个 curl 调用让 Flare 以低质量和低复杂度生成一张方形草稿,这是最快且合理的冒烟测试:
curl -sS https://api.toapis.com/v1/images/generations \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-flare",
    "prompt": "Paper-cut football stadium at night, layered cardstock, rim light, no text",
    "size": "1024x1024",
    "quality": "low",
    "complexity": "low",
    "n": 1
  }' -o flare-response.json
在编写下载器之前先检查响应。取决于模型和请求选项,图像 API 通常返回 URL 或 base64 数据;假定 data[0].url 的客户端会在合法的 base64 响应上失败。下面的辅助函数同时处理两种情况,并用于本文每个示例:
import base64
import os
import pathlib
import requests

API = "https://api.toapis.com/v1/images/generations"
HEADERS = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}


def generate(model: str, prompt: str, output: str, **params) -> str:
    payload = {"model": model, "prompt": prompt, "n": 1, **params}
    response = requests.post(API, headers=HEADERS, json=payload, timeout=180)
    response.raise_for_status()
    item = response.json()["data"][0]
    target = pathlib.Path(output)
    if item.get("b64_json"):
        target.write_bytes(base64.b64decode(item["b64_json"]))
    else:
        target.write_bytes(requests.get(item["url"], timeout=60).content)
    return str(target)


if __name__ == "__main__":
    prompt = "Paper-cut football stadium at night, layered cardstock, rim light, no text"
    generate("gpt-image-2.6-flare", prompt, "flare-draft.png",
             size="1024x1024", quality="low", complexity="low")
    generate("gpt-image-2.6-sunburst", prompt, "sunburst-final.png",
             size="1536x1024", quality="high", complexity="high")
180 秒超时是刻意设置的。复杂提示词可能耗时约两分钟,因此 30 秒的客户端超时会把服务器仍可能完成的工作拒掉。如果你的产品无法承受这么长的请求,请使用任务队列,而不是缩短超时并盲目重试。
3. Flare 与 Sunburst:GPT-Image-2.6 API 模型选择
有用的比较不是“哪个模型更好”,而是“在这个任务上,哪个模型能以可接受的延迟和成本被采纳”。一张被拒的 Flare 草稿,成本可能高于一张最终交付的 Sunburst 图像。
| 任务 | 更优的首选 | 原因 |
|---|---|---|
| 探索 20 个提示词方向 | gpt-image-2.6-flare | 低质量生成是快路径;尽早排除坏方向 |
| UI 缩略图和占位符 | gpt-image-2.6-flare | 速度比精细细节更重要 |
| 最终主视觉图 | gpt-image-2.6-sunburst | 在中等/高质量设置下质量和细节更高 |
| 必须保留主体特征的编辑 | gpt-image-2.6-sunburst | 中等/高质量下编辑一致性更强 |
| 大批量首轮生成 | gpt-image-2.6-flare | token 费率相同,但每次尝试耗时更少 |
| 格式实验(GIF/SVG) | 任一模型,然后重跑 | 在优化质量前先确认格式支持 |
让两个模型在相同提示词和输出尺寸上运行,一次只改变一个变量,并对结果做盲评。记录采纳率、p50/p95 延迟和原始响应元数据:请求与返回的模型、quality、complexity、size、format、token 用量(如有)以及耗时。一个好看的样本不能证明某个模型更好。
一个实用模式:先用低质量的 Flare 探索,再对选中的方向使用高质量 Sunburst。沿用提示词,但不要指望第二张图逐像素一致。如果一致性很重要,请测试一次编辑,而不是全新生成。
4. GPT-Image-2.6 API 中的质量与复杂度
quality 接受 low、medium、high、xhigh、max 或 auto。默认值为 auto。多数团队只需要三个工作点:
- 当延迟优先、且图像可丢弃时用
low。 - 当输出会被审核或交付时用
medium或high。 - 当细节值得额外工作量时,用
xhigh或max处理最终素材。
延迟和 token 用量因工作负载而异。不要照搬 2.5 的单图价格;2.6 采用 token 计费。
complexity 是独立参数:low、medium 或 high,指南默认值为 high。它不单独收费,但更高设置可能增加延迟和不想要的改动。应把它当作提示词遵循度变量来测试,而不是免费的质量升级:低复杂度请求可能更快,而高复杂度请求可能理清繁杂场景,或者“改进”你原本希望保持原样的部分。请在你自己的提示词上做小规模 A/B 测试。
| 测试 | quality | complexity | 你能了解到什么 |
|---|---|---|---|
| 延迟下限 | low | low | 该提示词最快的现实响应 |
| 默认行为 | auto | high(文档默认值) | 未做配置的客户端会得到什么 |
| 漂移检查 | high | low | 测试较低复杂度是否减少不想要的改动 |
| 最终细节 | high 或 xhigh | high | 额外工作是否提升采纳率 |
一次只改变一个变量。如果同时改变 quality 和 complexity,糟糕的结果无法告诉你哪个旋钮造成了它。
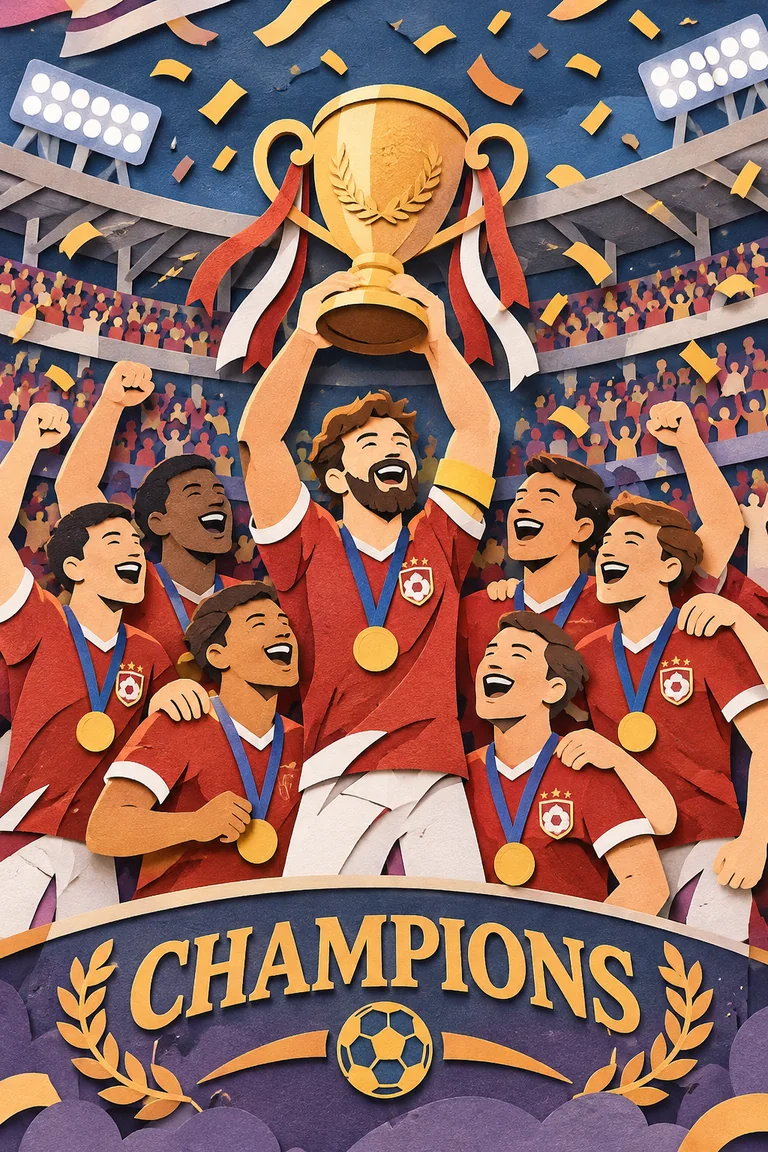
GPT-Image-2.6 中等质量示例:分层卡纸与体育场灯光。示例输出,并非基准测试。
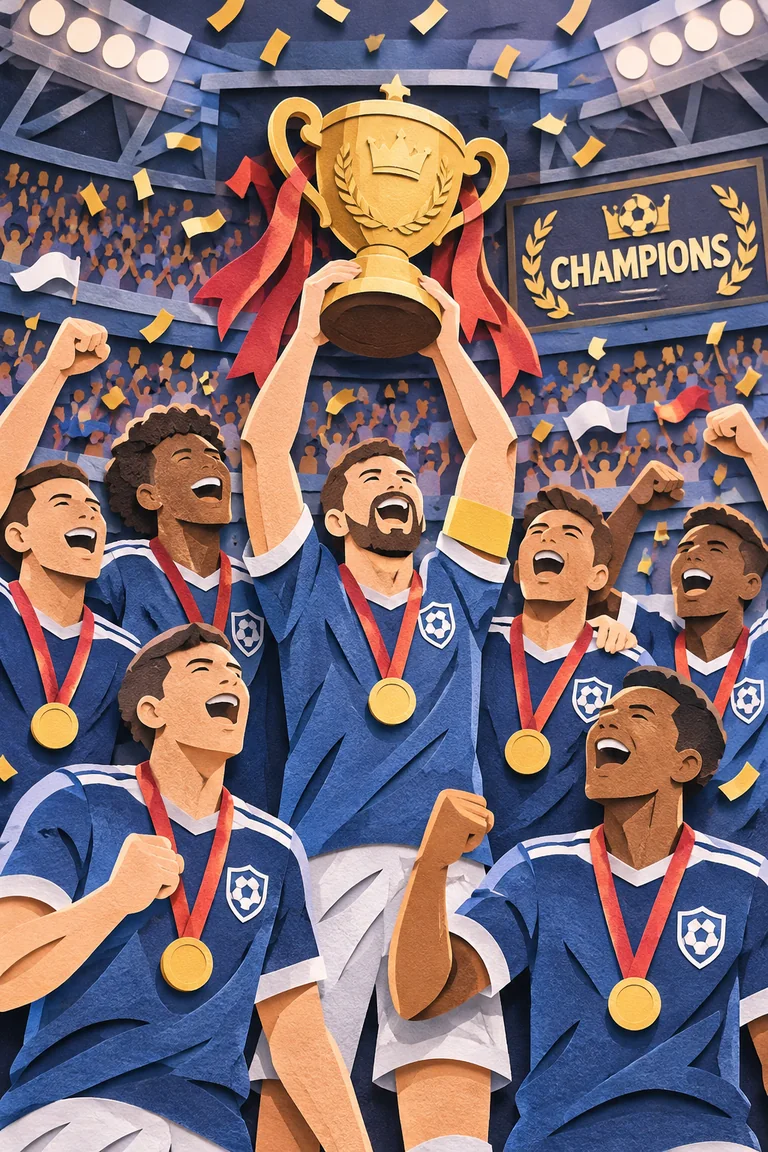
GPT-Image-2.6 高质量示例:更多表面细节和更紧的边缘。在显示尺寸下比较采纳率,而不是锐度。
5. GPT-Image-2.6 API 的 GIF 输出
GIF 仅用于生成。在 POST /v1/images/generations 上将 output_format 设为 gif;编辑不支持该格式。控制参数为:
frame_count:默认9。图像指南写2-64,API 参考写2-16。该冲突尚未解决,因此没有实际验证前不要硬编码 64。frame_duration_ms:默认200,最小20。9 帧、每帧 200 毫秒会产生 1.8 秒的播放;16 帧会产生 3.2 秒。这是算术,不是流畅运动的保证。
generate(
    "gpt-image-2.6-flare",
    "A paper lantern monkey swinging through a bamboo forest, simple background, no text",
    "monkey-lantern.gif",
    size="1024x1024",
    quality="low",
    output_format="gif",
    frame_count=9,
    frame_duration_ms=200,
)
从默认的 9 帧开始。如果需要更多,以小步向上探测,并在第一次被拒绝时停止;这会告诉你账户当前接受的限制。保持场景简单,因为 GIF 会把视觉决策乘以帧数。关注交付的文件大小和尺寸,而不只是 HTTP 状态码。
GPT-Image-2.6 示例:一次调用生成的短动态 GIF。帧数和播放时长取决于你请求的设置。
把 GIF 当作预览格式,而不是主素材。保留设置,并尽可能保留一张静帧,用于缩略图和无障碍回退。
6. GPT-Image-2.6 API 的 SVG 输出
SVG 同样仅用于生成。将 output_format 设为 svg,保持 n=1,并预期静态矢量输出。文档限制:不支持流式输出、不支持部分图像、不支持压缩,也不支持 prompt_rewriter。编辑不支持 SVG。
generate(
    "gpt-image-2.6-sunburst",
    "A minimal field-and-flour bakery label, wheat stalk and rolling pin, two-color vector, no text",
    "field-and-flour.svg",
    size="1024x1024",
    quality="high",
    output_format="svg",
    n=1,
)
在客户端拒绝 n>1。不要发送 output_compression,也不要指望渐进渲染;SVG 以完整静态素材返回。由于 SVG 是标记语言,请把文件视为不受信任:以图像方式提供,或在内联前做安全净化。一个看起来正确但包含意外元素的矢量图,是安全问题。
SVG 适合图标、标签、图表,以及会暴露位图放大痕迹的印刷标记。它不适合照片、动画或编辑工作流。要修改矢量图,请用更精确的提示词重新生成,或在设计工具中重建;除非你检查过结构,否则不要承诺图层可编辑。
GPT-Image-2.6 示例:简单双色标签的静态 SVG 输出。内联提供前请检查返回的标记。
7. GPT-Image-2.6 API 中的标记引导编辑
标记引导编辑会把源图像加上一张透明 PNG 叠加层发送到 POST /v1/images/edits。叠加层绘制在第一张图像上,尺寸必须与其匹配。第一张图像和叠加层各自最多 16,777,216 像素;叠加层文件最大 50 MB。
规则很严格:
- 标记不能与
mask或prompt_rewriter组合使用。 - 叠加层必须是透明 PNG,而不是扁平化截图。
- 发送多张图像时,叠加层应用于第一张图像。
- 没有额外标记费用,但请求仍按其 token 计费。
导出基础图像,创建同像素尺寸的 RGBA 叠加层,在目标周围画一个半透明箭头或轮廓,然后用一条定义改动内容和必须保持不变部分的提示词上传两者。叠加层显示“在哪里”,提示词说明“做什么”。“把马克杯右移,并保持桌子、阴影和背景不变”是可测试的;“让它更好”则不是。
import base64
import os
import requests

url = "https://api.toapis.com/v1/images/edits"
headers = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}

with open("base.png", "rb") as image, open("overlay.png", "rb") as markup:
    response = requests.post(
        url,
        headers=headers,
        data={
            "model": "gpt-image-2.6-sunburst",
            "prompt": "Move the mug to the right side of the table and keep the table, shadow, and background unchanged.",
            "size": "1024x1024",
            "quality": "high",
            "complexity": "medium",
        },
        files={"image": image, "markup": markup},
        timeout=180,
    )
response.raise_for_status()
item = response.json()["data"][0]
if item.get("b64_json"):
    open("edited.png", "wb").write(base64.b64decode(item["b64_json"]))
else:
    open("edited.png", "wb").write(requests.get(item["url"], timeout=60).content)
此示例使用 markup 作为叠加层部件名;请在当前 API 参考中确认。参考文档把 markup 标为 2.5 功能,而图像指南将其描述为适用于 2.5 和 2.6。测试请求成功前不要上线。如果 Sunburst 拒绝 markup,不要静默切换版本;请把失败暴露出来,并保留最后已知可用的路径。
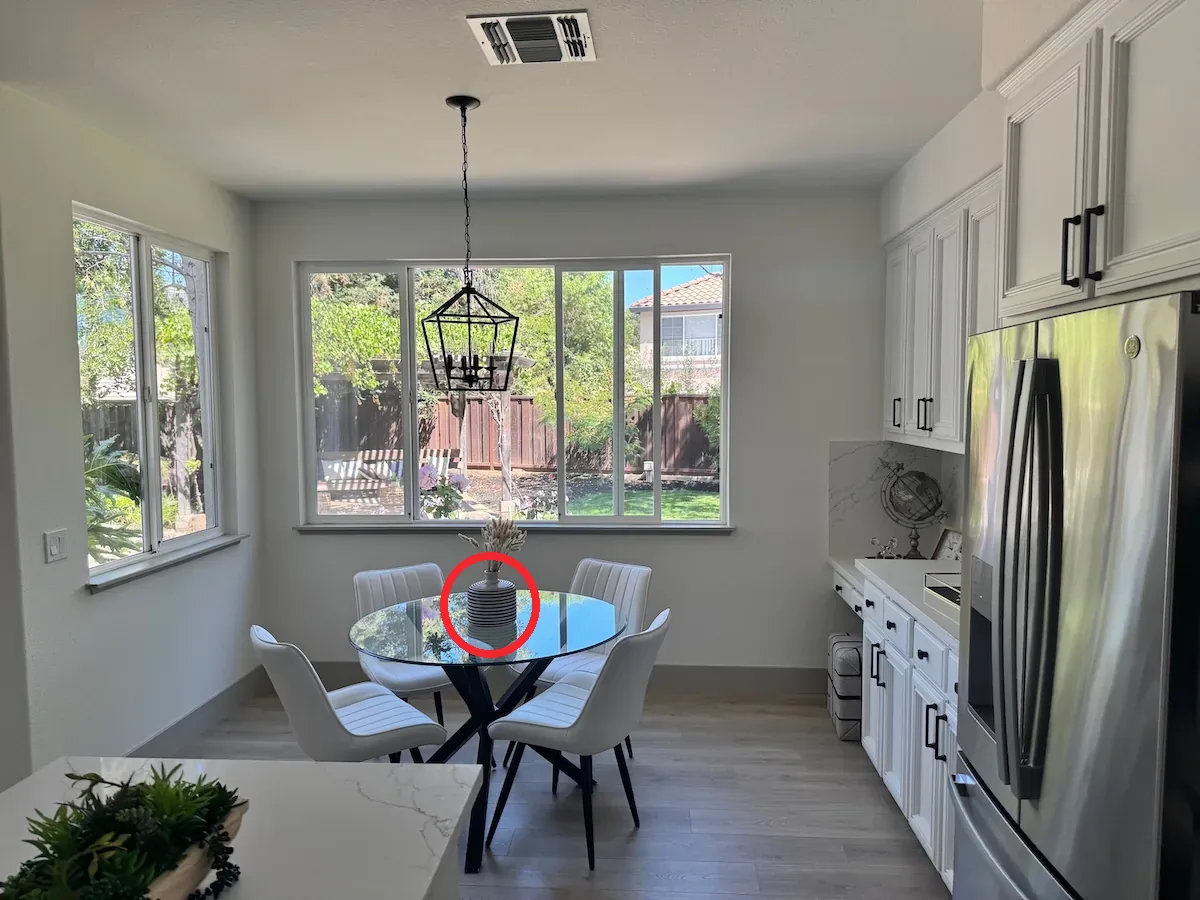
GPT-Image-2.6 示例:标记引导编辑前的源图像。叠加层和提示词未显示。
GPT-Image-2.6 示例:编辑后的结果。像检查请求的改动一样仔细检查未改动区域;一个看起来很可信的新物体仍可能移动阴影或改变背景。
用区域级清单衡量编辑质量:目标区域已改变、非目标几何结构保留、阴影与反射一致、文字未变、叠加层边缘没有新物体。保留基础图像,以便无需重新生成即可重试。
8. GPT-Image-2.6 API 的尺寸与限制
推荐尺寸为 1024x1024、1536x1024 和 1024x1536。自定义尺寸必须使用 16 的倍数、宽高比在 1:3 到 3:1 之间,且不超过 3840x2160。超过 2560x1440 的任何尺寸都属于实验性;当布局偏离推荐尺寸时,请先验证它。
客户端的一小段校验可以在浪费一次往返之前拦住大多数错误请求:
def validate_size(width: int, height: int) -> str:
    if width % 16 or height % 16:
        raise ValueError("width and height must be multiples of 16")
    if not (1 / 3 <= width / height <= 3):
        raise ValueError("aspect ratio must stay between 1:3 and 3:1")
    if width > 3840 or height > 2160:
        raise ValueError("maximum size is 3840x2160")
    if width * height > 3840 * 2160:
        raise ValueError("pixel area exceeds the documented maximum")
    return f"{width}x{height}"
GPT-Image-2.6 API 文档的冲突不是表面问题。它们会改变客户端应该接受什么:
| 主题 | 一个来源说 | 另一个来源说 | 工程动作 |
|---|---|---|---|
GIF frame_count | 图像指南:2-64 | API 参考:2-16 | 从 9 开始;向上探测;不要硬编码 64 |
| Markup 模型支持 | 图像指南:2.5 和 2.6 | API 参考:仅 2.5 | 在你账户上测试 2.6;保留回退 |
| 质量/尺寸表 | 2.6 指南包含更新的档位和尺寸 | 部分参考页滞后于上一代 | 运行时校验枚举和尺寸 |
把文档视为带版本的配置:记录来源 URL、访问日期,以及你账户的实际行为。不支持的枚举返回 400 是证据;配置注释不是。
9. GPT-Image-2.6 API 调用的真实成本
OpenAI 按 token 为 Images 2.6 定价。gpt-image-2.6-flare 和 gpt-image-2.6-sunburst 使用相同费率:
| Token 类型 | 标准 | 缓存 |
|---|---|---|
| 图像输出 | $30.00 / 1M | 不适用 |
| 图像输入 | $8.00 / 1M | $2.00 / 1M |
| 文本输入 | $5.00 / 1M | $1.25 / 1M |
成本公式为:
cost = (image_output_tokens * 30
      + image_input_tokens * 8
      + cached_image_input_tokens * 2
      + text_input_tokens * 5
      + cached_text_input_tokens * 1.25) / 1_000_000
官方没有固定的单图价格;任何估算都始于实测 token 用量。假设一次生成请求计费 400 个文本输入 token 和 5,000 个图像输出 token:(400 × 5 + 5,000 × 30) / 1,000,000 = $0.152。这些计数仅为示例,不是平均值。若一次编辑还计费 2,000 个图像输入 token,则会增加 $0.016,总计 $0.168。
在 1,000 次请求下,假设的 $0.152 约为 $152,尚未计入图像输入或缓存折扣。按每张被采纳的图像追踪成本,而不是按请求:包含重试、拒稿、审核时间和存储。如果审核员拒绝其 40% 的输出,更便宜的调用也可能得不偿失。
两条规则让成本计算保持诚实:快 50% 不等于便宜 50%,因为速度改变的是延迟,不是 token 费率;2.5 的单图价格不适用于 2.6。只有当输入由缓存提供时,缓存输入才会降低重复参考图编辑的成本。查看定价,并与返回的 usage 对账。
10. 生产检查清单与已知限制
GPT-Image-2.6 API 能力很强,但不是确定性的布局引擎。文档限制仍然适用:复杂提示词可能耗时约两分钟,文字渲染有局限,跨生成一致性无法保证,构图控制并不完美。请按审核与重试来设计,而不是指望一次完美调用。
在正式接入 GPT-Image-2.6 API 流量之前:
- 设置超过最坏情况的超时,或把长任务放入队列。超时结果不明确时,不要盲目重试已付费请求;先检查状态或幂等性。
- 在自己的客户端校验模型 ID、quality、complexity、size 和 output format。在消耗请求前拒绝不支持的组合。
- 记录请求与返回的模型、format、尺寸、quality、complexity、token 用量、延迟和输出哈希值。对密钥和敏感提示词做脱敏。
- 在指标中区分生成失败和编辑失败。被拒的标记请求和缓慢的生成是不同的事件。
- 多轮图像编辑使用 Responses API;它支持跨轮生成与编辑。对于一次性任务,Images 端点仍然更简单。
- 保留经过测试的回退。如果 Sunburst 不可用,Flare 可能仍能服务请求,但输出不同;当实际运行的是回退模型时,请告知用户,不要静默替换。
- 将所需素材存入受控存储。不要假定临时 URL 是永久存档,也不要在未净化的情况下内联不受信任的 SVG。
上线时,使用一套能代表你工作负载的固定测试集:包装上的小字、编辑后必须保持形状的产品、宽幅构图,以及一段短动画。按书面清单评分,然后按采纳率和 p95 延迟比较模型,而不是截图。
11. 常见问题
应该使用 gpt-image-2.6-flare 还是 gpt-image-2.6-sunburst?
探索、变体和延迟敏感的草稿用 Flare,尤其是 quality=low 时。最终细节,以及必须保留图像其余部分的编辑,用 Sunburst 的 quality=medium 或 high。两个模型共享 token 费率,所以请做一个小规模采纳测试,而不是假定更高质量的模型总是必要。
GPT-Image-2.6 API 的编辑支持 GIF 和 SVG 吗?
不支持。GIF 和 SVG 是 GPT-Image-2.6 API 的生成格式;编辑两者都不支持。SVG 是静态矢量,n=1,不支持流式输出、部分图像、压缩或 prompt_rewriter。GIF 同样仅用于生成。请构建独立路径,而不是指望编辑忽略格式。
一张 GPT-Image-2.6 API 图像的成本是多少?
官方没有固定的单图价格。图像输出为每 1M token $30,图像输入为每 1M token $8(缓存 $2),文本输入为每 1M token $5(缓存 $1.25)。用你实测的 token 数估算,然后以总支出除以被采纳的图像数。不要用 2.5 的单图价格做 2.6 的预算。
为什么 GPT-Image-2.6 API 文档不一致?
指南和 API 参考没有完全同步。frame_count 同时出现 2-64 和 2-16;markup 在参考中记为仅 2.5,在指南中为 2.5/2.6;部分质量和尺寸表滞后。请把这些当作版本特定的限制,在你的账户上测试,并记录检查日期和结果。
12. 从三次调用开始,而不是一次迁移
用一批受控请求评估 GPT-Image-2.6 API:一次 Flare low/low 草稿、一次 Sunburst high/high 成品,以及一次符合你产品需求的格式请求。记录 token、延迟和采纳率,再决定哪些值得进入流水线。
创建 ToAPIs 账户,查看 GPT-Image-2.6 模型指南了解当前访问权限,并在定价页确认费率。如果你仍在上一代,先阅读 GPT Image 2 API 指南,然后逐个端点迁移,而不是重写整个流水线。