
在把 GPT-6.2 API 当成一次模型名称替换之前,应先把它当成一次契约核验任务。 用量报告中的标签可能很有价值,但它不能告诉你应用可以发送什么请求、哪个账户有权限发送、最终工作成本是多少。当前最直接的工程问题,是避免配置文件看起来正确,到了服务商边界却失败。
核对日期:2026 年 11 月 4 日。 本文检查了 API易 11 月 2 日和 11 月 3 日发布的两篇竞品文章。它们关于灰度、截图和 demo 归属的描述都属于第三方转述,并非 ToAPIs 团队观察。本次研究环境请求 OpenAI 官方模型目录和 API 更新日志时返回 HTTP 403;这既不能证明页面存在,也不能证明页面不存在。本文没有执行带鉴权的 GPT-6.2 推理、取得报价,也没有独立核验原始截图。
概念图:灰度线索、契约核验与接入准备是不同阶段,不代表官方发布或模型实测输出。
1. GPT-6.2 灰度报道:它们能说明什么
API易 的灰度分析文章描述了 Codex 用量视图中可能出现的 gpt-6.2-astra、不同灰度比例、response 片段和 CLI 试验,同时也讨论官方没有确认,以及 CLI 参数本身证据不足。这些内容可以作为研究线索,但不是本文团队观察到的遥测数据,本文不会把报道中的比例复述为已验证事实。
关键区别在于:某处出现一个名称,和稳定的产品契约,是两件事。内部别名可能在公开选择之前出现在日志中;客户端可能在服务端校验前接受任意字符串;不同账户也可能被不同方式路由。这些可能性都不能决定 GPT-6.2 的实际行为,却解释了为什么单张截图仍然缺少关键答案。
| 证据 | 可以支持什么 | 仍需核验什么 |
|---|---|---|
| 竞品文章引用用量截图 | 某个日期有人发布了这项说法 | 原始上下文、真伪、账户范围和可重复性 |
| CLI 接受模型参数 | 本地客户端接受了一个字符串 | 服务端支持、授权和实际返回身份 |
| 已完成响应带有模型字段 | 某次响应报告了一个标识 | 别名行为、文档保证、计费和可用范围 |
| 带模型标签的公开 demo | 创作者把作品归因给这个标签 | 完整输入、工具、尝试次数、设置和独立复现 |
| 服务商文档加上获准请求 | 某个账户路径确实可用 | 运行限制、持续可用性和支持条款 |
严谨回答 GPT-6.2 发布日期时,应标注来源和范围。社区预测是预测,公告是公告,API 访问测试只能说明某个账户在某个时间能做什么。三种日期都不同时,应分别保留。不要把“暂时无法核验”写成“不可能存在”,也不要把竞品标题写成官方发布通知。
概念图:截图、CLI 输入、文档与请求记录各有不同证据范围,不能相互替代。
2. 先建立离线评测包
在模型可用性尚未确定前,你仍然可以准备有价值的接入工作。先选一组有代表性的任务,并提前写清楚验收规则。一个模型可能在一次 demo 中产出很亮眼的结果,却在你的工作流中漏掉 JSON 字段,或作出不安全的工具选择。提前定义失败条件,可以避免评测被最漂亮的输出带偏。
下面的 Python 3 示例只使用标准库。把它保存到空目录并在本地运行即可。它创建三个测试案例和一个刻意留空的契约记录。它不会调用服务商、不需要密钥,也不声称 GPT-6.2 支持这些任务。空的模型字段是有意保留的:只有在检查实际服务商的文档标识和权限后才能填写。
import json
from pathlib import Path

cases = [
    {
        "id": "structured-01",
        "task": "structured_output",
        "prompt": "Extract item and quantity from: Please order 3 blue mugs.",
        "expected": {"item": "blue mugs", "quantity": 3},
        "checks": ["valid JSON", "exact keys", "integer quantity"],
    },
    {
        "id": "code-01",
        "task": "coding",
        "prompt": "Implement clamp(x, low, high); reject low greater than high.",
        "checks": ["boundary tests", "invalid bounds", "no network access"],
    },
    {
        "id": "tool-01",
        "task": "tool_selection",
        "prompt": "Check order status; no order ID was supplied.",
        "checks": ["ask for order ID", "do not invent an ID", "no write tool"],
    },
]
contract = {
    "provider": None,
    "documented_model_id": None,
    "request_documentation_url": None,
    "access_checked_at": None,
    "billing_unit": None,
}
Path("evaluation-cases.jsonl").write_text(
    "".join(json.dumps(case, ensure_ascii=False) + "\n" for case in cases),
    encoding="utf-8",
)
Path("provider-contract.json").write_text(
    json.dumps(contract, indent=2) + "\n", encoding="utf-8"
)
print(f"Prepared {len(cases)} offline cases; provider contract remains unverified.")
继续扩展这些案例时,应使用应用真实失败模式,同时移除机密输入。既要有保护当前行为的简单案例,也要有能区分候选模型的困难案例。提示词、参考答案、schema 和测试环境应一起版本化。若在一次运行中修改预期答案,应开启新的评测版本,而不是悄悄改变通过率。
代码任务的验收标准,是在目标语言、依赖和隔离环境中真正执行。能读懂一段看起来合理的 patch 不够。结构化抽取需要同时检查 schema 和语义:语法正确的 JSON 也可能包含编造值。工具任务要检查参数、权限,以及是否应该先追问。无论 GPT-6.2 何时可用,这些检查都成立。
3. 为什么 GPT-6.2 与 Fable 5.5 的 demo 不能直接排名
第二篇 API易 文章是《Fable 5.5 与 GPT-6.2 Astra 对比》,整理了多个公开 demo,并明确指出任务不同。文章描述了多个归属于 Fable 5.5 的作品,以及一个归属于 GPT-6.2 的像素动画 demo。这些归属在本文中仍属于创作者或竞品声称;我们没有复现作品,也没有核实实际服务模型。
游戏、短片和动画是不同工作负载。它们的视觉质量可以帮助你发现值得测试的任务,却不能提供成功率、延迟或成本的共同分母。尝试次数同样重要。一个被挑出来的成功作品既不能告诉你失败次数,也不能告诉你为了完成它进行了多少人工修复。
公平比较应在执行前固定任务、输入、工具、时限、输出约束和重试策略。每次尝试都要记录文档中的模型标识和推理设置。模型不支持某项能力时,应明确报告限制,不要偷偷给某一方额外工具或不同约束。相同的运行预算,通常比假装所有服务商公开相同参数更有价值。
需要人工判断时,可以使用盲评。把任务和验收标准交给评审者,不先透露模型标签。记录分歧并在最终评分前检查原因。对非确定性任务重复执行,保留结果分布,不只挑最好的一次。小规模试点可以发现接入问题,但不能据此宣布 GPT-6.2 在编码、推理或 agent 工作上普遍更强。
概念图:公平评测需固定任务、工具和预算;图中没有性能结果或模型排名。
4. 在 API 边界核验身份、工具和失败行为
服务商正式记录 GPT-6.2 访问方式后,第一次获准测试应保持小范围并只读。保存文档 URL、检查日期、账户范围和准确请求标识。把返回标识单独记录,不要覆盖请求标签。如果服务商支持别名,应记录其稳定性说明以及是否提供固定版本。返回名称是有用的诊断证据,但不是关于底层模型权重的独立保证。
| 契约字段 | 要记录什么 | 验收问题 |
|---|---|---|
| 请求表面 | 端点、SDK 版本和文档模型 ID | 这个准确组合是否受支持? |
| 账户权限 | 服务商、区域、项目和授权范围 | 目标生产账户是否有权限? |
| 输出契约 | 流式、schema 行为、完成状态和 usage 字段 | 应用能否识别完整有效结果? |
| 工具契约 | 支持的工具、参数 schema 和授权边界 | 能否拒绝无效或未授权调用? |
| 失败契约 | 错误分类、重试建议和取消行为 | 失败能否结束而不重复执行? |
| 计费契约 | 输入、输出、缓存和其他计费单位 | 能否将请求与账单对上? |
不要因为熟悉的 SDK 就假设每个选项都可移植。推理设置、结构化输出、上下文限制、流式事件和工具语义都需要按版本核验。本文不提供 GPT-6.2 端点或 SDK 调用,因为这里没有独立确立任何一个。契约核验后,应补充一段带检查范围和日期的最小测试请求,而不是猜一个新模型字符串去改旧示例。
超时和重试也应单独验收。客户端超时不代表服务端执行已经停止;中断的流可能包含不完整工具调用。限流应遵循服务商文档中的重试策略并设置上限,不能无限循环。应区分临时容量错误、无效输入、缺少权限和不支持模型,只有适合重试的类别才重试。
所有外部副作用都应放在应用授权之后。模型生成的付款、删除文件或外发消息,不能仅因为工具调用格式正确就执行。评测应使用只读工具、可丢弃 fixture 和可审计审批。这里讨论的是应用设计责任,不是声称 GPT-6.2 具备某种安全能力或工具能力。
可观测性应保存 request ID、时间戳、完成状态、usage 总量和脱敏错误分类,同时避免保存密钥或不必要的客户内容。评测日志要足够诊断回归,也要符合自身数据规则。若返回标识或行为意外改变,应暂停推广并调查,不要把新结果和旧基线混成一张表。
5. GPT-6.2 价格:计算每个合格任务的成本
本文没有确立 GPT-6.2 的已确认价格。传闻文章中的数字、其他版本的价格或订阅计划,都不是已核实的 API 报价。价格正式出现后,应检查货币、计费单位、生效日期、区域和服务商。缓存输入、输出、推理相关用量、工具执行和最低收费,都可能需要分别处理。不要假设这些类别必然存在或必然不存在。
对应用来说,更有用的分母通常是“通过验收的任务”。把每次尝试的全部适用费用加总,包括计费的失败或拒绝输出,再除以通过验收规则的任务数。人工修复成本应单独列出,除非你有一致且可测量的计入方法。名义 token 费率更低,但如果重试和不可用结果更多,合格任务成本仍可能更高。
下面的独立脚本演示算式,费率是虚构的。它不是 GPT-6.2 价格估计,也不代表 ToAPIs 或 OpenAI 的计费。单独运行它只会输出 JSON 摘要;费率、工作量和通过数量都直接写在代码里,方便审阅假设。
import json

input_tokens = 1_000_000
output_tokens = 200_000
input_rate_per_million = 2.00  # Hypothetical USD rate
output_rate_per_million = 8.00  # Hypothetical USD rate
billed_attempts = 100
accepted_tasks = 80
assert 0 < accepted_tasks <= billed_attempts

total = (
    input_tokens / 1_000_000 * input_rate_per_million
    + output_tokens / 1_000_000 * output_rate_per_million
)
print(json.dumps({
    "scenario": "hypothetical, not a provider quote",
    "billed_attempts": billed_attempts,
    "accepted_tasks": accepted_tasks,
    "total_usd": round(total, 4),
    "usd_per_accepted_task": round(total / accepted_tasks, 4),
}, indent=2))
| 假设场景 | 总计费 | 合格任务 | 每个合格任务成本 |
|---|---|---|---|
| 示例 A | $3.60 | 80 | $0.045 |
| 相同花费、通过更少 | $3.60 | 60 | $0.060 |
| 花费更高、通过更多 | $4.00 | 90 | 约 $0.0444 |
这张表说明了质量如何影响经济性,但不能证明哪个模型真实成本最低,因为背后没有匹配的推理测试。实际 GPT-6.2 评测应同时记录尝试次数、计费 usage、重试策略和拒绝原因。延迟要单独报告:首 token 时间、完成时间和得到合格答案的时间回答的是不同问题。要说明测量是否包含网络、工具工作和重试。
6. 通过明确迁移门禁再推广
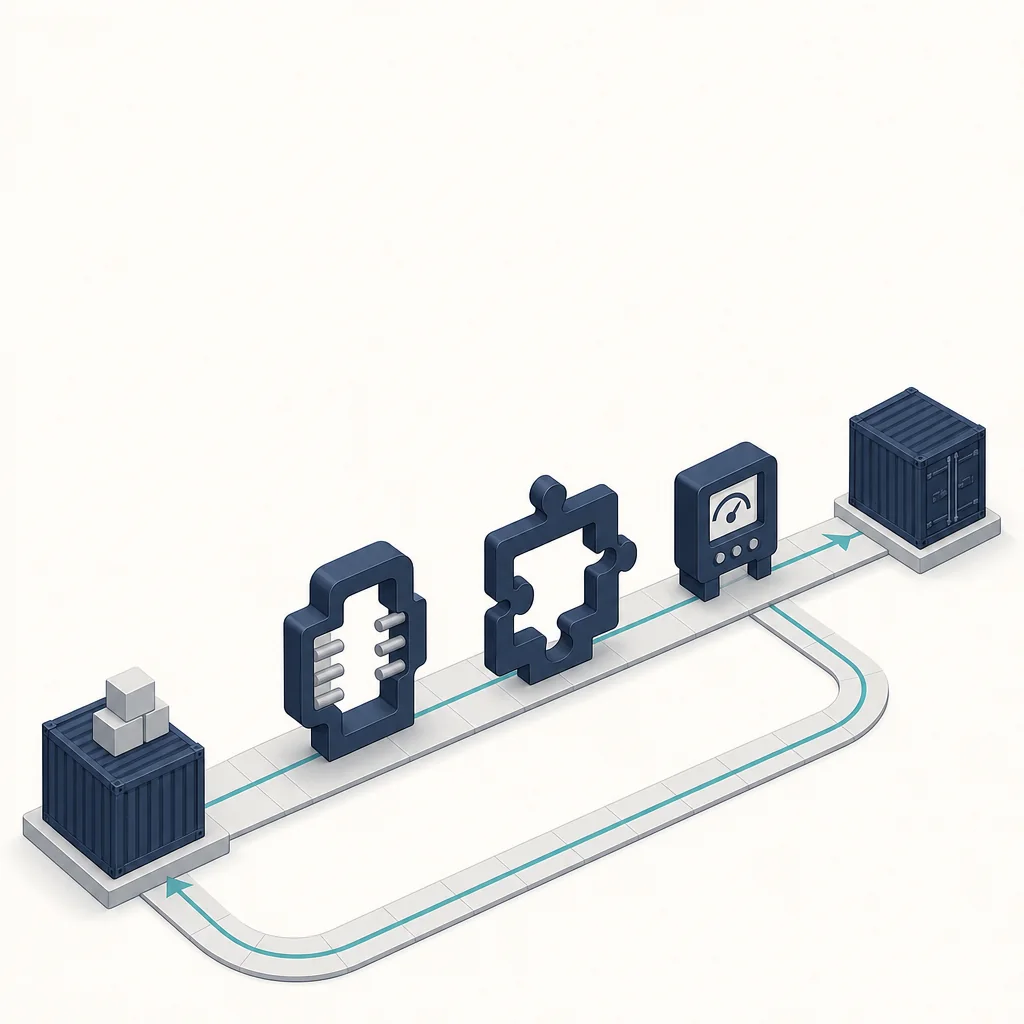
概念图:契约、质量和运行检查全部满足后才进入受限试点,并保留回滚路径。
准备候选适配器时,应保留当前可用模型作为基线。配置需要区分“评测标签”和“服务商文档中的真实模型标识”。未经核验的候选项放在生产白名单之外。这样可以在不把客户流量发送到猜测别名的情况下准备 GPT-6.2 评测。
设置三道门。第一道是契约门,确认请求、账户权限、限制和计费;第二道是质量门,在冻结评测集上使用同一规则和预算比较;第三道是运行门,检查延迟、失败处理、隐私、监控和回滚。通过一道门不能弥补另一道门的失败:漂亮的 demo 修复不了不支持的 schema,低价格也修复不了无效工具动作。
只有通过这些检查后,才适合让明确受限的小流量试点运行。试点开始前要写清停止条件,包括错误率上升、通过率下降、身份异常变化和预算超支。回滚应由应用控制,备用模型也必须满足用户可见契约;如果备用路径不满足输出或隐私要求,应返回受控失败,而不是静默替换不兼容行为。
可以使用模型广场、价格页面和API 文档检查当前支持路径。这些链接是核验入口,不承诺 GPT-6.2 已列出或可访问。不要只根据本文购买或迁移。合格的上线更新应补充准确文档、测试范围和剩余限制,让读者能够复核这项决定。
7. 开发者正在问 GPT-6.2 的问题
GPT-6.2 API 现在可用吗?
本文没有确立公开 API 可用性或 ToAPIs 支持。竞品文章讨论的是可能不同于公开 API 的 Codex 灰度路径。应在目标账户中检查服务商文档和授权。研究环境无法抓取官方页面,不代表不存在;本文也不声称不存在任何私有部署。
CLI 中的模型名称能确认底层模型吗?
不能。客户端接受一个参数,只能证明本地输入被接受。返回的模型字段能为某个响应增加证据,但别名和服务商保证仍需文档确认。记录完整测试条件但不要保存密钥。不要把反复猜测不可用模型标识当成接入策略。
发布日期和价格是多少?
本文没有独立确立官方发布日期或已核实的 GPT-6.2 API 价格。竞品文章是带日期的报道,不是我们的官方确认。本文的数字示例明确是假设。更新发布日期和价格时,应同时提供来源、日期、服务商范围,以及可复现的验收证据(如有)。
GPT-6.2 适合编码吗,是否比 Fable 5.5 更强?
引用的 demo 对比不能回答,因为任务、样本数量和模型归属都不同。应使用固定环境、工具和预算执行相同编码任务,再评估正确性、修复成本、合格任务成本和运行行为。报告结论范围,不要把小样本写成普遍排名。
来源与更新政策
- API易:GPT-6.2 Astra 灰度信号与疑点,2026 年 11 月 2 日——竞品报道,原始主张未在此独立认证。
- API易:Fable 5.5 与 GPT-6.2 Astra 对比,2026 年 11 月 3 日——竞品 demo 讨论,不是本文团队的受控基准测试。
- OpenAI API 模型目录——核验入口;本次研究直接请求返回 HTTP 403。
- OpenAI API 更新日志——核验入口;本次研究直接请求返回 HTTP 403。
后续更新应区分新核实的契约细节和此前报道的线索。加入准确来源与检查日期,在性能主张前发布评测方法,并保留明确限制。以后加入的插图应标注为概念图,除非它记录真实、可复现的测试。任何生成图片都不能被展示为产品截图、官方发布公告或已测得的 GPT-6.2 输出。