
**真正值得问的,不是 Gemini Omni 1.2 Flash 能不能做出好看的短片。**而是模型路由、输入契约、输出质量与计费单位,是否符合你要交付的工作。Omni 1.2 Flash 值得关注,因为同一个模型系列涵盖生成、编辑、延长与超分辨率,同时支持短视频工作流与原生音频。
**资料核对日期:2026 年 11 月 6 日。**本指南综合了 Google 发布公告、Google Cloud GA 公告、Google Cloud 模型文档、EvoLink 模型页面,以及 Segmind、Kingy AI 和 Shattered 的第三方文章。模型事实以 Google 文档为主要来源。EvoLink 与 Segmind 描述的是各自的路由、价格与测试;这些页面都不能证明 ToAPIs 目前提供此模型。
1. Gemini Omni 1.2 Flash 带来什么
Google Cloud 将 gemini-omni-1.2-flash 列为正式发布的多模态模型,适用于视频、图片与文字任务。文档中的能力矩阵包括文字转视频、图片转视频、参考素材转视频、首尾帧视频、视频编辑、视频延长与视频超分辨率。文档也列出 thinking,但此模型不支持系统指令、结构化输出、函数调用或 Gemini Live API。
模型页面记载,生成与编辑的视频输出时长为 3 到 15 秒,首尾帧生成为 3 到 10 秒,延长则会追加 3 到 10 秒。支持的宽高比为 16:9 与 9:16;记载的输出分辨率为 360p、720p、1080p 与 4k。视频输入限制取决于操作:编辑与超分辨率最多接受 15 秒,而延长可依其契约使用较长源视频的末段。
| 能力 | 主要文档的说明 | 集成时要确认的问题 |
|---|---|---|
| 文字转视频 | 由提示词生成视频,时长 3–15 秒 | 所选供应商提供哪些分辨率与音频字段? |
| 图片或参考素材转视频 | 图片与视频参考素材,各路由有各自限制 | 图片顺序与参考素材名称是否具有语义? |
| 首尾帧 | 支持,输出时长 3–10 秒 | 第二张图片是尾帧还是另一个参考素材? |
| 视频编辑 | 编辑最长 15 秒的源视频 | 时长与宽高比是否沿用来源? |
| 视频延长 | 依延长契约增加 3–10 秒 | duration 指追加时长还是输出总时长? |
| 视频超分辨率 | 将支持的来源分辨率升级至 4K | 此操作是否与生成分开计费? |
发布公告强调相较前一代的五项实用改进:可生成 15 秒短片、公布的 720p 价格更低、更能遵循图片与视频参考素材、先以低分辨率生成草稿再升级至 1080p 或 4K,以及对白更自然、唇形同步更清晰,并支持多位说话者情境。Google 也介绍了对话式编辑,例如变更产品、光线或摄像机角度,而不必从头重做。
这些是产品层级的说法,不代表每个供应商都会提供所有控制项。供应商可能把同一模型系列拆成不同 slug、省略某项能力,或增加不同的计费层。务必把确切路由结构视为集成契约。
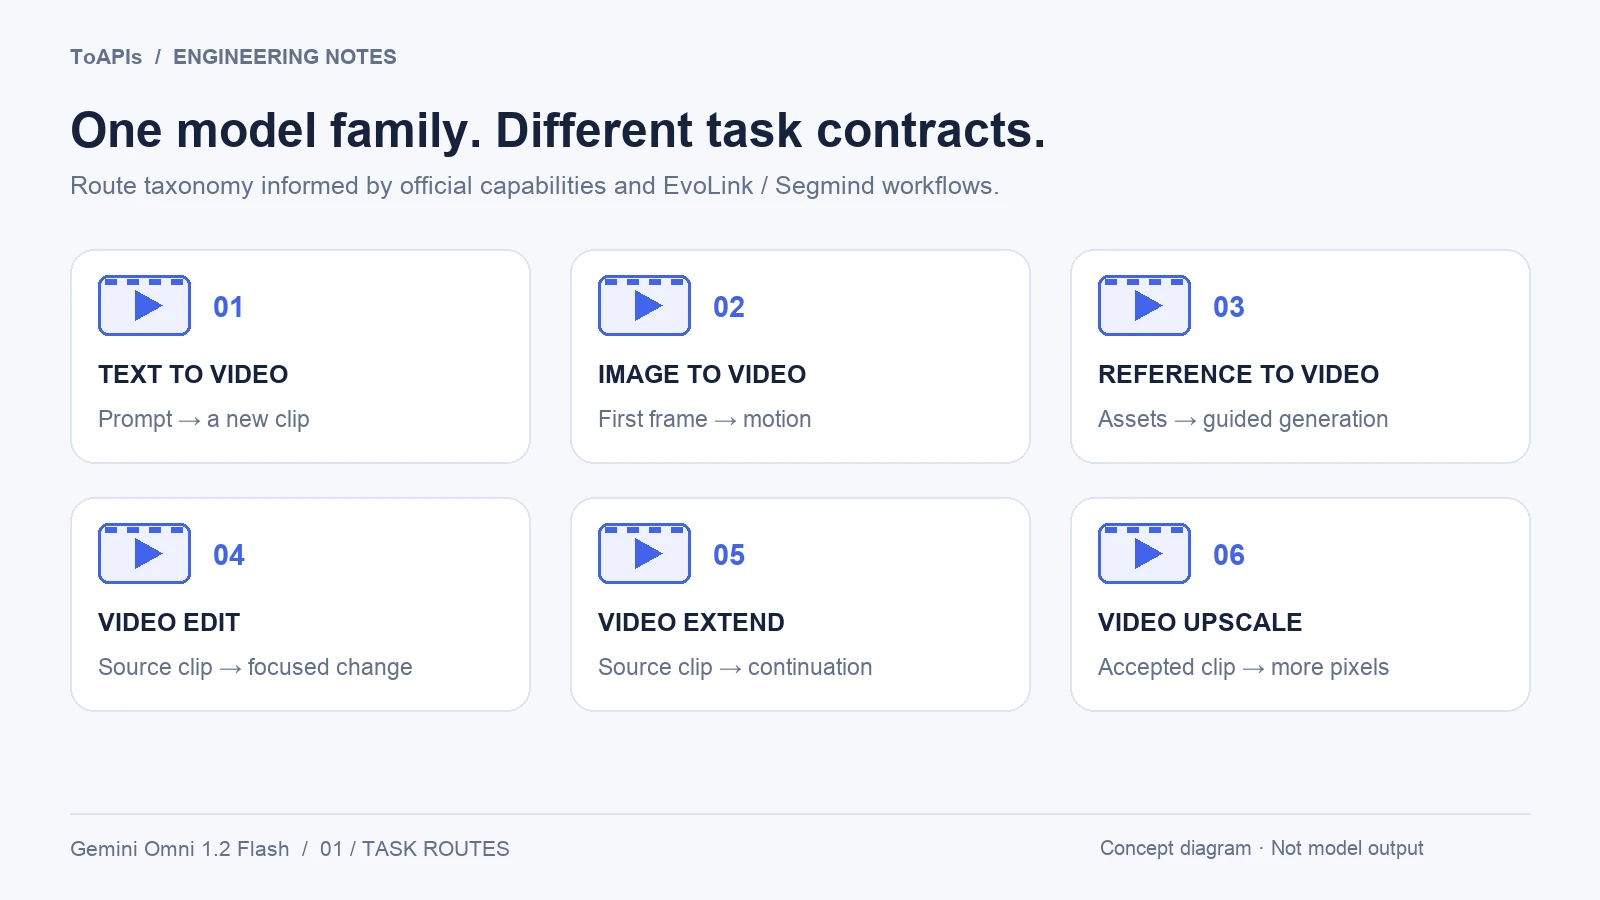
根据官方能力列表与第三方路由说明绘制的原创任务示意图。实际端点因供应商而异,非模型生成结果。
2. 六种路由,六种不同契约
EvoLink 页面在同一个异步视频接口上提供六种任务路由:文字转视频、图片转视频、参考素材转视频、视频编辑、视频延长与视频超分辨率。其模型 ID 有助于理解路由规划,但它们是 EvoLink 识别码,并非已确认的 ToAPIs 识别码。
Segmind 的评测提供另一种以路由为主的观点,并明确指出其发布测试中无法使用 refine 路由。这正说明了为何不能只凭吸引人的能力清单,就在未即时检查结构的情况下将字段照搬进产品表单。
| 路由 | 常见输入 | 需要验证的主要边界 |
|---|---|---|
| 文字转视频 | 提示词 | 3–15 秒;分辨率、比例、音频与 seed 可能因供应商而异 |
| 图片转视频 | 首张图片与提示词 | 第二张图片可能指定尾帧;确认最长时长 |
| 参考素材转视频 | 参考图片或视频及提示词 | 数量、时长与参考素材命名规则各有不同 |
| 视频编辑 | 源视频与一项明确修改 | 来源长度、安全筛选,以及输出是否沿用来源构图 |
| 视频延长 | 既有视频与续接提示词 | 新增时长不一定等于总时长 |
| 视频超分辨率 | 既有视频,通常不需提示词 | 可接受的来源尺寸、输出级别与单独计费 |
路由选择器应一并切换验证规则、说明文字与成本预估。不要让通用的 duration 字段在不知不觉中,把延长路由的语义带入生成路由。也不要假设 image_urls 字段在图片转视频与参考素材转视频请求中代表相同意思。
不要混用 Google Cloud 与 Gemini API 的限制
Gemini API 指南记载最多六张参考图片,而 Google Cloud 模型页面列出每个提示词最多十张图片。Gemini API 的视频参考限制也会随请求时长而异:11–15 秒的较长生成仅支持一段较短的参考视频,并不适用于 3–10 秒工作所能使用的相同参考素材额度。这些是不同平台的契约,不是互相矛盾、可以取平均或合并的数值。
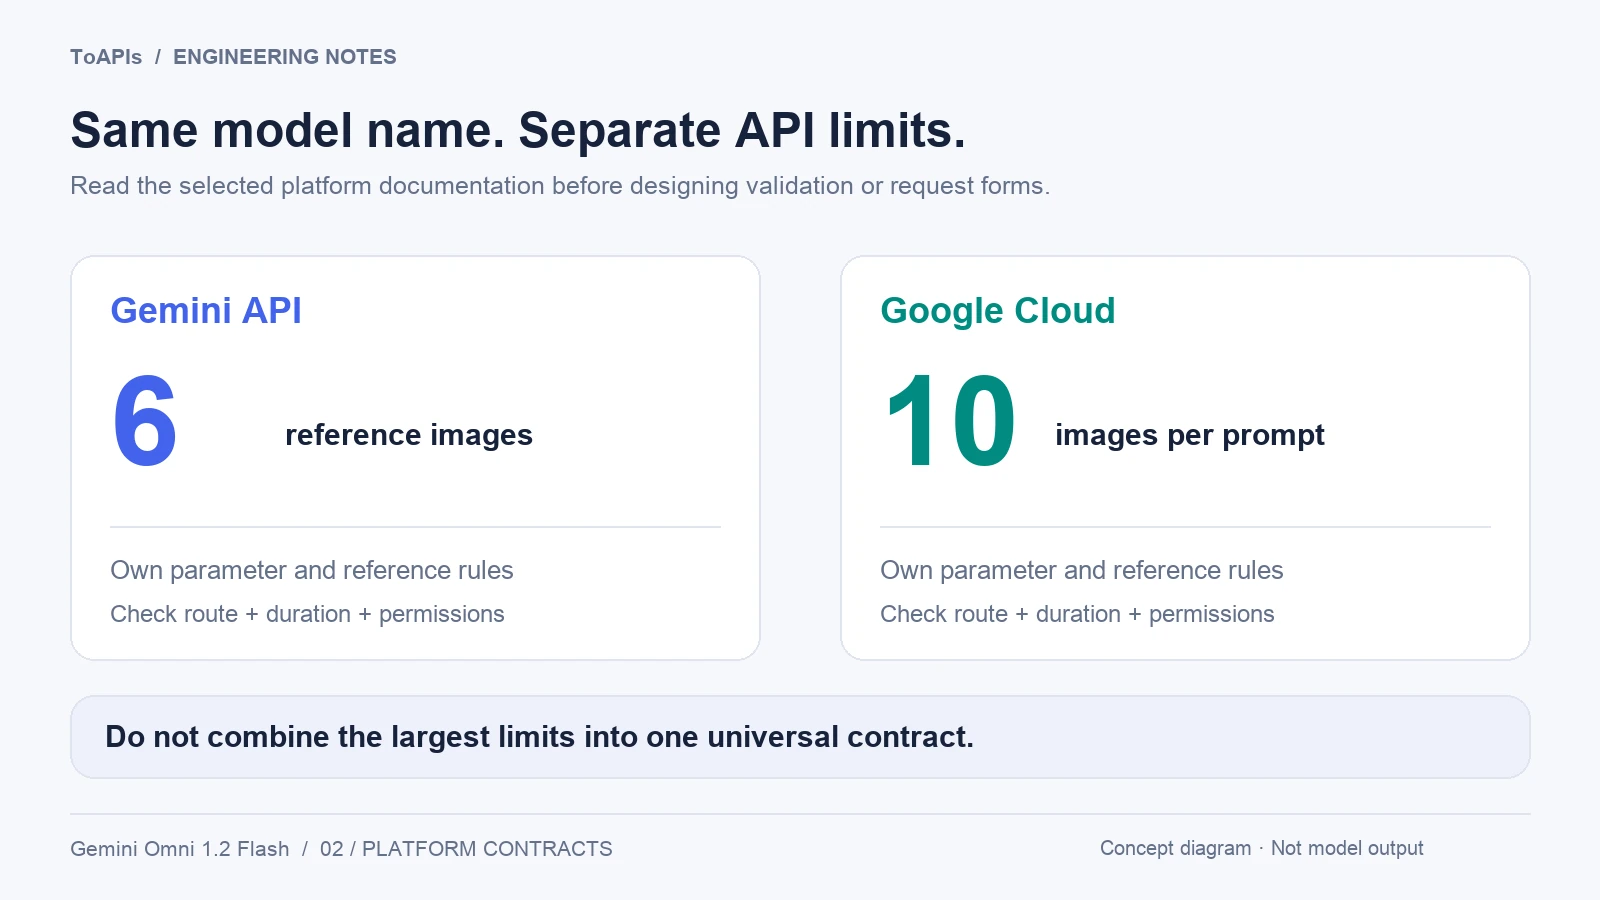
不同平台契约:Gemini API 最多六张参考图,Cloud 文档每个提示词最多十张图。上限不可拼接,仍需核对具体路由和时长。
Gemini API 的文档集成方式是 Interactions API,不是 generate_content、OpenAI chat-completions 调用或 Veo 专用的 generate_videos 方法。以下是经调整的付费调用示例,不是 ToAPIs 请求。它需要目前版本的 google-genai SDK、符合资格的账户,以及在本地设置好的密钥;绝不可把凭据放进提示词或浏览器软件包。本篇文章没有执行此示例。
import base64
from pathlib import Path
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input=(
        "A blue ceramic cup on a neutral table. "
        "One continuous slow camera push-in. "
        "Soft room ambience, no speech, no text."
    ),
    response_format={
        "type": "video",
        "resolution": "360p",
        "duration": "5s",
        "aspect_ratio": "16:9",
    },
)
Path("omni-draft.mp4").write_bytes(
    base64.b64decode(interaction.output_video.data)
)
print("interaction ID:", interaction.id)
在此 API 中,duration 是类似 "5s" 的字符串,不是从网关表单复制来的整数;生成控制项位于 response_format 之下。对于较大的文件,指南记载可通过 URI 传递并处理文件就绪状态。多轮编辑使用 previous_interaction_id;设置 store=false 会移除后续工作流所需的已存储状态。请先评估这些取舍,不要盲目照抄延迟设置。
3. 分辨率策略:先生成草稿,再选择性升级
Gemini API 指南明确将 360p 与 720p 列为原生生成级别,并将 1080p 与 4K 列为升采样输出。因此,提供 4K 交付选项并不能证明模型原生生成 4K。发布资料中最实用的工作流,是将探索与交付分开。使用 360p 或 720p 反复调整提示词并检查构图。短片通过验收清单后,可直接以较高分辨率重新生成,或将选定的来源送入文档记载的升级路由。
这种策略可减少浪费在高分辨率生成上的成本,但也增加了需要衡量的第二项操作。升级工具可以增加细节,却不会改变原有动态,也无法修正糟糕的构图。它不能保证错误的标签、不稳定的面部或不正确的物体移动在 4K 下就会变正确。
在工作记录中保留来源分辨率、输出分辨率、路由、时长与 token 用量。使用相同来源、裁切与验收标准,比较原生高分辨率输出和升级后输出。Segmind 的第三方评测指出,超分辨率能带来实用细节,但也将其视为需计费的工作流步骤,而不是所有原生生成都可免费替代的方案。
生产环境应设置两道关卡:
- 创意关卡:主体身份、构图、动态、文字、对白与声音均符合需求。
- 交付关卡:尺寸、时长、编解码器、音轨、权利与文件保留均符合下游要求。
只有同时通过两道关卡的短片,才应进入最终素材库。
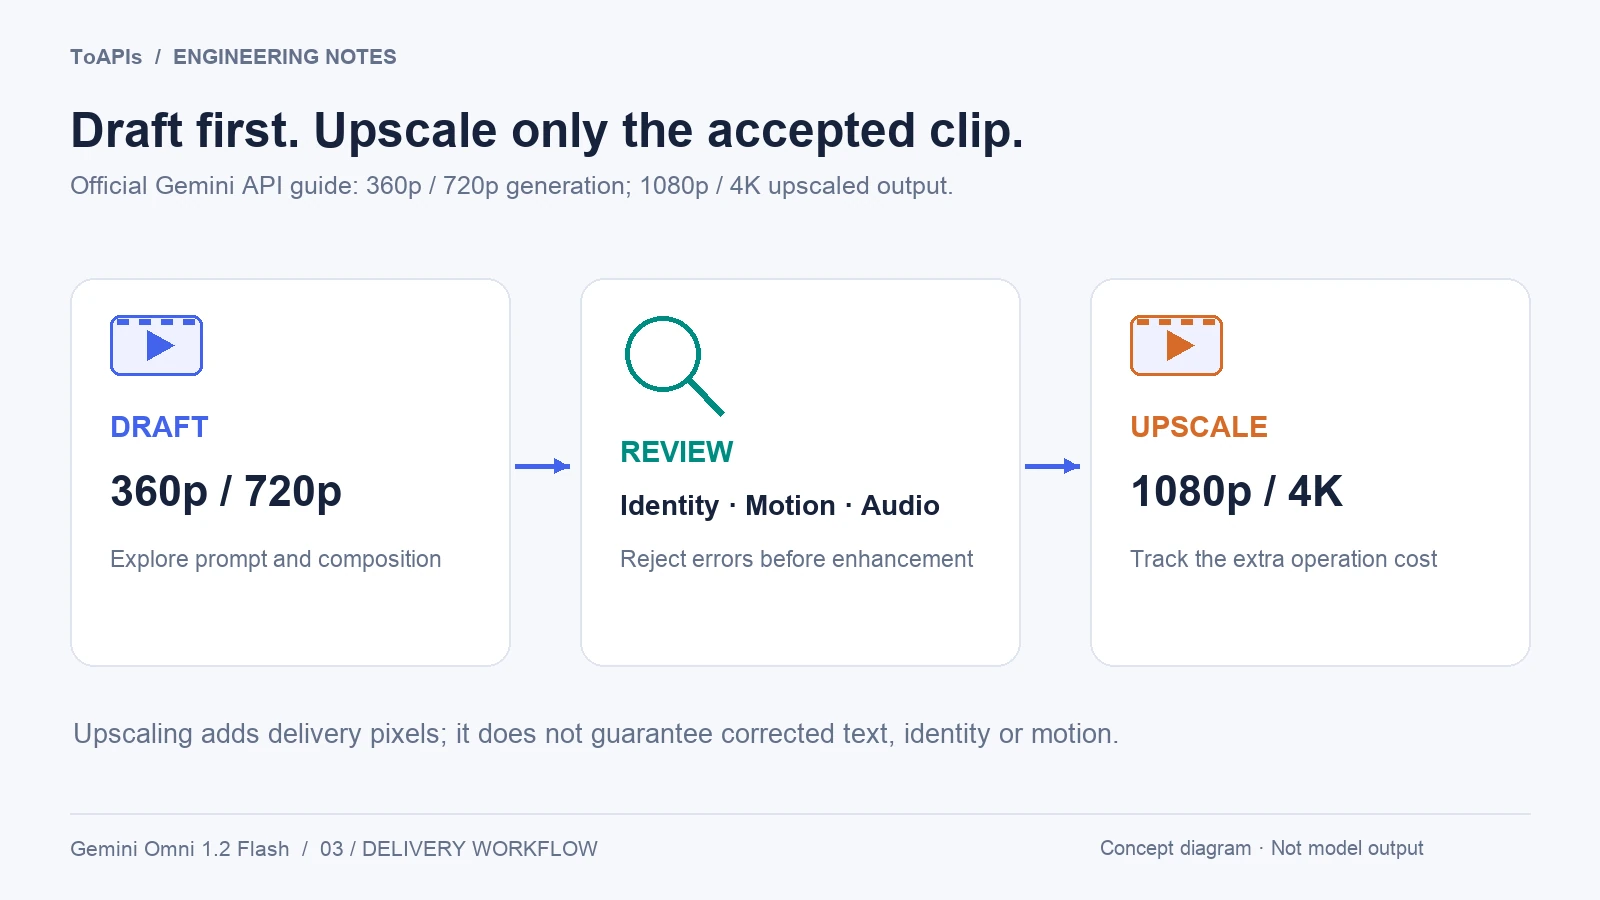
依据 Gemini API 指南绘制的流程示意。高分辨率交付采用升采样,并不保证修复运动、文字或主体一致性问题。
4. 针对精确遵循指令的视频撰写提示词
当第三方测试揭示了应该检查什么,而不是被当成普遍基准宣称时,才特别有助于提示词设计。Segmind 报告指出,模型在有标注的解说视频、动态字体、依提供的尾帧制作图表动画、风格化动态图像,以及对实景视频进行单项修改方面表现良好。同一评测也指出,从零开始生成写实人物、只凭数字绘制数据图,以及某些多步骤或品牌标志编辑的效果较弱。
稳健的 Omni 提示词应分别说明:
- 主体及其可见身份;
- 场景中按顺序发生的节拍;
- 摄像机运动,以及必须保持固定的内容;
- 精确的画面文字,并以引号另外标记;
- 对白、音乐与音效;
- 最终状态,若路由支持,最好以尾帧输入固定;
- 编辑时要保留的一项修改,以及所有必须维持不变的内容。
例如:
Create a flat 2D motion-graphics explainer in 16:9.
Show the title 'HOW A PRODUCT VIDEO API WORKS' exactly as written.
First show one product photo, then three labelled route cards from left to right,
then connect the cards to one finished video frame.
Keep every label fixed after it appears. Use a locked-off camera.
Add a short, calm voiceover and a soft click for each route card.
End on the complete diagram. Do not add any other text or logos.
这份需求是建议的测试,不是经实测的 Omni 输出。相较于「电影感」或「容易疯传」等形容词,验收规则更有用:每个标签都必须准确匹配、顺序正确、摄像机保持固定,音频只能包含指定的声音元素。
5. 原生音频、参考素材与编辑
官方文档列出支持语音、音乐与音效,Google 的发布文章则强调更自然的对白、更清晰的唇形同步,以及可区分多位说话者的情境。Google Cloud 公告也指出,音频参考素材须经白名单核准。这代表音频需要单独检查能力与权限,不能只在通用视频表单中放一个复选框。
参考素材一致性是此模型的主要主题之一。Google 表示模型更能遵循图片与视频参考素材,官方模型页面也支持参考素材生成。然而,支持参考素材不等于保证身份一致。请在整段短片中检查面部、服装、产品轮廓、可见标记、光线与动态。
对话式编辑也是一种工作流概念,不一定对应单一通用端点。发布资料描述了在同一短片中变更产品、光线或摄像机角度。供应商可能通过视频编辑、interaction ID、前一项任务参照,或不同的请求体来实现。将假设写入数据库之前,请先确认契约。
每次编辑都应记录:
- 源视频及其权利;
- 精确的一项修改指令;
- 必须保持不变的内容;
- 路由与模型 ID;
- 返回的任务或 interaction ID;
- 音频与安全审查结果。
这些记录能让失败的编辑便于诊断,也能让成功的编辑具备足够的可重现性以供审查。
6. Token 定价不等于 ToAPIs 报价
Google 的发布资料公布了 720p 视频的供应商价格,并说明相较前一模型有所降价。EvoLink 页面提供自己的 token 计算器、折扣与各路由价格。Kingy AI依 token 假设推算 720p 每秒估价,而 Shattered则以公布的每秒价格介绍此次发布。这些数字不可互换。
截至 2026 年 11 月 6 日核对的 Gemini API Standard 定价表列出:文字、图片与视频输入每百万 token 为 USD 1.50;包含 thinking 在内的文字输出每百万 token 为 USD 9.00;视频输出每百万 token 为 USD 12.00。此模型没有免费层。这些是该平台的供应商牌价,不是 ToAPIs 报价。
同一张定价表列出 720p 每秒视频输出 5,792 tokens。因此,15 秒 720p 短片的示意视频输出费用为 15 × 5,792 × 12 / 1,000,000 = USD 1.04256,尚未计入输入与文字/thinking 输出费用。这解释了发布标题约 USD 0.07/秒的四舍五入估值,但不能将其视为固定的全包费用。价格、token 规则与网关加价都可能变动。
生产环境的成本模型应列明:
| 成本维度 | 应保留的数据 |
|---|---|
| 供应商或网关 | 确切供应商、模型 ID 与日期 |
| 计费单位 | 秒数、视频输出 tokens、输入 tokens、thinking tokens 或套餐 |
| 分辨率乘数 | 原生输出与超分辨率操作 |
| 输入媒体 | 图片、源视频及其 token 计费规则 |
| 重试与拒绝政策 | 安全、验证或传输失败是否收费 |
| 验收产出率 | 尝试次数除以通过交付清单的短片数 |
若要估算假设性的 token 方案,请写出公式,不要照抄竞争对手报价:
raw generation cost = input tokens × input rate
                    + video output tokens × video rate
                    + thinking tokens × thinking rate
workflow cost = raw generation cost
              + accepted retries
              + storage, transfer and review time
cost per accepted clip = workflow cost / accepted clips
在当前目录或报价端点确认模型、SKU、单位与账户适用费率之前,不要发布 ToAPIs 价格。也不要宣称第三方测得的延迟或成本适用于其他网关。
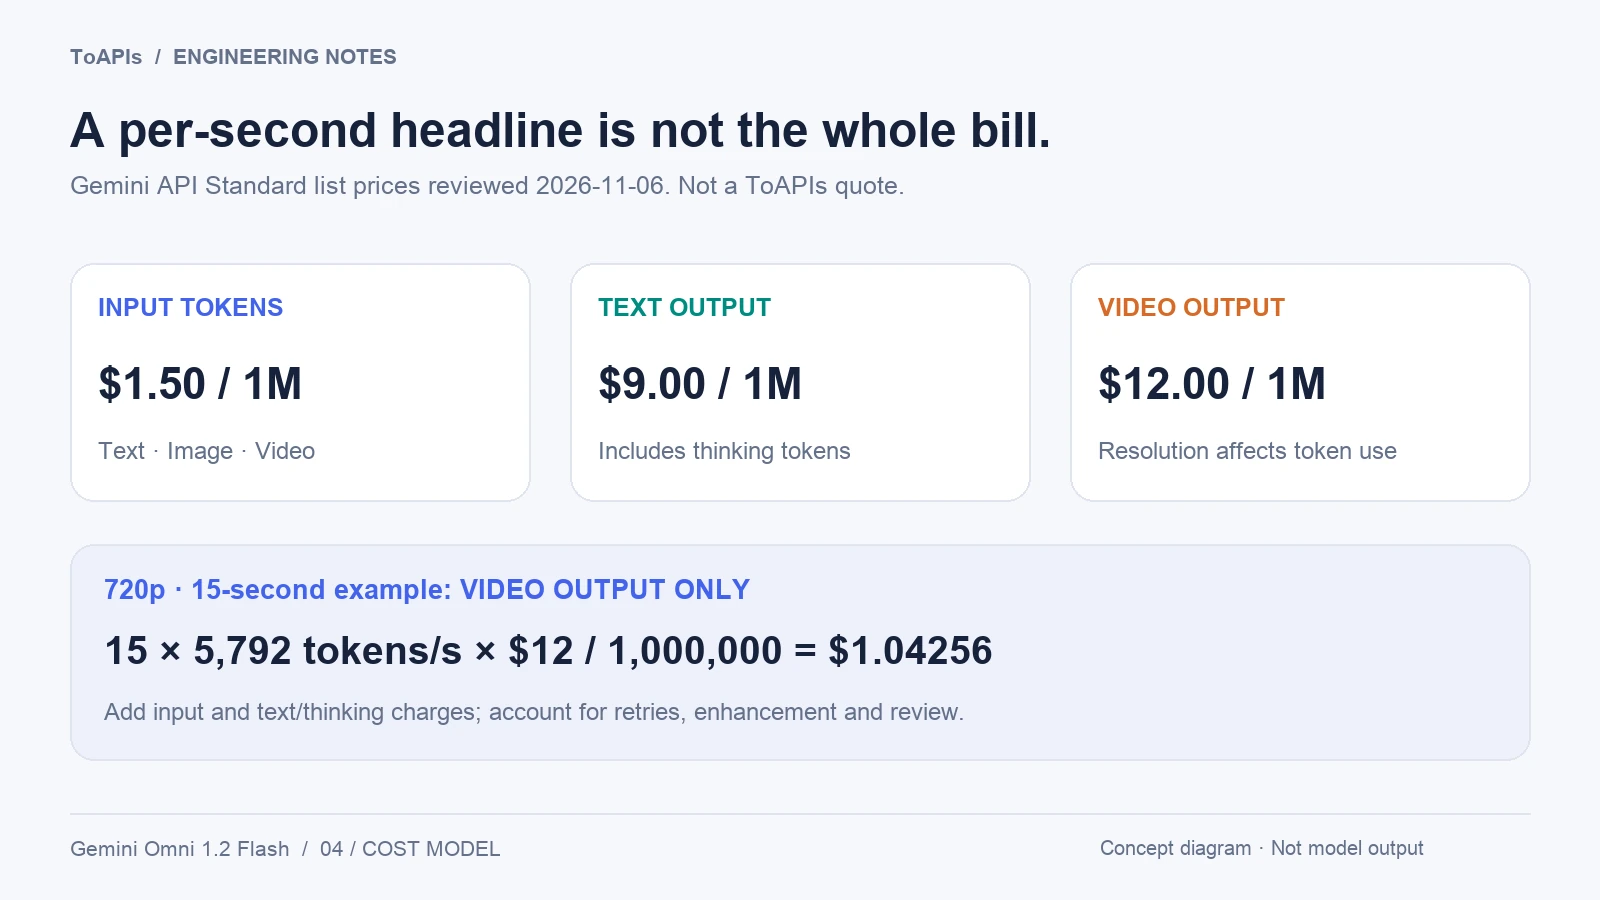
供应商标价示意,查阅于 2026 年 11 月 6 日,非 ToAPIs 报价。例中 USD 1.04256 仅包含视频输出,输入与文本/思考输出另计。
7. 生产环境上线前建立验收测试包
在应用程序中启用此模型之前,请执行一组小型、可重复的测试:
- 文字转视频:包含标注、按顺序节拍与明确音频提示的解说视频。
- 图片转视频:以产品首帧为起点,并指定必要的最终状态。
- 参考素材转视频:同一主体的多种视角,并附上连续性检查清单。
- 视频编辑:修改一段实景短片中的一项内容,同时保留原有表演。
- 视频延长:摄像机方向与声音应自然延续的镜头。
- 超分辨率:以同一支通过验收的草稿,对照原生高分辨率生成。
每项测试都记录模型 ID、路由、输入、提示词、支持时可用的 seed、分辨率、时长、任务 ID、排队时间、处理时间、输出 token 或计费数据、音频结果与验收判定。保留失败案例,不要只挑选最佳示例。
将第三方评测视为待验证的假设。例如,Segmind 的 20 项测试评测很有参考价值,因为它同时列出优点与失败案例;但其计费价格、延迟与供应商行为都属于 Segmind 的环境,并非所有 Gemini Omni 1.2 Flash 集成的独立基准测试。
8. 可用性与集成检查清单
Google 官方模型 ID 为 gemini-omni-1.2-flash,但仅有模型 ID 并不代表网关已启用此模型。通过 ToAPIs 集成前,请核对模型目录、目前定价与请求文档。确认确切路由、账户使用权限、请求体、异步状态模型、结果保留期限与计费政策。
若路由不存在或无法取得报价,请维持功能停用,或标记为即将发布。不要默默把其他 Gemini 模型映射到相同的营销名称。只有在已通过身份验证的调用成功,且返回的媒体经过审查后,才能宣称完成了即时生成。
来源与更新政策
- Google:Gemini Omni 1.2 Flash:15 秒视频与更低价格 — 2026 年 11 月 5 日官方发布公告。
- Google Cloud:Gemini Omni 1.2 Flash 现已正式发布 — 正式发布、企业情境与发布说明。
- Google Cloud 模型文档 — 模型 ID、能力、限制与发布状态。
- Gemini API Omni 指南 — Interactions API、平台专属参考素材、超分辨率级别与编辑状态。
- Gemini API 定价 — Standard token 费率与视频 token 换算;这是供应商价格,不是 ToAPIs 报价。
- EvoLink Gemini Omni 1.2 Flash API 页面 — 网关路由、计算器与供应商专属定价呈现。
- Segmind:Gemini Omni 1.2 Flash 测试 — 第三方测试、路由观察、提示词与计费工作流背景。
- Kingy AI:规格、基准测试、定价与可用性 — 第二手规格与价格概览;不是独立的 1.2 基准测试。
- Shattered:Gemini Omni 1.2 Flash 正式发布 — 第二手发布与成本概览;预测不视为事实。
更新本指南时,任何变更的能力或价格都应记录供应商、模型 ID、来源 URL 与核对日期。供应商价格、网关报价与第三方测试应分开处理。本指南不宣称 ToAPIs 已提供此模型、不宣称已进行经过身份验证的生成、不宣称有普遍适用的基准测试,也不保证生产环境结果。