








Guia da API GPT-Image-2.6: Flare, Sunburst, GIF e SVG
A solicitação que arruína um sprint de imagens quase nunca é a imagem principal. É o pedido seguinte: "A mesma chamada pode devolver um GIF? Podemos receber o logo em SVG? O design consegue mover a caneca dois centímetros para a esquerda sem regerar a cena inteira?" Um pipeline construído em torno de um único PNG achatado responde às três com um projeto novo.
A OpenAI lançou o Images 2.6 em 4 de novembro de 2026, e a API agora cobre esses pedidos: duas variantes de modelo, saída GIF e SVG, edições guiadas por markup e um controle separado de complexity. O problema é que a nova superfície chegou mais rápido do que todas as páginas de referência foram atualizadas. Este guia entrega uma integração executável da API GPT-Image-2.6 e depois aponta os pontos exatos em que você deve confirmar um limite antes de fixá-lo no código.
TL;DR
- Dois modelos, uma tabela de tarifas.
gpt-image-2.6-flareé o caminho de iteração rápida;gpt-image-2.6-sunburstbusca mais qualidade, mais detalhe e consistência de edição mais forte em qualidade média ou alta. Os dois usam as mesmas tarifas por tokens.- Novos recursos de API. Saída GIF, saída SVG, edições guiadas por markup e um parâmetro
complexity. Geração e edição continuam em endpoints separados.- Cobrança por tokens, não por imagem. A saída de imagem custa $30 por 1M de tokens; a entrada de imagem custa $8 por 1M ($2 em cache); a entrada de texto custa $5 por 1M ($1.25 em cache).
- A documentação se contradiz em três pontos. O
frame_countdo GIF, o suporte de markup por modelo e partes da referência de qualidade e tamanho. Verifique na sua conta antes de impor um limite rígido.
1. O que chegou com a API GPT-Image-2.6
O Images 2.6 é a geração de 4 de novembro de 2026, disponível no ChatGPT, no Codex e na API. A OpenAI afirma que ele gera imagens 50% mais rápido que a geração anterior. É uma afirmação do fornecedor sobre a velocidade de geração, não uma promessa sobre a sua latência p95, e não diz nada sobre preço: a cobrança continua por tokens.
Os dois identificadores de modelo atendem a trabalhos diferentes:
gpt-image-2.6-flarefoi feito para iteração rápida. Comquality=low, a OpenAI descreve uma geração em cerca de 6 segundos, o que o torna o padrão para explorar prompts, thumbnails e pré-visualizações de interface em que "bom o suficiente agora" vence "perfeito depois".gpt-image-2.6-sunburstbusca mais qualidade e detalhe, com consistência de edição mais forte emquality=mediumouhigh. Use para ativos finais e para edições em que as partes sem alteração precisam sobreviver.
Os dois modelos compartilham as tarifas por tokens, então a decisão é sobre taxa de aceitação e latência, não sobre um identificador de modelo mais barato. Se você está migrando da geração anterior, o guia da API GPT Image 2 explica o formato de solicitação compartilhado; este artigo foca no que o 2.6 adiciona. O guia do modelo GPT-Image-2.6 é o lugar para verificar a disponibilidade na sua conta.
A API é compatível com a OpenAI. Os exemplos abaixo apontam para https://api.toapis.com/v1; se você os direcionar para outra URL base compatível, mantenha o payload e altere a URL base e a chave.
2. Sua primeira solicitação à API GPT-Image-2.6
Comece pela geração. Esta chamada curl pede ao Flare um rascunho quadrado com qualidade e complexity baixas, o teste rápido mais sensato:
curl -sS https://api.toapis.com/v1/images/generations \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-flare",
    "prompt": "Paper-cut football stadium at night, layered cardstock, rim light, no text",
    "size": "1024x1024",
    "quality": "low",
    "complexity": "low",
    "n": 1
  }' -o flare-response.json
Inspecione a resposta antes de escrever um downloader. Dependendo do modelo e das opções da solicitação, APIs de imagem costumam devolver uma URL ou dados base64; um cliente que assume data[0].url falha com uma resposta base64 válida. O auxiliar abaixo trata os dois casos e serve para todos os exemplos deste artigo:
import base64
import os
import pathlib
import requests

API = "https://api.toapis.com/v1/images/generations"
HEADERS = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}


def generate(model: str, prompt: str, output: str, **params) -> str:
    payload = {"model": model, "prompt": prompt, "n": 1, **params}
    response = requests.post(API, headers=HEADERS, json=payload, timeout=180)
    response.raise_for_status()
    item = response.json()["data"][0]
    target = pathlib.Path(output)
    if item.get("b64_json"):
        target.write_bytes(base64.b64decode(item["b64_json"]))
    else:
        target.write_bytes(requests.get(item["url"], timeout=60).content)
    return str(target)


if __name__ == "__main__":
    prompt = "Paper-cut football stadium at night, layered cardstock, rim light, no text"
    generate("gpt-image-2.6-flare", prompt, "flare-draft.png",
             size="1024x1024", quality="low", complexity="low")
    generate("gpt-image-2.6-sunburst", prompt, "sunburst-final.png",
             size="1536x1024", quality="high", complexity="high")
O timeout de 180 segundos é intencional. Prompts complexos podem levar até cerca de dois minutos, então um timeout de 30 segundos no cliente rejeita trabalho que o servidor ainda pode concluir. Se o seu produto não consegue manter uma solicitação por tanto tempo, use uma fila de tarefas em vez de encurtar o timeout e tentar de novo às cegas.
3. Flare vs Sunburst: escolher modelo na API GPT-Image-2.6
A comparação útil não é "qual modelo é melhor". É "qual modelo é aceito nesta tarefa com latência e custo aceitáveis". Um rascunho do Flare rejeitado pode custar mais do que uma imagem do Sunburst que é entregue.
| Trabalho | Melhor primeira escolha | Por quê |
|---|---|---|
| Explorar 20 direções de prompt | gpt-image-2.6-flare | A geração em baixa qualidade é o caminho rápido; descarte cedo as direções ruins |
| Thumbnails e placeholders de interface | gpt-image-2.6-flare | Velocidade importa mais que detalhe fino |
| Imagem principal final | gpt-image-2.6-sunburst | Mais qualidade e detalhe em ajustes médios ou altos |
| Edição que precisa preservar a identidade | gpt-image-2.6-sunburst | Consistência de edição mais forte em qualidade média ou alta |
| Primeira passada em alto volume | gpt-image-2.6-flare | Mesmas tarifas por tokens, mas menos segundos por tentativa |
| Experimento de formato (GIF/SVG) | Qualquer um, depois repita | Confirme o suporte de formato antes de otimizar a qualidade |
Rode os dois modelos com os mesmos prompts e o mesmo tamanho de saída, mude uma variável por vez e revise os resultados às cegas. Registre taxa de aceitação, latência p50/p95 e metadados brutos da resposta: modelo solicitado e devolvido, qualidade, complexity, tamanho, formato, consumo de tokens quando presente e tempo decorrido. Uma amostra atraente não prova que um modelo é melhor.
Um padrão prático: Flare em qualidade baixa para explorar e depois Sunburst em qualidade alta para a direção escolhida. Reaproveite o prompt, mas não espere uma segunda imagem idêntica pixel a pixel. Se a consistência importa, teste uma edição em vez de uma geração nova.
4. Qualidade e complexity na API GPT-Image-2.6
quality aceita low, medium, high, xhigh, max ou auto. O padrão é auto. A maioria das equipes precisa apenas de três pontos de operação:
lowquando a latência domina e a imagem é descartável.mediumouhighquando a saída é revisada ou entregue.xhighoumaxpara ativos finais em que o detalhe justifica o trabalho extra.
Latência e consumo de tokens variam conforme a carga. Não copie os preços por imagem do 2.5; o 2.6 cobra por tokens.
complexity é separado: low, medium ou high, com high como padrão no guia. Não tem tarifa própria, mas ajustes mais altos podem adicionar latência e mudanças indesejadas. Trate-o como uma variável de aderência ao prompt a ser testada, não como um upgrade gratuito de qualidade: uma solicitação de complexity baixa pode ser mais rápida, enquanto uma de complexity alta pode resolver uma cena cheia ou "melhorar" partes que você queria deixar intactas. Faça um pequeno teste A/B com os seus próprios prompts.
| Teste | quality | complexity | O que você aprende |
|---|---|---|---|
| Piso de latência | low | low | A resposta realista mais rápida para o prompt |
| Comportamento padrão | auto | high (padrão documentado) | O que um cliente sem configuração recebe |
| Checar desvios | high | low | Se complexity mais baixa reduz mudanças indesejadas |
| Detalhe final | high ou xhigh | high | Se o trabalho extra melhora a aceitação |
Gere uma variável por vez. Se você mudar qualidade e complexity juntas, um resultado ruim não diz nada sobre qual botão causou o problema.
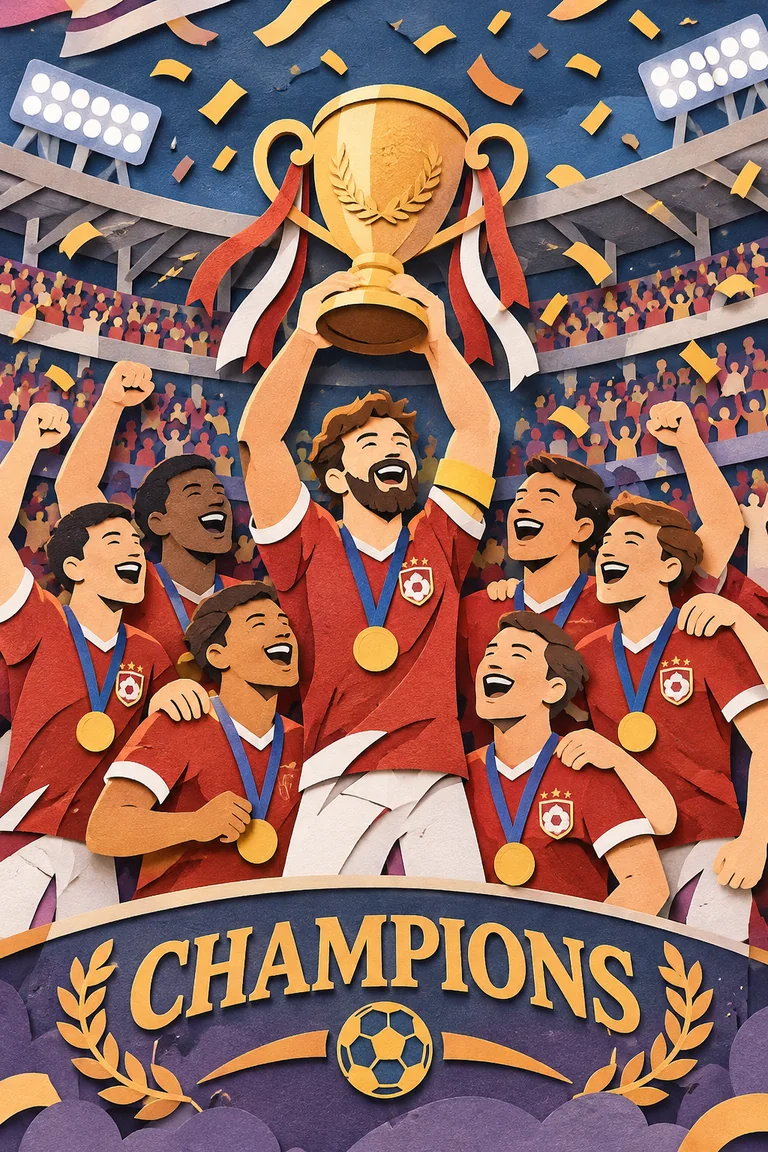
Exemplo de GPT-Image-2.6 em qualidade média: papelão em camadas e luzes de estádio. Saída ilustrativa, não um benchmark.
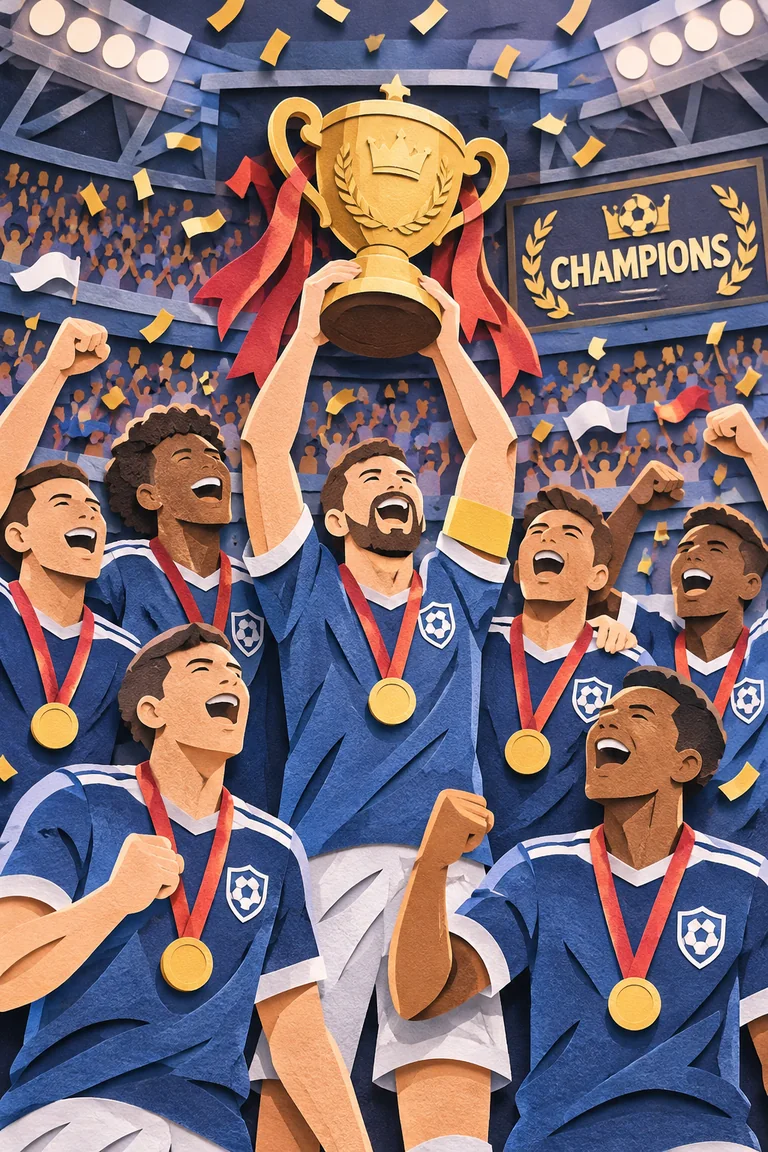
Exemplo de GPT-Image-2.6 em qualidade alta: mais detalhe de superfície e bordas mais definidas. Compare a aceitação, não a nitidez, no tamanho de exibição.
5. Saída GIF pela API GPT-Image-2.6
GIF existe apenas na geração. Defina output_format como gif em POST /v1/images/generations; as edições não aceitam. Os controles são:
frame_count: padrão9. O guia de imagem diz2-64; a referência da API diz2-16. O conflito não está resolvido, então não fixe 64 no código sem uma verificação real.frame_duration_ms: padrão200, mínimo20. Nove quadros a 200 ms geram uma passagem de 1,8 segundo; 16 quadros geram 3,2 segundos. Isso é aritmética, não garantia de movimento fluido.
generate(
    "gpt-image-2.6-flare",
    "A paper lantern monkey swinging through a bamboo forest, simple background, no text",
    "monkey-lantern.gif",
    size="1024x1024",
    quality="low",
    output_format="gif",
    frame_count=9,
    frame_duration_ms=200,
)
Comece com os 9 quadros padrão. Se precisar de mais, suba em passos pequenos e pare na primeira rejeição; isso mostra o que a sua conta aceita hoje. Mantenha a cena simples, porque um GIF multiplica decisões visuais por quadro. Acompanhe o tamanho do arquivo entregue e as dimensões, não apenas o status HTTP.
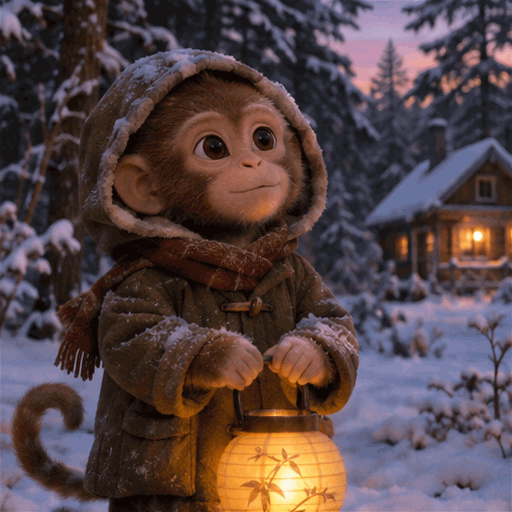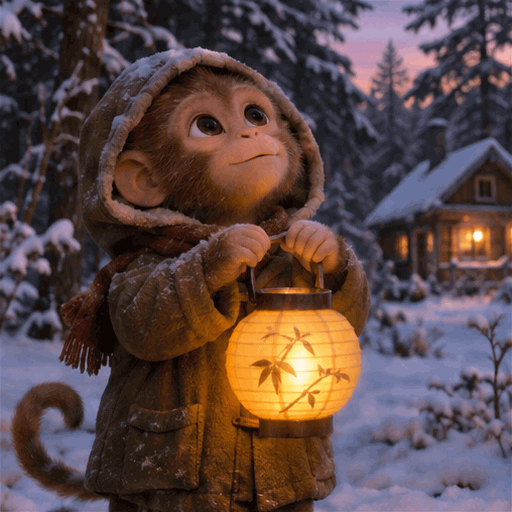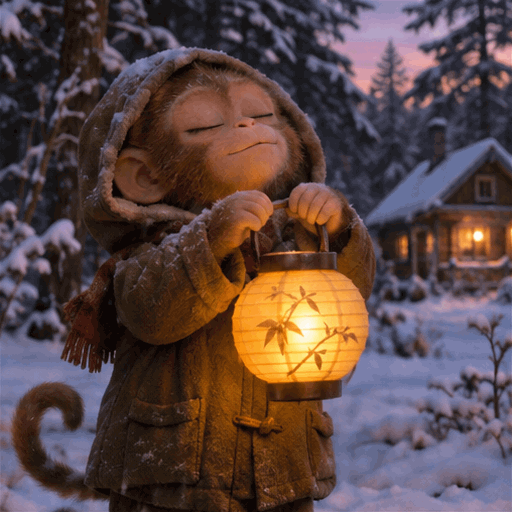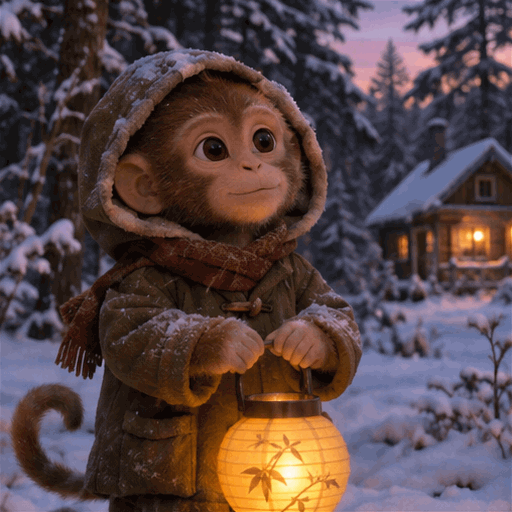
Exemplo de GPT-Image-2.6: um GIF animado curto gerado em uma única chamada. A quantidade de quadros e a duração dependem dos ajustes solicitados.
Trate o GIF como formato de pré-visualização, não como ativo principal. Guarde os ajustes e, quando possível, um quadro estático para thumbnails e alternativas de acessibilidade.
6. Saída SVG pela API GPT-Image-2.6
SVG também é apenas geração. Defina output_format como svg, mantenha n=1 e espere saída vetorial estática. Restrições documentadas: sem streaming, sem imagens parciais, sem compressão e sem prompt_rewriter. As edições não aceitam SVG.
generate(
    "gpt-image-2.6-sunburst",
    "A minimal field-and-flour bakery label, wheat stalk and rolling pin, two-color vector, no text",
    "field-and-flour.svg",
    size="1024x1024",
    quality="high",
    output_format="svg",
    n=1,
)
Rejeite n>1 no seu cliente. Não envie output_compression e não espere renderização progressiva; o SVG chega como um ativo estático completo. Como SVG é marcação, trate o arquivo como não confiável: sirva como imagem ou sanitize antes de embutir. Um vetor que parece correto mas tem elementos inesperados é um problema de segurança.
SVG serve para ícones, rótulos, diagramas e marcas de impressão que mostrariam um upscale de bitmap. Não serve para fotos, animação ou fluxos de edição. Para revisar um vetor, regenere com um prompt mais preciso ou refaça em uma ferramenta de design; não prometa camadas editáveis sem inspecionar a estrutura.
Exemplo de GPT-Image-2.6: saída SVG estática para um rótulo simples de duas cores. Inspecione a marcação devolvida antes de servir embutida.
7. Edições guiadas por markup na API GPT-Image-2.6
A edição guiada por markup envia uma imagem de origem mais uma camada PNG transparente para POST /v1/images/edits. A camada é desenhada sobre a primeira imagem e precisa corresponder às suas dimensões. A primeira imagem e a camada podem ter no máximo 16.777.216 pixels cada; o arquivo da camada pode ter no máximo 50 MB.
As regras são rígidas:
- O markup não pode ser combinado com
masknem comprompt_rewriter. - A camada precisa ser PNG transparente, não uma captura de tela achatada.
- A camada se aplica à primeira imagem quando você envia várias imagens.
- Não há tarifa extra de markup, mas a solicitação continua sendo cobrada pelos seus tokens.
Exporte a imagem base, crie uma camada RGBA com as mesmas dimensões em pixels, desenhe uma seta ou um contorno translúcido ao redor do alvo e envie as duas com um prompt que defina a mudança e o que precisa permanecer fixo. A camada mostra onde; o prompt diz o quê. "Mova a caneca para a direita e mantenha a mesa, a sombra e o fundo" é verificável. "Deixe melhor" não é.
import base64
import os
import requests

url = "https://api.toapis.com/v1/images/edits"
headers = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}

with open("base.png", "rb") as image, open("overlay.png", "rb") as markup:
    response = requests.post(
        url,
        headers=headers,
        data={
            "model": "gpt-image-2.6-sunburst",
            "prompt": "Move the mug to the right side of the table and keep the table, shadow, and background unchanged.",
            "size": "1024x1024",
            "quality": "high",
            "complexity": "medium",
        },
        files={"image": image, "markup": markup},
        timeout=180,
    )
response.raise_for_status()
item = response.json()["data"][0]
if item.get("b64_json"):
    open("edited.png", "wb").write(base64.b64decode(item["b64_json"]))
else:
    open("edited.png", "wb").write(requests.get(item["url"], timeout=60).content)
Este exemplo usa markup como nome da parte da camada; confirme na referência da API atual. A referência rotula o markup como recurso do 2.5, enquanto o guia de imagem o descreve para 2.5 e 2.6. Não publique até uma solicitação de teste funcionar. Se o Sunburst rejeitar o markup, não troque de versão em silêncio; exponha a falha e mantenha o último caminho que você sabe que funciona.
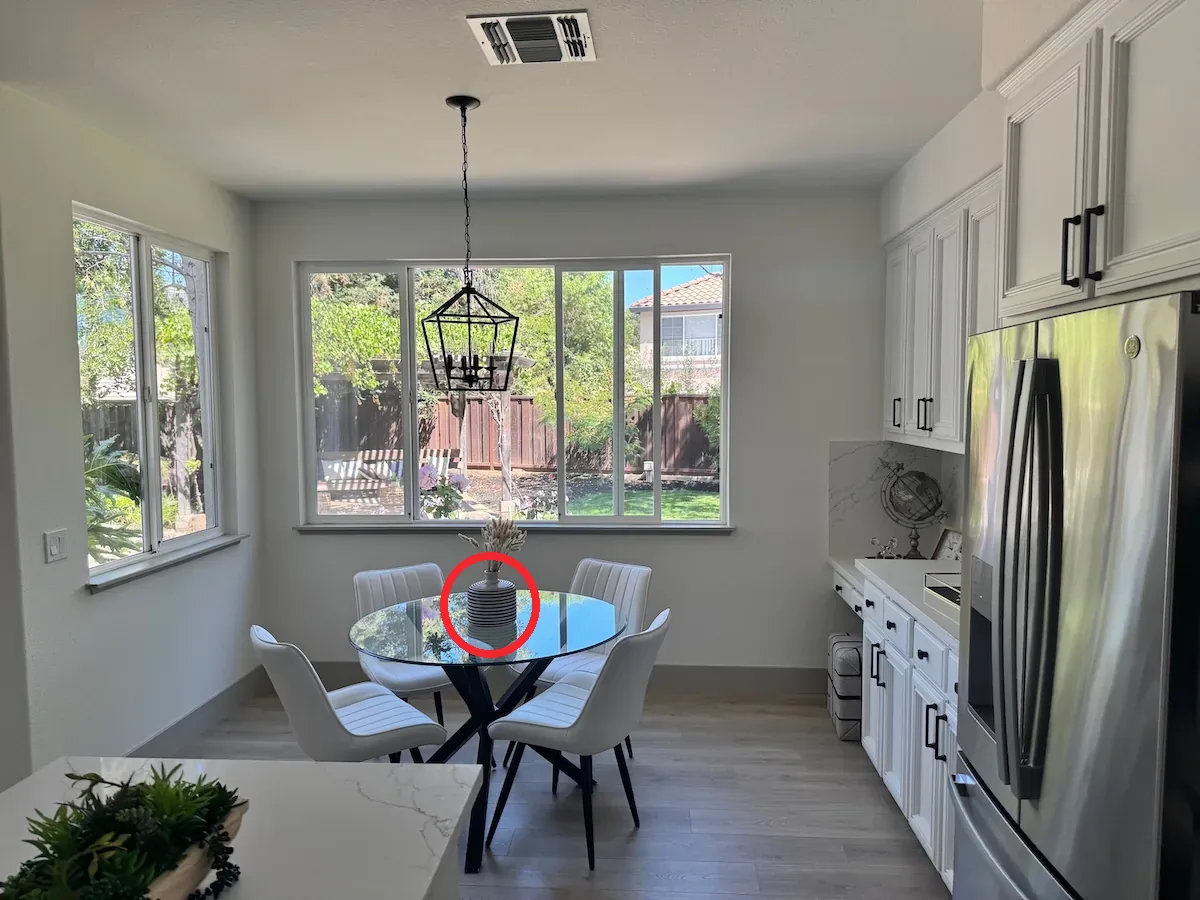
Exemplo de GPT-Image-2.6: a imagem de origem antes de uma edição guiada por markup. A camada e o prompt não são mostrados.
Exemplo de GPT-Image-2.6: o resultado editado. Revise as regiões sem mudança com o mesmo cuidado que a mudança solicitada; um objeto novo convincente ainda pode mover a sombra ou alterar o fundo.
Meça a qualidade da edição com uma lista de verificação por região: alvo alterado, geometria fora do alvo preservada, sombras e reflexos coerentes, texto inalterado e nenhum objeto novo na borda da camada. Guarde a imagem base para poder tentar de novo sem regerá-la.
8. Tamanhos e limites na API GPT-Image-2.6
Os tamanhos recomendados são 1024x1024, 1536x1024 e 1024x1536. Tamanhos personalizados precisam usar dimensões múltiplas de 16, proporção entre 1:3 e 3:1 e no máximo 3840x2160. Tudo acima de 2560x1440 é experimental; verifique primeiro quando um layout se afastar dos tamanhos recomendados.
Uma pequena validação no cliente captura a maioria das solicitações inválidas antes de custar uma viagem de ida e volta:
def validate_size(width: int, height: int) -> str:
    if width % 16 or height % 16:
        raise ValueError("width and height must be multiples of 16")
    if not (1 / 3 <= width / height <= 3):
        raise ValueError("aspect ratio must stay between 1:3 and 3:1")
    if width > 3840 or height > 2160:
        raise ValueError("maximum size is 3840x2160")
    if width * height > 3840 * 2160:
        raise ValueError("pixel area exceeds the documented maximum")
    return f"{width}x{height}"
Os conflitos na documentação da API GPT-Image-2.6 não são cosméticos. Eles mudam o que o seu cliente deveria aceitar:
| Tema | Uma fonte diz | Outra diz | Ação de engenharia |
|---|---|---|---|
frame_count do GIF | Guia de imagem: 2-64 | Referência da API: 2-16 | Comece em 9; suba por passos; não fixe 64 |
| Suporte de markup por modelo | Guia de imagem: 2.5 e 2.6 | Referência da API: apenas 2.5 | Teste o 2.6 na sua conta; mantenha um fallback |
| Tabelas de qualidade e tamanho | O guia do 2.6 inclui níveis e tamanhos novos | Algumas páginas de referência ficam na geração anterior | Valide o enum e as dimensões em tempo de execução |
Trate a documentação como configuração versionada: registre a URL de origem, a data de acesso e o comportamento real da sua conta. Um 400 por enum não suportado é evidência; um comentário no código não é.
9. O custo real de uma chamada à API GPT-Image-2.6
A OpenAI cobra o Images 2.6 por tokens. Tanto gpt-image-2.6-flare como gpt-image-2.6-sunburst usam as mesmas tarifas:
| Tipo de token | Padrão | Em cache |
|---|---|---|
| Saída de imagem | $30.00 / 1M | Não se aplica |
| Entrada de imagem | $8.00 / 1M | $2.00 / 1M |
| Entrada de texto | $5.00 / 1M | $1.25 / 1M |
A fórmula do custo é:
cost = (image_output_tokens * 30
      + image_input_tokens * 8
      + cached_image_input_tokens * 2
      + text_input_tokens * 5
      + cached_text_input_tokens * 1.25) / 1_000_000
Não existe preço fixo oficial por imagem; qualquer estimativa começa pelo consumo de tokens medido. Suponha que uma solicitação de geração cobre 400 tokens de entrada de texto e 5.000 tokens de saída de imagem: (400 × 5 + 5.000 × 30) / 1.000.000 = $0.152. Essas contagens são ilustrativas, não uma média. Uma edição que também cobra 2.000 tokens de entrada de imagem adiciona $0.016, chegando a $0.168.
Com 1.000 solicitações, o hipotético $0.152 vira cerca de $152, antes da entrada de imagem ou de descontos de cache. Acompanhe o custo por imagem aceita, não por solicitação: inclua novas tentativas, rejeições, tempo de revisão e armazenamento. Uma chamada mais barata pode perder quando os revisores rejeitam 40% da saída.
Duas regras mantêm a conta honesta: 50% mais rápido não significa 50% mais barato, porque a velocidade muda a latência, não as tarifas por tokens; e os preços por imagem do 2.5 não valem para o 2.6. A entrada em cache só barateia edições com referências repetidas quando a entrada é servida do cache. Consulte preços e concilie com o consumo devolvido.
10. Checklist de produção e limitações conhecidas
A API GPT-Image-2.6 é capaz, mas não é um motor de layout determinístico. Os limites documentados continuam valendo: prompts complexos podem levar até cerca de dois minutos, a renderização de texto tem limites, a consistência entre gerações não é garantida e o controle de composição é imperfeito. Projete para revisão e nova tentativa, não para uma chamada perfeita.
Antes de direcionar tráfego para a API GPT-Image-2.6:
- Defina um timeout acima do pior caso, ou enfileire trabalhos longos. Não repita às cegas uma solicitação paga depois de um timeout ambíguo; verifique primeiro o status ou a idempotência.
- Valide identificadores de modelo, qualidade, complexity, tamanho e formato de saída no seu próprio cliente. Rejeite combinações não suportadas antes de gastar uma solicitação.
- Registre o modelo solicitado e devolvido, o formato, as dimensões, a qualidade, a complexity, o consumo de tokens, a latência e um hash da saída. Oculte chaves e prompts sensíveis.
- Separe falhas de geração e de edição nas suas métricas. Uma solicitação de markup rejeitada e uma geração lenta são incidentes diferentes.
- Use a API Responses para edição de imagens em vários turnos; ela aceita geração e edição entre turnos. Os endpoints de Images continuam mais simples para trabalhos de um disparo só.
- Mantenha um fallback testado. Se o Sunburst não estiver disponível, o Flare ainda pode atender a solicitação, mas a saída é diferente; avise o usuário quando um modelo de fallback rodou em vez de substituir em silêncio.
- Guarde os ativos de que você precisa em armazenamento controlado. Não assuma que uma URL temporária é um arquivo permanente e não embuta SVG não confiável sem sanitização.
Para o lançamento, use um conjunto fixo que represente a sua carga: texto pequeno de embalagem, um produto que precisa manter a forma após uma edição, uma composição larga e uma animação curta. Pontue contra uma lista de verificação escrita e depois compare os modelos por aceitação e latência p95, não por capturas de tela.
11. Perguntas frequentes
Devo usar gpt-image-2.6-flare ou gpt-image-2.6-sunburst?
Use o Flare para explorar, criar variantes e rascunhos sensíveis à latência, principalmente com quality=low. Use o Sunburst para o detalhe final e para edições que precisam preservar o resto da imagem em quality=medium ou high. Os dois modelos compartilham as tarifas por tokens, então faça um pequeno teste de aceitação em vez de supor que o modelo de maior qualidade é sempre necessário.
A API GPT-Image-2.6 aceita GIF e SVG nas edições?
Não. GIF e SVG são formatos de geração da API GPT-Image-2.6; as edições não aceitam nenhum dos dois. SVG é vetor estático com n=1 e sem streaming, imagens parciais, compressão ou prompt_rewriter. GIF também é apenas de geração. Construa caminhos separados em vez de esperar que uma edição ignore o formato.
Quanto custa uma imagem da API GPT-Image-2.6?
Não há preço fixo oficial por imagem. A saída de imagem custa $30 por 1M de tokens, a entrada de imagem $8 por 1M ($2 em cache) e a entrada de texto $5 por 1M ($1.25 em cache). Estime com as suas contagens de tokens medidas e depois divida o gasto total pelas imagens aceitas. Não reutilize os preços por imagem do 2.5 para um orçamento de 2.6.
Por que a documentação da API GPT-Image-2.6 se contradiz?
O guia e a referência da API não estão totalmente sincronizados. O frame_count aparece tanto como 2-64 quanto como 2-16; o markup está documentado como exclusivo do 2.5 na referência, mas como 2.5/2.6 no guia; algumas tabelas de qualidade e tamanho ficam para trás. Trate isso como limites específicos de versão, teste na sua conta e registre a data e o resultado da verificação.
12. Comece com três chamadas, não com uma migração
Avalie a API GPT-Image-2.6 com um lote controlado: um rascunho Flare low/low, um final Sunburst high/high e uma solicitação de formato que combine com o seu produto. Registre tokens, latência e aceitação e depois decida o que ganha lugar no pipeline.
Crie uma conta ToAPIs, confira o guia do modelo GPT-Image-2.6 para o acesso atual e confirme as tarifas na página de preços. Se você ainda está na geração anterior, leia primeiro o guia da API GPT Image 2 e depois migre um endpoint por vez em vez de reescrever todo o pipeline.