








1. O que o Gemini Omni 1.2 Flash acrescenta
O Google Cloud lista gemini-omni-1.2-flash como um modelo multimodal disponível de forma geral, projetado para tarefas de vídeo, imagem e texto. A matriz de capacidades documentada inclui texto para vídeo, imagem para vídeo, referência para vídeo, vídeo com primeiro e último quadro, edição de vídeo, extensão de vídeo e upscale de vídeo. Também lista raciocínio (thinking), mas não instruções de sistema, saída estruturada, chamada de funções nem a API Gemini Live para este modelo.
A página do modelo documenta saída de vídeo de 3 a 15 segundos para geração e edição, de 3 a 10 segundos para geração com primeiro e último quadro, e de 3 a 10 segundos de duração acrescentada para extensão. As proporções suportadas são 16:9 e 9:16; as resoluções de saída documentadas são 360p, 720p, 1080p e 4k. Os limites de vídeo de entrada dependem da operação: edição e upscale aceitam até 15 segundos, enquanto a extensão usa o final de uma fonte mais longa segundo contrato próprio.
| Capacidade | O que a documentação principal diz | Pergunta de integração |
|---|---|---|
| Texto para vídeo | Vídeo guiado por prompt, 3–15 segundos | Quais campos de resolução e áudio o fornecedor escolhido expõe? |
| Imagem ou referência para vídeo | Referências de imagem e vídeo, com limites por rota | A ordem das imagens e os nomes de referência têm significado semântico? |
| Primeiro e último quadro | Suportado, com saída de 3–10 segundos | A segunda imagem é um quadro final ou outra referência? |
| Edição de vídeo | Editar um vídeo de origem de até 15 segundos | A duração e a proporção seguem a origem? |
| Extensão de vídeo | Acrescentar 3–10 segundos sob um contrato de extensão | duration é o comprimento acrescentado ou o comprimento total de saída? |
| Upscale de vídeo | Aumentar resoluções de origem suportadas até 4K | Esse realce é cobrado separadamente da geração? |
Os anúncios de lançamento destacam cinco melhorias práticas em relação à geração anterior: clipes de 15 segundos, um preço publicado mais baixo em 720p, aderência mais forte a referências de imagem e vídeo, geração de rascunho em resolução menor seguida de upscale para 1080p ou 4K, e diálogo mais natural com sincronia labial mais clara e condições de múltiplos falantes. O Google também descreve edição conversacional, como trocar um produto, a iluminação ou o ângulo de câmera sem recomeçar do zero.
Essas são afirmações de nível de produto, não a promessa de que todo fornecedor exponha cada controle. Um fornecedor pode dividir uma família de modelos em slugs separados, omitir uma capacidade ou adicionar uma camada de cobrança diferente. Sempre trate o esquema exato da rota como o contrato de integração.
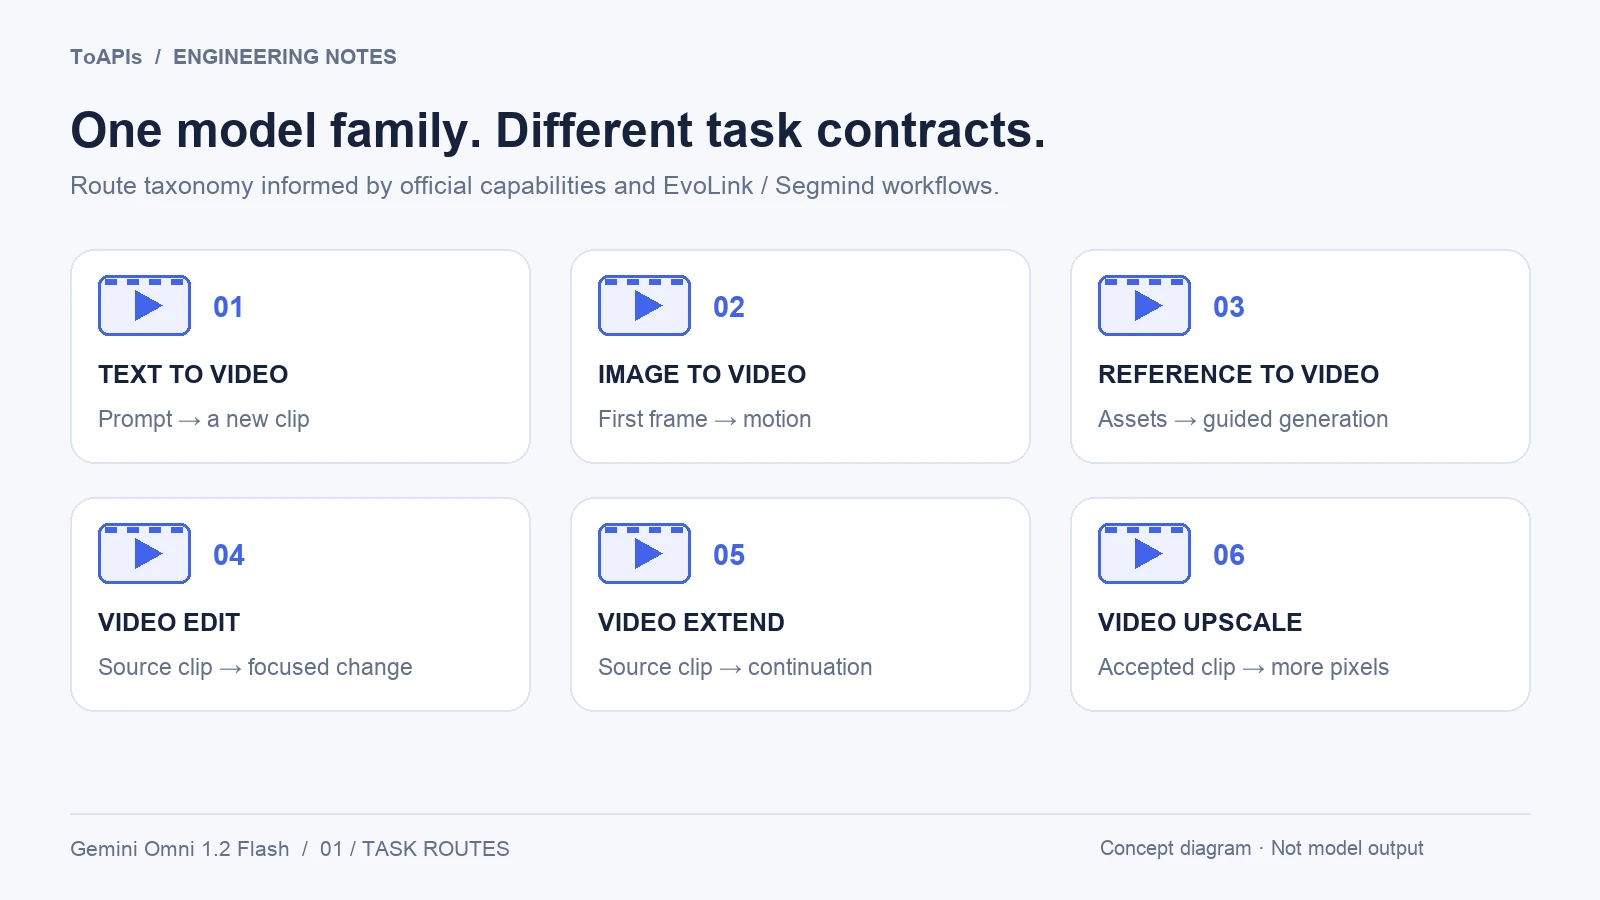
Ilustração original do mapa de tarefas baseada na lista oficial de capacidades e em descrições de rotas de terceiros. Os endpoints reais variam por fornecedor; isto não é saída do modelo.
2. Seis rotas, seis contratos diferentes
Alguns gateways de vídeo de terceiros apresentam seis rotas de tarefa em uma única interface de vídeo assíncrona: texto para vídeo, imagem para vídeo, referência para vídeo, edição de vídeo, extensão de vídeo e upscale de vídeo. Seus IDs de modelo são úteis para entender o planejamento de rotas, mas são identificadores específicos do fornecedor, não identificadores confirmados da ToAPIs.
Relatórios de testes independentes também oferecem uma visão orientada a rotas e observam explicitamente que certas rotas, como refine, não estavam disponíveis nos testes de lançamento. É um bom exemplo de por que uma lista de capacidades atraente não deve ser copiada para um formulário de produto sem uma checagem do esquema em execução.
| Rota | Entrada típica | Limite principal a validar |
|---|---|---|
| Texto para vídeo | Prompt | 3–15 segundos; resolução, proporção, áudio e seed podem depender do fornecedor |
| Imagem para vídeo | Primeira imagem e prompt | Uma segunda imagem pode definir um quadro final; confirme a duração máxima |
| Referência para vídeo | Imagens ou vídeos de referência mais prompt | Regras de quantidade, duração e nomes de referência diferem |
| Edição de vídeo | Vídeo de origem mais uma alteração focada | Duração da origem, filtros de segurança e se a saída segue o enquadramento da origem |
| Extensão de vídeo | Vídeo existente mais prompt de continuação | A duração acrescentada não é necessariamente a duração total |
| Upscale de vídeo | Vídeo existente, normalmente sem prompt | Tamanhos de origem aceitos, níveis de saída e cobrança separada |
Um seletor de rota deve mudar ao mesmo tempo suas regras de validação, seu texto de ajuda e sua previsão de custo. Não deixe um campo genérico duration carregar silenciosamente a semântica de uma rota de extensão para uma rota de geração. Não presuma que um campo chamado image_urls significa a mesma coisa em requisições de imagem para vídeo e de referência para vídeo.
Não misture os limites do Google Cloud e da API Gemini
O guia da API Gemini documenta até seis imagens de referência, enquanto a página do modelo no Google Cloud lista até dez imagens por prompt. A API Gemini também aplica limites de vídeos de referência que dependem da duração solicitada: uma geração mais longa, de 11–15 segundos, suporta um único vídeo de referência curto, não o mesmo orçamento de referências de uma tarefa de 3–10 segundos. São contratos de plataforma distintos, não valores contraditórios para média ou combinação.
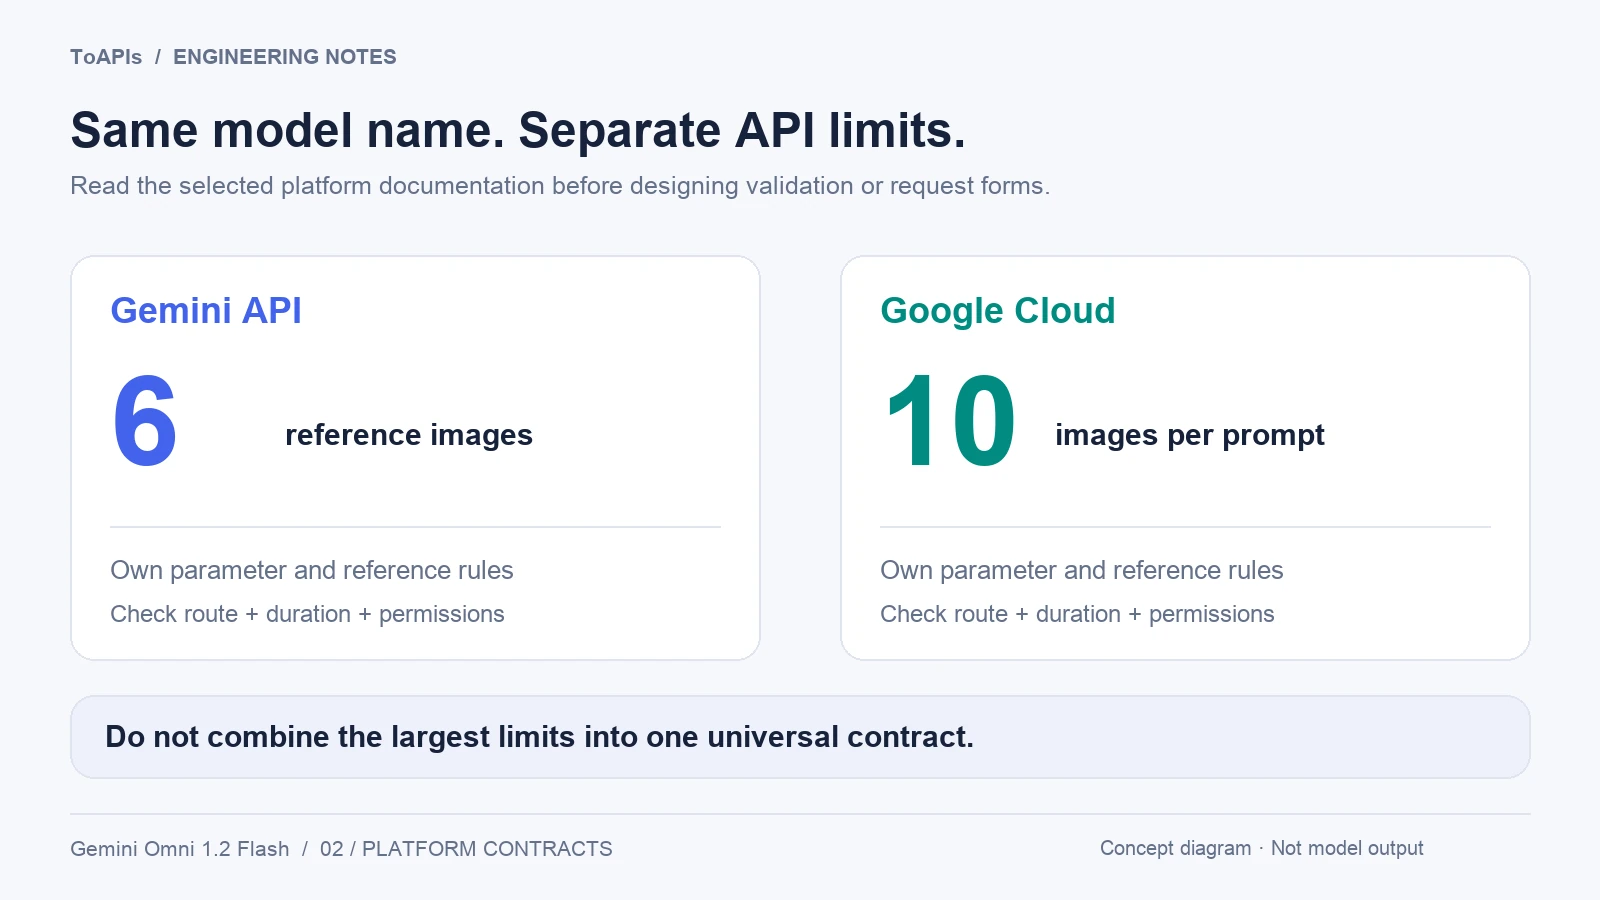
Contratos de plataforma separados: seis imagens de referência na API Gemini contra dez imagens por prompt na documentação do Cloud. Esses máximos não podem ser combinados; verifique a rota e a duração escolhidas.
Para a API Gemini, a integração documentada usa a Interactions API, não generate_content, nem uma chamada chat-completions da OpenAI, nem um método generate_videos específico do Veo. O exemplo a seguir é adaptado de uma chamada paga, não é uma requisição à ToAPIs. Exige um SDK google-genai atual, uma conta elegível e uma chave configurada localmente; nunca coloque credenciais em um prompt ou em um pacote de navegador. Ele não foi executado para este artigo.
import base64
from pathlib import Path
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input=(
        "A blue ceramic cup on a neutral table. "
        "One continuous slow camera push-in. "
        "Soft room ambience, no speech, no text."
    ),
    response_format={
        "type": "video",
        "resolution": "360p",
        "duration": "5s",
        "aspect_ratio": "16:9",
    },
)
Path("omni-draft.mp4").write_bytes(
    base64.b64decode(interaction.output_video.data)
)
print("interaction ID:", interaction.id)
Nessa API, duration é uma string como "5s", não um inteiro copiado de um formulário de gateway; os controles de geração ficam em response_format. Para arquivos maiores, o guia documenta entrega por URI e tratamento da prontidão do arquivo. Edições multiturno usam previous_interaction_id; definir store=false remove o estado armazenado necessário para esse fluxo de acompanhamento. Revise essas contrapartidas em vez de copiar ajustes de latência sem pensar.
3. Estratégia de resolução: rascunho primeiro, upscale seletivo
O guia da API Gemini identifica explicitamente 360p e 720p como níveis de geração, e 1080p e 4k como saída com upscale. Portanto, uma opção de entrega em 4K não estabelece geração nativa em 4K. O fluxo de trabalho mais prático do material de lançamento é separar exploração de entrega. Use 360p ou 720p para iterar prompts e checar composição. Quando um clipe passa na lista de aceitação, compare selecionar entrega em alta resolução na requisição de geração com fazer upscale separado de um clipe existente. Confirme que o fornecedor suporta cada caminho; nenhum dos dois implica geração nativa em 4K.
Essa estratégia reduz gerações desperdiçadas em alta resolução, mas introduz uma segunda operação para medir. Um upscaler pode acrescentar detalhe sem mudar o movimento subjacente nem corrigir uma composição ruim. Ele não consegue garantir que um rótulo errado, um rosto instável ou um movimento de objeto incorreto fiquem corretos em 4K.
Guarde a resolução de origem, a resolução de saída, a rota, a duração e o uso de tokens no registro do trabalho. Onde o fornecedor suportar os dois caminhos, compare a entrega em alta resolução selecionada na requisição de geração com o upscale separado de um clipe existente, usando entradas, enquadramento e critérios de aceitação equivalentes. Nenhum dos caminhos estabelece geração nativa em 4K. Relatórios de testes independentes notaram detalhe útil do upscale, ao mesmo tempo que o trataram como uma etapa do fluxo de trabalho com custo cujo preço precisa ser medido.
Para produção, defina dois portões:
- Um portão criativo: identidade do sujeito, composição, movimento, texto, diálogo e som atendem ao briefing.
- Um portão de entrega: dimensões, duração, codec, faixa de áudio, direitos e retenção de arquivos atendem ao requisito posterior.
Somente clipes que passam nos dois portões devem entrar na biblioteca final de ativos.
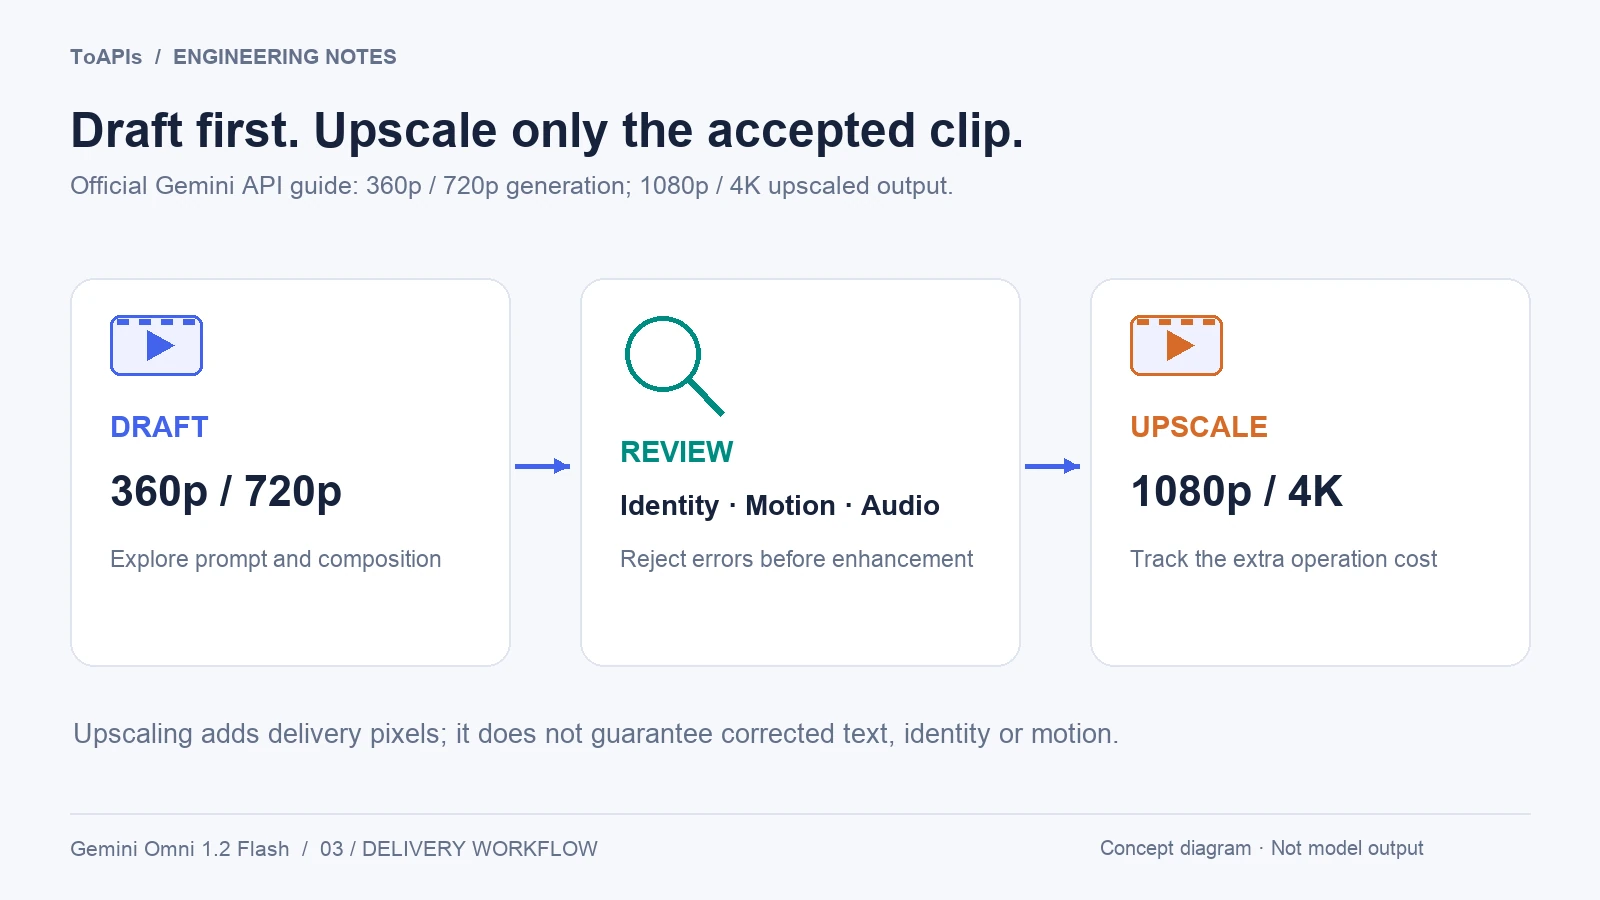
Fluxo de trabalho conceitual baseado no guia da API Gemini. A entrega em resolução maior usa upscale; não garante movimento, texto ou identidade corrigidos.
4. Prompting para vídeo fiel à instrução
Testes de terceiros são especialmente valiosos para o design de prompts quando revelam o que checar, não quando se tornam afirmações de benchmark universais. Relatórios de testes independentes apontam resultados fortes em explicativos com rótulos, tipografia cinética, animação de gráficos a partir de um quadro final fornecido, motion graphics estilizados e edições de uma única mudança sobre filmagem real. Esses mesmos relatórios apontam resultados mais fracos em pessoas fotorrealistas criadas do zero, gráficos de dados a partir de números apenas e algumas edições de várias etapas ou de logotipo de marca.
Um prompt de Omni robusto deve separar:
- o sujeito e sua identidade visível;
- as batidas ordenadas da cena;
- o movimento de câmera e o que deve permanecer travado;
- o texto exato na tela, citado separadamente;
- diálogo, música e efeitos sonoros;
- o estado final, preferencialmente fixado com uma entrada de último quadro quando a rota suportar;
- uma alteração a preservar em uma edição, mais tudo que deve permanecer inalterado.
Por exemplo:
Create a flat 2D motion-graphics explainer in 16:9.
Show the title 'HOW A PRODUCT VIDEO API WORKS' exactly as written.
First show one product photo, then three labelled route cards from left to right,
then connect the cards to one finished video frame.
Keep every label fixed after it appears. Use a locked-off camera.
Add a short, calm voiceover and a soft click for each route card.
End on the complete diagram. Do not add any other text or logos.
Este briefing é um teste proposto, não uma saída de Omni medida. As regras de aceitação são mais úteis do que adjetivos como "cinematográfico" ou "viral": cada rótulo deve coincidir, a ordem deve estar correta, a câmera deve permanecer travada e o áudio deve conter apenas as deixa solicitadas.
5. Áudio nativo, referências e edição
A documentação oficial lista fala, música e efeitos sonoros como suportados, enquanto o post de lançamento do Google destaca diálogo mais natural, sincronia labial mais clara e condições distintas de múltiplos falantes. O anúncio do Google Cloud também observa que as referências de áudio estão atrás de lista de permissões. Isso significa que o áudio precisa da sua própria checagem de capacidade e permissão, não apenas de uma caixa em um formulário de vídeo genérico.
A consistência de referência é um dos temas principais do modelo. O Google descreve aderência mais forte a referências de imagem e vídeo, e a página oficial do modelo suporta geração baseada em referências. Ainda assim, suporte a referências não é garantia de identidade. Revise rosto, roupa, silhueta do produto, marcas visíveis, iluminação e movimento em todo o clipe.
A edição conversacional também é um conceito de fluxo de trabalho, não necessariamente um endpoint universal único. O material de lançamento descreve trocar um produto, a iluminação ou o ângulo de câmera no mesmo clipe. Um fornecedor pode implementar isso como edição de vídeo, um ID de interação, uma referência a tarefa anterior ou um corpo de requisição diferente. Confirme o contrato antes de guardar premissas no seu banco de dados.
Para cada edição, registre:
- o vídeo de origem e seus direitos;
- a instrução exata de uma única alteração;
- o que deve permanecer inalterado;
- a rota e o ID do modelo;
- o ID de tarefa ou de interação retornado;
- os resultados de áudio e de revisão de segurança.
Isso torna uma edição malsucedida diagnosticável e uma edição bem-sucedida reproduzível o bastante para revisão.
6. Preço por token não é o mesmo que uma cotação da ToAPIs
Os materiais de lançamento do Google publicam um preço de fornecedor para vídeo em 720p e descrevem uma redução em relação ao modelo anterior. Alguns gateways de vídeo de terceiros apresentam suas próprias calculadoras baseadas em tokens, descontos e preços por rota, enquanto análises de preços de terceiros derivam estimativas por segundo em 720p a partir de premissas de tokens ou enquadram o lançamento em torno de um preço por segundo publicado. Esses números não são intercambiáveis.
A tabela de preços Standard da API Gemini, revisada em 6 de novembro de 2026, lista USD 1,50 por milhão de tokens de entrada para texto, imagens e vídeo; USD 9,00 por milhão de tokens de saída de texto, incluindo raciocínio; e USD 12,00 por milhão de tokens de saída de vídeo. Não oferece nível gratuito para este modelo. São preços de lista do fornecedor para aquela plataforma, não uma cotação da ToAPIs.
A mesma página de preços lista 5.792 tokens de saída de vídeo por segundo em 720p. Portanto, um clipe de 15 segundos em 720p tem um componente ilustrativo de saída de vídeo de 15 × 5,792 × 12 / 1,000,000 = USD 1.04256, antes dos encargos de entrada e de saída de texto e raciocínio. Isso explica a manchete arredondada de lançamento de cerca de USD 0,07 por segundo sem transformá-la em uma taxa fixa com tudo incluído. Preços, regras de tokens e margens de gateway podem mudar.
Um modelo de custo de produção deve identificar:
| Dimensão de custo | O que preservar |
|---|---|
| Fornecedor ou gateway | O fornecedor exato, o ID do modelo e a data |
| Unidade de cobrança | Segundos, tokens de saída de vídeo, tokens de entrada, tokens de raciocínio ou um pacote |
| Multiplicador de resolução | Entrega em alta resolução selecionada na geração contra upscale solicitado separadamente; verifique suporte e cobrança do fornecedor |
| Mídia de entrada | Imagens, vídeos de origem e suas regras de tokens cobráveis |
| Política de repetição e rejeição | Se falhas de segurança, validação ou transporte são cobradas |
| Rendimento de aceitação (taxa de aprovação) | Clipes que passam na lista de entrega divididos pelo total de tentativas |
Para um plano hipotético baseado em tokens, escreva a fórmula em vez de copiar a cotação de um concorrente:
raw generation cost = input token cost
                    + text and thinking output token cost
                    + video output token cost
workflow cost = sum of all generation attempts
              + separately billed upscaling
              + storage, transfer and review cost
cost per accepted clip = workflow cost / accepted clips
Não conte duas vezes um item que já está incluído na fatura; quando accepted clips é 0, o custo por clipe aceito fica indefinido e deve ser informado separadamente.
Não publique um preço da ToAPIs até que seu catálogo atual ou seu endpoint de cotação confirme o modelo, a SKU, a unidade e a tarifa específica da conta. Não afirme que uma latência ou um custo medidos por terceiros se aplicam a outro gateway.
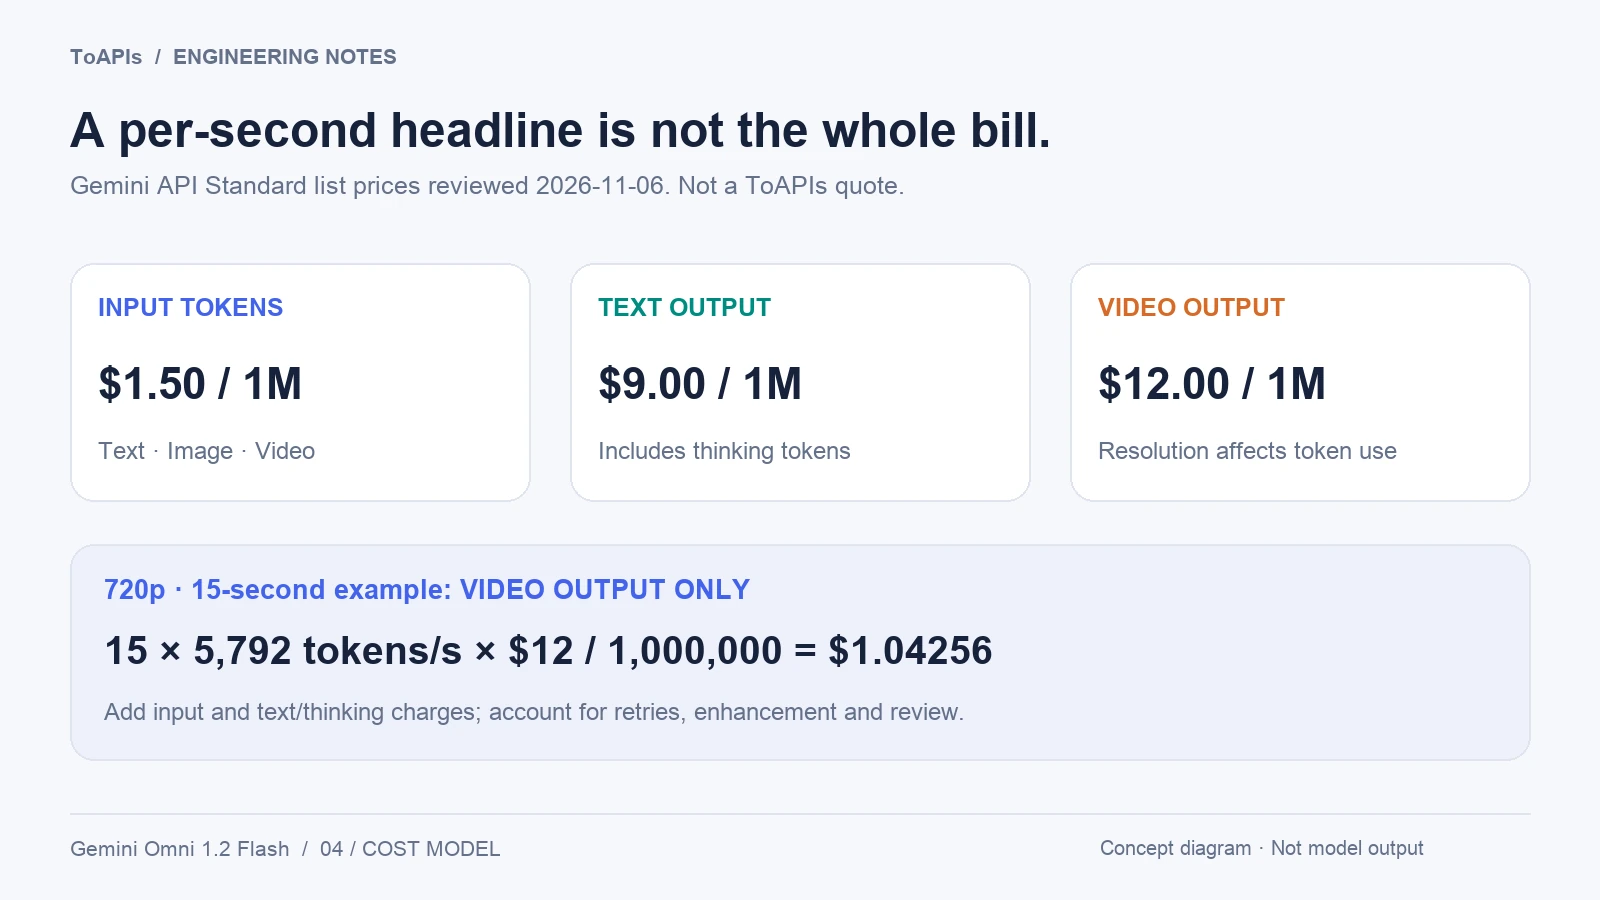
Ilustração com preços de lista do fornecedor revisados em 6 de novembro de 2026, não uma cotação da ToAPIs. Os USD 1,04256 cobrem apenas a saída de vídeo neste exemplo; os encargos de entrada e de texto e raciocínio são adicionais.
7. Monte um pacote de aceitação antes da produção
Antes de habilitar este modelo em uma aplicação, execute um pacote pequeno e repetível:
- Texto para vídeo: um explicativo com rótulos, batidas ordenadas e deixas de áudio explícitas.
- Imagem para vídeo: um primeiro quadro de produto com um estado final obrigatório.
- Referência para vídeo: um sujeito em várias vistas, com uma lista de verificação de continuidade.
- Edição de vídeo: uma alteração em um clipe real preservando a atuação.
- Extensão de vídeo: um plano cuja direção de câmera e som devem continuar com naturalidade.
- Entrega em alta resolução: se o fornecedor suportar os dois caminhos, compare selecionar entrega em alta resolução em uma requisição de geração com fazer upscale separado de um rascunho já aceito; nenhum dos dois implica geração nativa em 4K.
Para cada teste, registre ID do modelo, rota, entradas, prompt, seed se suportada, resolução, duração, ID da tarefa, tempo em fila, tempo de processamento, dados de tokens ou cobrança da saída, resultado de áudio e veredito de aceitação. Guarde as falhas em vez de selecionar apenas os melhores exemplos.
Use resenhas de terceiros como hipóteses. Por exemplo, uma revisão independente de 20 testes é valiosa quando nomeia tanto pontos fortes quanto falhas, mas seus preços cobrados, latência e comportamento de fornecedor pertencem àquele ambiente de teste específico. Ela não é um benchmark independente de toda integração do Gemini Omni 1.2 Flash.
8. Lista de verificação de disponibilidade e integração
O ID oficial do modelo no Google é gemini-omni-1.2-flash, mas um ID de modelo por si só não significa que um gateway o habilitou. Antes de integrar pela ToAPIs, inspecione o catálogo de modelos, os preços atuais e a documentação da requisição. Confirme a rota exata, o direito da conta, o corpo da requisição, o modelo de status assíncrono, o período de retenção do resultado e a política de cobrança.
Se a rota estiver ausente ou a cotação não existir, mantenha o recurso desabilitado ou rotule-o como em breve. Não mapeie silenciosamente outro modelo Gemini para o mesmo nome comercial. Não informe uma geração real a menos que uma chamada autenticada tenha tido sucesso e a mídia retornada tenha sido revisada.
Fontes e política de atualização
- Google: Gemini Omni 1.2 Flash, vídeo de 15 segundos e preço menor — anúncio oficial de lançamento, 5 de novembro de 2026.
- Google Cloud: Gemini Omni 1.2 Flash agora em GA — disponibilidade geral, contexto corporativo e afirmações de lançamento.
- Documentação do modelo no Google Cloud — ID do modelo, capacidades, limites e estado de lançamento.
- Guia Omni da API Gemini — Interactions API, referências específicas de plataforma, níveis de resolução com upscale e estado de edição.
- Preços da API Gemini — tarifas por token Standard e conversão de tokens de vídeo; preço do fornecedor, não uma cotação da ToAPIs.
Ao atualizar este guia, registre o fornecedor, o ID do modelo, a URL de origem e a data de revisão para cada capacidade ou preço alterado. Mantenha separados os preços do fornecedor, as cotações de gateways e os testes de terceiros. Este guia não afirma disponibilidade na ToAPIs, uma geração autenticada, um benchmark universal nem um resultado de produção garantido.