








Test de l'API Seedance 2.0 Mini : génération vidéo à haut débit avec un petit budget
Modèle cible :
seedance-2-mini
Endpoint d'inférence :https://api.toapis.com/v1/videos/generations
Associé : Démarrage rapide Seedance 2.0 · Guide des avatars réels
1. TL;DR et vue d'ensemble des performances
- Idéal pour : générateurs programmatiques TikTok/Reels, tests dynamiques de créations publicitaires, résumés de presse automatisés et backends à budget serré.
- Vitesse : temps de traitement moyen de 16 à 20 secondes — environ 2× plus rapide que Seedance 2.0 standard (~32 s pour une tâche typique de 5 s en 1080p).
- Coût : $0.012/s ($0.060 pour 5 secondes, $0.120 pour 10 secondes).
- Résolution : 720p natif (
1280x720ou720x1280), MP4 à 24fps. - Concurrence : jusqu'à 50 tâches parallèles par compte ToAPIs.
2. Verdict : Mini face au standard
Mini est un frère distillé de Seedance 2.0 : même surface REST compatible OpenAI, moins de dollars de VRAM par clip et un profil de qualité calibré pour les timelines mobiles plutôt que pour les spots cinématographiques phares.
| Dimension | Seedance 2.0 Mini | Seedance 2.0 |
|---|---|---|
| Résolution native | 720p @ 24fps | Classe 1080p (4K par cascade) |
| Temps typique pour 5 s | 16–20 s | ~32 s |
| Tarif ToAPIs | $0.012/s | ~$0.028/s |
| Coût relatif | 57 % plus bas | Cheval de trait de référence |
| Concurrence pratique | Jusqu'à 50 tâches | Marge VRAM plus faible |
| Meilleur usage | Social programmatique, publicités A/B, boucles d'actualité | Explications phares, films de marque |
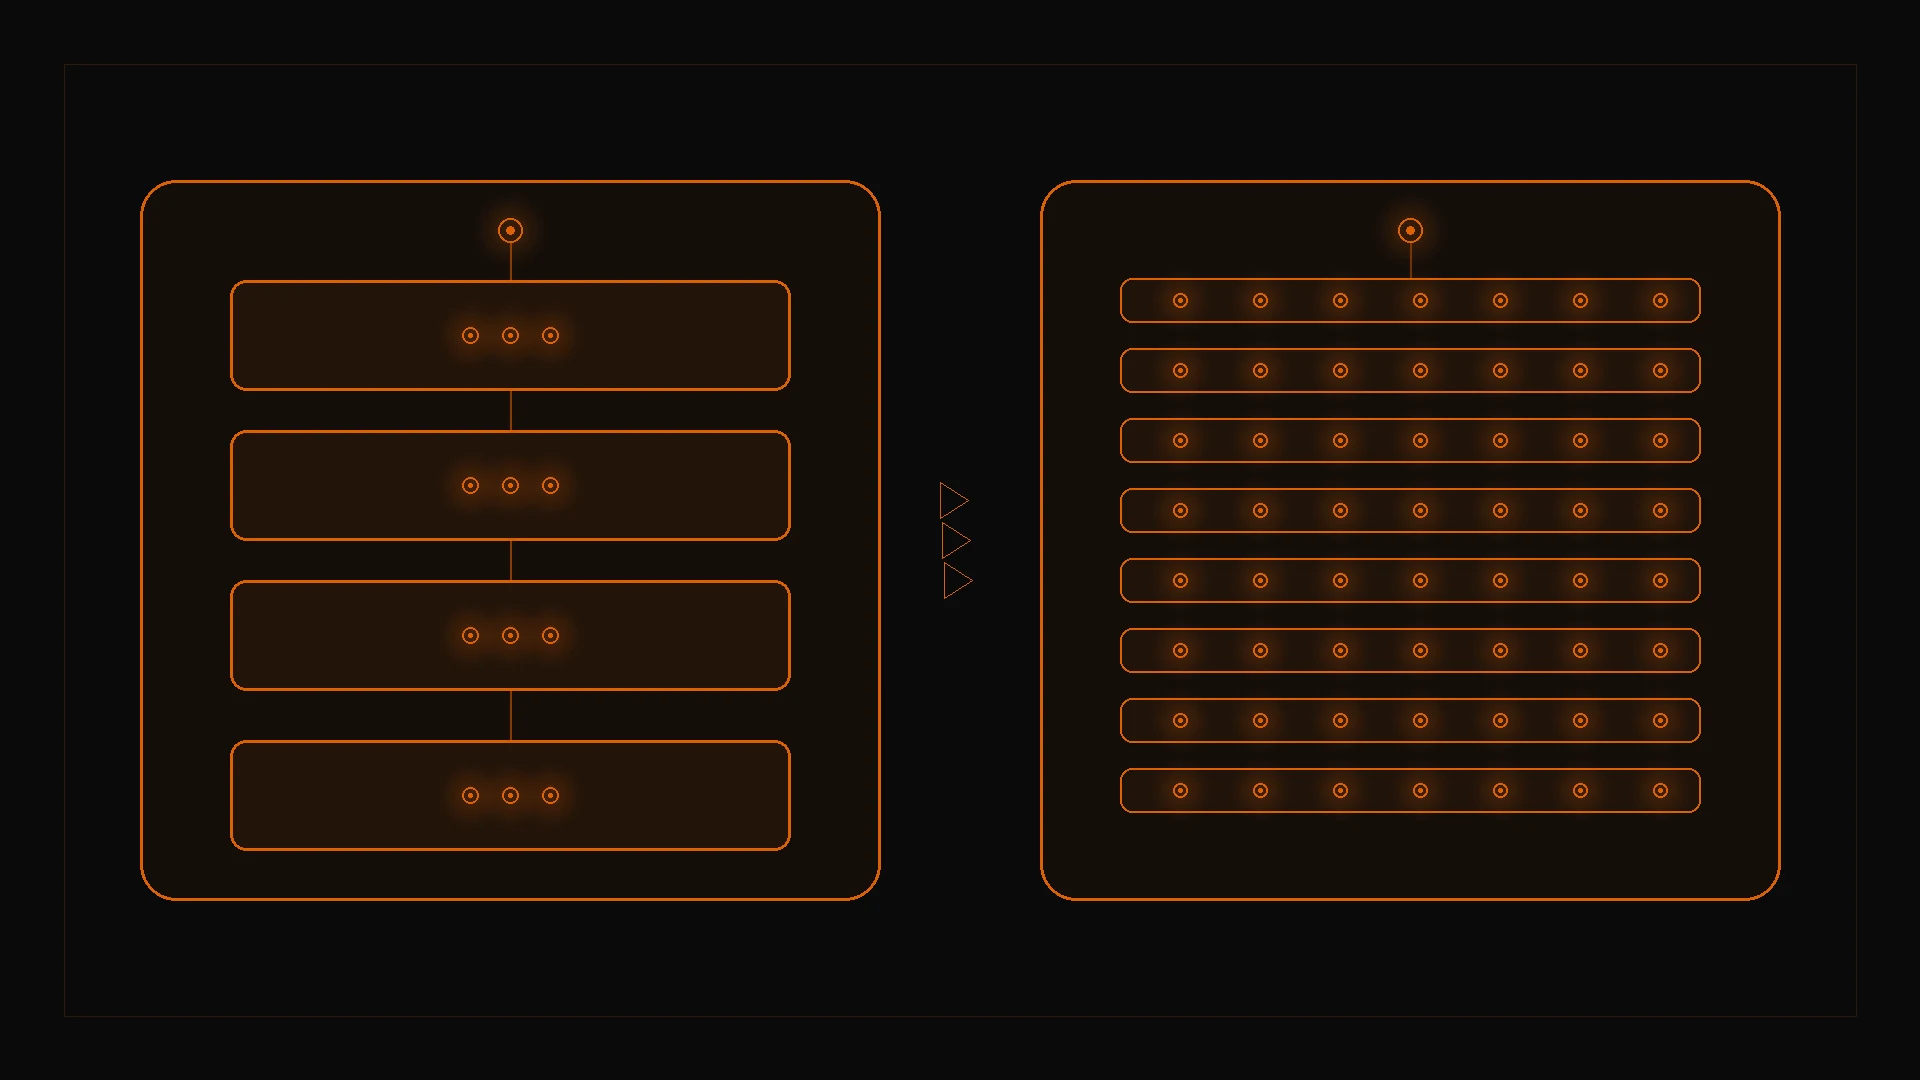
Figure 1 : Seedance 2.0 standard privilégie moins de tâches plus lourdes ; Mini déploie de nombreuses voies légères en 720p derrière le même endpoint de générations ToAPIs.
Gardez les présentateurs de type talking-head sur l'API d'avatars réels. Utilisez Mini pour tout ce qui doit être livré en volume.
3. Mise en œuvre en production : cURL et Python
Étape 1 : envoi cURL (social vertical)
curl -X POST https://api.toapis.com/v1/videos/generations \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2-mini",
    "prompt": "Fast motion hyperlapse of neon traffic streaming across Shibuya crossing Tokyo at night",
    "aspect_ratio": "9:16",
    "duration": 5
  }'
Étape 2 : poller Python rapide (budget de 90 s)
import os
import time
import requests

API_KEY = os.getenv("TOAPIS_API_KEY")
ENDPOINT = "https://api.toapis.com/v1/videos/generations"


def generate_mini_social_clip(prompt: str) -> str:
    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json",
    }
    payload = {
        "model": "seedance-2-mini",
        "prompt": prompt,
        "aspect_ratio": "9:16",
        "duration": 5,
    }

    start_submit = time.time()
    res = requests.post(ENDPOINT, headers=headers, json=payload, timeout=20)
    res.raise_for_status()
    task_id = res.json()["task_id"]
    print(f"[+] Task {task_id} dispatched in {round(time.time() - start_submit, 2)}s")

    poll_url = f"https://api.toapis.com/v1/videos/tasks/{task_id}"
    while time.time() - start_submit < 90:
        time.sleep(2)
        poll = requests.get(poll_url, headers=headers, timeout=10)
        status_data = poll.json()
        if status_data.get("status") == "succeeded":
            total_elapsed = round(time.time() - start_submit, 1)
            print(f"[✔] Rendered in {total_elapsed}s! URL: {status_data['video_url']}")
            return status_data["video_url"]
        if status_data.get("status") == "failed":
            raise RuntimeError(f"Mini generation failed: {status_data.get('error')}")

    raise TimeoutError("Task timed out")


if __name__ == "__main__":
    prompt = "Fast motion hyperlapse of neon traffic streaming across Shibuya crossing Tokyo at night"
    generate_mini_social_clip(prompt)
Mini et le seedance-2 standard partagent cet endpoint et ce contrat de polling. En cas de succès, ToAPIs renvoie une video_url CDN. Les rendus échoués en amont n'entraînent aucune déduction de solde.
4. Gestion des erreurs et matrice des statuts
| Code HTTP | Classification | Cause racine | Atténuation |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Schéma / champs non pris en charge | Validez prompt, duration, aspect_ratio |
401 Unauthorized | invalid_api_key | Jeton Bearer expiré ou incorrect | Renouvelez la clé dans le tableau de bord ToAPIs |
429 Rate Limit | rate_limit_exceeded | Plafond de concurrence | Backoff exponentiel avec jitter ; file d'attente locale |
500 / 504 | gateway_timeout | Latence GPU en amont | Réessayez ; la passerelle bascule sur un cluster de secours |
5. Tarifs et ROI FinOps
- Tarif Mini : $0.012/s — $0.060 par clip de 5 secondes, $0.120 par clip de 10 secondes.
- Face au 2.0 standard (~$0.028/s) : environ 57 % plus bas. 1 000 × 10 s = 10 000 s coûte environ $120 avec Mini contre environ $280 avec le 2.0 standard ($160 d'économies).
- Référence d'entreprise officielle : engagements annuels et quotas de sièges. ToAPIs reste en paiement à l'usage.
- Astuce de routage : envoyez les tâches gratuites/d'aperçu et les tâches sociales à fort volume vers
seedance-2-mini, puis basculezmodelversseedance-2ouseedance-2-5pour les finalisations VIP.
6. Foire aux questions
Voir le bloc FAQ en frontmatter. En résumé : Mini privilégie le 720p avec une physique des particules un peu plus simple, prend en charge environ 50 tâches simultanées, partage le schéma REST avec le 2.0 standard et ne doit pas être utilisé lorsque vous avez besoin de 1080p ou 4K natif.
7. Liste d'actions
- Créez une clé sur le portail développeur ToAPIs.
- Testez rapidement l'extrait cURL vertical (
seedance-2-mini, 9:16, 5 secondes). - Adoptez le poller Python de 90 s et ajoutez un commutateur
modelpour les tâches phares. - Lisez ensuite le guide des avatars réels et la comparaison d'architecture 2.0 vs 2.5.