








Guide de l'API GPT-Image-2.6 : Flare, Sunburst, GIF et SVG
La requête qui ruine un sprint d'images est rarement le visuel principal. C'est la demande de suivi : « Le même appel peut-il renvoyer un GIF ? Peut-on obtenir le logo en SVG ? Le design peut-il déplacer la tasse de deux centimètres vers la gauche sans régénérer toute la scène ? » Un pipeline construit autour d'un seul PNG à plat répond aux trois par un nouveau projet.
OpenAI a publié Images 2.6 le 4 novembre 2026, et l'API couvre désormais ces demandes : deux variantes de modèle, la sortie GIF et SVG, les retouches guidées par markup et un contrôle complexity distinct. Le piège, c'est que la nouvelle surface est arrivée plus vite que la mise à jour de chaque page de référence. Ce guide vous donne une intégration exécutable de l'API GPT-Image-2.6, puis signale les endroits exacts où vous devez confirmer une limite avant de la figer dans le code.
TL;DR
- Deux modèles, une grille tarifaire.
gpt-image-2.6-flareest la voie de l'itération rapide ;gpt-image-2.6-sunburstvise une qualité et un détail supérieurs, avec une cohérence de retouche plus forte en qualité moyenne ou élevée. Les deux utilisent les mêmes tarifs par tokens.- Nouvelles fonctions API. Sortie GIF, sortie SVG, retouches guidées par markup et un paramètre
complexity. La génération et la retouche restent des endpoints distincts.- Facturation au token, pas à l'image. La sortie image coûte $30 par 1M de tokens ; l'entrée image $8 par 1M ($2 en cache) ; l'entrée texte $5 par 1M ($1.25 en cache).
- La documentation se contredit à trois endroits. Le
frame_countdu GIF, la prise en charge du markup selon le modèle et certaines parties de la référence qualité/taille. Vérifiez sur votre compte avant de livrer une limite figée.
1. Ce qu'apporte l'API GPT-Image-2.6
Images 2.6 est la génération du 4 novembre 2026, disponible dans ChatGPT, dans Codex et via l'API. OpenAI indique qu'elle génère les images 50 % plus vite que la génération précédente. C'est une affirmation de l'éditeur sur la vitesse de génération, pas une promesse sur votre latence p95, et elle ne dit rien du prix : la facturation reste basée sur les tokens.
Les deux identifiants de modèle servent des tâches différentes :
gpt-image-2.6-flareest conçu pour itérer vite. Avecquality=low, OpenAI décrit une génération en seulement 6 secondes environ, ce qui en fait le choix par défaut pour l'exploration de prompts, les vignettes et les aperçus d'interface où « assez bon maintenant » vaut mieux que « parfait plus tard ».gpt-image-2.6-sunburstvise une qualité et un détail supérieurs, avec une cohérence de retouche plus forte àquality=mediumouhigh. Utilisez-le pour les assets finaux et les retouches où les parties inchangées doivent survivre.
Les deux modèles partagent les tarifs par tokens : le choix porte donc sur le taux d'acceptation et la latence, pas sur un identifiant de modèle moins cher. Si vous migrez depuis la génération précédente, le guide de l'API GPT Image 2 explique la forme de requête commune ; cet article se concentre sur ce que 2.6 ajoute. Le guide du modèle GPT-Image-2.6 est l'endroit où vérifier la disponibilité pour votre compte.
L'API est compatible OpenAI. Les exemples ci-dessous ciblent https://api.toapis.com/v1 ; si vous les pointez vers une autre URL de base compatible, conservez le payload et modifiez uniquement l'URL de base et la clé.
2. Votre première requête à l'API GPT-Image-2.6
Commencez par la génération. Cet appel curl demande à Flare un brouillon carré en qualité et complexity faibles, le test de fumée le plus rapide et le plus raisonnable :
curl -sS https://api.toapis.com/v1/images/generations \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-flare",
    "prompt": "Paper-cut football stadium at night, layered cardstock, rim light, no text",
    "size": "1024x1024",
    "quality": "low",
    "complexity": "low",
    "n": 1
  }' -o flare-response.json
Inspectez la réponse avant d'écrire un téléchargeur. Selon le modèle et les options de la requête, les API d'image renvoient souvent une URL ou des données base64 ; un client qui suppose data[0].url échouera sur une réponse base64 valide. L'assistant ci-dessous gère les deux cas et sert à tous les exemples de cet article :
import base64
import os
import pathlib
import requests

API = "https://api.toapis.com/v1/images/generations"
HEADERS = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}


def generate(model: str, prompt: str, output: str, **params) -> str:
    payload = {"model": model, "prompt": prompt, "n": 1, **params}
    response = requests.post(API, headers=HEADERS, json=payload, timeout=180)
    response.raise_for_status()
    item = response.json()["data"][0]
    target = pathlib.Path(output)
    if item.get("b64_json"):
        target.write_bytes(base64.b64decode(item["b64_json"]))
    else:
        target.write_bytes(requests.get(item["url"], timeout=60).content)
    return str(target)


if __name__ == "__main__":
    prompt = "Paper-cut football stadium at night, layered cardstock, rim light, no text"
    generate("gpt-image-2.6-flare", prompt, "flare-draft.png",
             size="1024x1024", quality="low", complexity="low")
    generate("gpt-image-2.6-sunburst", prompt, "sunburst-final.png",
             size="1536x1024", quality="high", complexity="high")
Le timeout de 180 secondes est volontaire. Les prompts complexes peuvent prendre jusqu'à environ deux minutes : un timeout client de 30 secondes rejette donc un travail que le serveur peut encore terminer. Si votre produit ne peut pas maintenir une requête aussi longtemps, utilisez une file de jobs plutôt que de raccourcir le timeout et de réessayer à l'aveugle.
3. Flare vs Sunburst : choisir le modèle dans l'API GPT-Image-2.6
La comparaison utile n'est pas « quel modèle est meilleur ». C'est « quel modèle est accepté sur cette tâche à une latence et un coût acceptables ». Un brouillon Flare rejeté peut coûter plus cher qu'une image Sunburst livrée.
| Tâche | Meilleur premier choix | Pourquoi |
|---|---|---|
| Explorer 20 directions de prompt | gpt-image-2.6-flare | La génération en basse qualité est la voie rapide ; écartez tôt les mauvaises directions |
| Vignettes et placeholders d'interface | gpt-image-2.6-flare | La vitesse compte plus que le détail fin |
| Visuel principal final | gpt-image-2.6-sunburst | Qualité et détail supérieurs en réglage moyen ou élevé |
| Retouche qui doit préserver l'identité | gpt-image-2.6-sunburst | Cohérence de retouche plus forte en qualité moyenne ou élevée |
| Premier passage à fort volume | gpt-image-2.6-flare | Mêmes tarifs par tokens, mais moins de secondes par tentative |
| Expérimentation de format (GIF/SVG) | L'un ou l'autre, puis relancez | Confirmez la prise en charge du format avant d'optimiser la qualité |
Exécutez les deux modèles sur les mêmes prompts et la même taille de sortie, changez une variable à la fois et relisez les résultats à l'aveugle. Enregistrez le taux d'acceptation, la latence p50/p95 et les métadonnées brutes de la réponse : modèle demandé et renvoyé, qualité, complexity, taille, format, consommation de tokens si disponible, et temps écoulé. Un échantillon séduisant ne prouve pas qu'un modèle est meilleur.
Un schéma pratique : Flare en qualité basse pour l'exploration, puis Sunburst en qualité haute pour la direction retenue. Reprenez le prompt, mais n'attendez pas une seconde image identique au pixel près. Si la cohérence compte, testez une retouche plutôt qu'une nouvelle génération.
4. Qualité et complexity dans l'API GPT-Image-2.6
quality accepte low, medium, high, xhigh, max ou auto. La valeur par défaut est auto. La plupart des équipes n'ont besoin que de trois points de fonctionnement :
lowquand la latence domine et que l'image est jetable.mediumouhighquand la sortie est relue ou livrée.xhighoumaxpour les assets finaux où le détail justifie le travail supplémentaire.
La latence et la consommation de tokens varient selon la charge. Ne copiez pas les prix par image de 2.5 ; 2.6 facture au token.
complexity est distinct : low, medium ou high, avec high comme valeur par défaut dans le guide. Il n'y a pas de frais séparés, mais des réglages plus élevés peuvent ajouter de la latence et des changements indésirables. Traitez-le comme une variable d'adhérence au prompt à tester, pas comme une amélioration gratuite de la qualité : une requête en complexity basse peut être plus rapide, tandis qu'une requête en complexity haute peut résoudre une scène chargée ou « améliorer » des parties que vous vouliez laisser intactes. Faites un petit test A/B sur vos propres prompts.
| Test | quality | complexity | Ce que vous apprenez |
|---|---|---|---|
| Plancher de latence | low | low | La réponse réaliste la plus rapide pour le prompt |
| Comportement par défaut | auto | high (valeur documentée) | Ce que reçoit un client non configuré |
| Contrôle de dérive | high | low | Si une complexity plus basse réduit les changements indésirables |
| Détail final | high ou xhigh | high | Si le travail supplémentaire améliore l'acceptation |
Générez une variable à la fois. Si vous changez la qualité et la complexity ensemble, un mauvais résultat ne vous dit rien sur le réglage responsable.
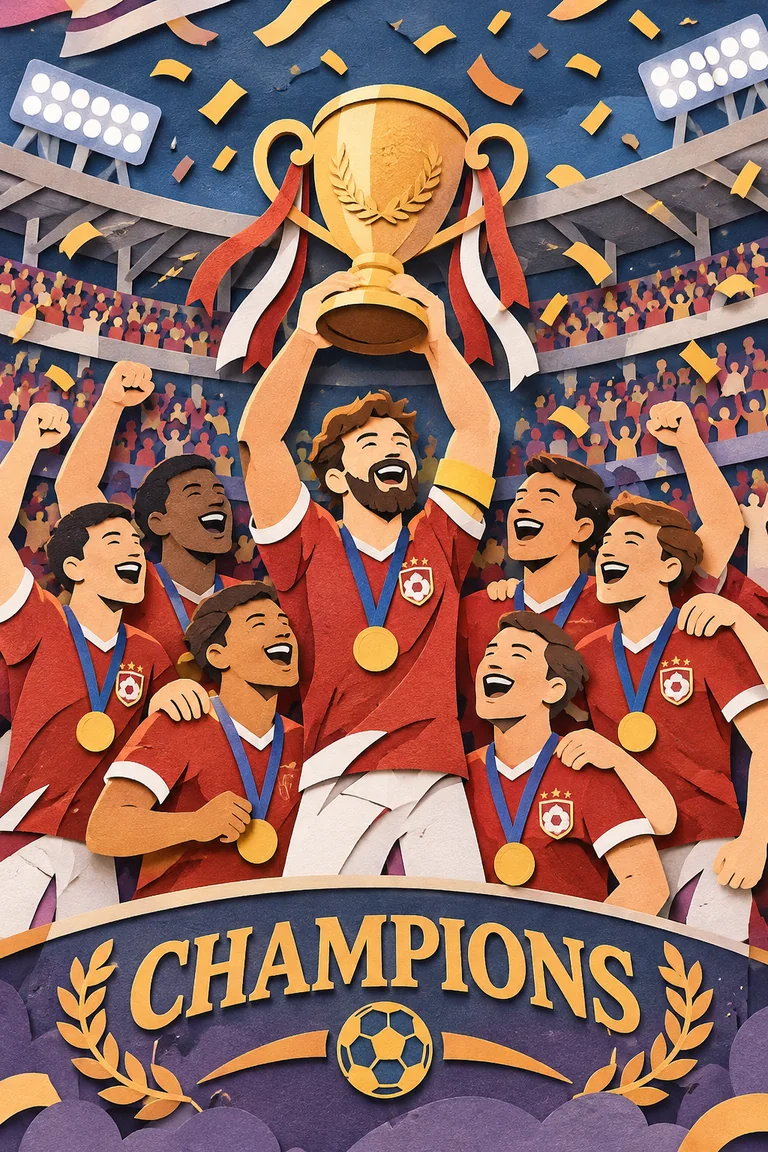
Exemple GPT-Image-2.6 en qualité moyenne : carton superposé et lumières de stade. Sortie illustrative, pas un benchmark.
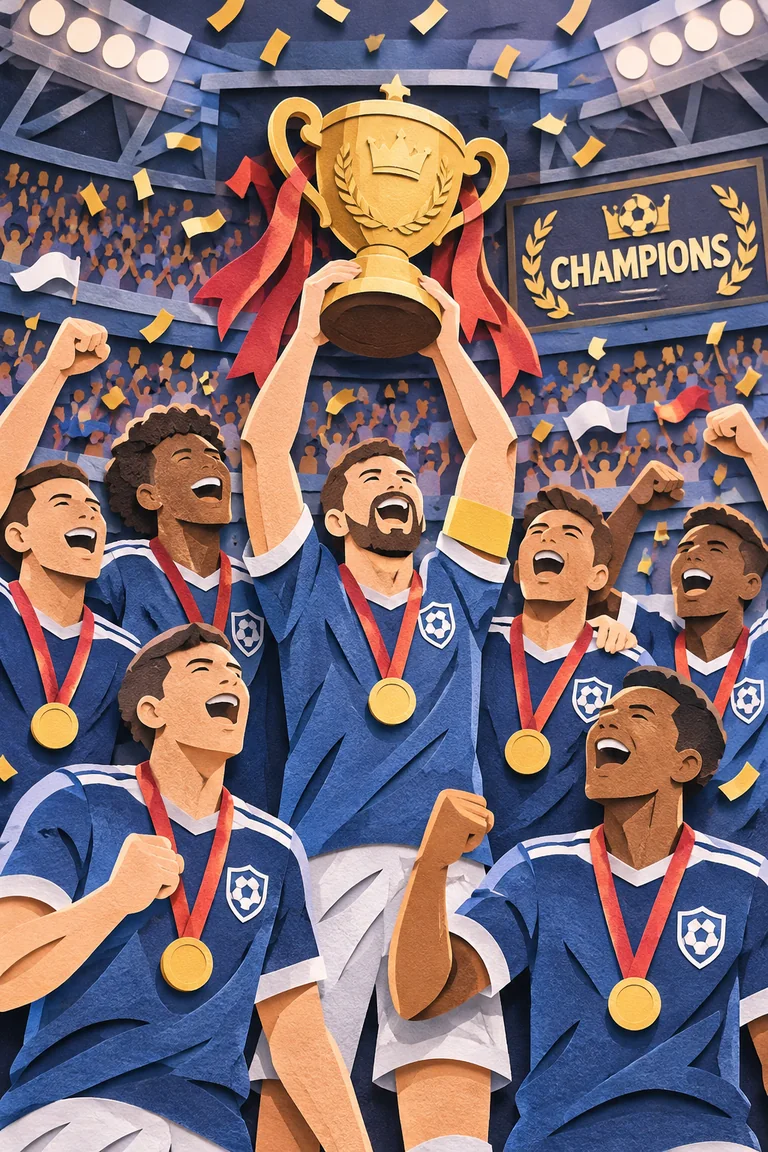
Exemple GPT-Image-2.6 en qualité haute : plus de détail de surface et des bords plus nets. Comparez l'acceptation, pas la netteté, à la taille d'affichage.
5. Sortie GIF depuis l'API GPT-Image-2.6
Le GIF n'existe qu'en génération. Réglez output_format sur gif sur POST /v1/images/generations ; les retouches ne le prennent pas en charge. Les contrôles sont :
frame_count:9par défaut. Le guide image indique2-64, la référence API indique2-16. Ce conflit n'est pas résolu : ne figez pas 64 sans vérification réelle.frame_duration_ms:200par défaut,20minimum. Neuf images à 200 ms produisent une passe de 1,8 seconde ; 16 images en produisent 3,2 secondes. C'est de l'arithmétique, pas une garantie de mouvement fluide.
generate(
    "gpt-image-2.6-flare",
    "A paper lantern monkey swinging through a bamboo forest, simple background, no text",
    "monkey-lantern.gif",
    size="1024x1024",
    quality="low",
    output_format="gif",
    frame_count=9,
    frame_duration_ms=200,
)
Commencez avec les 9 images par défaut. Si vous en voulez plus, progressez par petits pas et arrêtez-vous au premier rejet ; cela vous indique ce que votre compte accepte aujourd'hui. Gardez la scène simple, car un GIF multiplie les décisions visuelles sur toutes les images. Surveillez la taille du fichier livré et ses dimensions, pas seulement le code de statut HTTP.
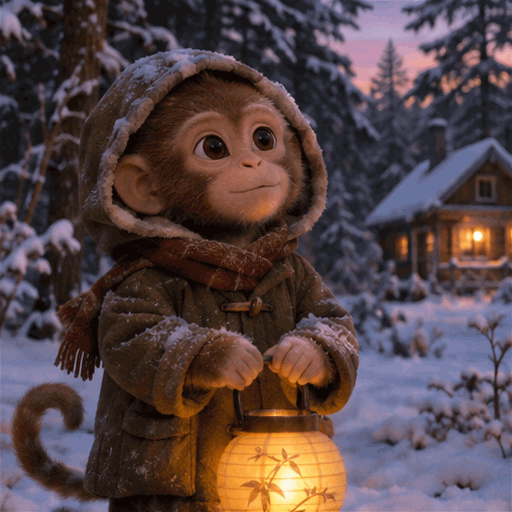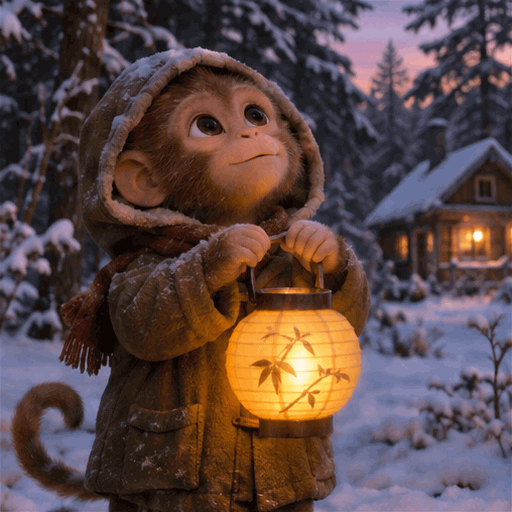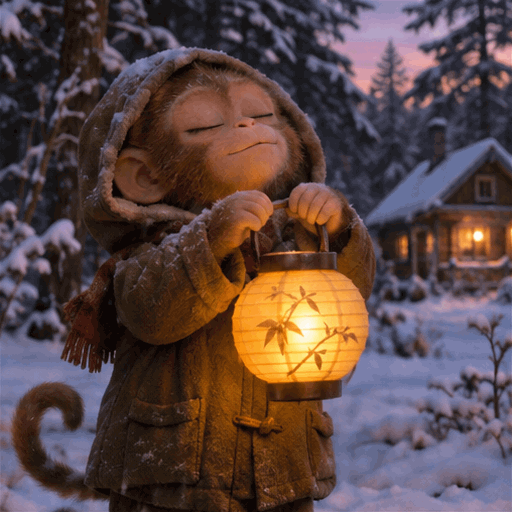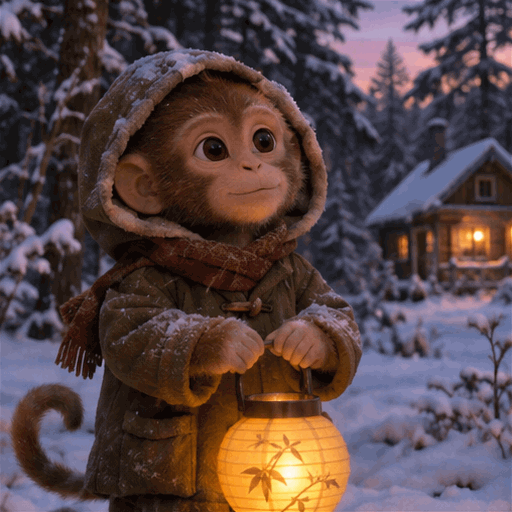
Exemple GPT-Image-2.6 : un court GIF animé généré en un seul appel. Le nombre d'images et la durée de lecture dépendent de vos réglages.
Traitez le GIF comme un format d'aperçu, pas comme un asset maître. Conservez les réglages et, si possible, une image fixe pour les vignettes et les solutions d'accessibilité.
6. Sortie SVG depuis l'API GPT-Image-2.6
Le SVG est aussi réservé à la génération. Réglez output_format sur svg, gardez n=1 et attendez-vous à une sortie vectorielle statique. Restrictions documentées : pas de streaming, pas d'images partielles, pas de compression et pas de prompt_rewriter. Les retouches ne prennent pas en charge le SVG.
generate(
    "gpt-image-2.6-sunburst",
    "A minimal field-and-flour bakery label, wheat stalk and rolling pin, two-color vector, no text",
    "field-and-flour.svg",
    size="1024x1024",
    quality="high",
    output_format="svg",
    n=1,
)
Rejetez n>1 dans votre client. N'envoyez pas output_compression et n'attendez pas de rendu progressif ; le SVG arrive comme un asset statique complet. Comme le SVG est du markup, traitez le fichier comme non fiable : servez-le comme image ou nettoyez-le avant de l'intégrer en ligne. Un vecteur d'apparence correcte contenant des éléments inattendus est un problème de sécurité.
Le SVG convient aux icônes, étiquettes, diagrammes et marques d'impression qui laisseraient voir un agrandissement raster. Il ne convient pas aux photos, à l'animation ni aux flux de retouche. Pour réviser un vecteur, régénérez-le avec un prompt plus précis ou reconstruisez-le dans un outil de design ; ne promettez pas des calques modifiables sans avoir inspecté la structure.
Exemple GPT-Image-2.6 : sortie SVG statique pour une étiquette simple à deux couleurs. Inspectez le markup renvoyé avant de le servir en ligne.
7. Retouches guidées par markup dans l'API GPT-Image-2.6
La retouche guidée par markup envoie une image source plus une superposition PNG transparente à POST /v1/images/edits. La superposition est dessinée sur la première image et doit en partager les dimensions. La première image et la superposition peuvent chacune faire au plus 16 777 216 pixels ; le fichier de superposition peut faire au plus 50 Mo.
Les règles sont strictes :
- Le markup ne peut pas être combiné avec
maskouprompt_rewriter. - La superposition doit être un PNG transparent, pas une capture d'écran aplatie.
- La superposition s'applique à la première image lorsque vous envoyez plusieurs images.
- Il n'y a pas de frais supplémentaires pour le markup, mais la requête reste facturée selon ses tokens.
Exportez l'image de base, créez une superposition RGBA aux mêmes dimensions en pixels, dessinez une flèche ou un contour translucide autour de la cible, puis téléversez les deux avec un prompt qui définit le changement et ce qui doit rester figé. La superposition montre où ; le prompt dit quoi. « Déplace la tasse à droite et conserve la table, l'ombre et l'arrière-plan » est testable. « Fais mieux » ne l'est pas.
import base64
import os
import requests

url = "https://api.toapis.com/v1/images/edits"
headers = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}

with open("base.png", "rb") as image, open("overlay.png", "rb") as markup:
    response = requests.post(
        url,
        headers=headers,
        data={
            "model": "gpt-image-2.6-sunburst",
            "prompt": "Move the mug to the right side of the table and keep the table, shadow, and background unchanged.",
            "size": "1024x1024",
            "quality": "high",
            "complexity": "medium",
        },
        files={"image": image, "markup": markup},
        timeout=180,
    )
response.raise_for_status()
item = response.json()["data"][0]
if item.get("b64_json"):
    open("edited.png", "wb").write(base64.b64decode(item["b64_json"]))
else:
    open("edited.png", "wb").write(requests.get(item["url"], timeout=60).content)
Cet exemple utilise markup comme nom de la partie de superposition ; confirmez-le dans la référence API actuelle. La référence classe le markup comme une fonction 2.5, tandis que le guide image le décrit pour 2.5 et 2.6. Ne livrez rien avant qu'une requête de test réussisse. Si Sunburst rejette le markup, ne changez pas de version en silence ; exposez l'échec et gardez le dernier chemin connu comme fonctionnel.
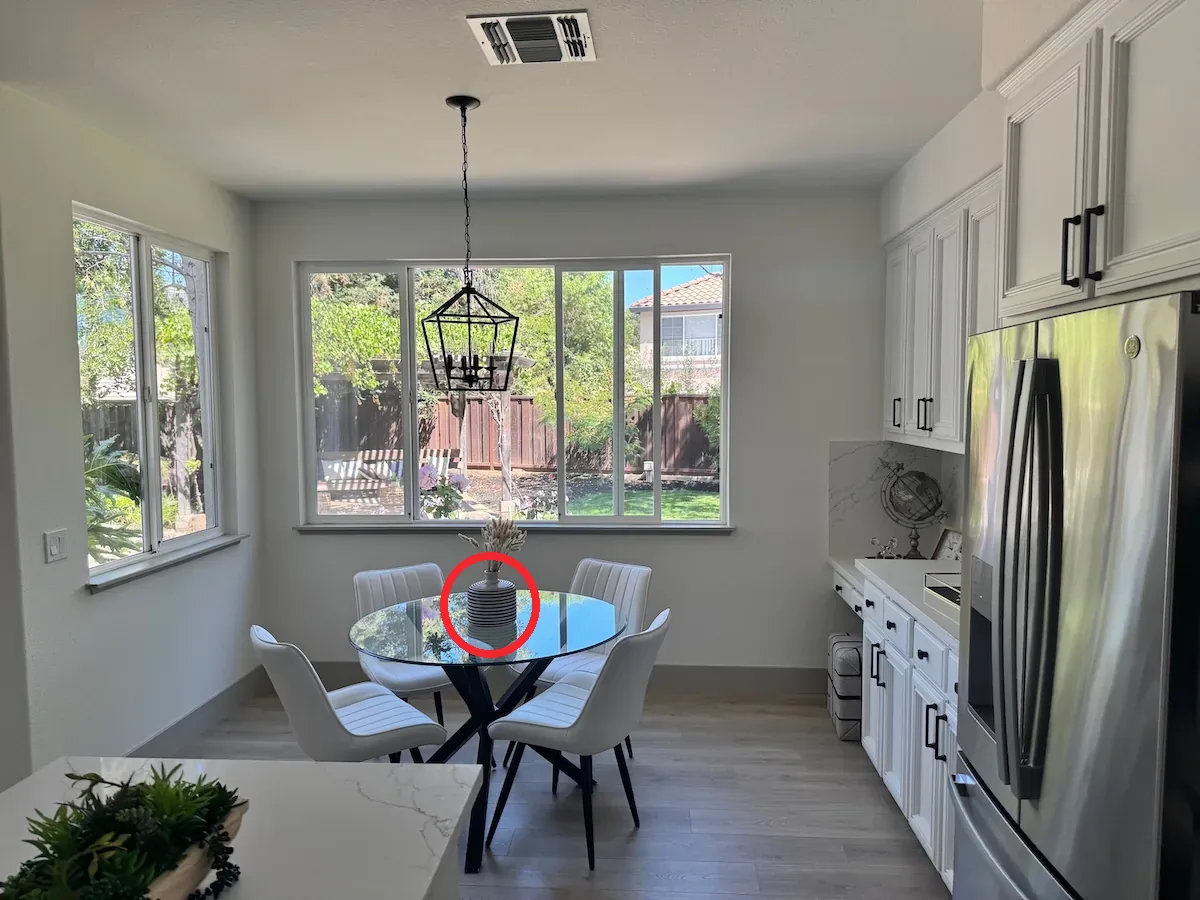
Exemple GPT-Image-2.6 : l'image source avant une retouche guidée par markup. La superposition et le prompt ne sont pas affichés.
Exemple GPT-Image-2.6 : le résultat retouché. Examinez les zones inchangées avec autant de soin que le changement demandé ; un nouvel objet convaincant peut tout de même déplacer l'ombre ou modifier l'arrière-plan.
Mesurez la qualité de la retouche avec une liste de contrôle par région : cible modifiée, géométrie hors cible préservée, ombres et reflets cohérents, texte inchangé et aucun nouvel objet au bord de la superposition. Conservez l'image de base pour pouvoir réessayer sans la régénérer.
8. Tailles et limites dans l'API GPT-Image-2.6
Les tailles recommandées sont 1024x1024, 1536x1024 et 1024x1536. Les tailles personnalisées doivent utiliser des dimensions multiples de 16, un format d'image entre 1:3 et 3:1, et ne pas dépasser 3840x2160. Tout ce qui dépasse 2560x1440 est expérimental ; vérifiez-le en premier lorsqu'une mise en page s'écarte des tailles recommandées.
Une petite validation côté client intercepte la plupart des requêtes invalides avant qu'elles ne coûtent un aller-retour :
def validate_size(width: int, height: int) -> str:
    if width % 16 or height % 16:
        raise ValueError("width and height must be multiples of 16")
    if not (1 / 3 <= width / height <= 3):
        raise ValueError("aspect ratio must stay between 1:3 and 3:1")
    if width > 3840 or height > 2160:
        raise ValueError("maximum size is 3840x2160")
    if width * height > 3840 * 2160:
        raise ValueError("pixel area exceeds the documented maximum")
    return f"{width}x{height}"
Les contradictions de la documentation de l'API GPT-Image-2.6 ne sont pas cosmétiques. Elles changent ce que votre client devrait accepter :
| Sujet | Une source dit | Une autre dit | Action d'ingénierie |
|---|---|---|---|
frame_count du GIF | Guide image : 2-64 | Référence API : 2-16 | Commencez à 9 ; progressez par pas ; ne figez pas 64 |
| Prise en charge du markup par modèle | Guide image : 2.5 et 2.6 | Référence API : 2.5 uniquement | Testez 2.6 sur votre compte ; gardez un fallback |
| Tables de qualité et de taille | Le guide 2.6 inclut des niveaux et tailles récents | Certaines pages de référence retardent sur la génération précédente | Validez l'énumération et les dimensions à l'exécution |
Traitez la documentation comme une configuration versionnée : consignez l'URL source, la date d'accès et le comportement réel de votre compte. Un 400 dû à une énumération non prise en charge est une preuve ; un commentaire dans la configuration ne l'est pas.
9. Le coût réel d'un appel à l'API GPT-Image-2.6
OpenAI facture Images 2.6 au token. gpt-image-2.6-flare comme gpt-image-2.6-sunburst utilisent les mêmes tarifs :
| Type de token | Standard | En cache |
|---|---|---|
| Sortie image | $30.00 / 1M | Non applicable |
| Entrée image | $8.00 / 1M | $2.00 / 1M |
| Entrée texte | $5.00 / 1M | $1.25 / 1M |
La formule de coût est la suivante :
cost = (image_output_tokens * 30
      + image_input_tokens * 8
      + cached_image_input_tokens * 2
      + text_input_tokens * 5
      + cached_text_input_tokens * 1.25) / 1_000_000
Il n'existe pas de prix fixe officiel par image ; toute estimation part de la consommation de tokens mesurée. Supposez qu'une requête de génération facture 400 tokens d'entrée texte et 5 000 tokens de sortie image : (400 × 5 + 5 000 × 30) / 1 000 000 = $0.152. Ces nombres sont illustratifs, pas une moyenne. Une retouche qui facture en plus 2 000 tokens d'entrée image ajoute $0.016, soit $0.168.
Sur 1 000 requêtes, le $0.152 hypothétique devient environ $152, avant l'entrée image ou les remises de cache. Suivez le coût par image acceptée, pas par requête : incluez les nouvelles tentatives, les rejets, le temps de revue et le stockage. Un appel moins cher peut perdre quand les relecteurs rejettent 40 % de sa sortie.
Deux règles gardent le calcul honnête : 50 % plus rapide ne signifie pas 50 % moins cher, car la vitesse change la latence, pas les tarifs par tokens ; et les prix par image de 2.5 ne s'appliquent pas à 2.6. L'entrée en cache ne réduit le coût des retouches à référence répétée que si l'entrée est servie depuis le cache. Consultez les tarifs et rapprochez-les de la consommation renvoyée.
10. Liste de contrôle pour la production et limites connues
L'API GPT-Image-2.6 est capable, mais ce n'est pas un moteur de mise en page déterministe. Les limites documentées s'appliquent toujours : les prompts complexes peuvent prendre environ deux minutes, le rendu de texte a ses limites, la cohérence entre générations n'est pas garantie et le contrôle de la composition est imparfait. Concevez pour la revue et la nouvelle tentative, pas pour un appel parfait.
Avant de router du trafic vers l'API GPT-Image-2.6 :
- Fixez un timeout au-dessus du pire cas, ou mettez les tâches longues en file. Ne relancez pas à l'aveugle une requête payée après un timeout ambigu ; vérifiez d'abord le statut ou l'idempotence.
- Validez les identifiants de modèle, la qualité, la complexity, la taille et le format de sortie dans votre propre client. Rejetez les combinaisons non prises en charge avant de dépenser une requête.
- Journalisez le modèle demandé et renvoyé, le format, les dimensions, la qualité, la complexity, la consommation de tokens, la latence et un hash de la sortie. Masquez les clés et les prompts sensibles.
- Séparez les échecs de génération et de retouche dans vos métriques. Une requête markup rejetée et une génération lente sont des incidents différents.
- Utilisez l'API Responses pour la retouche d'images sur plusieurs tours ; elle prend en charge génération et retouche entre les tours. Les endpoints Images restent plus simples pour les tâches en un seul coup.
- Gardez un fallback testé. Si Sunburst est indisponible, Flare peut encore servir la requête, mais sa sortie diffère ; prévenez l'utilisateur quand un modèle de secours a été utilisé au lieu de substituer en silence.
- Stockez les assets nécessaires dans un stockage maîtrisé. Ne supposez pas qu'une URL temporaire soit une archive permanente et n'intégrez pas un SVG non fiable sans nettoyage.
Pour le déploiement, utilisez un jeu fixe représentatif de votre charge : un petit texte d'emballage, un produit qui doit conserver sa forme après une retouche, une composition large et une courte animation. Notez selon une liste de contrôle écrite, puis comparez les modèles sur le taux d'acceptation et la latence p95, pas sur des captures d'écran.
11. Questions fréquentes
Dois-je utiliser gpt-image-2.6-flare ou gpt-image-2.6-sunburst ?
Utilisez Flare pour l'exploration, les variantes et les brouillons sensibles à la latence, surtout avec quality=low. Utilisez Sunburst pour le détail final et les retouches qui doivent préserver le reste de l'image avec quality=medium ou high. Les deux modèles partagent les tarifs par tokens : faites donc un petit test d'acceptation plutôt que de supposer que le modèle de meilleure qualité est toujours nécessaire.
L'API GPT-Image-2.6 prend-elle en charge GIF et SVG pour les retouches ?
Non. GIF et SVG sont des formats de génération de l'API GPT-Image-2.6 ; les retouches ne prennent en charge ni l'un ni l'autre. Le SVG est du vectoriel statique avec n=1 et sans streaming, images partielles, compression ni prompt_rewriter. Le GIF est également réservé à la génération. Construisez des chemins séparés au lieu d'espérer qu'une retouche ignore le format.
Combien coûte une image via l'API GPT-Image-2.6 ?
Il n'existe pas de prix fixe officiel par image. La sortie image coûte $30 par 1M de tokens, l'entrée image $8 par 1M ($2 en cache) et l'entrée texte $5 par 1M ($1.25 en cache). Estimez avec vos nombres de tokens mesurés, puis divisez la dépense totale par les images acceptées. Ne réutilisez pas les prix par image de 2.5 pour un budget 2.6.
Pourquoi la documentation de l'API GPT-Image-2.6 se contredit-elle ?
Le guide et la référence API ne sont pas entièrement synchronisés. frame_count apparaît à la fois comme 2-64 et 2-16 ; le markup est documenté comme réservé à 2.5 dans la référence mais 2.5/2.6 dans le guide ; certaines tables de qualité et de taille retardent. Traitez ces limites comme propres à une version, testez sur votre compte et consignez la date et le résultat de la vérification.
12. Commencez par trois appels, pas par une migration
Évaluez l'API GPT-Image-2.6 avec un lot contrôlé : un brouillon Flare low/low, un final Sunburst high/high et une requête de format adaptée à votre produit. Journalisez les tokens, la latence et l'acceptation, puis décidez ce qui mérite une place dans le pipeline.
Créez un compte ToAPIs, consultez le guide du modèle GPT-Image-2.6 pour l'accès actuel et confirmez les tarifs sur la page des tarifs. Si vous êtes encore sur la génération précédente, lisez d'abord le guide de l'API GPT Image 2, puis migrez un endpoint à la fois au lieu de réécrire tout le pipeline.