








1. Ce que Gemini Omni 1.2 Flash apporte
Google Cloud liste gemini-omni-1.2-flash comme un modèle multimodal généralement disponible conçu pour des tâches vidéo, image et texte. La matrice de capacités documentée inclut texte en vidéo, image en vidéo, référence en vidéo, vidéo avec première et dernière image, édition vidéo, extension vidéo et upscaling vidéo. Elle liste aussi le raisonnement (thinking), mais pas les instructions système, la sortie structurée, l'appel de fonctions ni l'API Gemini Live pour ce modèle.
La page du modèle documente une sortie vidéo de 3 à 15 secondes pour la génération et l'édition, de 3 à 10 secondes pour la génération avec première et dernière image, et de 3 à 10 secondes de durée ajoutée pour l'extension. Les ratios pris en charge sont 16:9 et 9:16 ; les résolutions de sortie documentées sont 360p, 720p, 1080p et 4k. Les limites de vidéo d'entrée dépendent de l'opération : l'édition et l'upscaling acceptent jusqu'à 15 secondes, tandis que l'extension utilise la fin d'une source plus longue selon son propre contrat.
| Capacité | Ce que dit la documentation principale | Question d'intégration |
|---|---|---|
| Texte en vidéo | Vidéo guidée par prompt, 3–15 secondes | Quels champs de résolution et d'audio le fournisseur choisi expose-t-il ? |
| Image ou référence en vidéo | Références image et vidéo, avec limites propres à la route | L'ordre des images et les noms de référence ont-ils un sens sémantique ? |
| Première et dernière image | Pris en charge, avec sortie de 3–10 secondes | La seconde image est-elle une image de fin ou une autre référence ? |
| Édition vidéo | Éditer une vidéo source jusqu'à 15 secondes | La durée et le ratio suivent-ils la source ? |
| Extension vidéo | Ajouter 3–10 secondes selon un contrat d'extension | duration est-il la longueur ajoutée ou la longueur totale de sortie ? |
| Upscaling vidéo | Augmenter les résolutions sources prises en charge jusqu'à 4K | Ce rehaussement est-il facturé séparément de la génération ? |
Les annonces de lancement mettent en avant cinq améliorations pratiques par rapport à la génération précédente : des clips de 15 secondes, un prix public plus bas en 720p, une meilleure fidélité aux références image et vidéo, une génération de brouillon en résolution plus basse suivie d'un upscaling en 1080p ou 4K, et un dialogue plus naturel avec une synchronisation labiale plus nette et des conditions à plusieurs locuteurs. Google décrit aussi l'édition conversationnelle, comme changer un produit, l'éclairage ou l'angle de caméra sans repartir de zéro.
Ce sont des affirmations de niveau produit, pas la promesse que chaque fournisseur expose chaque contrôle. Un fournisseur peut diviser une famille de modèles en plusieurs slugs, omettre une capacité ou ajouter une couche de facturation différente. Traitez toujours le schéma exact de la route comme le contrat d'intégration.
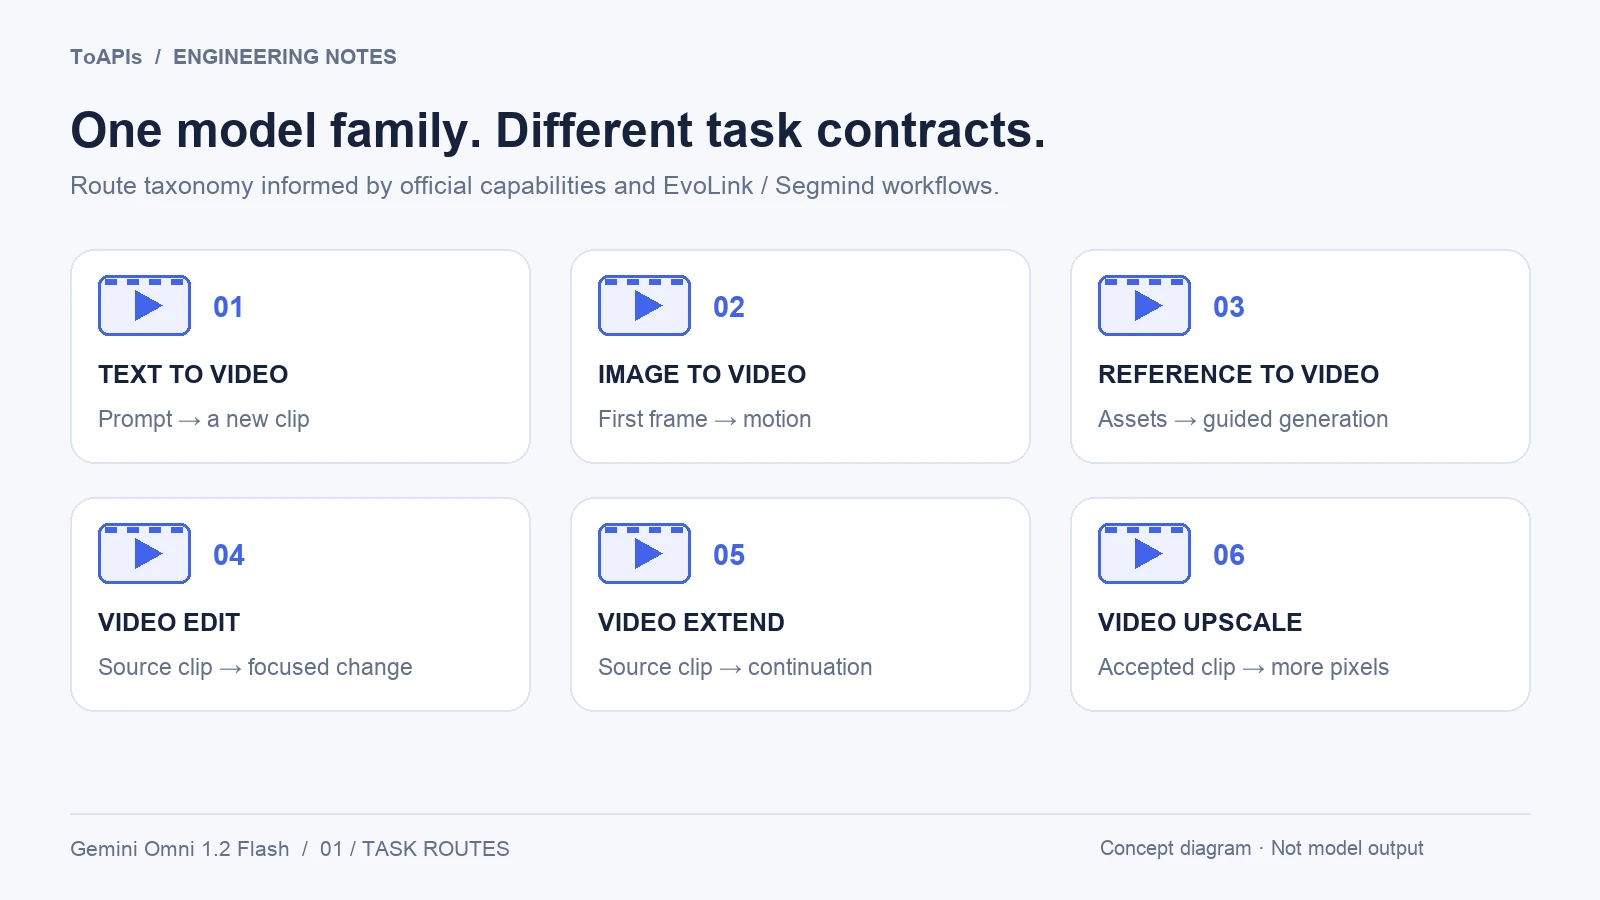
Illustration originale de la carte des tâches fondée sur la liste officielle des capacités et sur des descriptions de routes tierces. Les endpoints réels varient selon le fournisseur ; ceci n'est pas une sortie du modèle.
2. Six routes, six contrats différents
Certaines passerelles vidéo tierces présentent six routes de tâche sur une interface vidéo asynchrone unique : texte en vidéo, image en vidéo, référence en vidéo, édition vidéo, extension vidéo et upscaling vidéo. Leurs IDs de modèle aident à comprendre la planification des routes, mais ce sont des identifiants propres au fournisseur, pas des identifiants ToAPIs confirmés.
Les rapports de tests indépendants offrent eux aussi une vue orientée routes et notent explicitement que certaines routes comme refine n'étaient pas disponibles lors des tests de lancement. C'est un bon exemple de pourquoi une liste de capacités séduisante ne doit pas être copiée dans un formulaire produit sans vérification du schéma en direct.
| Route | Entrée typique | Limite principale à valider |
|---|---|---|
| Texte en vidéo | Prompt | 3–15 secondes ; résolution, ratio, audio et seed peuvent dépendre du fournisseur |
| Image en vidéo | Première image et prompt | Une seconde image peut définir une image de fin ; confirmez la durée maximale |
| Référence en vidéo | Images ou vidéos de référence plus prompt | Les règles de nombre, de durée et de nommage des références diffèrent |
| Édition vidéo | Vidéo source plus une modification ciblée | Longueur de la source, filtres de sécurité et suivi ou non du cadrage source |
| Extension vidéo | Vidéo existante plus prompt de continuation | La durée ajoutée n'est pas forcément la durée totale |
| Upscaling vidéo | Vidéo existante, généralement sans prompt | Tailles sources acceptées, paliers de sortie et facturation séparée |
Un sélecteur de route doit faire évoluer ensemble ses règles de validation, son texte d'aide et son estimation de coût. Ne laissez pas un champ générique duration transporter silencieusement la sémantique d'une route d'extension vers une route de génération. Ne supposez pas qu'un champ nommé image_urls signifie la même chose dans les requêtes image en vidéo et référence en vidéo.
Ne mélangez pas les limites Google Cloud et API Gemini
Le guide de l'API Gemini documente jusqu'à six images de référence, tandis que la page du modèle sur Google Cloud liste jusqu'à dix images par prompt. L'API Gemini applique aussi des limites de vidéos de référence qui dépendent de la durée demandée : une génération plus longue de 11 à 15 secondes prend en charge une seule courte vidéo de référence, et non le même budget de références qu'une tâche de 3 à 10 secondes. Ce sont des contrats de plateforme distincts, pas des valeurs contradictoires à moyenner ou à combiner.
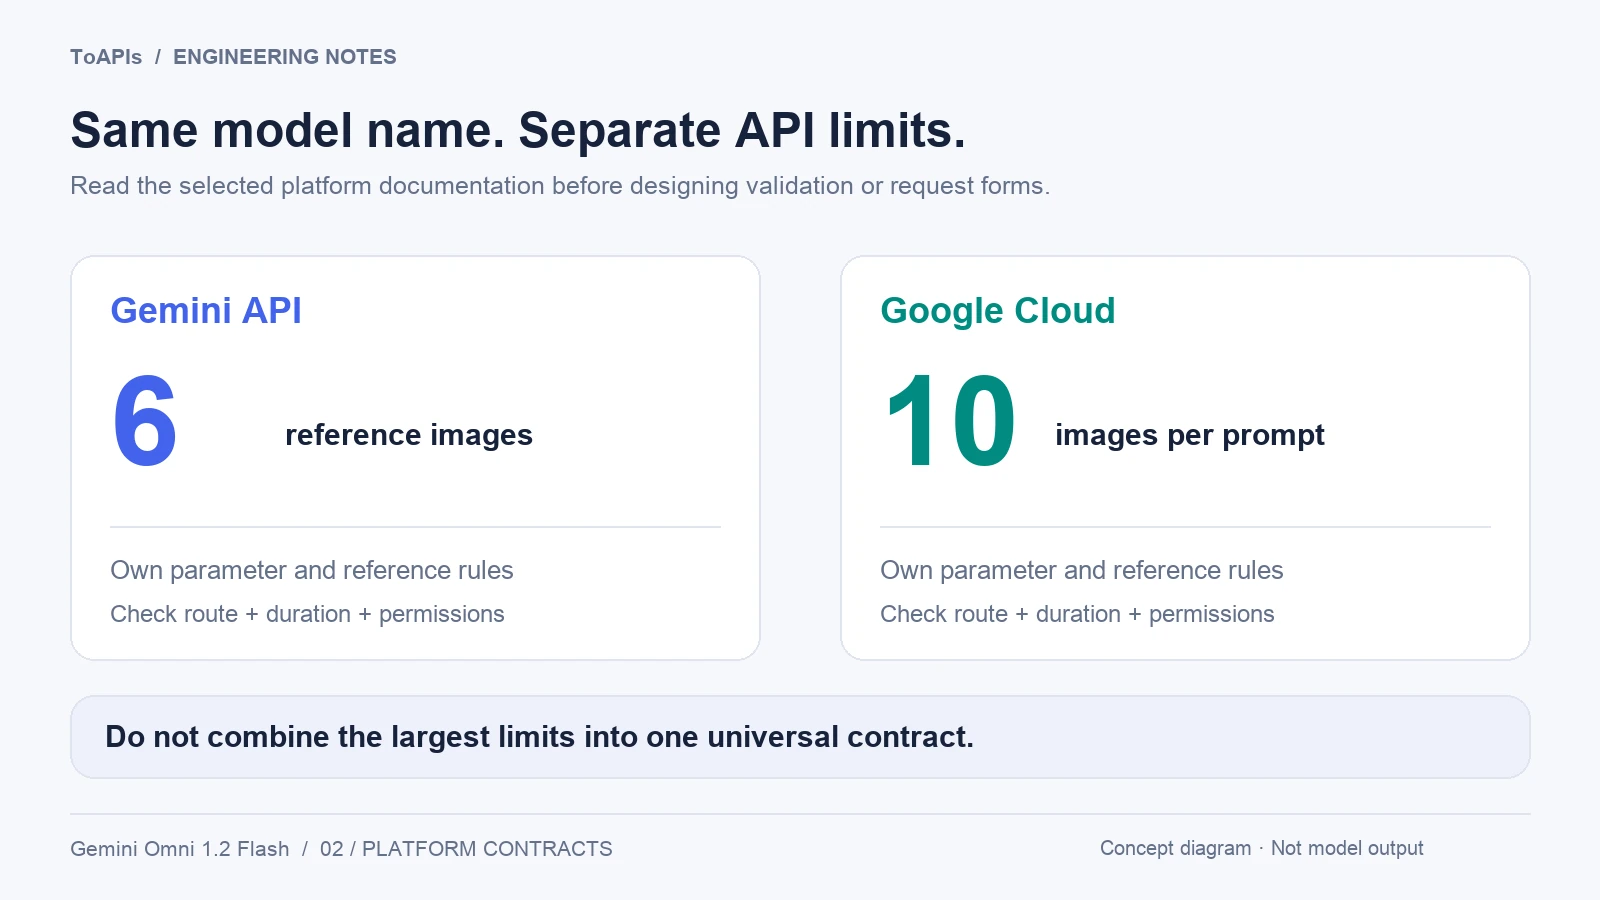
Contrats de plateforme séparés : six images de référence dans l'API Gemini contre dix images par prompt dans la documentation Cloud. Ces maxima ne se combinent pas ; vérifiez la route et la durée choisies.
Pour l'API Gemini, l'intégration documentée utilise l'Interactions API, pas generate_content, pas un appel chat-completions OpenAI et pas une méthode generate_videos propre à Veo. L'exemple suivant est un appel payant adapté, pas une requête ToAPIs. Il nécessite un SDK google-genai à jour, un compte éligible et une clé configurée localement ; ne placez jamais d'identifiants dans un prompt ni dans un bundle navigateur. Il n'a pas été exécuté pour cet article.
import base64
from pathlib import Path
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input=(
        "A blue ceramic cup on a neutral table. "
        "One continuous slow camera push-in. "
        "Soft room ambience, no speech, no text."
    ),
    response_format={
        "type": "video",
        "resolution": "360p",
        "duration": "5s",
        "aspect_ratio": "16:9",
    },
)
Path("omni-draft.mp4").write_bytes(
    base64.b64decode(interaction.output_video.data)
)
print("interaction ID:", interaction.id)
Dans cette API, duration est une chaîne comme "5s", pas un entier copié depuis un formulaire de passerelle ; les contrôles de génération se trouvent sous response_format. Pour les fichiers plus volumineux, le guide documente la livraison par URI et la gestion de la disponibilité du fichier. Les éditions multitours utilisent previous_interaction_id ; définir store=false supprime l'état stocké nécessaire à ce suivi. Examinez ces compromis plutôt que de copier aveuglément des réglages de latence.
3. Stratégie de résolution : brouillon d'abord, upscaling sélectif
Le guide de l'API Gemini identifie explicitement 360p et 720p comme paliers de génération, et 1080p et 4k comme sortie upscalée. Une option de livraison 4K n'établit donc pas une génération 4K native. Le workflow le plus pratique du matériel de lancement sépare l'exploration de la livraison. Utilisez 360p ou 720p pour itérer les prompts et vérifier la composition. Une fois qu'un clip passe la checklist d'acceptation, comparez le choix d'une livraison haute résolution dans une requête de génération avec l'upscaling séparé d'un clip existant. Confirmez que le fournisseur prend en charge chaque chemin ; aucun des deux n'implique une génération 4K native.
Cette stratégie réduit les générations haute résolution gaspillées, mais introduit une seconde opération à mesurer. Un upscaler peut ajouter du détail sans changer le mouvement sous-jacent ni corriger une mauvaise composition. Il ne peut pas garantir qu'une étiquette erronée, un visage instable ou un mouvement d'objet incorrect devienne correct en 4K.
Conservez la résolution source, la résolution de sortie, la route, la durée et la consommation de tokens dans l'enregistrement du job. Lorsque le fournisseur prend en charge les deux chemins, comparez la livraison haute résolution sélectionnée dans une requête de génération avec l'upscaling séparé d'un clip existant, à entrées, cadrage et critères d'acceptation équivalents. Aucun des deux chemins n'établit une génération 4K native. Des rapports de tests indépendants ont noté un détail utile apporté par l'upscaling, tout en le traitant comme une étape de workflow facturée dont le prix doit être mesuré.
Pour la production, définissez deux portes :
- Une porte créative : identité du sujet, composition, mouvement, texte, dialogue et son répondent au brief.
- Une porte de livraison : dimensions, durée, codec, piste audio, droits et conservation des fichiers répondent à l'exigence aval.
Seuls les clips qui passent les deux portes devraient entrer dans la bibliothèque d'actifs finale.
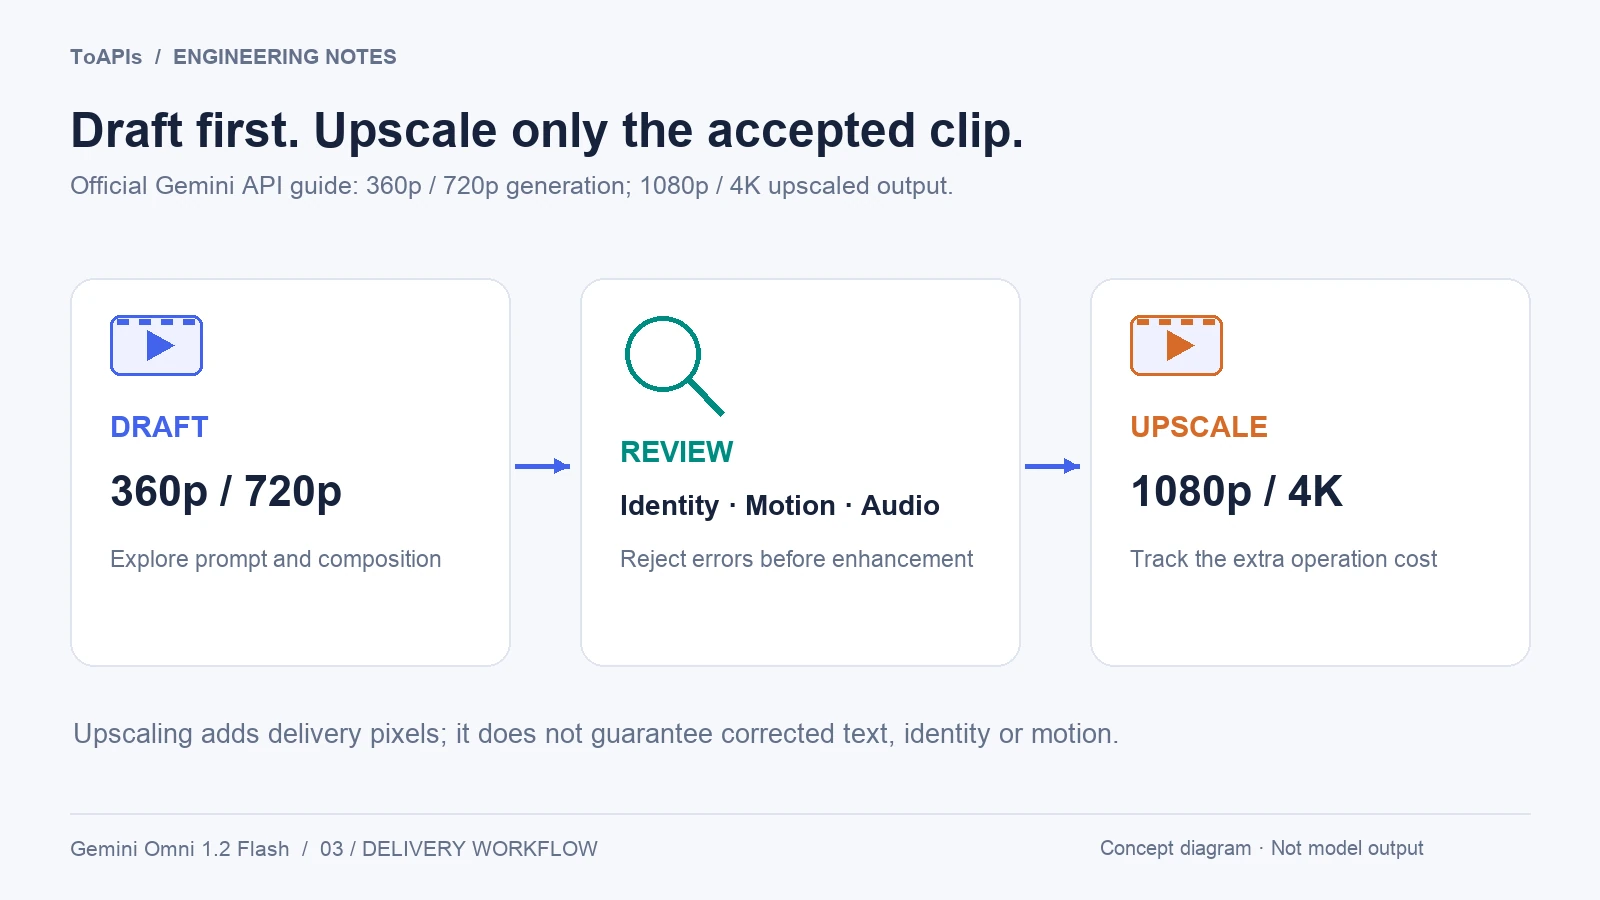
Workflow conceptuel fondé sur le guide de l'API Gemini. La livraison en résolution supérieure utilise l'upscaling ; elle ne garantit pas un mouvement, un texte ou une identité corrigés.
4. Prompting pour une vidéo fidèle à l'instruction
Les tests tiers sont particulièrement précieux pour la conception de prompts lorsqu'ils révèlent quoi vérifier, et non lorsqu'ils deviennent des affirmations de benchmark universelles. Les rapports de tests indépendants notent de bons résultats pour des explainers étiquetés, de la typographie cinétique, l'animation de graphiques à partir d'une image finale fournie, des motion graphics stylisés et des éditions à modification unique sur des images réelles. Ces mêmes rapports notent des résultats plus faibles pour des personnes photoréalistes créées de zéro, des tracés de données à partir de nombres seuls et certaines éditions multi-étapes ou de logos de marque.
Un prompt Omni robuste doit séparer :
- le sujet et son identité visible ;
- les temps ordonnés de la scène ;
- le mouvement de caméra et ce qui doit rester fixe ;
- le texte exact à l'écran, cité séparément ;
- le dialogue, la musique et les effets sonores ;
- l'état final, de préférence fixé avec une entrée de dernière image lorsque la route le permet ;
- une modification à préserver pour une édition, plus tout ce qui doit rester inchangé.
Par exemple :
Create a flat 2D motion-graphics explainer in 16:9.
Show the title 'HOW A PRODUCT VIDEO API WORKS' exactly as written.
First show one product photo, then three labelled route cards from left to right,
then connect the cards to one finished video frame.
Keep every label fixed after it appears. Use a locked-off camera.
Add a short, calm voiceover and a soft click for each route card.
End on the complete diagram. Do not add any other text or logos.
Ce brief est un test proposé, pas une sortie Omni mesurée. Les règles d'acceptation sont plus utiles que des adjectifs comme « cinématographique » ou « viral » : chaque étiquette doit correspondre, l'ordre doit être correct, la caméra doit rester fixe et l'audio ne doit contenir que les signaux demandés.
5. Audio natif, références et édition
La documentation officielle liste la parole, la musique et les effets sonores comme pris en charge, tandis que l'article de lancement de Google met en avant un dialogue plus naturel, une synchronisation labiale plus nette et des conditions distinctes à plusieurs locuteurs. L'annonce Google Cloud note aussi que les références audio sont soumises à une liste d'autorisation. L'audio nécessite donc sa propre vérification de capacité et d'autorisation, pas seulement une case à cocher dans un formulaire vidéo générique.
La cohérence des références est l'un des thèmes phares du modèle. Google décrit une meilleure fidélité aux références image et vidéo, et la page officielle du modèle prend en charge la génération basée sur références. La prise en charge des références n'est pourtant pas une garantie d'identité. Vérifiez le visage, les vêtements, la silhouette du produit, les marques visibles, l'éclairage et le mouvement sur tout le clip.
L'édition conversationnelle est également un concept de workflow, pas nécessairement un endpoint universel unique. Le matériel de lancement décrit le changement d'un produit, de l'éclairage ou de l'angle de caméra dans le même clip. Un fournisseur peut l'implémenter comme une édition vidéo, un ID d'interaction, une référence à une tâche précédente ou un corps de requête différent. Confirmez le contrat avant de stocker des hypothèses dans votre base de données.
Pour chaque édition, enregistrez :
- la vidéo source et ses droits ;
- l'instruction exacte de modification unique ;
- ce qui doit rester inchangé ;
- la route et l'ID de modèle ;
- l'ID de tâche ou d'interaction renvoyé ;
- les résultats audio et de revue de sécurité.
Cela rend une édition échouée diagnosticable et une édition réussie suffisamment reproductible pour la revue.
6. Le prix par token n'est pas un devis ToAPIs
Les supports de lancement de Google publient un prix fournisseur pour la vidéo 720p et décrivent une baisse par rapport au modèle précédent. Certaines passerelles vidéo tierces présentent leurs propres calculateurs basés sur les tokens, remises et prix par route, tandis que des analyses tarifaires tierces dérivent des estimations par seconde en 720p à partir d'hypothèses de tokens ou cadrent le lancement autour d'un prix par seconde publié. Ces chiffres ne sont pas interchangeables.
Le tableau des tarifs Standard de l'API Gemini, consulté le 6 novembre 2026, liste 1,50 USD par million de tokens d'entrée pour le texte, les images et la vidéo ; 9,00 USD par million de tokens de sortie texte, raisonnement inclus ; et 12,00 USD par million de tokens de sortie vidéo. Aucun palier gratuit n'est proposé pour ce modèle. Ce sont des prix catalogue du fournisseur pour cette plateforme, pas un devis ToAPIs.
La même page de tarifs liste 5 792 tokens de sortie vidéo par seconde en 720p. Un clip de 15 secondes en 720p a donc une composante illustrative de sortie vidéo de 15 × 5 792 × 12 / 1 000 000 = USD 1,04256, avant les frais d'entrée et de sortie texte/raisonnement. Cela explique le titre de lancement arrondi d'environ 0,07 USD par seconde sans en faire un tarif forfaitaire fixe. Les prix, les règles de tokens et les marges de passerelle peuvent changer.
Un modèle de coût de production doit identifier :
| Dimension de coût | Ce qu'il faut conserver |
|---|---|
| Fournisseur ou passerelle | Le fournisseur exact, l'ID de modèle et la date |
| Unité de facturation | Secondes, tokens de sortie vidéo, tokens d'entrée, tokens de raisonnement ou un forfait |
| Multiplicateur de résolution | Livraison haute résolution choisie dans la génération contre upscaling demandé séparément ; vérifiez la prise en charge et la facturation du fournisseur |
| Médias d'entrée | Images, vidéos sources et leurs règles de tokens facturables |
| Politique de reprise et de rejet | Si les échecs de sécurité, de validation ou de transport sont facturés |
| Rendement d'acceptation (taux de réussite) | Clips passant la checklist de livraison divisés par le total des tentatives |
Pour un plan hypothétique basé sur les tokens, écrivez la formule plutôt que de copier le devis d'un concurrent :
raw generation cost = input token cost
                    + text and thinking output token cost
                    + video output token cost
workflow cost = sum of all generation attempts
              + separately billed upscaling
              + storage, transfer and review cost
cost per accepted clip = workflow cost / accepted clips
Ne comptez pas deux fois un poste déjà inclus dans la facture ; lorsque accepted clips vaut 0, le coût par clip accepté est indéfini et doit être signalé séparément.
Ne publiez pas de prix ToAPIs avant que son catalogue actuel ou son endpoint de devis confirme le modèle, la SKU, l'unité et le tarif propre au compte. N'affirmez pas qu'une latence ou un coût mesurés par un tiers s'appliquent à une autre passerelle.
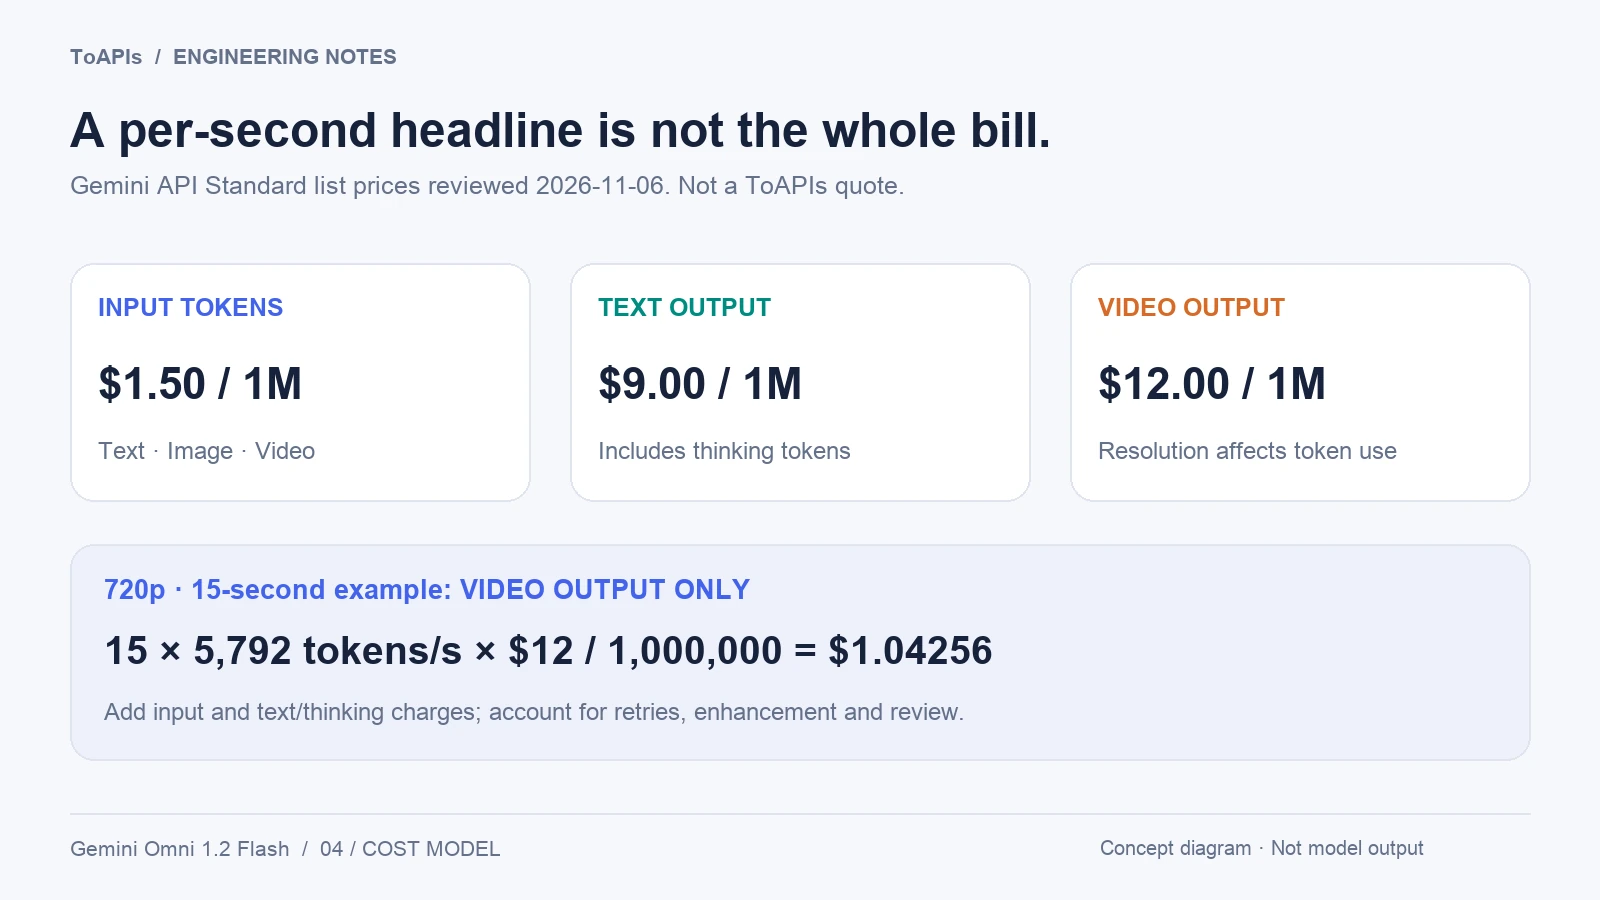
Illustration de prix catalogue fournisseur consultés le 6 novembre 2026, pas un devis ToAPIs. Les 1,04256 USD ne couvrent que la sortie vidéo dans cet exemple ; les frais d'entrée et de texte/raisonnement s'y ajoutent.
7. Construisez un pack d'acceptation avant la production
Avant d'activer ce modèle dans une application, exécutez un petit pack reproductible :
- Texte en vidéo : un explainer étiqueté avec des temps ordonnés et des signaux audio explicites.
- Image en vidéo : une première image produit avec un état final imposé.
- Référence en vidéo : un sujet sous plusieurs vues, avec une checklist de continuité.
- Édition vidéo : une modification sur un clip réel en préservant le jeu d'acteur.
- Extension vidéo : un plan dont la direction de caméra et le son doivent se poursuivre naturellement.
- Livraison haute résolution : si le fournisseur prend en charge les deux chemins, comparez le choix d'une livraison haute résolution dans une requête de génération avec l'upscaling séparé d'un brouillon déjà accepté ; aucun des deux n'implique une génération 4K native.
Pour chaque test, enregistrez l'ID de modèle, la route, les entrées, le prompt, la seed si prise en charge, la résolution, la durée, l'ID de tâche, le temps d'attente, le temps de traitement, les données de tokens ou de facturation en sortie, le résultat audio et le verdict d'acceptation. Conservez les échecs au lieu de ne garder que les meilleurs exemples.
Utilisez les avis tiers comme des hypothèses. Par exemple, une revue indépendante de 20 tests est précieuse lorsqu'elle nomme à la fois les forces et les échecs, mais ses prix facturés, sa latence et le comportement de son fournisseur appartiennent à cet environnement de test précis. Ce n'est pas un benchmark indépendant de chaque intégration Gemini Omni 1.2 Flash.
8. Checklist de disponibilité et d'intégration
L'ID de modèle officiel de Google est gemini-omni-1.2-flash, mais un ID de modèle seul ne signifie pas qu'une passerelle l'a activé. Avant d'intégrer via ToAPIs, inspectez le catalogue de modèles, les tarifs actuels et la documentation de requête. Confirmez la route exacte, le droit du compte, le corps de requête, le modèle de statut asynchrone, la durée de conservation du résultat et la politique de facturation.
Si la route est absente ou le devis indisponible, gardez la fonctionnalité désactivée ou étiquetez-la comme à venir. Ne mappez pas silencieusement un autre modèle Gemini au même nom marketing. Ne signalez pas de génération réelle tant qu'un appel authentifié n'a pas réussi et que les médias renvoyés n'ont pas été examinés.
Sources et politique de mise à jour
- Google : Gemini Omni 1.2 Flash, vidéo de 15 secondes et tarifs plus bas — annonce officielle de lancement, 5 novembre 2026.
- Google Cloud : Gemini Omni 1.2 Flash désormais GA — disponibilité générale, contexte entreprise et affirmations de lancement.
- Documentation du modèle Google Cloud — ID de modèle, capacités, limites et état de sortie.
- Guide Omni de l'API Gemini — Interactions API, références propres à la plateforme, paliers de résolution upscalée et état d'édition.
- Tarifs de l'API Gemini — tarifs par token Standard et conversion des tokens vidéo ; un prix fournisseur, pas un devis ToAPIs.
Lors de la mise à jour de ce guide, enregistrez le fournisseur, l'ID de modèle, l'URL source et la date de revue pour chaque capacité ou prix modifié. Gardez séparés les prix fournisseur, les devis de passerelle et les tests tiers. Ce guide ne revendique ni disponibilité ToAPIs, ni génération authentifiée, ni benchmark universel, ni résultat de production garanti.