








Guía de la API GPT-Image-2.6: Flare, Sunburst, GIF y SVG
La solicitud que arruina un sprint de imágenes casi nunca es la toma principal. Es el seguimiento: "¿La misma llamada puede devolver un GIF? ¿Podemos obtener el logo en SVG? ¿Puede diseño mover la taza dos centímetros a la izquierda sin regenerar toda la escena?" Un pipeline construido alrededor de un único PNG plano responde a las tres con un proyecto nuevo.
OpenAI lanzó Images 2.6 el 4 de noviembre de 2026, y la API ahora cubre esas peticiones: dos variantes de modelo, salida GIF y SVG, ediciones guiadas por markup y un control independiente de complexity. El problema es que la nueva superficie llegó más rápido de lo que se actualizaron todas las páginas de referencia. Esta guía te da una integración ejecutable de la API GPT-Image-2.6 y después señala los puntos exactos donde deberías confirmar un límite antes de fijarlo en el código.
TL;DR
- Dos modelos, una lista de tarifas.
gpt-image-2.6-flarees la ruta de iteración rápida;gpt-image-2.6-sunburstapunta a mayor calidad, más detalle y una consistencia de edición más firme con calidad media o alta. Ambos usan las mismas tarifas por tokens.- Nuevas funciones de API. Salida GIF, salida SVG, ediciones guiadas por markup y un parámetro
complexity. La generación y la edición siguen siendo endpoints separados.- Cobro por tokens, no por imagen. La salida de imagen cuesta $30 por 1M de tokens; la entrada de imagen $8 por 1M ($2 en caché); la entrada de texto $5 por 1M ($1.25 en caché).
- La documentación se contradice en tres puntos. El
frame_countde GIF, el soporte de markup por modelo y partes de la referencia de calidad y tamaño. Verifícalos en tu cuenta antes de fijar un límite rígido.
1. Qué llegó con la API GPT-Image-2.6
Images 2.6 es la generación del 4 de noviembre de 2026, disponible en ChatGPT, en Codex y en la API. OpenAI afirma que genera imágenes un 50 % más rápido que la generación anterior. Es una afirmación del proveedor sobre la velocidad de generación, no una promesa sobre tu latencia p95, y no dice nada sobre el precio: el cobro sigue siendo por tokens.
Los dos identificadores de modelo cubren trabajos distintos:
gpt-image-2.6-flareestá pensado para iterar rápido. Conquality=low, OpenAI describe una generación en tan solo unos 6 segundos, lo que lo convierte en la opción por defecto para explorar prompts, miniaturas y vistas previas de interfaz donde "suficientemente bueno ahora" gana a "perfecto después".gpt-image-2.6-sunburstapunta a mayor calidad y detalle, con una consistencia de edición más firme enquality=mediumohigh. Úsalo para activos finales y para ediciones en las que las partes sin cambios deben sobrevivir.
Ambos modelos comparten las tarifas por tokens, así que la decisión se trata de tasa de aceptación y latencia, no de un identificador de modelo más barato. Si vienes de la generación anterior, la guía de la API GPT Image 2 explica la forma de solicitud compartida; este artículo se centra en lo que añade 2.6. La guía del modelo GPT-Image-2.6 es el lugar donde comprobar la disponibilidad de tu cuenta.
La API es compatible con OpenAI. Los ejemplos siguientes apuntan a https://api.toapis.com/v1; si los diriges a otra URL base compatible, mantén el payload y cambia la URL base y la clave.
2. Tu primera solicitud a la API GPT-Image-2.6
Empieza por la generación. Esta llamada curl pide a Flare un borrador cuadrado con calidad y complexity bajas, la prueba de humo más rápida y razonable:
curl -sS https://api.toapis.com/v1/images/generations \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-flare",
    "prompt": "Paper-cut football stadium at night, layered cardstock, rim light, no text",
    "size": "1024x1024",
    "quality": "low",
    "complexity": "low",
    "n": 1
  }' -o flare-response.json
Revisa la respuesta antes de escribir un descargador. Según el modelo y las opciones de la solicitud, las API de imagen suelen devolver una URL o datos base64; un cliente que asume data[0].url fallará con una respuesta base64 válida. El auxiliar siguiente maneja ambos casos y sirve para todos los ejemplos de este artículo:
import base64
import os
import pathlib
import requests

API = "https://api.toapis.com/v1/images/generations"
HEADERS = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}


def generate(model: str, prompt: str, output: str, **params) -> str:
    payload = {"model": model, "prompt": prompt, "n": 1, **params}
    response = requests.post(API, headers=HEADERS, json=payload, timeout=180)
    response.raise_for_status()
    item = response.json()["data"][0]
    target = pathlib.Path(output)
    if item.get("b64_json"):
        target.write_bytes(base64.b64decode(item["b64_json"]))
    else:
        target.write_bytes(requests.get(item["url"], timeout=60).content)
    return str(target)


if __name__ == "__main__":
    prompt = "Paper-cut football stadium at night, layered cardstock, rim light, no text"
    generate("gpt-image-2.6-flare", prompt, "flare-draft.png",
             size="1024x1024", quality="low", complexity="low")
    generate("gpt-image-2.6-sunburst", prompt, "sunburst-final.png",
             size="1536x1024", quality="high", complexity="high")
El tiempo límite de 180 segundos es deliberado. Los prompts complejos pueden tardar hasta unos dos minutos, así que un tiempo límite de 30 segundos en el cliente rechaza trabajo que el servidor puede terminar. Si tu producto no puede mantener una solicitud tanto tiempo, usa una cola de trabajos en lugar de acortar el tiempo límite y reintentar a ciegas.
3. Flare vs Sunburst: elegir modelo en la API GPT-Image-2.6
La comparación útil no es "qué modelo es mejor". Es "qué modelo resulta aceptado en esta tarea con una latencia y un costo aceptables". Un borrador de Flare rechazado puede costar más que una imagen de Sunburst que sí se entrega.
| Trabajo | Mejor primera opción | Por qué |
|---|---|---|
| Explorar 20 direcciones de prompt | gpt-image-2.6-flare | La generación de baja calidad es la ruta rápida; descarta pronto las malas direcciones |
| Miniaturas y marcadores de posición de interfaz | gpt-image-2.6-flare | La velocidad importa más que el detalle fino |
| Imagen principal final | gpt-image-2.6-sunburst | Mayor calidad y detalle en ajustes medios o altos |
| Edición que debe preservar la identidad | gpt-image-2.6-sunburst | Consistencia de edición más firme con calidad media o alta |
| Primera pasada de alto volumen | gpt-image-2.6-flare | Mismas tarifas por tokens, pero menos segundos por intento |
| Experimentar con formatos (GIF/SVG) | Cualquiera, y luego repite | Confirma el soporte de formato antes de optimizar la calidad |
Ejecuta ambos modelos con los mismos prompts y el mismo tamaño de salida, cambia una variable a la vez y revisa los resultados a ciegas. Registra la tasa de aceptación, la latencia p50/p95 y los metadatos brutos de la respuesta: modelo solicitado y devuelto, calidad, complexity, tamaño, formato, consumo de tokens si está presente y tiempo transcurrido. Una muestra atractiva no demuestra que un modelo sea mejor.
Un patrón práctico: Flare con calidad baja para explorar y después Sunburst con calidad alta para la dirección elegida. Reutiliza el prompt, pero no esperes una segunda imagen idéntica píxel a píxel. Si la consistencia importa, prueba una edición en lugar de una generación nueva.
4. Calidad y complexity en la API GPT-Image-2.6
quality acepta low, medium, high, xhigh, max o auto. El valor por defecto es auto. La mayoría de los equipos solo necesita tres puntos de operación:
lowcuando domina la latencia y la imagen es desechable.mediumohighcuando la salida se revisa o se entrega.xhighomaxpara activos finales donde el detalle justifica el trabajo extra.
La latencia y el consumo de tokens varían según la carga. No copies los precios por imagen de 2.5; 2.6 cobra por tokens.
complexity es independiente: low, medium o high, con high como valor por defecto en la guía. No tiene una tarifa aparte, pero los ajustes más altos pueden añadir latencia y cambios no deseados. Trátalo como una variable de adherencia al prompt que hay que probar, no como una mejora gratuita de calidad: una solicitud de complexity baja puede ser más rápida, mientras que una de complexity alta puede resolver una escena recargada o "mejorar" partes que querías dejar intactas. Haz una pequeña prueba A/B con tus propios prompts.
| Prueba | quality | complexity | Qué aprendes |
|---|---|---|---|
| Piso de latencia | low | low | La respuesta realista más rápida para el prompt |
| Comportamiento por defecto | auto | high (valor documentado) | Lo que recibe un cliente sin configurar |
| Comprobar desviaciones | high | low | Si una complexity baja reduce los cambios no deseados |
| Detalle final | high o xhigh | high | Si el trabajo extra mejora la aceptación |
Genera una variable a la vez. Si cambias calidad y complexity juntas, un mal resultado no te dice nada sobre qué perilla lo causó.
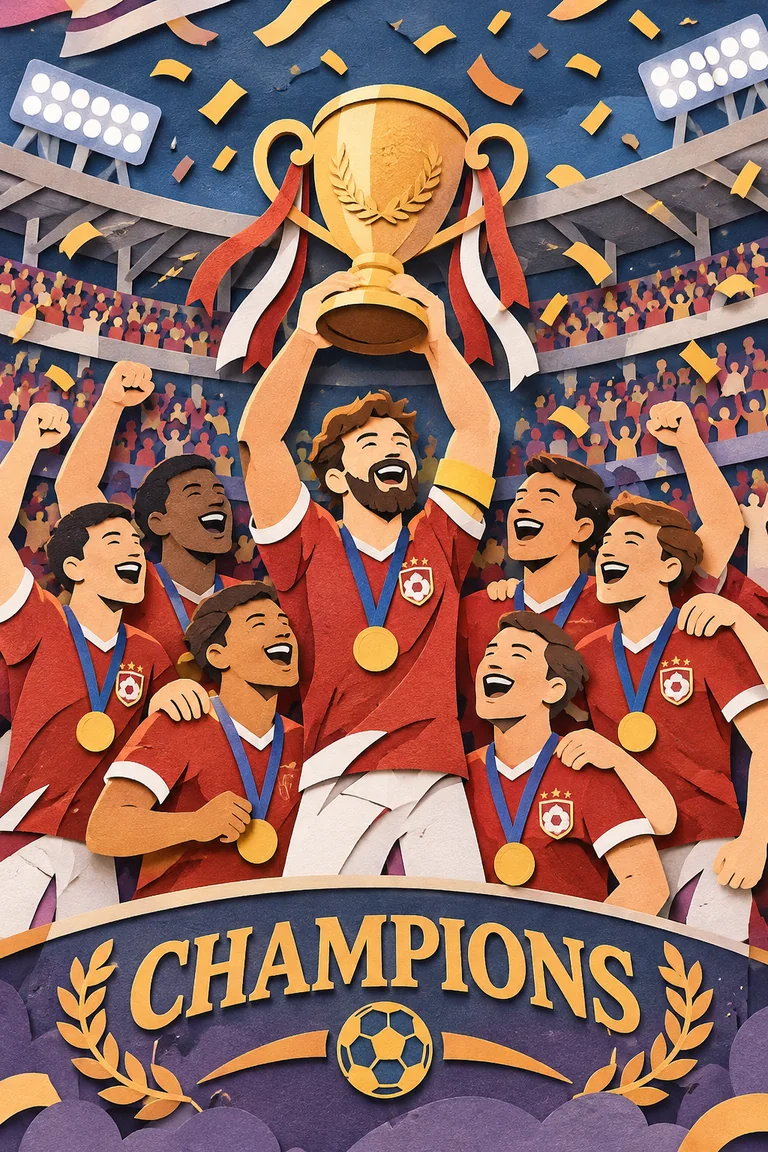
Ejemplo de GPT-Image-2.6 con calidad media: cartón en capas y luces de estadio. Salida ilustrativa, no un benchmark.
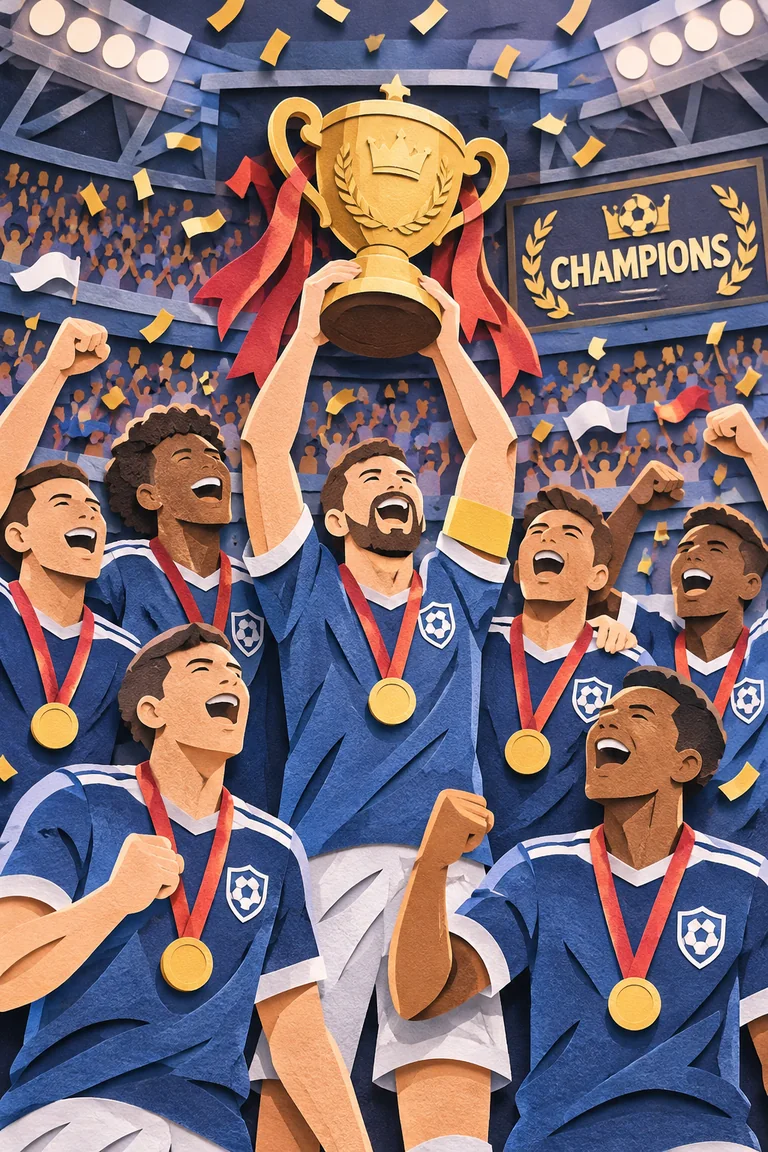
Ejemplo de GPT-Image-2.6 con calidad alta: más detalle de superficie y bordes más definidos. Compara la aceptación, no la nitidez, en el tamaño de visualización.
5. Salida GIF desde la API GPT-Image-2.6
GIF solo existe en generación. Pon output_format en gif en POST /v1/images/generations; las ediciones no lo admiten. Los controles son:
frame_count: por defecto9. La guía de imagen dice2-64; la referencia de API dice2-16. El conflicto no está resuelto, así que no fijes 64 en el código sin una comprobación real.frame_duration_ms: por defecto200, mínimo20. Nueve fotogramas a 200 ms producen una pasada de 1,8 segundos; 16 fotogramas producen 3,2 segundos. Eso es aritmética, no una garantía de movimiento fluido.
generate(
    "gpt-image-2.6-flare",
    "A paper lantern monkey swinging through a bamboo forest, simple background, no text",
    "monkey-lantern.gif",
    size="1024x1024",
    quality="low",
    output_format="gif",
    frame_count=9,
    frame_duration_ms=200,
)
Empieza con los 9 fotogramas por defecto. Si necesitas más, sube en pasos pequeños y detente en el primer rechazo; eso te dice qué acepta tu cuenta hoy. Mantén la escena simple, porque un GIF multiplica las decisiones visuales en cada fotograma. Vigila el tamaño de archivo entregado y las dimensiones, no solo el código de estado HTTP.
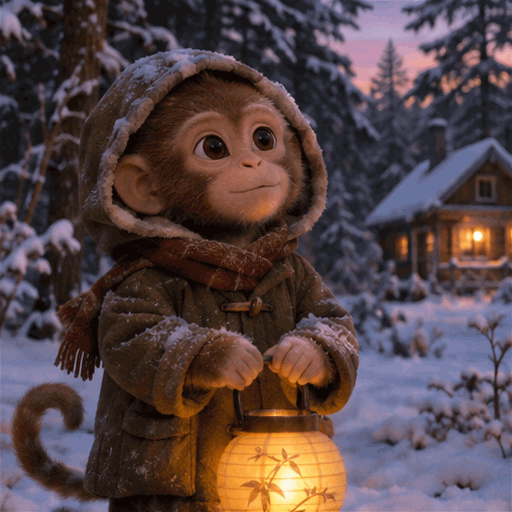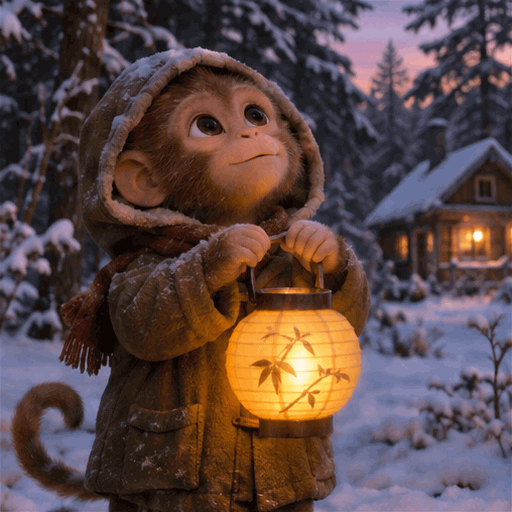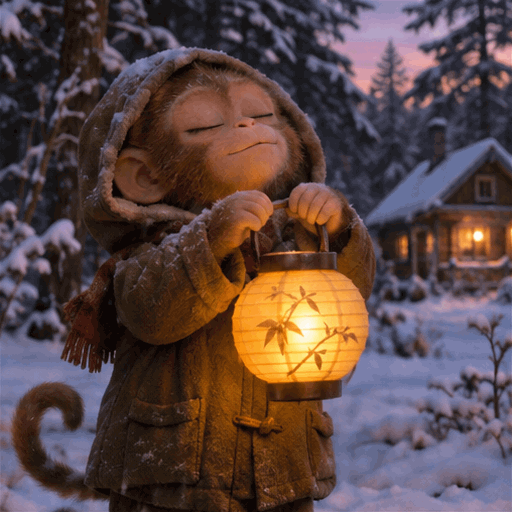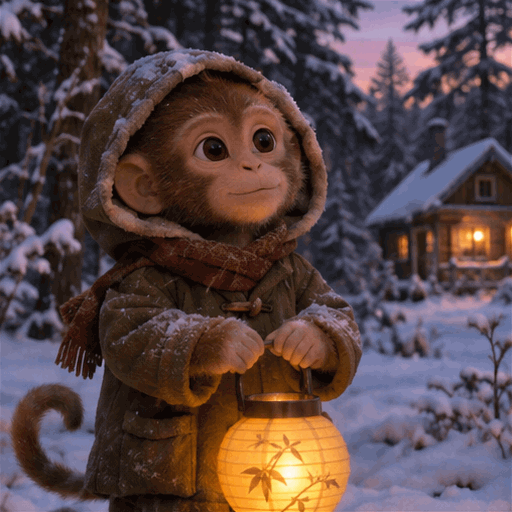
Ejemplo de GPT-Image-2.6: un GIF animado corto generado en una sola llamada. La cantidad de fotogramas y la duración dependen de los ajustes que solicites.
Trata GIF como formato de vista previa, no como activo maestro. Conserva los ajustes y, cuando sea posible, un fotograma fijo para miniaturas y alternativas de accesibilidad.
6. Salida SVG desde la API GPT-Image-2.6
SVG también es solo generación. Pon output_format en svg, mantén n=1 y espera una salida vectorial estática. Restricciones documentadas: sin streaming, sin imágenes parciales, sin compresión y sin prompt_rewriter. Las ediciones no admiten SVG.
generate(
    "gpt-image-2.6-sunburst",
    "A minimal field-and-flour bakery label, wheat stalk and rolling pin, two-color vector, no text",
    "field-and-flour.svg",
    size="1024x1024",
    quality="high",
    output_format="svg",
    n=1,
)
Rechaza n>1 en tu cliente. No envíes output_compression y no esperes renderizado progresivo; el SVG llega como un activo estático completo. Como el SVG es marcado, trata el archivo como no confiable: sírvelo como imagen o sanitízalo antes de incrustarlo. Un vector que parece correcto pero con elementos inesperados es un problema de seguridad.
SVG encaja en iconos, etiquetas, diagramas y marcas de impresión que mostrarían un escalado de mapa de bits. No encaja en fotos, animación ni flujos de edición. Para revisar un vector, regenéralo con un prompt más preciso o renuévelo en una herramienta de diseño; no prometas capas editables si no has inspeccionado la estructura.
Ejemplo de GPT-Image-2.6: salida SVG estática para una etiqueta simple de dos colores. Inspecciona el marcado devuelto antes de servirlo incrustado.
7. Ediciones guiadas por markup en la API GPT-Image-2.6
La edición guiada por markup envía una imagen de origen más una capa PNG transparente a POST /v1/images/edits. La capa se dibuja sobre la primera imagen y debe coincidir con sus dimensiones. La primera imagen y la capa pueden tener como máximo 16.777.216 píxeles cada una; el archivo de la capa puede pesar como máximo 50 MB.
Las reglas son estrictas:
- El markup no se puede combinar con
maskni conprompt_rewriter. - La capa debe ser un PNG transparente, no una captura de pantalla aplanada.
- La capa se aplica a la primera imagen cuando envías varias imágenes.
- No hay una tarifa extra por markup, pero la solicitud se sigue cobrando por sus tokens.
Exporta la imagen base, crea una capa RGBA con las mismas dimensiones en píxeles, dibuja una flecha o un contorno translúcido alrededor del objetivo y después sube ambos con un prompt que defina el cambio y lo que debe permanecer fijo. La capa muestra dónde; el prompt dice qué. "Mueve la taza a la derecha y conserva la mesa, la sombra y el fondo" es verificable. "Hazlo mejor" no lo es.
import base64
import os
import requests

url = "https://api.toapis.com/v1/images/edits"
headers = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}

with open("base.png", "rb") as image, open("overlay.png", "rb") as markup:
    response = requests.post(
        url,
        headers=headers,
        data={
            "model": "gpt-image-2.6-sunburst",
            "prompt": "Move the mug to the right side of the table and keep the table, shadow, and background unchanged.",
            "size": "1024x1024",
            "quality": "high",
            "complexity": "medium",
        },
        files={"image": image, "markup": markup},
        timeout=180,
    )
response.raise_for_status()
item = response.json()["data"][0]
if item.get("b64_json"):
    open("edited.png", "wb").write(base64.b64decode(item["b64_json"]))
else:
    open("edited.png", "wb").write(requests.get(item["url"], timeout=60).content)
Este ejemplo usa markup como nombre de la parte de la capa; confírmalo en la referencia de API actual. La referencia etiqueta el markup como una función de 2.5, mientras que la guía de imagen lo describe para 2.5 y 2.6. No publiques hasta que una solicitud de prueba funcione. Si Sunburst rechaza el markup, no cambies de versión en silencio; muestra el fallo y mantén la última ruta que sabes que funciona.
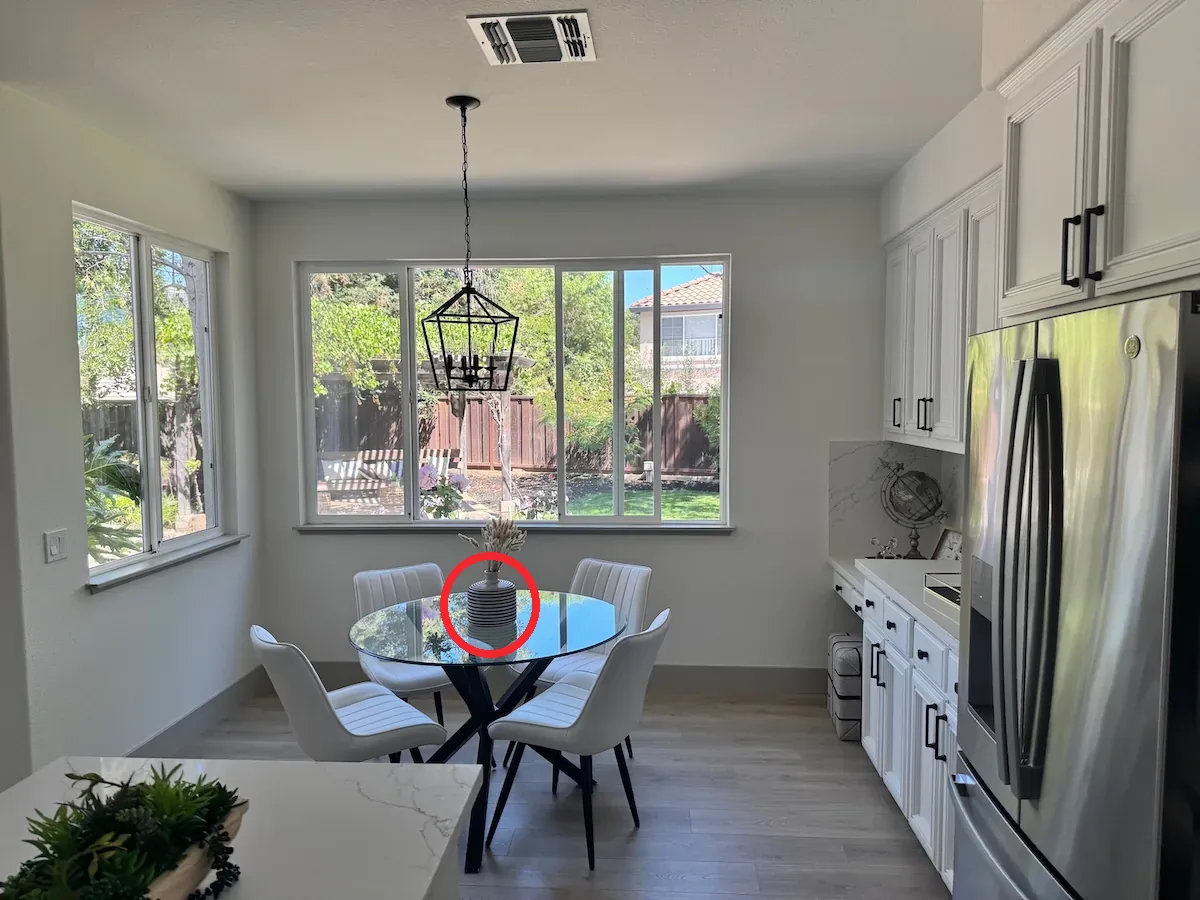
Ejemplo de GPT-Image-2.6: la imagen de origen antes de una edición guiada por markup. La capa y el prompt no se muestran.
Ejemplo de GPT-Image-2.6: el resultado editado. Revisa las regiones sin cambios con el mismo cuidado que el cambio solicitado; un objeto nuevo convincente todavía puede mover la sombra o alterar el fondo.
Mide la calidad de la edición con una lista de comprobación por región: el objetivo cambió, la geometría fuera del objetivo se conservó, las sombras y los reflejos son coherentes, el texto no cambió y no aparecen objetos nuevos en el borde de la capa. Conserva la imagen base para poder reintentar sin regenerarla.
8. Tamaños y límites en la API GPT-Image-2.6
Los tamaños recomendados son 1024x1024, 1536x1024 y 1024x1536. Los tamaños personalizados deben usar dimensiones múltiplos de 16, una relación de aspecto entre 1:3 y 3:1, y no más de 3840x2160. Todo lo que esté por encima de 2560x1440 es experimental; compruébalo primero cuando un diseño se aleje de los tamaños recomendados.
Una pequeña validación en el cliente atrapa la mayoría de las solicitudes inválidas antes de que te cuesten un viaje de ida y vuelta:
def validate_size(width: int, height: int) -> str:
    if width % 16 or height % 16:
        raise ValueError("width and height must be multiples of 16")
    if not (1 / 3 <= width / height <= 3):
        raise ValueError("aspect ratio must stay between 1:3 and 3:1")
    if width > 3840 or height > 2160:
        raise ValueError("maximum size is 3840x2160")
    if width * height > 3840 * 2160:
        raise ValueError("pixel area exceeds the documented maximum")
    return f"{width}x{height}"
Los conflictos en la documentación de la API GPT-Image-2.6 no son cosméticos. Cambian lo que tu cliente debería aceptar:
| Tema | Una fuente dice | Otra dice | Acción de ingeniería |
|---|---|---|---|
frame_count de GIF | Guía de imagen: 2-64 | Referencia de API: 2-16 | Empieza en 9; sube por pasos; no fijes 64 |
| Soporte de markup por modelo | Guía de imagen: 2.5 y 2.6 | Referencia de API: solo 2.5 | Prueba 2.6 en tu cuenta; mantén un respaldo |
| Tablas de calidad y tamaño | La guía de 2.6 incluye niveles y tamaños nuevos | Algunas páginas de referencia se quedan en la generación anterior | Valida el enum y las dimensiones en tiempo de ejecución |
Trata la documentación como configuración versionada: registra la URL de origen, la fecha de acceso y el comportamiento real de tu cuenta. Un 400 por un enum no admitido es evidencia; un comentario en la configuración no lo es.
9. El costo real de una llamada a la API GPT-Image-2.6
OpenAI tarifica Images 2.6 por tokens. Tanto gpt-image-2.6-flare como gpt-image-2.6-sunburst usan las mismas tarifas:
| Tipo de token | Estándar | En caché |
|---|---|---|
| Salida de imagen | $30.00 / 1M | No aplica |
| Entrada de imagen | $8.00 / 1M | $2.00 / 1M |
| Entrada de texto | $5.00 / 1M | $1.25 / 1M |
La fórmula del costo es:
cost = (image_output_tokens * 30
      + image_input_tokens * 8
      + cached_image_input_tokens * 2
      + text_input_tokens * 5
      + cached_text_input_tokens * 1.25) / 1_000_000
No existe un precio fijo oficial por imagen; cualquier estimación parte del consumo de tokens medido. Supón que una solicitud de generación cobra 400 tokens de entrada de texto y 5.000 tokens de salida de imagen: (400 × 5 + 5.000 × 30) / 1.000.000 = $0.152. Esos recuentos son ilustrativos, no un promedio. Una edición que además cobra 2.000 tokens de entrada de imagen añade $0.016, para $0.168.
Con 1.000 solicitudes, el hipotético $0.152 se convierte en unos $152, antes de la entrada de imagen o de descuentos por caché. Sigue el costo por imagen aceptada, no por solicitud: incluye reintentos, rechazos, tiempo de revisión y almacenamiento. Una llamada más barata puede perder cuando los revisores rechazan el 40 % de su salida.
Dos reglas mantienen las cuentas honestas: un 50 % más rápido no significa un 50 % más barato, porque la velocidad cambia la latencia, no las tarifas por tokens; y los precios por imagen de 2.5 no aplican a 2.6. La entrada en caché solo abarata las ediciones con referencias repetidas cuando la entrada se sirve desde la caché. Consulta precios y concilia con el consumo devuelto.
10. Lista de comprobación para producción y límites conocidos
La API GPT-Image-2.6 es capaz, pero no es un motor de maquetación determinista. Los límites documentados siguen aplicándose: los prompts complejos pueden tardar hasta unos dos minutos, el renderizado de texto tiene límites, la consistencia entre generaciones no está garantizada y el control de la composición es imperfecto. Diseña para revisar y reintentar, no para una llamada perfecta.
Antes de enrutar tráfico a la API GPT-Image-2.6:
- Configura un tiempo límite por encima del peor caso, o encola los trabajos largos. No reintentes a ciegas una solicitud cobrada después de un tiempo límite ambiguo; comprueba primero el estado o la idempotencia.
- Valida los identificadores de modelo, la calidad, la complexity, el tamaño y el formato de salida en tu propio cliente. Rechaza las combinaciones no admitidas antes de gastar una solicitud.
- Registra el modelo solicitado y devuelto, el formato, las dimensiones, la calidad, la complexity, el consumo de tokens, la latencia y un hash de la salida. Oculta las claves y los prompts sensibles.
- Separa los fallos de generación y de edición en tus métricas. Una solicitud de markup rechazada y una generación lenta son incidentes distintos.
- Usa la API Responses para la edición de imágenes en varios turnos; admite generación y edición entre turnos. Los endpoints de Images siguen siendo más simples para trabajos de un solo disparo.
- Mantén un respaldo probado. Si Sunburst no está disponible, Flare todavía puede atender la solicitud, pero su salida es distinta; avisa al usuario cuando se ejecutó un modelo de respaldo en lugar de sustituirlo en silencio.
- Guarda los activos que necesitas en un almacenamiento controlado. No asumas que una URL temporal es un archivo permanente y no incrustes SVG no confiables sin sanitizarlos.
Para el despliegue, usa un conjunto fijo que represente tu carga: texto pequeño de packaging, un producto que debe conservar su forma tras una edición, una composición ancha y una animación corta. Puntúa contra una lista de comprobación escrita y después compara los modelos por aceptación y latencia p95, no por capturas de pantalla.
11. Preguntas frecuentes
¿Debo usar gpt-image-2.6-flare o gpt-image-2.6-sunburst?
Usa Flare para explorar, crear variantes y borradores sensibles a la latencia, sobre todo con quality=low. Usa Sunburst para el detalle final y para ediciones que deben preservar el resto de la imagen con quality=medium o high. Ambos modelos comparten las tarifas por tokens, así que haz una pequeña prueba de aceptación en lugar de suponer que el modelo de mayor calidad siempre es necesario.
¿La API GPT-Image-2.6 admite GIF y SVG en las ediciones?
No. GIF y SVG son formatos de generación de la API GPT-Image-2.6; las ediciones no admiten ninguno. SVG es vector estático con n=1 y sin streaming, imágenes parciales, compresión ni prompt_rewriter. GIF también es solo de generación. Construye rutas separadas en lugar de esperar que una edición ignore el formato.
¿Cuánto cuesta una imagen de la API GPT-Image-2.6?
No hay un precio fijo oficial por imagen. La salida de imagen cuesta $30 por 1M de tokens, la entrada de imagen $8 por 1M ($2 en caché) y la entrada de texto $5 por 1M ($1.25 en caché). Estima con tus recuentos de tokens medidos y después divide el gasto total entre las imágenes aceptadas. No reutilices los precios por imagen de 2.5 para un presupuesto de 2.6.
¿Por qué la documentación de la API GPT-Image-2.6 se contradice?
La guía y la referencia de API no están completamente sincronizadas. frame_count aparece como 2-64 y como 2-16; el markup está documentado como solo 2.5 en la referencia pero como 2.5/2.6 en la guía; algunas tablas de calidad y tamaño se quedan atrás. Trata esto como límites específicos de cada versión, prueba en tu cuenta y registra la fecha y el resultado de la comprobación.
12. Empieza con tres llamadas, no con una migración
Evalúa la API GPT-Image-2.6 con un lote controlado: un borrador Flare low/low, un final Sunburst high/high y una solicitud de formato que encaje con tu producto. Registra tokens, latencia y aceptación, y después decide qué se gana un lugar en el pipeline.
Crea una cuenta de ToAPIs, consulta la guía del modelo GPT-Image-2.6 para el acceso actual y confirma las tarifas en la página de precios. Si sigues en la generación anterior, lee primero la guía de la API GPT Image 2 y después migra un endpoint a la vez en lugar de reescribir todo el pipeline.