








1. Qué aporta Gemini Omni 1.2 Flash
Google Cloud lista gemini-omni-1.2-flash como un modelo multimodal disponible de forma general, diseñado para tareas de vídeo, imagen y texto. La matriz de capacidades documentada incluye texto a vídeo, imagen a vídeo, referencia a vídeo, vídeo con primer y último fotograma, edición de vídeo, extensión de vídeo y escalado de vídeo. También lista razonamiento (thinking), pero no instrucciones de sistema, salida estructurada, llamadas a funciones ni la API Gemini Live para este modelo.
La página del modelo documenta salida de vídeo de 3 a 15 segundos para generación y edición, de 3 a 10 segundos para generación con primer y último fotograma, y de 3 a 10 segundos de duración añadida para la extensión. Las relaciones de aspecto admitidas son 16:9 y 9:16; las resoluciones de salida documentadas son 360p, 720p, 1080p y 4k. Los límites de vídeo de entrada dependen de la operación: la edición y el escalado aceptan hasta 15 segundos, mientras que la extensión usa el final de una fuente más larga bajo su propio contrato.
| Capacidad | Qué dice la documentación principal | Pregunta de integración |
|---|---|---|
| Texto a vídeo | Vídeo guiado por prompt, 3–15 segundos | ¿Qué campos de resolución y audio expone el proveedor elegido? |
| Imagen o referencia a vídeo | Referencias de imagen y vídeo, con límites por ruta | ¿El orden de las imágenes y los nombres de referencia tienen significado semántico? |
| Primer y último fotograma | Admitido, con salida de 3–10 segundos | ¿La segunda imagen es un fotograma final u otra referencia? |
| Edición de vídeo | Editar un vídeo fuente de hasta 15 segundos | ¿La duración y la relación de aspecto siguen a la fuente? |
| Extensión de vídeo | Añadir 3–10 segundos según un contrato de extensión | ¿duration es la longitud añadida o la longitud total de salida? |
| Escalado de vídeo | Escalar resoluciones de origen admitidas hasta 4K | ¿Este realce se factura por separado de la generación? |
Los anuncios de lanzamiento destacan cinco mejoras prácticas frente a la generación anterior: clips de 15 segundos, un precio publicado más bajo en 720p, mayor adherencia a referencias de imagen y vídeo, generación de borradores en menor resolución seguida de escalado a 1080p o 4K, y un diálogo más natural con sincronización labial más clara y condiciones de varios interlocutores. Google también describe edición conversacional, como cambiar un producto, la iluminación o el ángulo de cámara sin empezar de cero.
Esas son afirmaciones a nivel de producto, no la promesa de que cada proveedor exponga cada control. Un proveedor puede dividir una familia de modelos en slugs distintos, omitir una capacidad o añadir una capa de facturación diferente. Trata siempre el esquema exacto de la ruta como el contrato de integración.
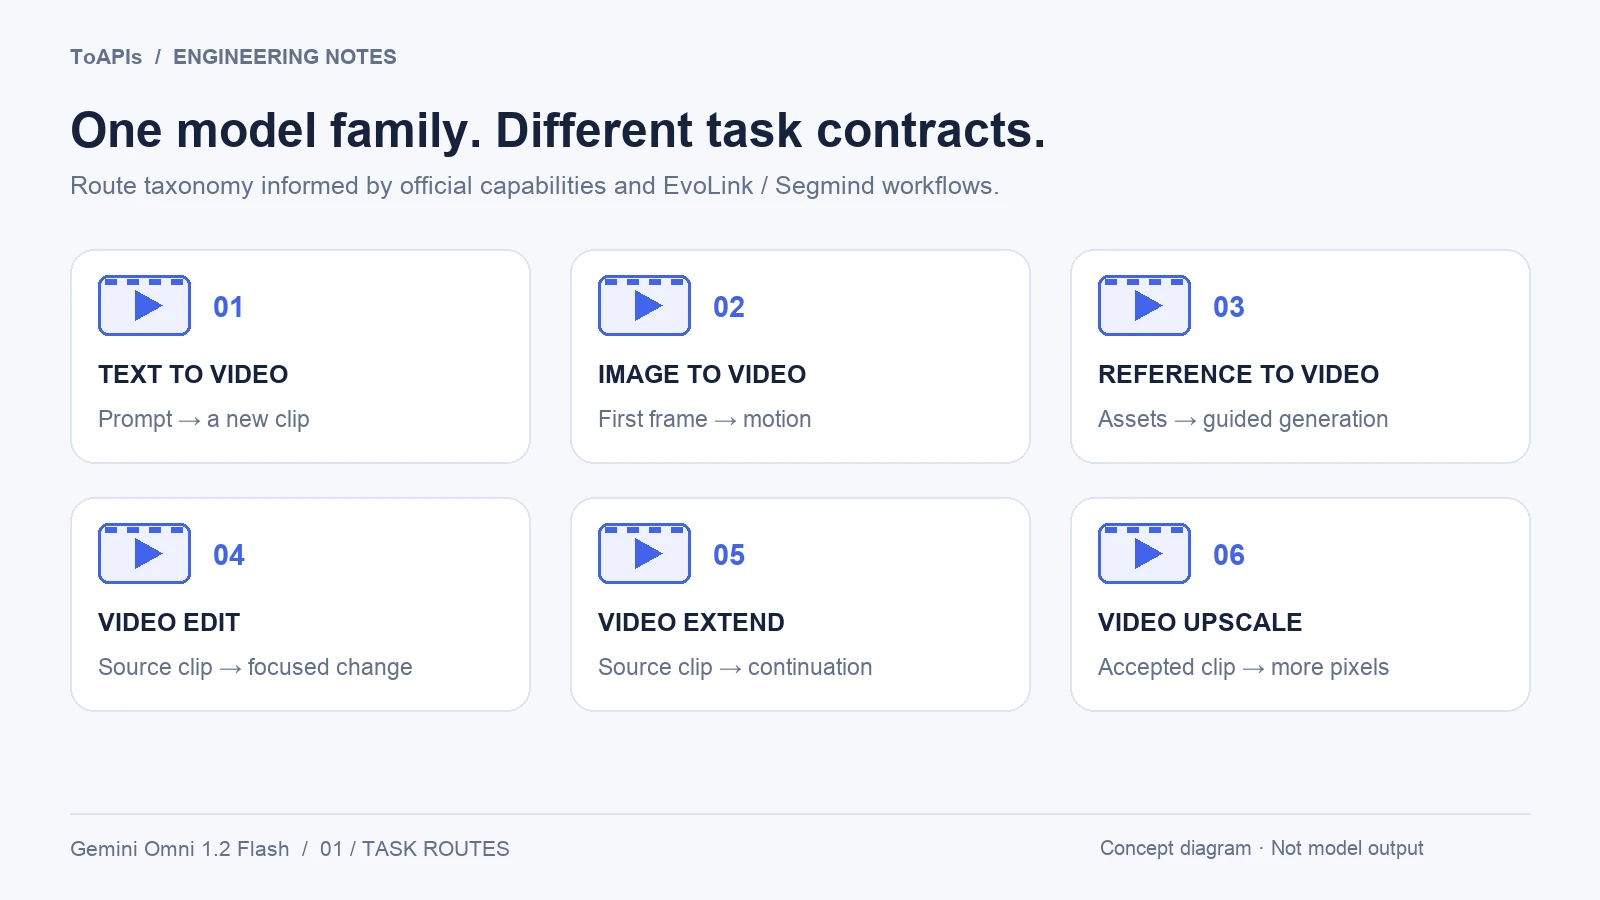
Ilustración original del mapa de tareas basada en la lista oficial de capacidades y en descripciones de rutas de terceros. Los endpoints reales varían según el proveedor; esto no es salida del modelo.
2. Seis rutas, seis contratos distintos
Algunas pasarelas de vídeo de terceros presentan seis rutas de tarea sobre una única interfaz de vídeo asíncrona: texto a vídeo, imagen a vídeo, referencia a vídeo, edición de vídeo, extensión de vídeo y escalado de vídeo. Sus ID de modelo sirven para entender la planificación de rutas, pero son identificadores propios de cada proveedor, no identificadores confirmados de ToAPIs.
Los informes de pruebas independientes también ofrecen una visión orientada a rutas y señalan explícitamente que ciertas rutas, como refine, no estaban disponibles en las pruebas de lanzamiento. Es un buen ejemplo de por qué una lista de capacidades atractiva no debe copiarse en un formulario de producto sin comprobar el esquema en vivo.
| Ruta | Entrada típica | Límite principal que validar |
|---|---|---|
| Texto a vídeo | Prompt | 3–15 segundos; resolución, relación de aspecto, audio y seed pueden depender del proveedor |
| Imagen a vídeo | Primera imagen y prompt | Una segunda imagen puede definir un fotograma final; confirma la duración máxima |
| Referencia a vídeo | Imágenes o vídeos de referencia más prompt | Las reglas de cantidad, duración y nombres de referencia difieren |
| Edición de vídeo | Vídeo fuente más un cambio concreto | Duración de la fuente, filtros de seguridad y si la salida sigue el encuadre de la fuente |
| Extensión de vídeo | Vídeo existente más prompt de continuación | La duración añadida no es necesariamente la duración total |
| Escalado de vídeo | Vídeo existente, normalmente sin prompt | Tamaños de origen aceptados, niveles de salida y facturación separada |
Un selector de ruta debería cambiar a la vez sus reglas de validación, su texto de ayuda y su previsión de coste. No dejes que un campo genérico duration arrastre en silencio la semántica de una ruta de extensión hacia una ruta de generación. No des por hecho que un campo llamado image_urls significa lo mismo en solicitudes de imagen a vídeo y de referencia a vídeo.
No mezcles los límites de Google Cloud y de la API Gemini
La guía de la API Gemini documenta hasta seis imágenes de referencia, mientras que la página del modelo en Google Cloud lista hasta diez imágenes por prompt. La API Gemini también aplica límites de vídeos de referencia que dependen de la duración solicitada: una generación más larga, de 11–15 segundos, admite un único vídeo de referencia corto, no el mismo presupuesto de referencias que una tarea de 3–10 segundos. Son contratos de plataforma distintos, no valores contradictorios que haya que promediar o combinar.
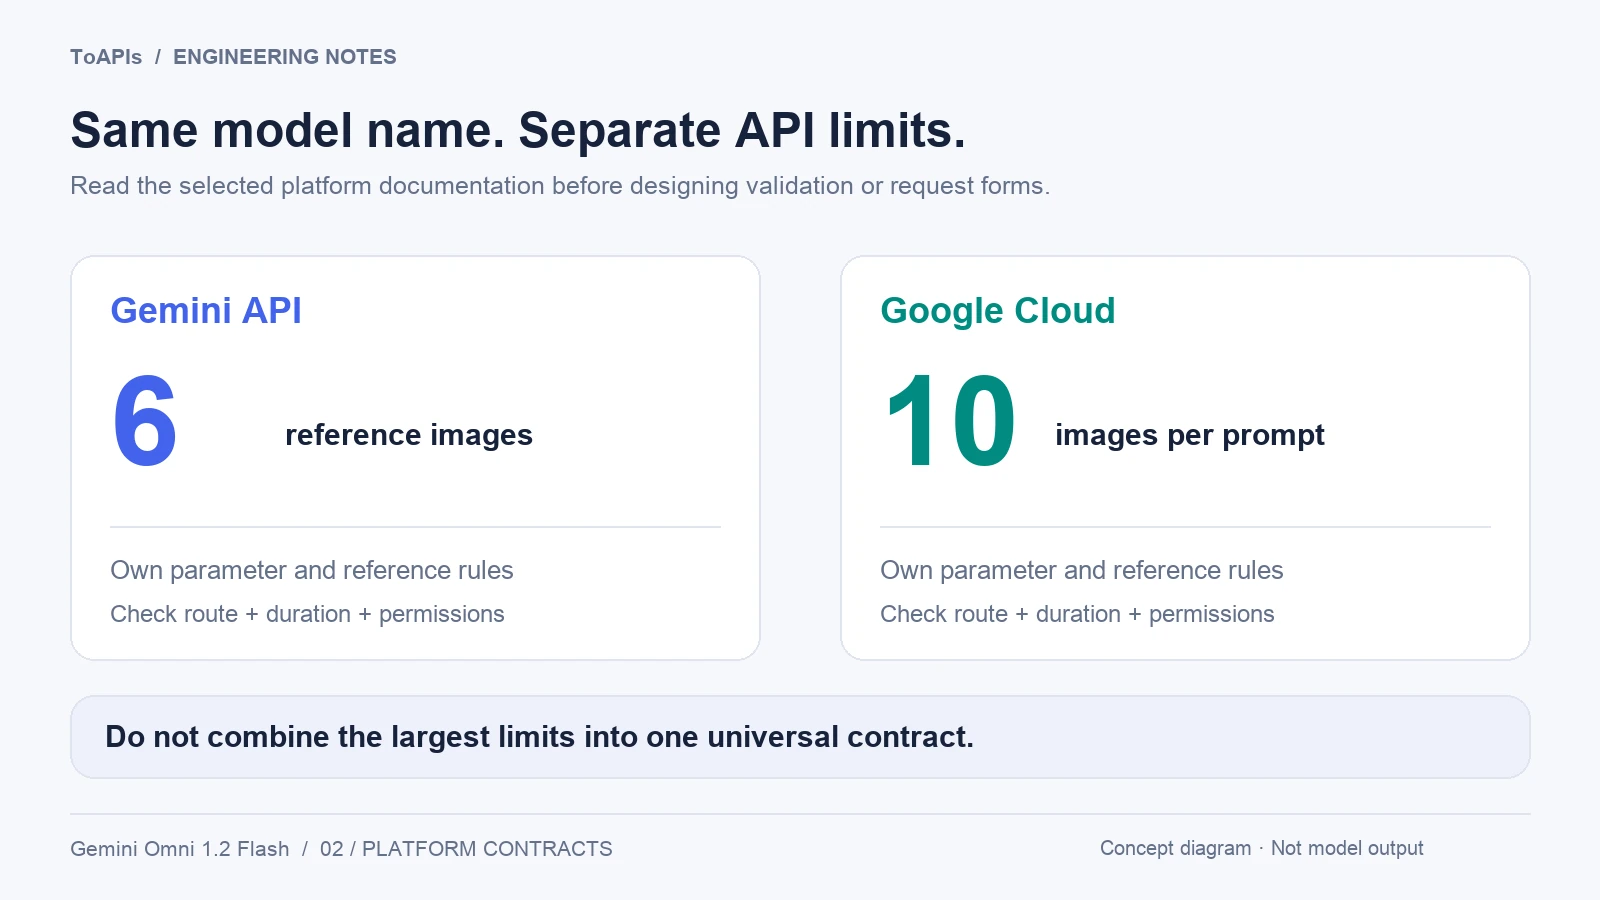
Contratos de plataforma separados: seis imágenes de referencia en la API Gemini frente a diez imágenes por prompt en la documentación de Cloud. Estos máximos no se pueden combinar; verifica la ruta y la duración elegidas.
Para la API Gemini, la integración documentada usa la Interactions API, no generate_content, ni una llamada chat-completions de OpenAI, ni un método generate_videos específico de Veo. Lo siguiente es un ejemplo adaptado de llamada de pago, no una solicitud a ToAPIs. Requiere un SDK google-genai vigente, una cuenta elegible y una clave configurada localmente; nunca pongas credenciales en un prompt ni en un paquete de navegador. No se ejecutó para este artículo.
import base64
from pathlib import Path
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input=(
        "A blue ceramic cup on a neutral table. "
        "One continuous slow camera push-in. "
        "Soft room ambience, no speech, no text."
    ),
    response_format={
        "type": "video",
        "resolution": "360p",
        "duration": "5s",
        "aspect_ratio": "16:9",
    },
)
Path("omni-draft.mp4").write_bytes(
    base64.b64decode(interaction.output_video.data)
)
print("interaction ID:", interaction.id)
En esta API, duration es una cadena como "5s", no un entero copiado de un formulario de pasarela; los controles de generación viven bajo response_format. Para archivos más grandes, la guía documenta entrega por URI y manejo de la disponibilidad del archivo. Las ediciones multiturno usan previous_interaction_id; definir store=false elimina el estado almacenado que necesita ese flujo de seguimiento. Revisa estas contrapartidas en lugar de copiar sin pensar ajustes de latencia.
3. Estrategia de resolución: primero borrador, escalar de forma selectiva
La guía de la API Gemini identifica explícitamente 360p y 720p como niveles de generación, y 1080p y 4k como salida escalada. Por tanto, una opción de entrega en 4K no establece generación nativa en 4K. El flujo de trabajo más práctico del material de lanzamiento es separar la exploración de la entrega. Usa 360p o 720p para iterar prompts y comprobar la composición. Cuando un clip supere la lista de comprobación de aceptación, compara seleccionar la entrega en alta resolución en la solicitud de generación con escalar por separado un clip existente. Confirma que el proveedor admite cada camino; ninguno implica generación nativa en 4K.
Esta estrategia reduce las generaciones desperdiciadas en alta resolución, pero introduce una segunda operación que medir. Un escalador puede añadir detalle sin cambiar el movimiento subyacente ni arreglar una composición mala. No puede garantizar que una etiqueta incorrecta, un rostro inestable o un movimiento de objeto equivocado se vuelvan correctos a 4K.
Guarda la resolución de origen, la resolución de salida, la ruta, la duración y el uso de tokens en el registro del trabajo. Donde el proveedor admita ambos caminos, compara la entrega en alta resolución seleccionada en la solicitud de generación con el escalado separado de un clip existente, usando entradas, encuadre y criterios de aceptación equivalentes. Ninguno de los dos caminos establece generación nativa en 4K. Los informes de pruebas independientes señalaron detalle útil gracias al escalado, y a la vez lo trataron como un paso del flujo de trabajo con coste cuyo precio debe medirse.
Para producción, define dos puertas:
- Una puerta creativa: la identidad del sujeto, la composición, el movimiento, el texto, el diálogo y el sonido cumplen el brief.
- Una puerta de entrega: dimensiones, duración, códec, pista de audio, derechos y retención de archivos cumplen el requisito posterior.
Solo los clips que superen ambas puertas deberían entrar en la biblioteca final de recursos.
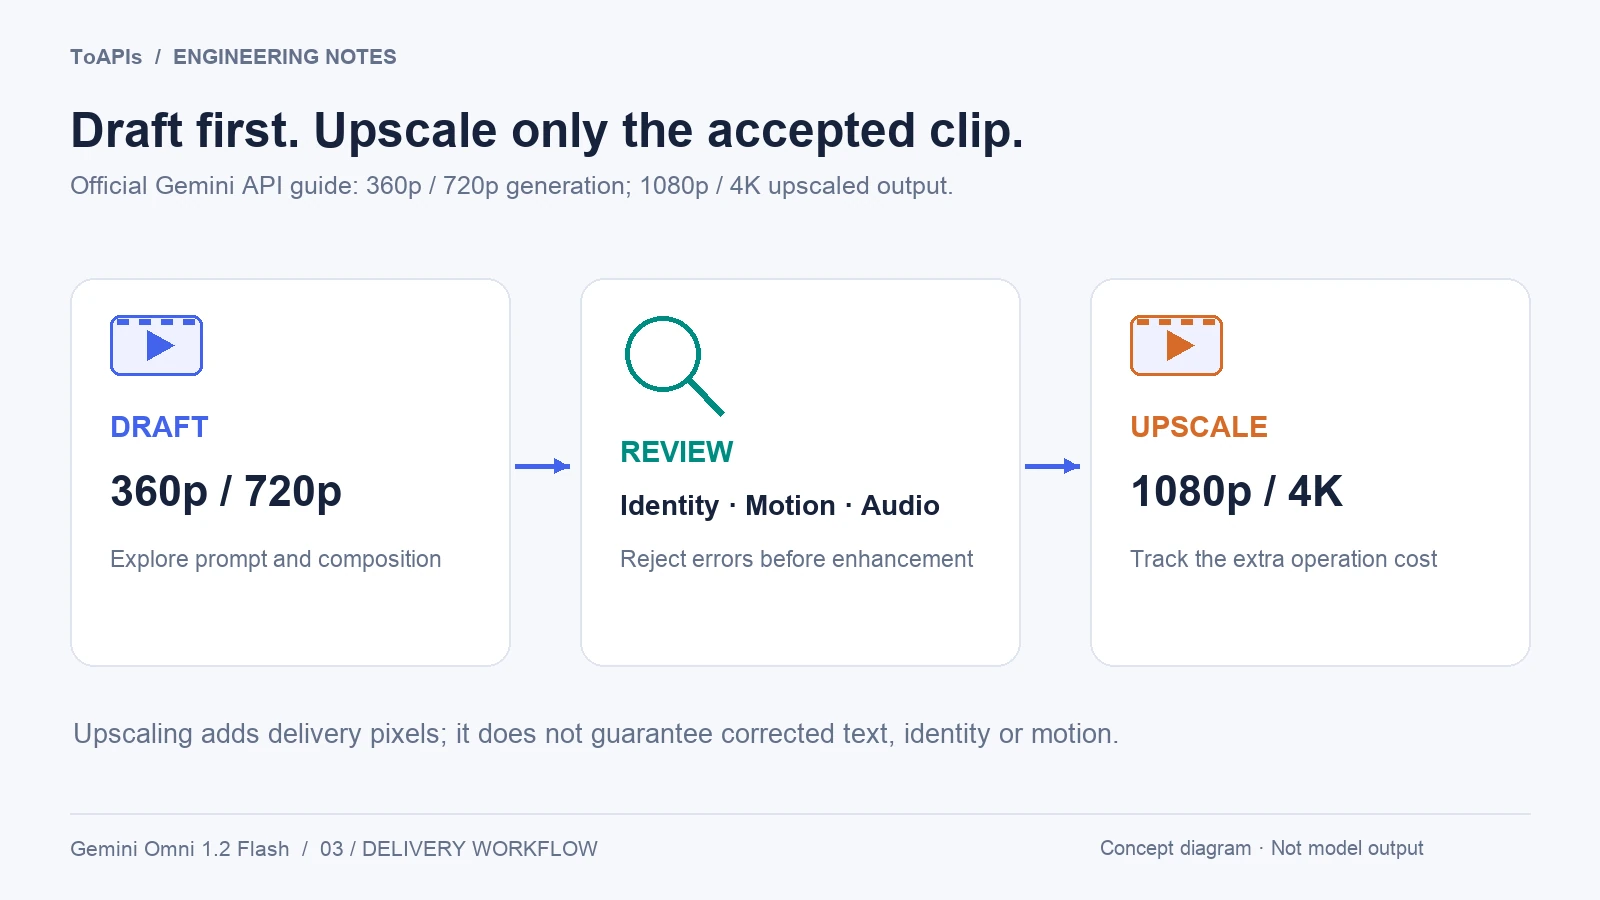
Flujo de trabajo conceptual basado en la guía de la API Gemini. La entrega en mayor resolución usa escalado; no garantiza movimiento, texto o identidad corregidos.
4. Prompting para un vídeo fiel a la instrucción
Las pruebas de terceros son especialmente valiosas para el diseño de prompts cuando revelan qué comprobar, no cuando se convierten en afirmaciones de benchmark universales. Los informes de pruebas independientes señalan resultados sólidos en explicativos con etiquetas, tipografía cinética, animación de gráficos a partir de un fotograma final suministrado, motion graphics estilizados y ediciones de un solo cambio sobre metraje real. Esos mismos informes señalan resultados más débiles en personas fotorrealistas creadas de cero, gráficos de datos a partir de números solos y algunas ediciones de varios pasos o de logotipos de marca.
Un prompt de Omni robusto debería separar:
- el sujeto y su identidad visible;
- los tiempos ordenados de la escena;
- el movimiento de cámara y lo que debe permanecer fijo;
- el texto exacto en pantalla, citado aparte;
- el diálogo, la música y los efectos de sonido;
- el estado final, preferiblemente fijado con una entrada de último fotograma cuando la ruta lo admita;
- un cambio a conservar en el caso de una edición, más todo lo que debe permanecer sin cambios.
Por ejemplo:
Create a flat 2D motion-graphics explainer in 16:9.
Show the title 'HOW A PRODUCT VIDEO API WORKS' exactly as written.
First show one product photo, then three labelled route cards from left to right,
then connect the cards to one finished video frame.
Keep every label fixed after it appears. Use a locked-off camera.
Add a short, calm voiceover and a soft click for each route card.
End on the complete diagram. Do not add any other text or logos.
Este brief es una prueba propuesta, no una salida de Omni medida. Las reglas de aceptación son más útiles que adjetivos como «cinematográfico» o «viral»: cada etiqueta debe coincidir, el orden debe ser correcto, la cámara debe permanecer fija y el audio debe contener solo las señales solicitadas.
5. Audio nativo, referencias y edición
La documentación oficial lista voz, música y efectos de sonido como admitidos, mientras que la entrada de lanzamiento de Google destaca un diálogo más natural, una sincronización labial más clara y condiciones distintas de varios interlocutores. El anuncio de Google Cloud también señala que las referencias de audio están detrás de una lista de permitidos. Eso significa que el audio necesita su propia comprobación de capacidad y permiso, no solo una casilla en un formulario de vídeo genérico.
La consistencia de referencias es uno de los temas principales del modelo. Google describe una adherencia más fuerte a las referencias de imagen y vídeo, y la página oficial del modelo admite generación basada en referencias. Aun así, el soporte de referencias no es una garantía de identidad. Revisa rostro, ropa, silueta del producto, marcas visibles, iluminación y movimiento en todo el clip.
La edición conversacional también es un concepto de flujo de trabajo, no necesariamente un endpoint universal único. El material de lanzamiento describe cambiar un producto, la iluminación o el ángulo de cámara dentro del mismo clip. Un proveedor puede implementarlo como edición de vídeo, un ID de interacción, una referencia a una tarea anterior o un cuerpo de solicitud distinto. Confirma el contrato antes de guardar suposiciones en tu base de datos.
Para cada edición, registra:
- el vídeo de origen y sus derechos;
- la instrucción exacta de un solo cambio;
- lo que debe permanecer sin cambios;
- la ruta y el ID de modelo;
- el ID de tarea o de interacción devuelto;
- los resultados de audio y de revisión de seguridad.
Esto hace diagnosticable una edición fallida y reproducible lo suficiente para revisión una edición correcta.
6. El precio por token no es lo mismo que una cotización de ToAPIs
Los materiales de lanzamiento de Google publican un precio del proveedor para vídeo en 720p y describen una reducción frente al modelo anterior. Algunas pasarelas de vídeo de terceros presentan sus propias calculadoras basadas en tokens, descuentos y precios por ruta, mientras que los análisis de precios de terceros derivan estimaciones por segundo en 720p a partir de supuestos de tokens o enmarcan el lanzamiento en torno a un precio por segundo publicado. Estas cifras no son intercambiables.
La tabla de precios Standard de la API Gemini, revisada el 6 de noviembre de 2026, lista 1,50 USD por millón de tokens de entrada para texto, imágenes y vídeo; 9,00 USD por millón de tokens de salida de texto, incluido el razonamiento; y 12,00 USD por millón de tokens de salida de vídeo. No ofrece un nivel gratuito para este modelo. Son precios de lista del proveedor para esa plataforma, no una cotización de ToAPIs.
La misma página de precios lista 5.792 tokens de salida de vídeo por segundo en 720p. Por tanto, un clip de 15 segundos en 720p tiene un componente ilustrativo de salida de vídeo de 15 × 5,792 × 12 / 1,000,000 = USD 1.04256, antes de los cargos de entrada y de salida de texto y razonamiento. Esto explica el titular redondeado de lanzamiento de unos 0,07 USD por segundo sin convertirlo en una tarifa fija todo incluido. Los precios, las reglas de tokens y los márgenes de las pasarelas pueden cambiar.
Un modelo de coste de producción debería identificar:
| Dimensión de coste | Qué conservar |
|---|---|
| Proveedor o pasarela | El proveedor exacto, el ID de modelo y la fecha |
| Unidad de facturación | Segundos, tokens de salida de vídeo, tokens de entrada, tokens de razonamiento o un paquete |
| Multiplicador de resolución | Entrega en alta resolución seleccionada en la generación frente a escalado solicitado por separado; verifica el soporte y la facturación del proveedor |
| Medios de entrada | Imágenes, vídeos de origen y sus reglas de tokens facturables |
| Política de reintentos y rechazos | Si se cobran los fallos de seguridad, de validación o de transporte |
| Rendimiento de aceptación (tasa de aprobación) | Clips que superan la lista de entrega divididos por el total de intentos |
Para un plan hipotético basado en tokens, escribe la fórmula en lugar de copiar la cotización de un competidor:
raw generation cost = input token cost
                    + text and thinking output token cost
                    + video output token cost
workflow cost = sum of all generation attempts
              + separately billed upscaling
              + storage, transfer and review cost
cost per accepted clip = workflow cost / accepted clips
No cuentes dos veces un elemento si ya está incluido en la factura; cuando accepted clips es 0, el coste por clip aceptado queda indefinido y debe informarse por separado.
No publiques un precio de ToAPIs hasta que su catálogo actual o su endpoint de cotización confirme el modelo, la SKU, la unidad y la tarifa específica de la cuenta. No afirmes que una latencia o un coste medidos por un tercero aplican a otra pasarela.
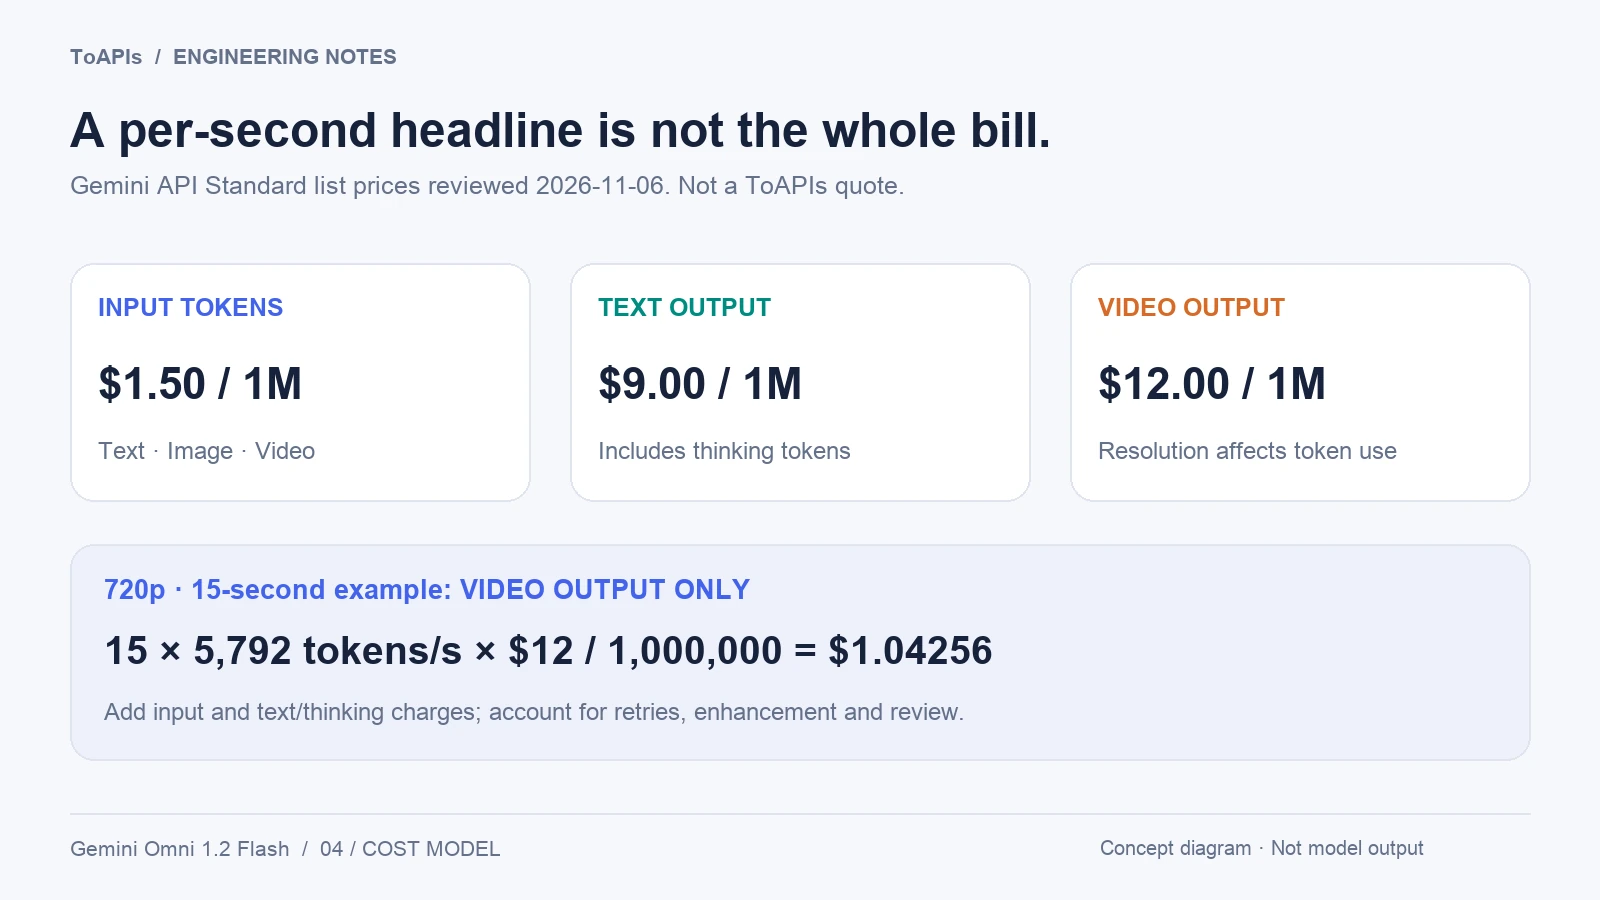
Ilustración con precios de lista del proveedor revisados el 6 de noviembre de 2026, no una cotización de ToAPIs. Los 1,04256 USD cubren solo la salida de vídeo en este ejemplo; los cargos de entrada y de texto y razonamiento son adicionales.
7. Prepara un paquete de aceptación antes de producción
Antes de habilitar este modelo en una aplicación, ejecuta un paquete pequeño y repetible:
- Texto a vídeo: un explicativo con etiquetas, tiempos ordenados y señales de audio explícitas.
- Imagen a vídeo: un primer fotograma de producto con un estado final obligatorio.
- Referencia a vídeo: un sujeto a través de varias vistas, con una lista de comprobación de continuidad.
- Edición de vídeo: un cambio sobre un clip real manteniendo la interpretación.
- Extensión de vídeo: un plano cuya dirección de cámara y sonido deberían continuar con naturalidad.
- Entrega en alta resolución: si el proveedor admite ambos caminos, compara seleccionar la entrega en alta resolución en una solicitud de generación con escalar por separado un borrador ya aceptado; ninguno implica generación nativa en 4K.
Para cada prueba, registra el ID de modelo, la ruta, las entradas, el prompt, la seed si está admitida, la resolución, la duración, el ID de tarea, el tiempo en cola, el tiempo de procesamiento, los datos de tokens o facturación de salida, el resultado de audio y el veredicto de aceptación. Conserva los fallos en lugar de quedarte solo con los mejores ejemplos.
Usa las reseñas de terceros como hipótesis. Por ejemplo, una reseña independiente de 20 pruebas es valiosa cuando nombra tanto fortalezas como fallos, pero sus precios facturados, su latencia y el comportamiento de su proveedor pertenecen a ese entorno de pruebas concreto. No es un benchmark independiente de cada integración de Gemini Omni 1.2 Flash.
8. Lista de comprobación de disponibilidad e integración
El ID oficial del modelo en Google es gemini-omni-1.2-flash, pero un ID de modelo por sí solo no significa que una pasarela lo haya habilitado. Antes de integrar a través de ToAPIs, revisa el catálogo de modelos, los precios actuales y la documentación de la solicitud. Confirma la ruta exacta, el derecho de la cuenta, el cuerpo de la solicitud, el modelo de estado asíncrono, el periodo de retención del resultado y la política de facturación.
Si la ruta no está disponible o la cotización no existe, mantén la función deshabilitada o etiquétala como próximamente. No mapees en silencio otro modelo Gemini al mismo nombre comercial. No informes de una generación real salvo que una llamada autenticada haya tenido éxito y los medios devueltos se hayan revisado.
Fuentes y política de actualización
- Google: Gemini Omni 1.2 Flash, vídeo de 15 segundos y precios más bajos — anuncio oficial de lanzamiento, 5 de noviembre de 2026.
- Google Cloud: Gemini Omni 1.2 Flash ya está disponible de forma general — disponibilidad general, contexto empresarial y afirmaciones de lanzamiento.
- Documentación del modelo en Google Cloud — ID de modelo, capacidades, límites y estado de lanzamiento.
- Guía Omni de la API Gemini — Interactions API, referencias específicas de plataforma, niveles de resolución escalada y estado de edición.
- Precios de la API Gemini — tarifas por token Standard y conversión de tokens de vídeo; precio del proveedor, no una cotización de ToAPIs.
Al actualizar esta guía, registra el proveedor, el ID de modelo, la URL de origen y la fecha de revisión de cada capacidad o precio modificados. Mantén separados los precios del proveedor, las cotizaciones de pasarelas y las pruebas de terceros. Esta guía no afirma disponibilidad en ToAPIs, una generación autenticada, un benchmark universal ni un resultado de producción garantizado.