








Guía completa de configuración de Cherry Studio: GPT-5, Claude y LLM chinos en un solo cliente de escritorio
1. Resumen (TL;DR) y panorama de rendimiento
- Benchmark principal: Cherry Studio es un cliente de escritorio open source de primer nivel que admite chat multimodelo, previsualización de artefactos y gestión de una base de conocimiento local.
- Aplicación en producción: Al configurar ToAPIs como proveedor personalizado compatible con OpenAI, los desarrolladores obtienen acceso unificado a los modelos de OpenAI, Anthropic, DeepSeek y Google.
- Economía FinOps: Evita los bloqueos de tarjetas de crédito internacionales gracias a un saldo unificado de pago por uso y una latencia de gateway inferior a 50 ms.
- SLA de alta disponibilidad: 99.95% de uptime con aceleración de latencia en el edge y conmutación por error automática.
- Compatible con OpenAI REST sin refactorizar: Autenticación con token Bearer y cero sobrecarga de refactorización.
2. El problema del cliente fragmentado
Los desarrolladores avanzados y los equipos enterprise usan con frecuencia varios modelos de frontera según la tarea: Claude para diffs de código, GPT para estructurar JSON complejo y DeepSeek para razonamiento matemático avanzado.
Sin embargo, hacer malabares con 4 pestañas de navegador distintas con suscripciones separadas ($20/mes cada una) genera una fricción organizativa enorme. Cherry Studio combinado con ToAPIs ofrece un único centro de mando de escritorio unificado.
Configuración rápida en Cherry Studio:
- Abre Settings → Model Providers → Add Provider.
- Elige el formato compatible con OpenAI.
- Define la API Base URL como
https://api.toapis.com/v1. - Pega tu clave de ToAPIs y añade IDs de modelo como
gpt-5.6,claude-opus-5,deepseek-v4yglm-5.3.
3. Implementación en producción: cURL y Python
Paso 1: Envío rápido con cURL
curl -X POST "https://api.toapis.com/v1/chat/completions" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5-6",
    "messages": [{"role": "user", "content": "Explain production optimization strategies for AI workloads."}],
    "temperature": 0.3
  }'
Paso 2: Cliente Python de producción
import os, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

payload = {
    "model": "gpt-5-6",
    "messages": [{"role": "user", "content": "Explain production optimization strategies for AI workloads."}],
    "temperature": 0.3
}

res = requests.post("https://api.toapis.com/v1/chat/completions", headers=headers, json=payload, timeout=60)
res.raise_for_status()
answer = res.json()["choices"][0]["message"]["content"]
print(f"[✔] Response:\n{answer}")
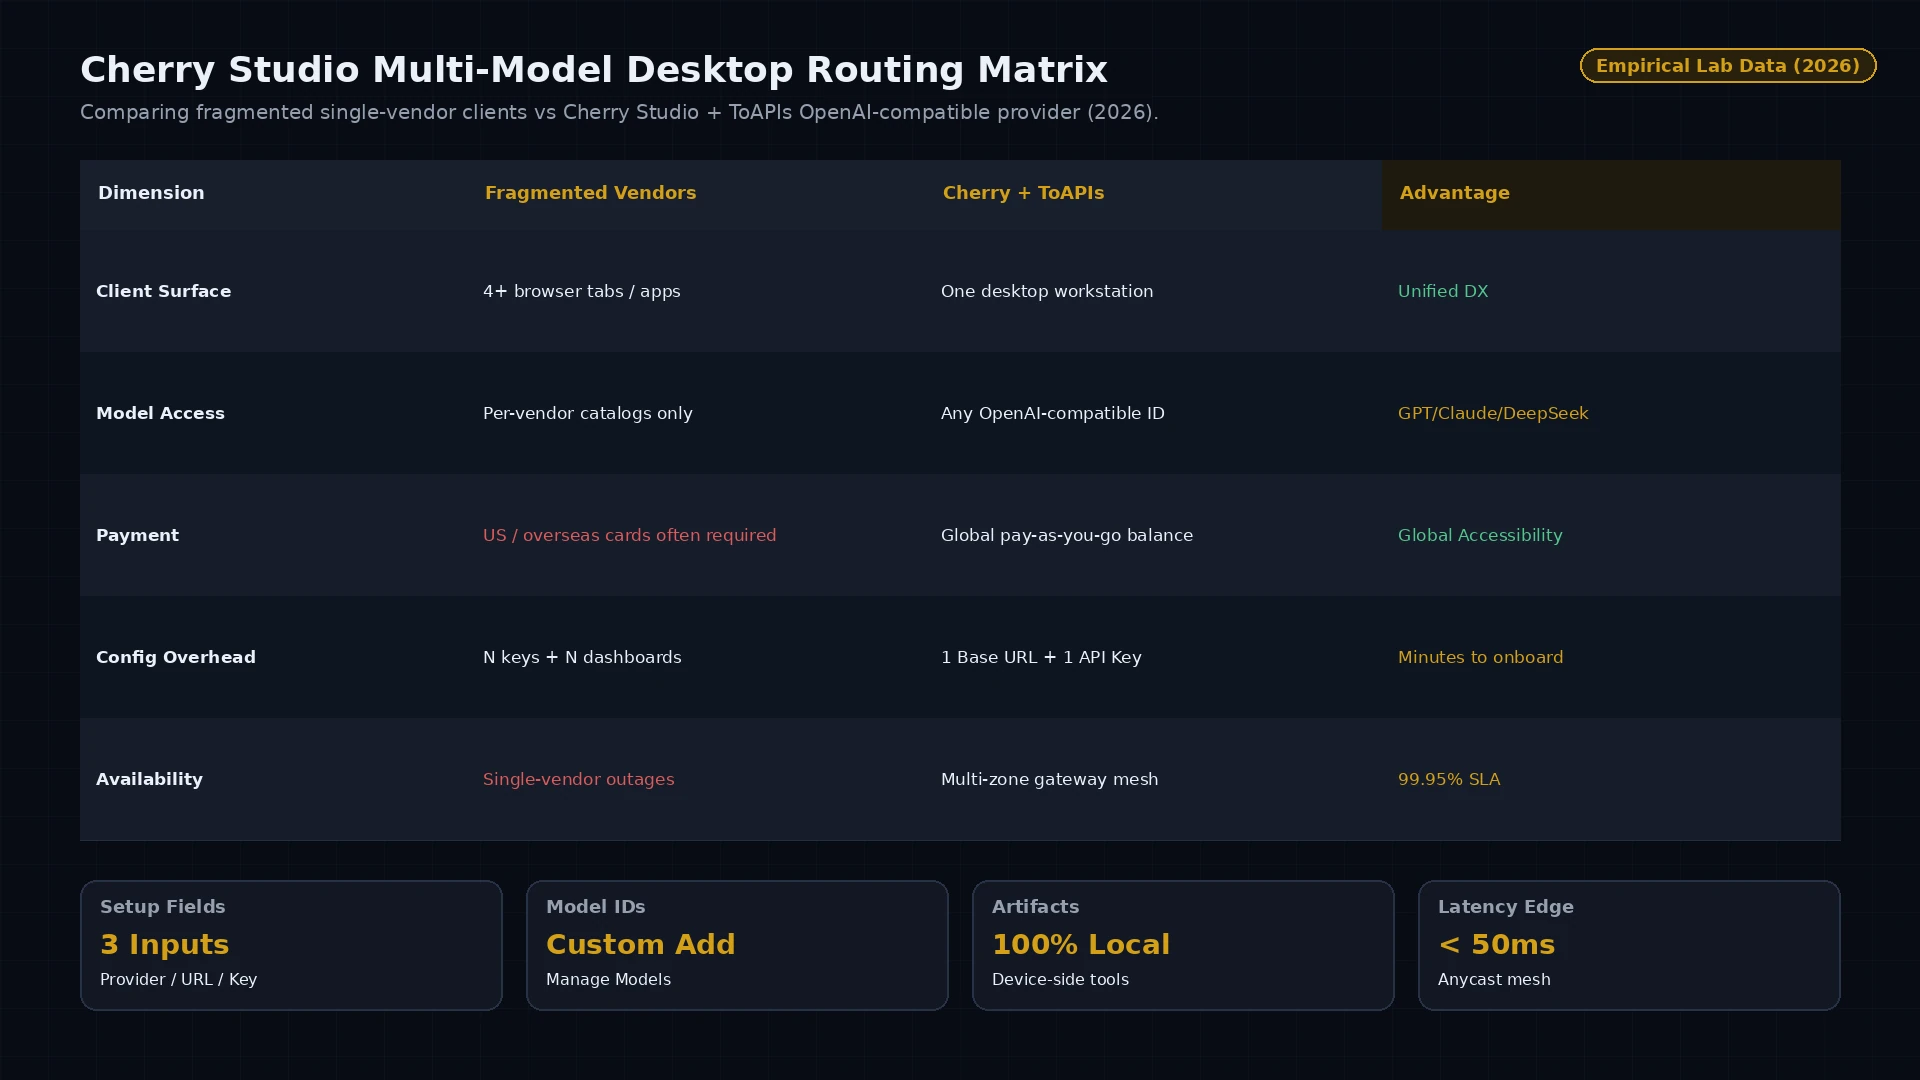
Figura 1: Comparación de clientes de escritorio: suscripciones fragmentadas de un solo proveedor frente al enrutamiento unificado compatible con OpenAI de Cherry Studio + ToAPIs (2026).
4. Nivel producción: manejo de errores y matriz de estados
| Código HTTP | Clasificación del error | Análisis de causa raíz | Estrategia de mitigación en producción |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Error de validación del esquema o parámetros no admitidos | Revisa las dimensiones del payload y verifica que los campos cumplan el contrato |
401 Unauthorized | invalid_api_key | Token Bearer caducado o incorrecto | Renueva el token de API desde el panel de desarrollador de ToAPIs |
429 Rate Limit | rate_limit_exceeded | Se alcanzó el umbral de concurrencia del pool de cómputo | Implementa reintentos con backoff exponencial y jitter aleatorio |
500 / 504 Timeout | gateway_timeout | Latencia temporal en los nodos de inferencia upstream | El gateway redirige automáticamente al clúster de GPU de respaldo |
5. Precios y cálculo del ROI de FinOps
- Base enterprise oficial: Los contratos directos con el proveedor imponen compromisos anuales obligatorios, cuotas fijas de licencias y umbrales de prepago.
- Precio mayorista de ToAPIs: Facturación elástica de pago por uso con tarifas mayoristas ($0.30 - $0.80 por 1M de tokens).
- Análisis de ROI de FinOps: Procesar 500M de tokens al mes reduce el coste operativo de infraestructura de $1,500 a $900 y ahorra $600 al mes (40.0% menos coste).
6. Preguntas frecuentes (FAQ)
P1: ¿Qué formato de API debo seleccionar en Cherry Studio para ToAPIs?
Selecciona el formato 'OpenAI' en Settings -> Model Providers e introduce https://api.toapis.com/v1 como API Base URL.
P2: ¿Puedo usar la búsqueda web y los artefactos de Cherry Studio con ToAPIs?
Sí. Cherry Studio procesa los artefactos y ejecuta las herramientas de forma local en tu máquina, lo que funciona sin problemas con todos los modelos enrutados a través de ToAPIs.
P3: ¿Cómo añado modelos que no aparecen en el desplegable predeterminado de Cherry Studio?
Haz clic en Manage Models dentro de la tarjeta del proveedor ToAPIs y escribe el ID del modelo (por ejemplo, deepseek-v4, claude-opus-5, gpt-5.6) para añadirlo al instante.
7. Lista de acciones y siguientes pasos
- Regístrate para obtener una clave de API en el portal de desarrolladores de ToAPIs.
- Verifica la conectividad de la API con el fragmento cURL del paso 1.
- Añade ToAPIs como proveedor compatible con OpenAI dentro de Cherry Studio y carga tus IDs de modelo.
- Explora los tutoriales enterprise relacionados en nuestro índice de documentación técnica.