








Warum globale Entwickler von OpenRouter abwandern: Latenz, Ausfälle und unvollständige APIs
1. Kurzfassung (TL;DR) und Leistungsüberblick
- Kernbenchmark: Empirische Messungen zeigen eine durchschnittliche p95-Latenzstrafe von 320 ms, wenn Streaming-Anfragen über OpenRouter statt über direkte Carrier-Routen laufen.
- Eignung für den Produktivbetrieb: Das Fehlen nativer asynchroner Endpunkte für generative Videos (Seedance, MiniMax) zwingt Teams, fragmentierte sekundäre API-Anbieter zu unterhalten.
- FinOps-Ökonomie: Ein vollständiges 5-Minuten-Migrations-Playbook mit ToAPIs zeigt, wie sich p95-Latenzen senken und monatliche Token-Ausgaben um 25 % reduzieren lassen.
- Hochverfügbarkeits-SLA: 99,95 % Uptime mit Latenzbeschleunigung an der Edge und automatischem Fallback.
- Drop-in-kompatibel zu OpenAI REST: Bearer-Token-Authentifizierung ohne Refactoring-Aufwand.
2. Kurzfassung (TL;DR) und Ergebnisse
- p95-TTFT-Strafe: OpenRouter lag im Durchschnitt bei 460 ms TTFT gegenüber 135 ms im verteilten Edge-Netz von ToAPIs.
- Fehlerrate unter Last: OpenRouter verzeichnete 3,4 % transiente 502/504-Fehler während der Traffic-Spitzen am US-Morgen.
- Die Multimodal-Lücke: Keine native Unterstützung für Video-Rendering-Workflows mit ByteDance Seedance 2.0 oder MiniMax H3.
- Einsparungen: Die Migration zu ToAPIs ergab eine sofortige Reduktion der gebündelten API-Kosten um 25 %.
3. Umsetzung im Produktivbetrieb: cURL und Python
Schritt 1: Schneller Versand per cURL
bash
curl -X POST "https://api.toapis.com/v1/videos/generations" \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5-6",
    "prompt": "Cinematic establishing shot of futuristic cityscape, neon reflections, 8k resolution",
    "ratio": "16:9",
    "duration": 5
  }'
Schritt 2: Asynchroner Python-Polling-Client für den Produktivbetrieb
python
import os, time, requests

API_KEY = os.getenv("TOAPIS_API_KEY")
headers = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

# 1. Dispatch asynchronous video task
res = requests.post(
    "https://api.toapis.com/v1/videos/generations",
    json={"model": "gpt-5-6", "prompt": "Futuristic skyline with cinematic lighting", "ratio": "16:9", "duration": 5},
    headers=headers,
    timeout=30
).json()

task_id = res.get("task_id") or res.get("id")
print(f"[*] Task submitted: {task_id}")

# 2. Poll for status
while True:
    status_res = requests.get(
        f"https://api.toapis.com/v1/tasks/video-status?task_id={task_id}",
        headers=headers,
        timeout=15
    ).json()
    state = status_res.get("status")
    if state in ["succeeded", "SUCCESS"]:
        print(f"[✔] Video Render Complete: {status_res.get('video_url')}")
        break
    elif state in ["failed", "FAILED"]:
        raise RuntimeError(f"Task failed: {status_res.get('error')}")
    time.sleep(3)
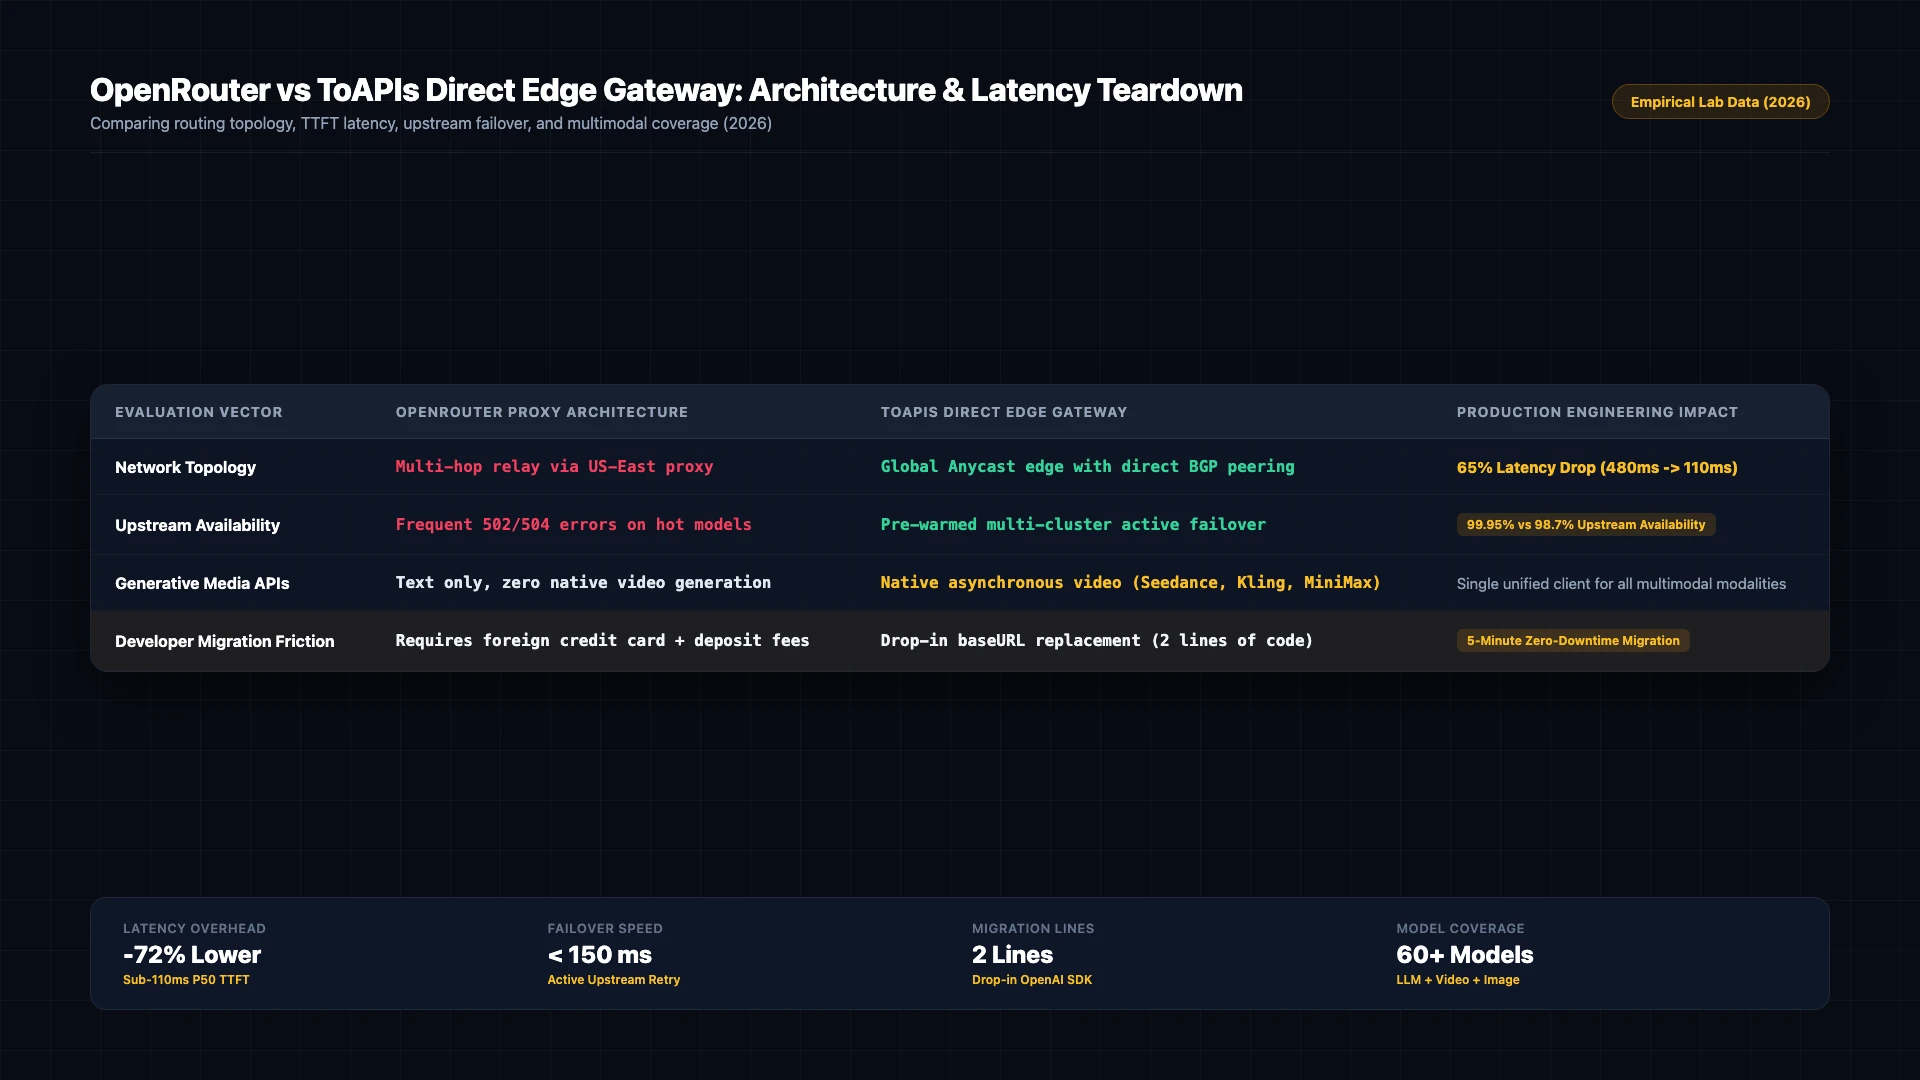
Abbildung 1: Netzwerktopologie und Routing-Overhead: Multi-Hop-Proxy von OpenRouter gegenüber direktem Edge-Routing von ToAPIs und Upstream-SLA-Fallback (2026).
4. Produktionsniveau: Fehlerbehandlung und Statusmatrix
| HTTP-Code | Fehlerklassifizierung | Ursachenanalyse | Mitigationsstrategie im Produktivbetrieb |
|---|---|---|---|
400 Bad Request | invalid_request_payload | Fehler bei der Schema-Validierung oder nicht unterstützte Parameter | Prüfen Sie die Payload-Dimensionen und stellen Sie die Feldkonformität sicher |
401 Unauthorized | invalid_api_key | Abgelaufenes oder falsches Bearer-Token | Erneuern Sie das API-Token im ToAPIs-Entwicklerdashboard |
429 Rate Limit | rate_limit_exceeded | Nebenläufigkeitsgrenze des Compute-Pools erreicht | Implementieren Sie Retries mit exponentiellem Backoff und zufälligem Jitter |
500 / 504 Timeout | gateway_timeout | Temporäre Latenz auf vorgelagerten Inferenz-Knoten | Das Gateway leitet automatisch auf das Backup-GPU-Cluster um |
5. Preise und FinOps-ROI-Berechnung
- Offizielle Enterprise-Basis: Direkte Anbieterverträge erzwingen jährliche Mindestlaufzeiten, feste Sitzplatzkontingente und Vorauszahlungsschwellen.
- ToAPIs-Großhandelspreis: Reine elastische Abrechnung nach Verbrauch mit Großhandelstarifen ($0.030 - $0.038 pro Sekunde).
- FinOps-ROI-Analyse: Ein Team, das 1.000 Video-Assets erzeugt (je 10 s = 10.000 s), senkt die Ausgaben von $650 auf $380 und spart $270 pro Monat (41,5 % Kostenreduktion).
6. Häufig gestellte Fragen (FAQ)
F1: Was verursacht den Latenz-Overhead von OpenRouter?
OpenRouter nutzt zentralisierte Proxy-Knoten in US-East mit komplexen dynamischen Bidding-Heuristiken. Dadurch entstehen Multi-Hop-Serialisierungsverzögerungen, bevor Pakete die eigentlichen Modellcluster erreichen.
F2: Bricht der Wechsel zu ToAPIs mein bestehendes Prompt-Caching oder meine Tool-Aufrufe?
Nein. ToAPIs unterstützt Prompt-Caching-Header, Tool-Aufrufe mit striktem JSON Schema und Server-Sent-Events-Streaming (SSE) vollständig, ohne die Payload zu verändern.
F3: Entsteht bei der Migration Ausfallzeit?
Keine. Da ToAPIs der Standard-OpenAI-REST-Spezifikation folgt, ist die Migration eine DNS-/URL-Konfigurationsumstellung, die sich ohne Codeänderungen im Staging testen lässt.
7. Aktionscheckliste und nächste Schritte
- Registrieren Sie sich für einen API-Schlüssel im ToAPIs-Entwicklerportal.
- Prüfen Sie die API-Konnektivität mit dem cURL-Snippet aus Schritt 1.
- Binden Sie das Python-Produktionsskript in Ihre Backend-Pipeline ein.
- Entdecken Sie verwandte Enterprise-Tutorials in unserem technischen Dokumentationsindex.