








GPT-Image-2.6 API: Leitfaden zu Flare, Sunburst, GIF und SVG
Die Anfrage, die einen Bild-Sprint ruiniert, ist selten das Hero-Bild. Es ist die Rückfrage: „Kann derselbe Aufruf ein GIF zurückgeben? Bekommen wir das Logo als SVG? Kann das Design die Tasse zwei Zentimeter nach links schieben, ohne die ganze Szene neu zu erzeugen?" Eine Pipeline, die um ein einzelnes flaches PNG herum gebaut ist, beantwortet alle drei mit einem neuen Projekt.
OpenAI hat Images 2.6 am 4. November 2026 veröffentlicht, und die API deckt diese Anfragen nun ab: zwei Modellvarianten, GIF- und SVG-Ausgabe, markup-gesteuerte Bearbeitungen und eine separate complexity-Steuerung. Der Haken ist, dass die neue Oberfläche schneller gewachsen ist, als jede Referenzseite aktualisiert wurde. Dieser Leitfaden liefert Ihnen eine lauffähige Integration der GPT-Image-2.6 API und markiert danach die genauen Stellen, an denen Sie einen Grenzwert prüfen sollten, bevor Sie ihn fest verdrahten.
TL;DR
- Zwei Modelle, ein Preisschema.
gpt-image-2.6-flareist der Weg für schnelle Iteration;gpt-image-2.6-sunburstzielt auf höhere Qualität, mehr Detail und stärkere Bearbeitungskonsistenz bei mittlerer oder hoher Qualität. Beide nutzen dieselben Token-Sätze.- Neue API-Funktionen. GIF-Ausgabe, SVG-Ausgabe, markup-gesteuerte Bearbeitungen und ein
complexity-Parameter. Generierung und Bearbeitung bleiben getrennte Endpunkte.- Abrechnung nach Tokens, nicht nach Bild. Bildausgabe kostet $30 pro 1M Tokens; Bildeingabe $8 pro 1M ($2 gecacht); Texteingabe $5 pro 1M ($1.25 gecacht).
- Die Dokumentation widerspricht sich an drei Stellen. GIF-
frame_count, Markup-Modellunterstützung und Teile der Qualitäts- und Größenreferenz. Prüfen Sie das in Ihrem Konto, bevor Sie einen festen Grenzwert ausliefern.
1. Was mit der GPT-Image-2.6 API kam
Images 2.6 ist die Generation vom 4. November 2026, verfügbar in ChatGPT, in Codex und über die API. OpenAI gibt an, dass sie Bilder 50 % schneller erzeugt als die vorige Generation. Das ist eine Anbieteraussage zur Generierungsgeschwindigkeit, kein Versprechen für Ihre p95-Latenz, und sie sagt nichts über den Preis: Die Abrechnung erfolgt weiterhin nach Tokens.
Die beiden Modell-IDs bedienen unterschiedliche Aufgaben:
gpt-image-2.6-flareist auf schnelles Iterieren ausgelegt. Beiquality=lowbeschreibt OpenAI eine Generierung in nur etwa 6 Sekunden, was ihn zur Standardwahl für Prompt-Exploration, Thumbnails und UI-Vorschauen macht, bei denen „gut genug jetzt" besser ist als „perfekt später".gpt-image-2.6-sunburstzielt auf höhere Qualität und mehr Detail, mit stärkerer Bearbeitungskonsistenz beiquality=mediumoderhigh. Verwenden Sie ihn für finale Assets und für Bearbeitungen, bei denen die unveränderten Teile erhalten bleiben müssen.
Beide Modelle teilen die Token-Sätze, die Wahl entscheidet also über Akzeptanzrate und Latenz, nicht über eine günstigere Modell-ID. Wenn Sie von der vorigen Generation migrieren, erklärt der GPT Image 2 API-Leitfaden die gemeinsame Anfrageform; dieser Artikel konzentriert sich darauf, was 2.6 ergänzt. Der GPT-Image-2.6 Modell-Leitfaden ist die Stelle, an der Sie die Verfügbarkeit für Ihr Konto prüfen.
Die API ist OpenAI-kompatibel. Die Beispiele unten zielen auf https://api.toapis.com/v1; wenn Sie sie auf eine andere kompatible Basis-URL richten, behalten Sie das Payload und ändern nur Basis-URL und Schlüssel.
2. Ihre erste Anfrage an die GPT-Image-2.6 API
Beginnen Sie mit der Generierung. Dieser curl-Aufruf fordert von Flare einen quadratischen Entwurf mit niedriger Qualität und niedriger complexity an — der schnellste sinnvolle Smoke-Test:
curl -sS https://api.toapis.com/v1/images/generations \
  -H "Authorization: Bearer $TOAPIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-flare",
    "prompt": "Paper-cut football stadium at night, layered cardstock, rim light, no text",
    "size": "1024x1024",
    "quality": "low",
    "complexity": "low",
    "n": 1
  }' -o flare-response.json
Prüfen Sie die Antwort, bevor Sie einen Downloader schreiben. Je nach Modell und Anfrageoptionen liefern Bild-APIs üblicherweise eine URL oder Base64-Daten; ein Client, der data[0].url annimmt, scheitert an einer gültigen Base64-Antwort. Der folgende Helfer behandelt beides und dient allen Beispielen in diesem Artikel:
import base64
import os
import pathlib
import requests

API = "https://api.toapis.com/v1/images/generations"
HEADERS = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}


def generate(model: str, prompt: str, output: str, **params) -> str:
    payload = {"model": model, "prompt": prompt, "n": 1, **params}
    response = requests.post(API, headers=HEADERS, json=payload, timeout=180)
    response.raise_for_status()
    item = response.json()["data"][0]
    target = pathlib.Path(output)
    if item.get("b64_json"):
        target.write_bytes(base64.b64decode(item["b64_json"]))
    else:
        target.write_bytes(requests.get(item["url"], timeout=60).content)
    return str(target)


if __name__ == "__main__":
    prompt = "Paper-cut football stadium at night, layered cardstock, rim light, no text"
    generate("gpt-image-2.6-flare", prompt, "flare-draft.png",
             size="1024x1024", quality="low", complexity="low")
    generate("gpt-image-2.6-sunburst", prompt, "sunburst-final.png",
             size="1536x1024", quality="high", complexity="high")
Das Timeout von 180 Sekunden ist Absicht. Komplexe Prompts können bis zu etwa zwei Minuten dauern, ein Client-Timeout von 30 Sekunden weist also Arbeit ab, die der Server womöglich noch abschließt. Wenn Ihr Produkt eine solch lange Anfrage nicht halten kann, nutzen Sie eine Job-Queue, statt das Timeout zu kürzen und blind erneut zu versuchen.
3. Flare vs. Sunburst: Modellwahl in der GPT-Image-2.6 API
Der nützliche Vergleich lautet nicht „welches Modell ist besser". Er lautet: „Welches Modell wird bei dieser Aufgabe mit akzeptabler Latenz und akzeptablen Kosten angenommen?" Ein abgelehnter Flare-Entwurf kann teurer sein als ein Sunburst-Bild, das ausgeliefert wird.
| Aufgabe | Bessere erste Wahl | Warum |
|---|---|---|
| 20 Prompt-Richtungen erkunden | gpt-image-2.6-flare | Generierung in niedriger Qualität ist der schnelle Pfad; schlechte Richtungen früh verwerfen |
| UI-Thumbnails und Platzhalter | gpt-image-2.6-flare | Geschwindigkeit zählt mehr als feines Detail |
| Finales Hero-Bild | gpt-image-2.6-sunburst | Höhere Qualität und mehr Detail bei mittleren oder hohen Einstellungen |
| Bearbeitung, die Identität erhalten muss | gpt-image-2.6-sunburst | Stärkere Bearbeitungskonsistenz bei mittlerer oder hoher Qualität |
| Erster Durchlauf mit hohem Volumen | gpt-image-2.6-flare | Gleiche Token-Sätze, aber weniger Sekunden pro Versuch |
| Format-Experiment (GIF/SVG) | Beide, dann erneut ausführen | Formatunterstützung bestätigen, bevor Sie die Qualität optimieren |
Führen Sie beide Modelle mit denselben Prompts und derselben Ausgabegröße aus, ändern Sie jeweils nur eine Variable und prüfen Sie die Ergebnisse blind. Erfassen Sie Akzeptanzrate, p50/p95-Latenz und die rohen Antwort-Metadaten: angefragtes und zurückgegebenes Modell, Qualität, complexity, Größe, Format, Token-Verbrauch falls vorhanden und Laufzeit. Ein attraktives Einzelbeispiel beweist nicht, dass ein Modell besser ist.
Ein praktisches Muster: Flare in niedriger Qualität für die Exploration, dann Sunburst in hoher Qualität für die gewählte Richtung. Übernehmen Sie den Prompt, erwarten Sie aber kein pixelidentisches zweites Bild. Wenn Konsistenz zählt, testen Sie eine Bearbeitung statt einer neuen Generierung.
4. Qualität und complexity in der GPT-Image-2.6 API
quality akzeptiert low, medium, high, xhigh, max oder auto. Der Standard ist auto. Die meisten Teams brauchen nur drei Betriebspunkte:
low, wenn Latenz dominiert und das Bild entbehrlich ist.mediumoderhigh, wenn die Ausgabe geprüft oder ausgeliefert wird.xhighodermaxfür finale Assets, bei denen Detail den Mehraufwand rechtfertigt.
Latenz und Token-Verbrauch variieren je nach Arbeitslast. Kopieren Sie keine Preise pro Bild aus 2.5; 2.6 rechnet nach Tokens ab.
complexity ist davon getrennt: low, medium oder high, wobei high der dokumentierte Standard ist. Es gibt keine separate Gebühr, aber höhere Einstellungen können Latenz und unerwünschte Änderungen hinzufügen. Behandeln Sie es als Variable für Prompt-Treue, die Sie testen müssen, nicht als kostenloses Qualitäts-Upgrade: Eine Anfrage mit niedriger complexity kann schneller sein, während eine mit hoher complexity eine unruhige Szene auflöst oder Teile „verbessert", die Sie unangetastet lassen wollten. Führen Sie einen kleinen A/B-Test mit Ihren eigenen Prompts durch.
| Test | quality | complexity | Was Sie lernen |
|---|---|---|---|
| Latenz-Untergrenze | low | low | Schnellste realistische Antwort für den Prompt |
| Standardverhalten | auto | high (dokumentierter Standard) | Was ein nicht konfigurierter Client erhält |
| Drift-Prüfung | high | low | Ob niedrigere complexity unerwünschte Änderungen reduziert |
| Finales Detail | high oder xhigh | high | Ob der Mehraufwand die Akzeptanz verbessert |
Ändern Sie jeweils nur eine Variable. Wenn Sie Qualität und complexity gemeinsam ändern, sagt ein schlechtes Ergebnis nichts darüber aus, welcher Regler es verursacht hat.
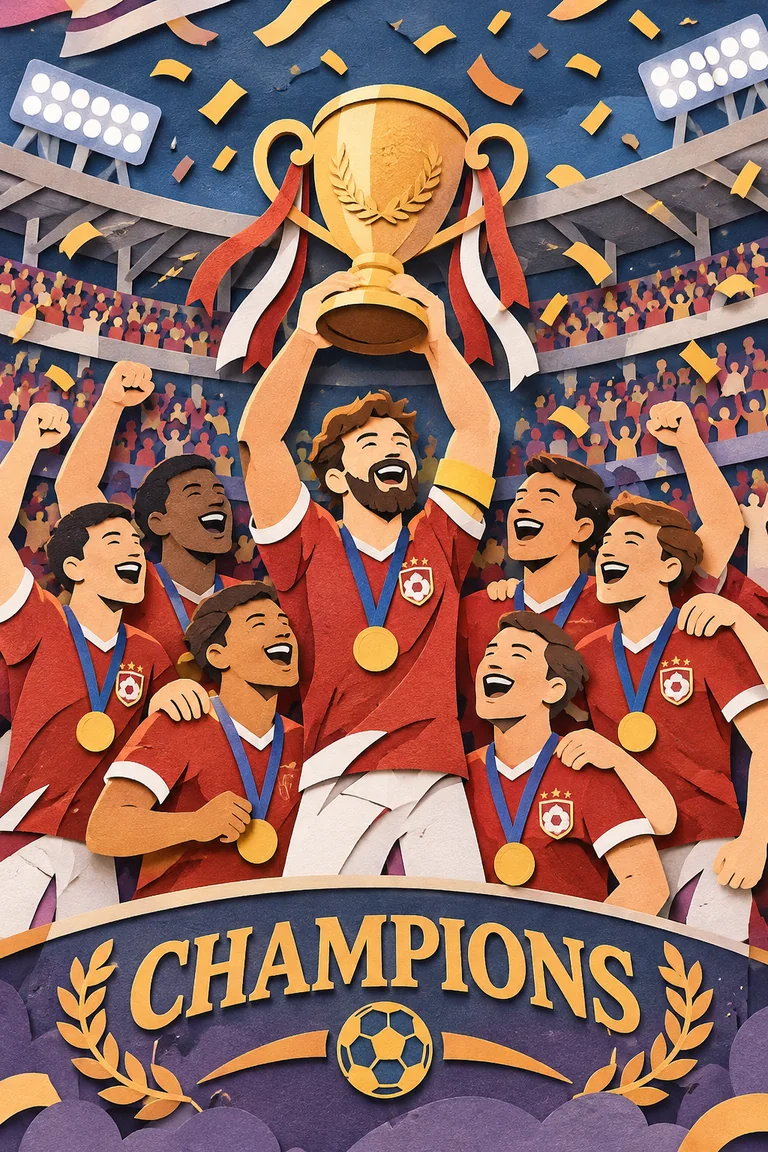
GPT-Image-2.6 Beispiel in mittlerer Qualität: geschichteter Karton und Stadionlicht. Illustrative Ausgabe, kein Benchmark.
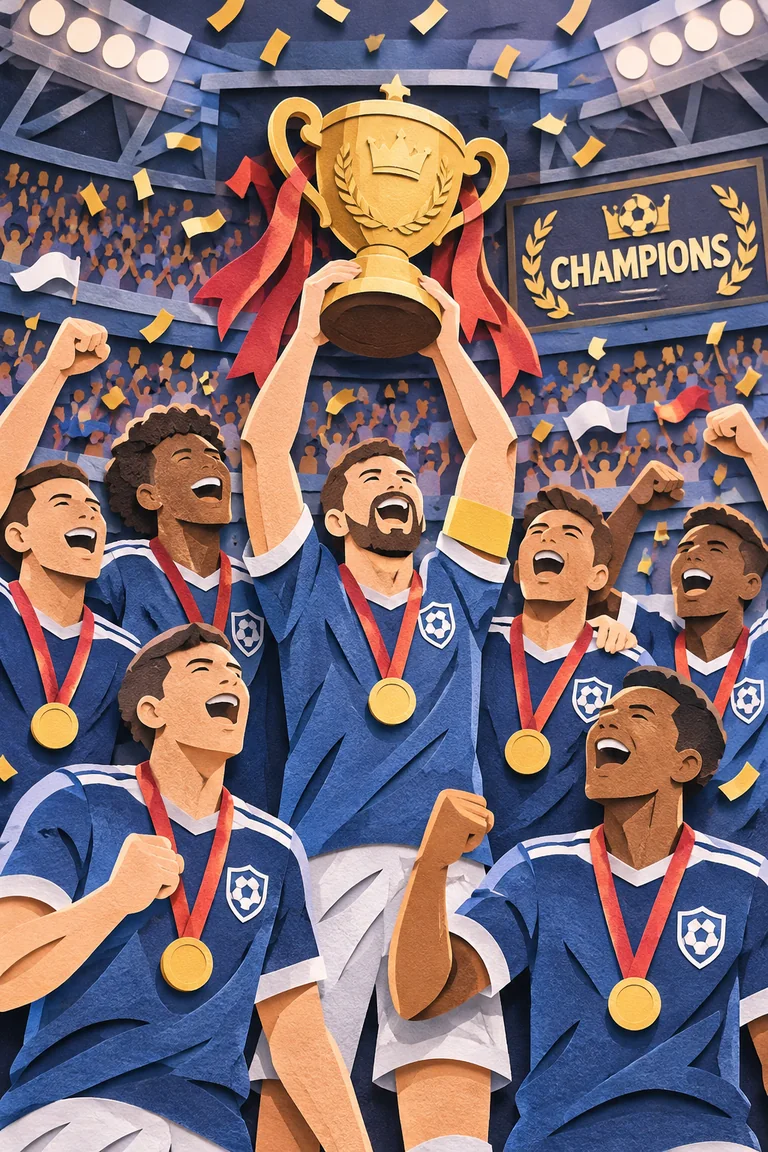
GPT-Image-2.6 Beispiel in hoher Qualität: mehr Oberflächendetail und schärfere Kanten. Vergleichen Sie in Anzeigegröße die Akzeptanz, nicht die Schärfe.
5. GIF-Ausgabe aus der GPT-Image-2.6 API
GIF gibt es nur in der Generierung. Setzen Sie output_format auf gif bei POST /v1/images/generations; Bearbeitungen unterstützen es nicht. Die Steuerungen sind:
frame_count: Standard9. Der Bild-Leitfaden nennt2-64, die API-Referenz2-16. Der Widerspruch ist ungeklärt, verdrahten Sie 64 also nicht ohne echte Prüfung.frame_duration_ms: Standard200, Minimum20. Neun Frames bei 200 ms ergeben 1,8 Sekunden; 16 Frames ergeben 3,2 Sekunden. Das ist Arithmetik, keine Garantie für flüssige Bewegung.
generate(
    "gpt-image-2.6-flare",
    "A paper lantern monkey swinging through a bamboo forest, simple background, no text",
    "monkey-lantern.gif",
    size="1024x1024",
    quality="low",
    output_format="gif",
    frame_count=9,
    frame_duration_ms=200,
)
Beginnen Sie mit den voreingestellten 9 Frames. Wenn Sie mehr brauchen, tasten Sie sich in kleinen Schritten nach oben und stoppen Sie bei der ersten Ablehnung; das zeigt, was Ihr Konto heute akzeptiert. Halten Sie die Szene einfach, denn ein GIF vervielfacht visuelle Entscheidungen über alle Frames. Achten Sie auf die gelieferte Dateigröße und die Abmessungen, nicht nur auf den HTTP-Status.
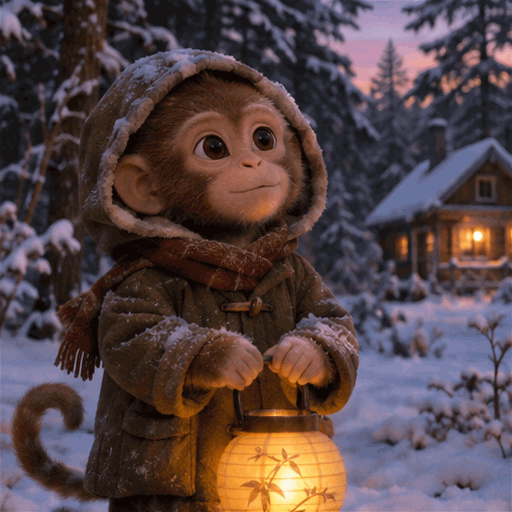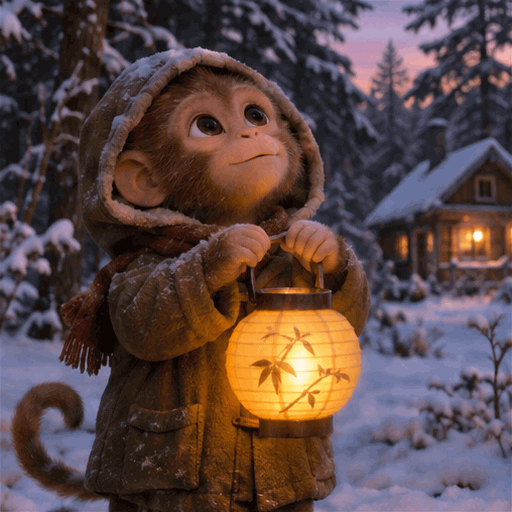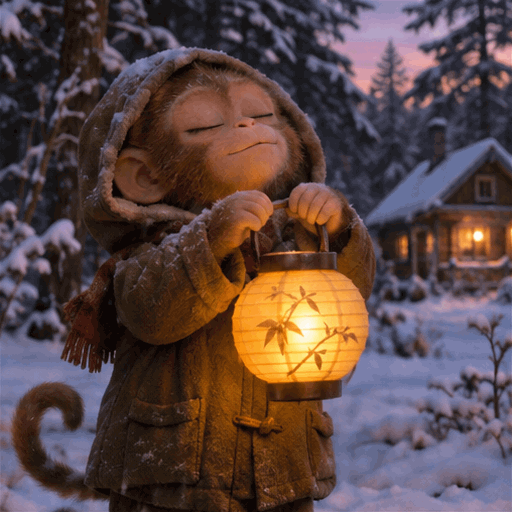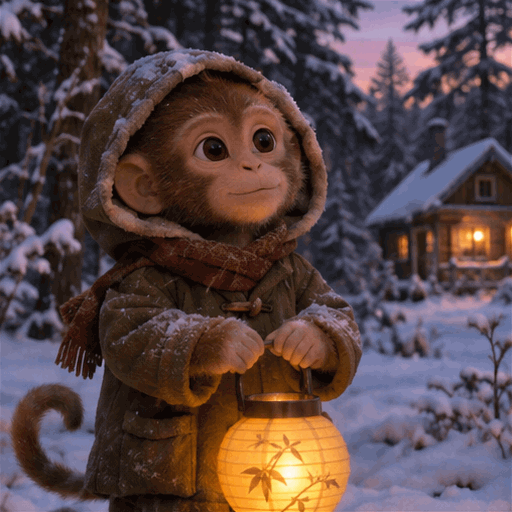
GPT-Image-2.6 Beispiel: ein kurzes animiertes GIF aus einem einzigen Aufruf. Frame-Anzahl und Wiedergabedauer hängen von Ihren Einstellungen ab.
Behandeln Sie GIF als Vorschauformat, nicht als Master-Asset. Behalten Sie die Einstellungen und, wenn möglich, ein Standbild für Thumbnails und Barrierefreiheits-Fallbacks.
6. SVG-Ausgabe aus der GPT-Image-2.6 API
SVG gibt es ebenfalls nur in der Generierung. Setzen Sie output_format auf svg, behalten Sie n=1 und erwarten Sie statische Vektorausgabe. Dokumentierte Einschränkungen: kein Streaming, keine Teilbilder, keine Kompression und kein prompt_rewriter. Bearbeitungen unterstützen SVG nicht.
generate(
    "gpt-image-2.6-sunburst",
    "A minimal field-and-flour bakery label, wheat stalk and rolling pin, two-color vector, no text",
    "field-and-flour.svg",
    size="1024x1024",
    quality="high",
    output_format="svg",
    n=1,
)
Weisen Sie n>1 in Ihrem Client zurück. Senden Sie kein output_compression und erwarten Sie kein progressives Rendering; SVG kommt als vollständiges statisches Asset. Da SVG Markup ist, behandeln Sie die Datei als nicht vertrauenswürdig: liefern Sie sie als Bild aus oder bereinigen Sie sie, bevor Sie sie inline einbetten. Ein korrekt wirkender Vektor mit unerwarteten Elementen ist ein Sicherheitsproblem.
SVG eignet sich für Icons, Labels, Diagramme und Druckmarken, bei denen ein Raster-Upscale sichtbar würde. Es eignet sich nicht für Fotos, Animation oder Bearbeitungsworkflows. Um einen Vektor zu überarbeiten, erzeugen Sie ihn mit einem präziseren Prompt neu oder bauen ihn in einem Design-Tool nach; versprechen Sie keine editierbaren Ebenen, ohne die Struktur geprüft zu haben.
GPT-Image-2.6 Beispiel: statische SVG-Ausgabe für ein einfaches zweifarbiges Label. Prüfen Sie das zurückgegebene Markup, bevor Sie es inline ausliefern.
7. Markup-gesteuerte Bearbeitungen in der GPT-Image-2.6 API
Die markup-gesteuerte Bearbeitung sendet ein Quellbild plus eine transparente PNG-Überlagerung an POST /v1/images/edits. Die Überlagerung wird auf das erste Bild gezeichnet und muss dessen Abmessungen entsprechen. Erstes Bild und Überlagerung dürfen jeweils höchstens 16.777.216 Pixel groß sein; die Überlagerungsdatei höchstens 50 MB.
Die Regeln sind streng:
- Markup lässt sich nicht mit
maskoderprompt_rewriterkombinieren. - Die Überlagerung muss ein transparentes PNG sein, kein abgeflachter Screenshot.
- Die Überlagerung gilt für das erste Bild, wenn Sie mehrere Bilder senden.
- Es gibt keine zusätzliche Markup-Gebühr, die Anfrage wird aber weiterhin nach ihren Tokens abgerechnet.
Exportieren Sie das Basisbild, erzeugen Sie eine RGBA-Überlagerung mit denselben Pixelmaßen, zeichnen Sie einen halbtransparenten Pfeil oder Umriss um das Ziel und laden Sie beides mit einem Prompt hoch, der die Änderung und das unverändert Bleibende definiert. Die Überlagerung zeigt wo; der Prompt sagt was. „Verschiebe die Tasse nach rechts und behalte Tisch, Schatten und Hintergrund" ist testbar. „Mach es besser" nicht.
import base64
import os
import requests

url = "https://api.toapis.com/v1/images/edits"
headers = {"Authorization": f"Bearer {os.environ['TOAPIS_API_KEY']}"}

with open("base.png", "rb") as image, open("overlay.png", "rb") as markup:
    response = requests.post(
        url,
        headers=headers,
        data={
            "model": "gpt-image-2.6-sunburst",
            "prompt": "Move the mug to the right side of the table and keep the table, shadow, and background unchanged.",
            "size": "1024x1024",
            "quality": "high",
            "complexity": "medium",
        },
        files={"image": image, "markup": markup},
        timeout=180,
    )
response.raise_for_status()
item = response.json()["data"][0]
if item.get("b64_json"):
    open("edited.png", "wb").write(base64.b64decode(item["b64_json"]))
else:
    open("edited.png", "wb").write(requests.get(item["url"], timeout=60).content)
Dieses Beispiel verwendet markup als Namen des Überlagerungsteils; bestätigen Sie ihn in der aktuellen API-Referenz. Die Referenz bezeichnet Markup als 2.5-Funktion, während der Bild-Leitfaden es für 2.5 und 2.6 beschreibt. Liefern Sie nichts aus, bis eine Testanfrage erfolgreich ist. Wenn Sunburst Markup ablehnt, wechseln Sie die Version nicht stillschweigend; machen Sie den Fehler sichtbar und behalten Sie den letzten bekannt funktionierenden Pfad.
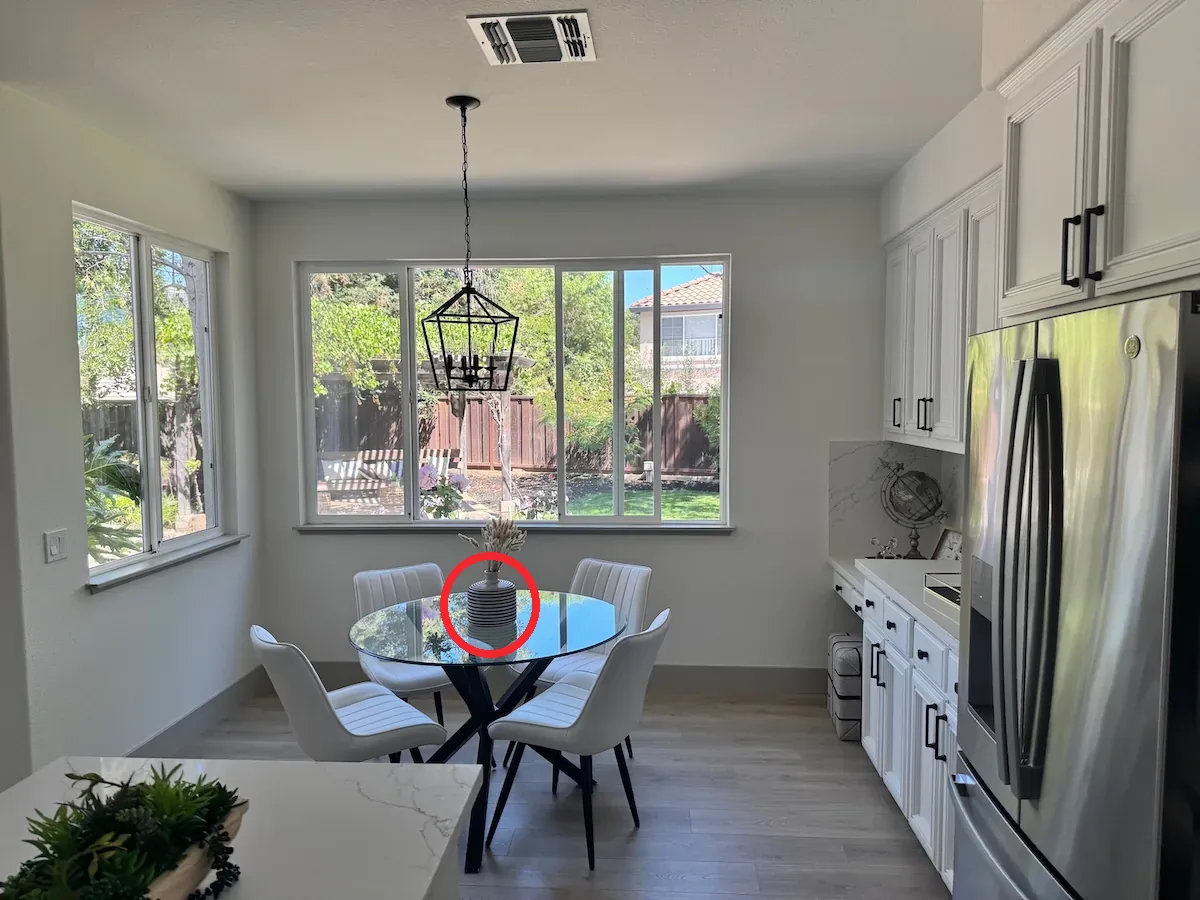
GPT-Image-2.6 Beispiel: das Quellbild vor einer markup-gesteuerten Bearbeitung. Überlagerung und Prompt werden nicht gezeigt.
GPT-Image-2.6 Beispiel: das bearbeitete Ergebnis. Prüfen Sie unveränderte Bereiche genauso sorgfältig wie die gewünschte Änderung; ein überzeugendes neues Objekt kann den Schatten verschieben oder den Hintergrund verändern.
Messen Sie die Bearbeitungsqualität mit einer Checkliste auf Regionsebene: Ziel geändert, Geometrie außerhalb des Ziels erhalten, Schatten und Reflexionen konsistent, Text unverändert und keine neuen Objekte am Rand der Überlagerung. Behalten Sie das Basisbild, damit Sie ohne Neugenerierung erneut versuchen können.
8. Größen und Grenzwerte in der GPT-Image-2.6 API
Die empfohlenen Größen sind 1024x1024, 1536x1024 und 1024x1536. Benutzerdefinierte Größen müssen Vielfache von 16 verwenden, ein Seitenverhältnis zwischen 1:3 und 3:1 haben und dürfen 3840x2160 nicht überschreiten. Alles über 2560x1440 ist experimentell; prüfen Sie es zuerst, wenn ein Layout von den empfohlenen Größen abweicht.
Eine kleine Prüfung im Client fängt die meisten ungültigen Anfragen ab, bevor sie einen Roundtrip kosten:
def validate_size(width: int, height: int) -> str:
    if width % 16 or height % 16:
        raise ValueError("width and height must be multiples of 16")
    if not (1 / 3 <= width / height <= 3):
        raise ValueError("aspect ratio must stay between 1:3 and 3:1")
    if width > 3840 or height > 2160:
        raise ValueError("maximum size is 3840x2160")
    if width * height > 3840 * 2160:
        raise ValueError("pixel area exceeds the documented maximum")
    return f"{width}x{height}"
Die Widersprüche in der Dokumentation zur GPT-Image-2.6 API sind nicht kosmetisch. Sie verändern, was Ihr Client akzeptieren sollte:
| Thema | Eine Quelle sagt | Eine andere sagt | Technische Maßnahme |
|---|---|---|---|
GIF-frame_count | Bild-Leitfaden: 2-64 | API-Referenz: 2-16 | Bei 9 starten; schrittweise erhöhen; 64 nicht verdrahten |
| Markup-Modellunterstützung | Bild-Leitfaden: 2.5 und 2.6 | API-Referenz: nur 2.5 | 2.6 im eigenen Konto testen; Fallback behalten |
| Qualitäts- und Größentabellen | Der 2.6-Leitfaden enthält neuere Stufen und Größen | Einige Referenzseiten hinken hinter der vorigen Generation | Enum und Abmessungen zur Laufzeit validieren |
Behandeln Sie Dokumentation als versionierte Konfiguration: Notieren Sie Quell-URL, Zugriffsdatum und das tatsächliche Verhalten Ihres Kontos. Ein 400 wegen eines nicht unterstützten Enums ist ein Beleg; ein Kommentar in der Konfiguration nicht.
9. Die echten Kosten eines Aufrufs der GPT-Image-2.6 API
OpenAI rechnet Images 2.6 nach Tokens ab. Sowohl gpt-image-2.6-flare als auch gpt-image-2.6-sunburst nutzen dieselben Sätze:
| Token-Typ | Standard | Gecacht |
|---|---|---|
| Bildausgabe | $30.00 / 1M | Nicht anwendbar |
| Bildeingabe | $8.00 / 1M | $2.00 / 1M |
| Texteingabe | $5.00 / 1M | $1.25 / 1M |
Die Kostenformel lautet:
cost = (image_output_tokens * 30
      + image_input_tokens * 8
      + cached_image_input_tokens * 2
      + text_input_tokens * 5
      + cached_text_input_tokens * 1.25) / 1_000_000
Es gibt keinen offiziellen festen Preis pro Bild; jede Schätzung beginnt beim gemessenen Token-Verbrauch. Angenommen, eine Generierungsanfrage berechnet 400 Text-Eingabe-Tokens und 5.000 Bildausgabe-Tokens: (400 × 5 + 5,000 × 30) / 1,000,000 = $0.152. Diese Zahlen sind illustrativ, kein Durchschnitt. Eine Bearbeitung, die zusätzlich 2.000 Bildeingabe-Tokens berechnet, ergänzt $0.016 auf $0.168.
Bei 1.000 Anfragen werden aus den hypothetischen $0.152 rund $152, vor Bildeingabe oder Cache-Rabatten. Verfolgen Sie die Kosten pro akzeptiertem Bild, nicht pro Anfrage: Rechnen Sie Wiederholungen, Ablehnungen, Prüfzeit und Speicherung mit. Ein günstigerer Aufruf kann verlieren, wenn Reviewer 40 % seiner Ausgabe ablehnen.
Zwei Regeln halten die Rechnung ehrlich: 50 % schneller bedeutet nicht 50 % günstiger, denn Geschwindigkeit ändert die Latenz, nicht die Token-Sätze; und Preise pro Bild aus 2.5 gelten nicht für 2.6. Gecachte Eingabe verbilligt Bearbeitungen mit wiederholter Referenz nur, wenn die Eingabe aus dem Cache bedient wird. Prüfen Sie die Preise und gleichen Sie sie mit dem zurückgegebenen Verbrauch ab.
10. Checkliste für den Produktivbetrieb und bekannte Einschränkungen
Die GPT-Image-2.6 API ist leistungsfähig, aber keine deterministische Layout-Engine. Dokumentierte Grenzen gelten weiter: Komplexe Prompts können bis zu etwa zwei Minuten dauern, die Textwiedergabe hat Grenzen, Konsistenz über Generationen hinweg ist nicht garantiert und die Kompositionskontrolle ist unvollkommen. Planen Sie Prüfung und Wiederholung ein, nicht den einen perfekten Aufruf.
Bevor Sie Traffic auf die GPT-Image-2.6 API leiten:
- Setzen Sie ein Timeout oberhalb des Worst Case oder stellen Sie lange Jobs in eine Queue. Wiederholen Sie eine bezahlte Anfrage nach einem unklaren Timeout nicht blind; prüfen Sie zuerst Status oder Idempotenz.
- Validieren Sie Modell-IDs, Qualität, complexity, Größe und Ausgabeformat im eigenen Client. Weisen Sie nicht unterstützte Kombinationen zurück, bevor Sie eine Anfrage bezahlen.
- Protokollieren Sie angefragtes und zurückgegebenes Modell, Format, Abmessungen, Qualität, complexity, Token-Verbrauch, Latenz und einen Hash der Ausgabe. Schwärzen Sie Schlüssel und sensible Prompts.
- Trennen Sie Generierungs- und Bearbeitungsfehler in Ihren Metriken. Eine abgelehnte Markup-Anfrage und eine langsame Generierung sind verschiedene Vorfälle.
- Nutzen Sie die Responses API für mehrstufige Bildbearbeitung; sie unterstützt Generierung und Bearbeitung über mehrere Turns. Die Images-Endpunkte bleiben für einmalige Jobs einfacher.
- Halten Sie einen getesteten Fallback bereit. Wenn Sunburst nicht verfügbar ist, kann Flare die Anfrage womöglich bedienen, aber die Ausgabe unterscheidet sich; sagen Sie dem Nutzer, dass ein Fallback-Modell lief, statt still zu ersetzen.
- Speichern Sie benötigte Assets in kontrolliertem Speicher. Gehen Sie nicht davon aus, dass eine temporäre URL ein dauerhaftes Archiv ist, und betten Sie nicht vertrauenswürdiges SVG nicht ohne Bereinigung ein.
Nutzen Sie für den Rollout ein festes Set, das Ihre Arbeitslast repräsentiert: kleiner Verpackungstext, ein Produkt, das seine Form durch eine Bearbeitung behalten muss, eine breite Komposition und eine kurze Animation. Bewerten Sie anhand einer schriftlichen Checkliste und vergleichen Sie Modelle dann nach Akzeptanz und p95-Latenz, nicht nach Screenshots.
11. Häufig gestellte Fragen
Sollte ich gpt-image-2.6-flare oder gpt-image-2.6-sunburst verwenden?
Nutzen Sie Flare für Exploration, Varianten und latenzkritische Entwürfe, vor allem bei quality=low. Nutzen Sie Sunburst für finales Detail und für Bearbeitungen, die den Rest des Bildes erhalten müssen, bei quality=medium oder high. Beide Modelle teilen die Token-Sätze; führen Sie einen kleinen Akzeptanztest durch, statt anzunehmen, dass das Modell mit höherer Qualität immer nötig ist.
Unterstützt die GPT-Image-2.6 API GIF und SVG für Bearbeitungen?
Nein. GIF und SVG sind Generierungsformate der GPT-Image-2.6 API; Bearbeitungen unterstützen keines von beiden. SVG ist statischer Vektor mit n=1 und ohne Streaming, Teilbilder, Kompression oder prompt_rewriter. Auch GIF gibt es nur in der Generierung. Bauen Sie getrennte Pfade, statt zu hoffen, dass eine Bearbeitung das Format ignoriert.
Was kostet ein Bild über die GPT-Image-2.6 API?
Es gibt keinen offiziellen festen Preis pro Bild. Bildausgabe kostet $30 pro 1M Tokens, Bildeingabe $8 pro 1M ($2 gecacht) und Texteingabe $5 pro 1M ($1.25 gecacht). Schätzen Sie mit Ihren gemessenen Token-Zahlen und teilen Sie die Gesamtausgaben durch die akzeptierten Bilder. Verwenden Sie für ein 2.6-Budget keine Preise pro Bild aus 2.5.
Warum widerspricht sich die Dokumentation zur GPT-Image-2.6 API?
Leitfaden und API-Referenz sind nicht vollständig synchron. frame_count erscheint sowohl als 2-64 als auch als 2-16; Markup ist in der Referenz nur für 2.5 dokumentiert, im Leitfaden für 2.5/2.6; einige Qualitäts- und Größentabellen hinken hinterher. Behandeln Sie das als versionsspezifische Grenzwerte, testen Sie in Ihrem Konto und notieren Sie Datum und Ergebnis der Prüfung.
12. Starten Sie mit drei Aufrufen, nicht mit einer Migration
Bewerten Sie die GPT-Image-2.6 API mit einem kontrollierten Batch: ein Flare-Entwurf low/low, ein Sunburst-Finalbild high/high und eine Formatanfrage, die zu Ihrem Produkt passt. Protokollieren Sie Tokens, Latenz und Akzeptanz und entscheiden Sie dann, was einen Platz in der Pipeline verdient.
Erstellen Sie ein ToAPIs-Konto, prüfen Sie den GPT-Image-2.6 Modell-Leitfaden für den aktuellen Zugang und bestätigen Sie die Sätze auf der Preisseite. Wenn Sie noch auf der vorigen Generation sind, lesen Sie zuerst den GPT Image 2 API-Leitfaden und migrieren Sie dann einen Endpunkt nach dem anderen, statt die gesamte Pipeline neu zu schreiben.