








1. Was Gemini Omni 1.2 Flash zusätzlich bietet
Google Cloud listet gemini-omni-1.2-flash als allgemein verfügbares multimodales Modell für Video-, Bild- und Textaufgaben. Die dokumentierte Fähigkeitsmatrix umfasst Text zu Video, Bild zu Video, Referenz zu Video, Video mit Start- und Endbild, Videobearbeitung, Videoverlängerung und Video-Upscaling. Außerdem ist Thinking gelistet, nicht aber Systemanweisungen, strukturierte Ausgabe, Function Calling oder die Gemini Live API für dieses Modell.
Die Modellseite dokumentiert Videoausgabe von 3 bis 15 Sekunden für Generierung und Bearbeitung, 3 bis 10 Sekunden für die Generierung mit Start- und Endbild und 3 bis 10 Sekunden angehängter Dauer für die Verlängerung. Unterstützte Seitenverhältnisse sind 16:9 und 9:16; dokumentierte Ausgabeauflösungen sind 360p, 720p, 1080p und 4k. Die Grenzen für Eingabevideos hängen vom Vorgang ab: Bearbeitung und Upscaling akzeptieren bis 15 Sekunden, während die Verlängerung das Ende einer längeren Quelle nach eigenem Vertrag nutzt.
| Fähigkeit | Was die primäre Dokumentation sagt | Integrationsfrage |
|---|---|---|
| Text zu Video | Prompt-gesteuertes Video, 3–15 Sekunden | Welche Auflösungs- und Audiofelder exponiert der gewählte Anbieter? |
| Bild oder Referenz zu Video | Bild- und Video-Referenzen mit routenspezifischen Grenzen | Haben Bildreihenfolge und Referenznamen semantische Bedeutung? |
| Start- und Endbild | Unterstützt, mit 3–10 Sekunden Ausgabe | Ist das zweite Bild ein Endbild oder eine weitere Referenz? |
| Videobearbeitung | Ein Quellvideo bis 15 Sekunden bearbeiten | Folgen Dauer und Seitenverhältnis der Quelle? |
| Videoverlängerung | 3–10 Sekunden nach einem Verlängerungsvertrag hinzufügen | Ist duration die angehängte Länge oder die gesamte Ausgabelänge? |
| Video-Upscaling | Unterstützte Quellauflösungen bis 4K hochskalieren | Wird diese Verbesserung getrennt von der Generierung abgerechnet? |
Die Launch-Ankündigungen betonen fünf praktische Verbesserungen gegenüber der vorherigen Generation: 15-Sekunden-Clips, einen niedrigeren veröffentlichten 720p-Preis, stärkere Treue zu Bild- und Video-Referenzen, Entwurfsgenerierung in niedrigerer Auflösung mit anschließendem Upscaling auf 1080p oder 4K sowie natürlicheren Dialog mit klarerem Lip-Sync und Bedingungen mit mehreren Sprechenden. Google beschreibt außerdem konversationelle Bearbeitung, etwa den Austausch eines Produkts, der Beleuchtung oder des Kamerawinkels, ohne von vorn zu beginnen.
Das sind Aussagen auf Produktebene, nicht das Versprechen, dass jeder Anbieter jeden Regler exponiert. Ein Anbieter kann eine Modellfamilie in getrennte Slugs aufteilen, eine Fähigkeit weglassen oder eine andere Abrechnungsebene ergänzen. Behandeln Sie immer das exakte Routenschema als Integrationsvertrag.
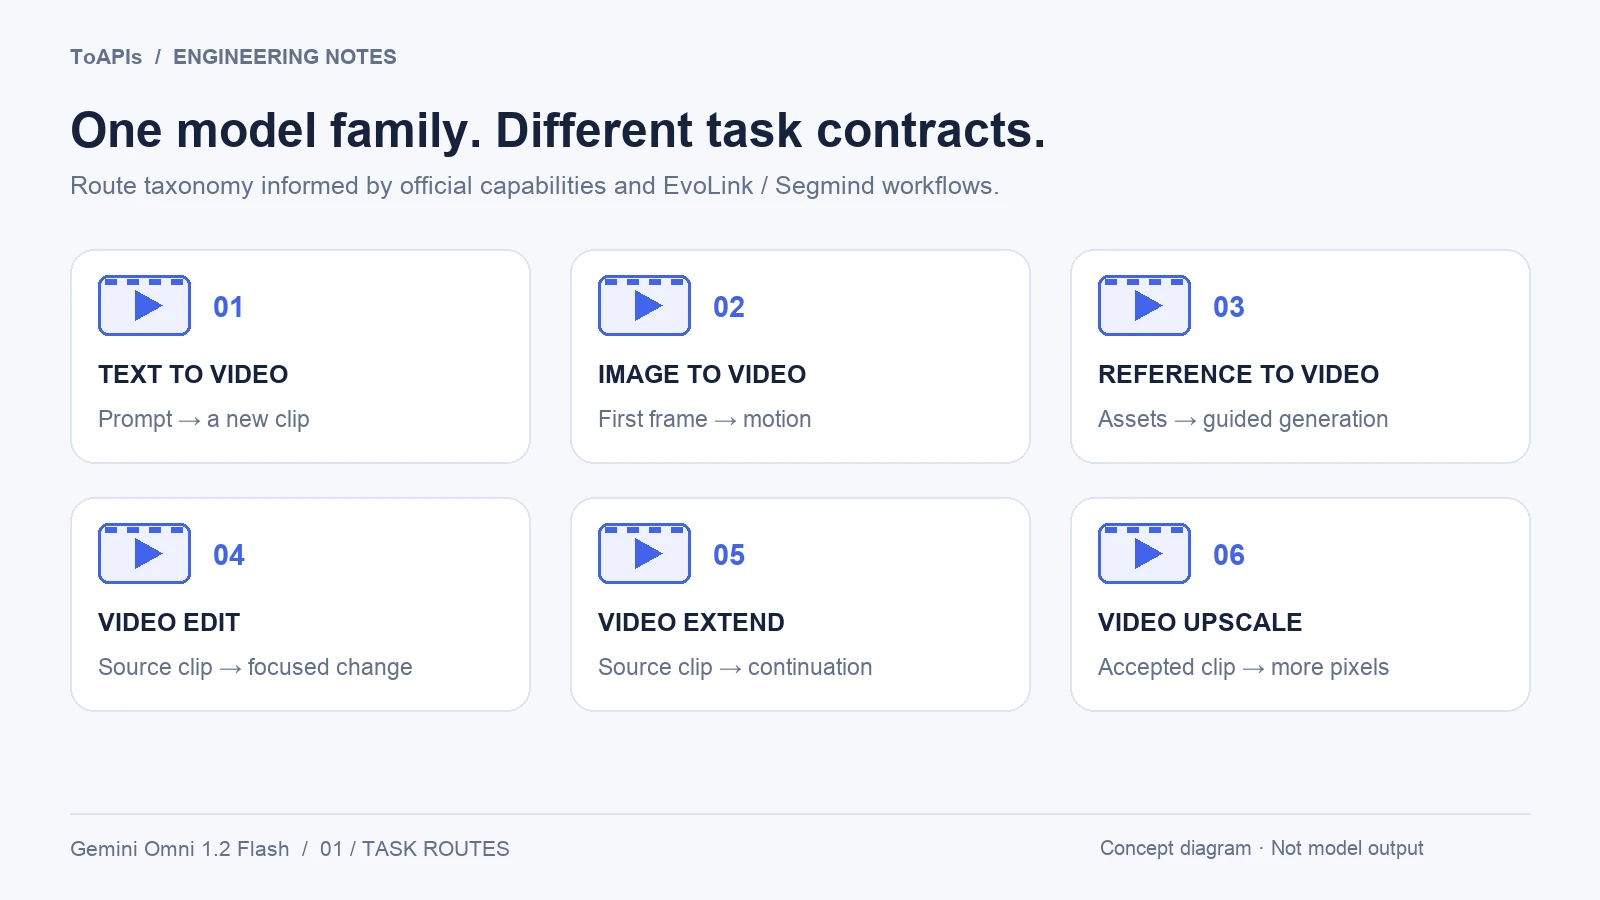
Eigene Aufgabenkarten-Illustration auf Basis der offiziellen Fähigkeitsliste und Beschreibungen von Drittanbieter-Routen. Tatsächliche Endpunkte variieren je Anbieter; dies ist keine Modellausgabe.
2. Sechs Routen, sechs verschiedene Verträge
Einige Video-Gateways von Drittanbietern präsentieren sechs Aufgabenrouten auf einer asynchronen Videoschnittstelle: Text zu Video, Bild zu Video, Referenz zu Video, Videobearbeitung, Videoverlängerung und Video-Upscaling. Ihre Modell-IDs helfen beim Verständnis der Routenplanung, sind aber anbieterspezifische Kennungen und keine bestätigten ToAPIs Kennungen.
Unabhängige Testergebnisse liefern ebenfalls eine routenorientierte Sicht und merken ausdrücklich an, dass bestimmte Routen wie refine in Launch-Tests nicht verfügbar waren. Das ist ein gutes Beispiel dafür, warum eine attraktive Fähigkeitsliste nicht ohne Live-Schema-Prüfung in ein Produktformular kopiert werden sollte.
| Route | Typische Eingabe | Zentrale Grenze zur Validierung |
|---|---|---|
| Text zu Video | Prompt | 3–15 Sekunden; Auflösung, Seitenverhältnis, Audio und Seed können anbieterspezifisch sein |
| Bild zu Video | Erstes Bild und Prompt | Ein zweites Bild kann ein Endbild definieren; bestätigen Sie die maximale Dauer |
| Referenz zu Video | Referenzbilder oder -videos plus Prompt | Anzahl, Dauer und Benennungsregeln für Referenzen unterscheiden sich |
| Videobearbeitung | Quellvideo plus eine fokussierte Änderung | Länge der Quelle, Sicherheitsfilter und ob die Ausgabe der Bildkomposition der Quelle folgt |
| Videoverlängerung | Bestehendes Video plus Fortsetzungsprompt | Hinzugefügte Dauer ist nicht unbedingt die Gesamtdauer |
| Video-Upscaling | Bestehendes Video, meist ohne Prompt | Akzeptierte Quellgrößen, Ausgabestufen und getrennte Abrechnung |
Ein Routenselektor sollte seine Validierungsregeln, Hilfetexte und Kostenvorschau gemeinsam ändern. Lassen Sie nicht zu, dass ein generisches duration-Feld stillschweigend die Bedeutung einer Verlängerungsroute in eine Generierungsroute überträgt. Gehen Sie nicht davon aus, dass ein Feld namens image_urls bei Anfragen für Bild zu Video und Referenz zu Video dasselbe bedeutet.
Google Cloud und Gemini API Grenzen nicht vermischen
Der Gemini API Leitfaden dokumentiert bis zu sechs Referenzbilder, während die Google Cloud Modellseite bis zu zehn Bilder pro Prompt listet. Die Gemini API wendet außerdem Grenzen für Video-Referenzen an, die von der angeforderten Dauer abhängen: Eine längere Generierung von 11–15 Sekunden unterstützt ein kurzes Referenzvideo, nicht dasselbe Referenzbudget wie eine Aufgabe von 3–10 Sekunden. Das sind getrennte Plattformverträge, keine widersprüchlichen Werte, die man mitteln oder kombinieren sollte.
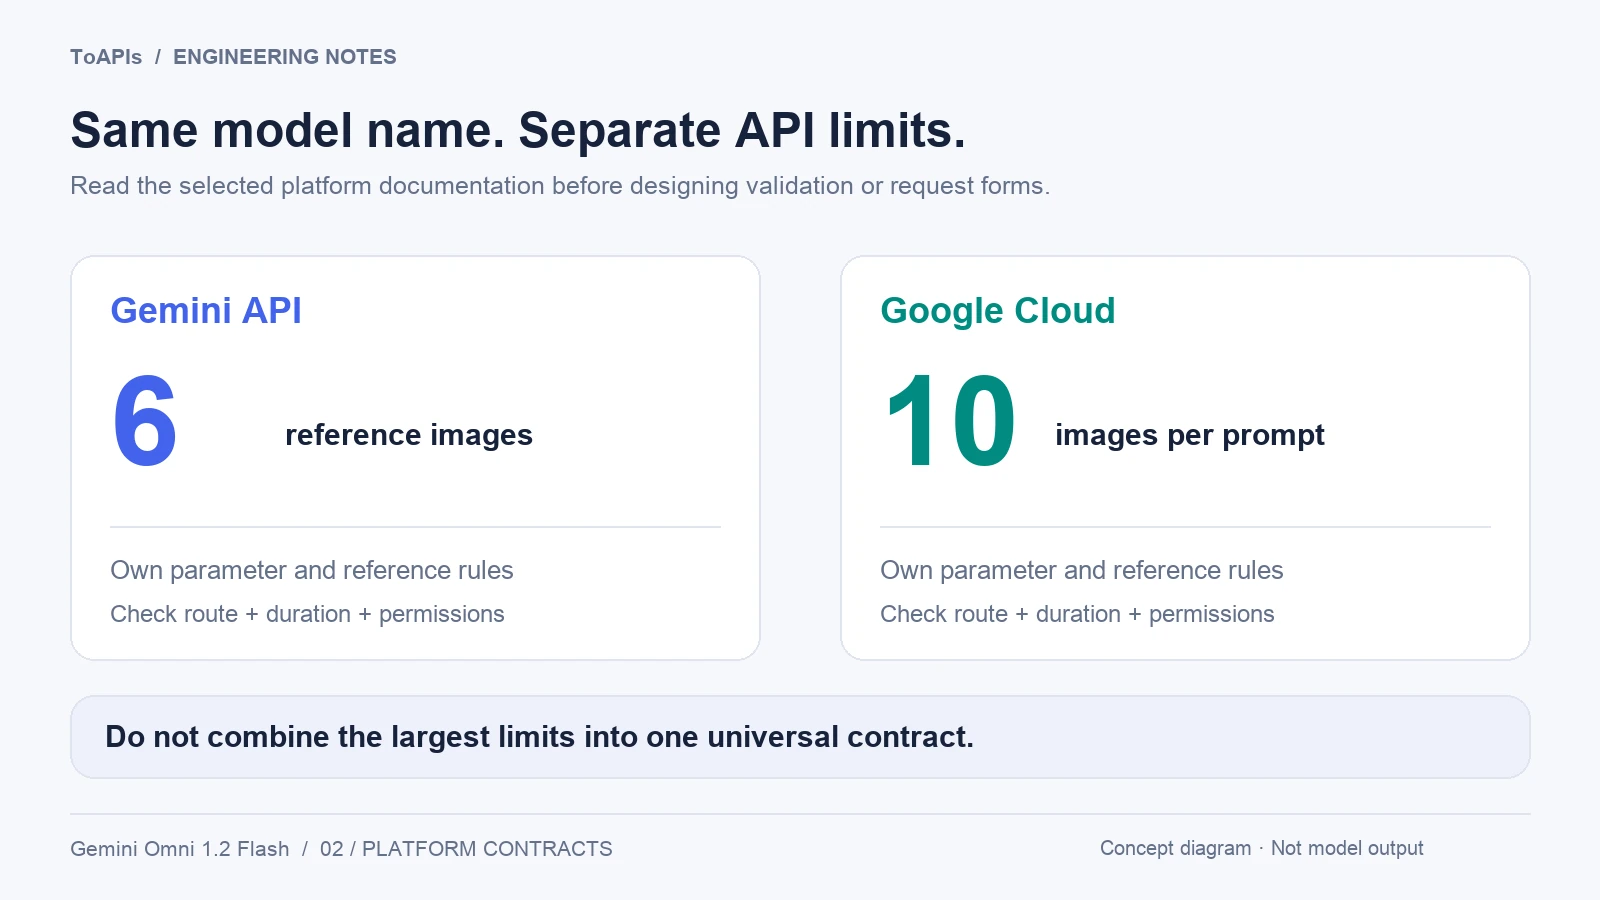
Getrennte Plattformverträge: sechs Referenzbilder in der Gemini API gegenüber zehn Bildern pro Prompt in der Cloud-Dokumentation. Diese Maxima lassen sich nicht kombinieren; prüfen Sie die gewählte Route und Dauer.
Für die Gemini API nutzt die dokumentierte Integration die Interactions API, nicht generate_content, keinen OpenAI Chat-Completions-Aufruf und keine Veo-spezifische Methode generate_videos. Das folgende Beispiel ist ein angepasster, kostenpflichtiger Aufruf und keine ToAPIs Anfrage. Es erfordert ein aktuelles google-genai SDK, ein berechtigtes Konto und einen lokal konfigurierten Schlüssel; legen Sie niemals Zugangsdaten in einem Prompt oder einem Browser-Bundle ab. Es wurde für diesen Artikel nicht ausgeführt.
import base64
from pathlib import Path
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input=(
        "A blue ceramic cup on a neutral table. "
        "One continuous slow camera push-in. "
        "Soft room ambience, no speech, no text."
    ),
    response_format={
        "type": "video",
        "resolution": "360p",
        "duration": "5s",
        "aspect_ratio": "16:9",
    },
)
Path("omni-draft.mp4").write_bytes(
    base64.b64decode(interaction.output_video.data)
)
print("interaction ID:", interaction.id)
In dieser API ist duration ein String wie "5s", keine aus einem Gateway-Formular kopierte Ganzzahl; die Generierungssteuerung liegt unter response_format. Für größere Dateien dokumentiert der Leitfaden URI-Auslieferung und die Behandlung der Dateibereitschaft. Mehrstufige Bearbeitungen verwenden previous_interaction_id; store=false entfernt den gespeicherten Zustand, den dieser Folgeworkflow benötigt. Prüfen Sie diese Kompromisse, statt Latenzeinstellungen blind zu kopieren.
3. Auflösungsstrategie: zuerst Entwurf, dann selektiv hochskalieren
Der Gemini API Leitfaden kennzeichnet 360p und 720p ausdrücklich als Generierungsstufen und 1080p und 4k als hochskalierte Ausgabe. Eine 4K-Auslieferungsoption belegt daher keine native 4K-Generierung. Der praktischste Workflow im Launch-Material trennt Exploration von Auslieferung. Verwenden Sie 360p oder 720p für Prompt-Iteration und Kompositionsprüfung. Wenn ein Clip die Abnahmeliste besteht, vergleichen Sie die Auswahl einer hochauflösenden Auslieferung in einer Generierungsanfrage mit dem separaten Upscaling eines bestehenden Clips. Bestätigen Sie, dass der Anbieter jeden Weg unterstützt; keiner von beiden impliziert native 4K-Generierung.
Diese Strategie reduziert verschwendete hochauflösende Generierungen, führt aber einen zweiten zu messenden Vorgang ein. Ein Upscaler kann Details ergänzen, ohne die zugrunde liegende Bewegung zu ändern oder eine schlechte Komposition zu reparieren. Er kann nicht garantieren, dass ein falsches Label, ein instabiles Gesicht oder eine falsche Objektbewegung in 4K korrekt wird.
Halten Sie Quellauflösung, Ausgabeauflösung, Route, Dauer und Tokenverbrauch im Job-Datensatz fest. Wo der Anbieter beide Wege unterstützt, vergleichen Sie die in einer Generierungsanfrage gewählte hochauflösende Auslieferung mit dem separaten Upscaling eines bestehenden Clips bei gleichen Eingaben, gleicher Bildkomposition und gleichen Abnahmekriterien. Keiner der Wege belegt native 4K-Generierung. Unabhängige Testergebnisse bemerkten nützliche Details durch Upscaling und behandelten es zugleich als kostenpflichtigen Workflowschritt, dessen Preis gemessen werden muss.
Definieren Sie für die Produktion zwei Tore:
- Ein kreatives Tor: Motividentität, Komposition, Bewegung, Text, Dialog und Ton entsprechen dem Briefing.
- Ein Auslieferungstor: Abmessungen, Dauer, Codec, Audiospur, Rechte und Dateiaufbewahrung entsprechen der nachgelagerten Anforderung.
Nur Clips, die beide Tore bestehen, sollten in die endgültige Asset-Bibliothek gelangen.
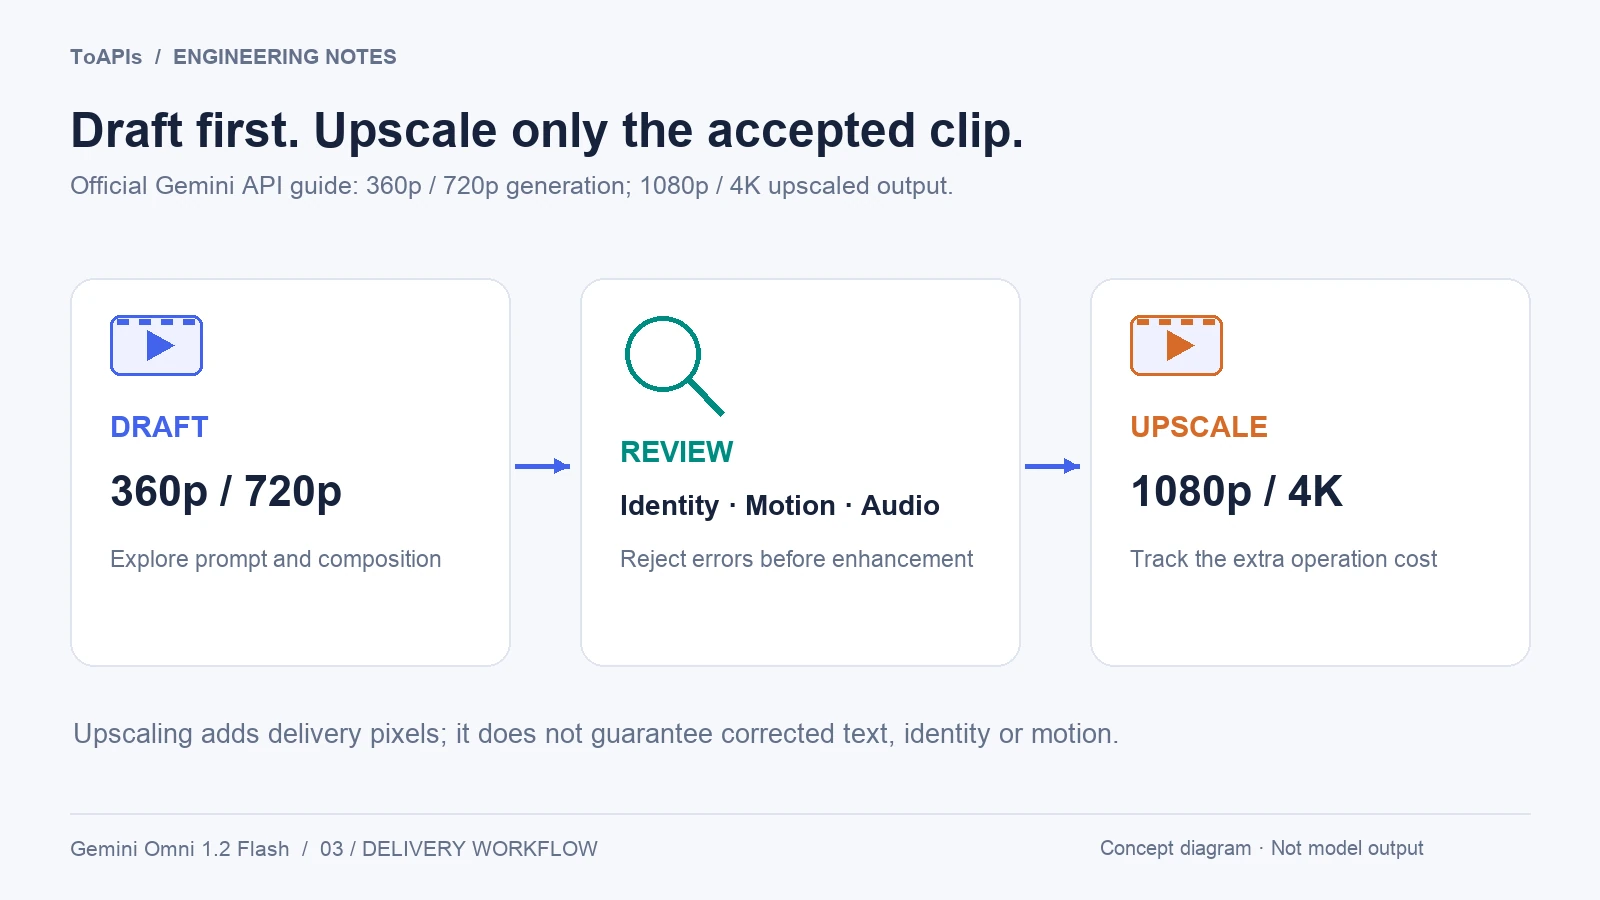
Konzeptioneller Workflow auf Basis des Gemini API Leitfadens. Höher aufgelöste Auslieferung nutzt Upscaling; sie garantiert keine korrigierte Bewegung, keinen korrigierten Text und keine korrigierte Identität.
4. Prompting für instruktionsgenaues Video
Tests von Drittanbietern sind für das Prompt-Design besonders wertvoll, wenn sie zeigen, was zu prüfen ist, nicht wenn sie zu allgemeinen Benchmark-Aussagen werden. Unabhängige Testergebnisse nennen starke Ergebnisse für beschriftete Erklärstücke, kinetische Typografie, Diagrammanimation aus einem gelieferten Endbild, stilisierte Motion Graphics und Einzeländerungs-Bearbeitungen von echtem Filmmaterial. Dieselben Berichte nennen schwächere Ergebnisse für fotorealistische Personen aus dem Nichts, Datenplots allein aus Zahlen und einige mehrstufige Bearbeitungen oder Änderungen an Markenlogos.
Ein robuster Omni-Prompt sollte trennen:
- das Motiv und seine sichtbare Identität;
- die geordneten Beats der Szene;
- Kamerabewegung und was fixiert bleiben muss;
- exakten Text im Bild, separat zitiert;
- Dialog, Musik und Soundeffekte;
- den Endzustand, möglichst mit einer Endbild-Eingabe fixiert, wenn die Route das unterstützt;
- eine zu erhaltende Änderung bei einer Bearbeitung sowie alles, was unverändert bleiben muss.
Zum Beispiel:
Create a flat 2D motion-graphics explainer in 16:9.
Show the title 'HOW A PRODUCT VIDEO API WORKS' exactly as written.
First show one product photo, then three labelled route cards from left to right,
then connect the cards to one finished video frame.
Keep every label fixed after it appears. Use a locked-off camera.
Add a short, calm voiceover and a soft click for each route card.
End on the complete diagram. Do not add any other text or logos.
Dieses Briefing ist ein vorgeschlagener Test, keine gemessene Omni-Ausgabe. Die Abnahmeregeln sind nützlicher als Adjektive wie „cinematisch“ oder „viral“: jedes Label muss übereinstimmen, die Reihenfolge muss stimmen, die Kamera muss fixiert bleiben und das Audio darf nur die angeforderten Signale enthalten.
5. Natives Audio, Referenzen und Bearbeitung
Die offizielle Dokumentation listet Sprache, Musik und Soundeffekte als unterstützt, während Googles Launch-Beitrag natürlicheren Dialog, klareren Lip-Sync und deutliche Bedingungen mit mehreren Sprechenden hervorhebt. Die Google Cloud Ankündigung merkt außerdem an, dass Audio-Referenzen hinter einer Allowlist liegen. Audio benötigt daher eine eigene Fähigkeits- und Berechtigungsprüfung, nicht nur ein Kontrollkästchen in einem generischen Videoformular.
Referenztreue ist eines der Hauptthemen des Modells. Google beschreibt stärkere Treue zu Bild- und Video-Referenzen, und die offizielle Modellseite unterstützt referenzbasierte Generierung. Referenzunterstützung ist dennoch keine Identitätsgarantie. Prüfen Sie Gesicht, Kleidung, Produktsilhouette, sichtbare Markierungen, Beleuchtung und Bewegung über den gesamten Clip.
Konversationelle Bearbeitung ist ebenfalls ein Workflow-Konzept, nicht unbedingt ein einziger universeller Endpunkt. Das Launch-Material beschreibt das Ändern eines Produkts, der Beleuchtung oder des Kamerawinkels im selben Clip. Ein Anbieter kann das als Videobearbeitung, als Interaktions-ID, als Referenz auf eine frühere Aufgabe oder mit einem anderen Request-Body umsetzen. Bestätigen Sie den Vertrag, bevor Sie Annahmen in Ihrer Datenbank speichern.
Erfassen Sie für jede Bearbeitung:
- das Quellvideo und seine Rechte;
- die exakte Einzeländerungs-Anweisung;
- was unverändert bleiben muss;
- Route und Modell-ID;
- die zurückgegebene Task- oder Interaktions-ID;
- Audio- und Sicherheitsprüfungsergebnisse.
So wird eine fehlgeschlagene Bearbeitung diagnostizierbar und eine erfolgreiche Bearbeitung ausreichend reproduzierbar für die Review.
6. Token-Preise sind nicht dasselbe wie ein ToAPIs Angebot
Googles Launch-Materialien veröffentlichen einen Anbieterpreis für 720p-Video und beschreiben eine Senkung gegenüber dem Vormodell. Einige Video-Gateways von Drittanbietern präsentieren eigene tokenbasierte Rechner, Rabatte und routenspezifische Preise, während Preisanalysen von Drittanbietern Schätzungen pro Sekunde für 720p aus Tokenannahmen ableiten oder den Launch um einen veröffentlichten Sekundenpreis herum einordnen. Diese Zahlen sind nicht austauschbar.
Die Gemini API Standard-Preistabelle, geprüft am 6. November 2026, listet 1,50 USD pro Million Eingabetokens für Text, Bilder und Video; 9,00 USD pro Million Text-Ausgabetokens einschließlich Thinking; und 12,00 USD pro Million Video-Ausgabetokens. Für dieses Modell gibt es keine kostenlose Stufe. Das sind Anbieterlistenpreise für diese Plattform, kein ToAPIs Angebot.
Dieselbe Preisseite listet 5.792 Video-Ausgabetokens pro Sekunde bei 720p. Ein 15-sekündiger 720p-Clip hat damit eine illustrative Videoausgabe-Komponente von 15 × 5.792 × 12 / 1.000.000 = USD 1,04256, vor Eingabe- und Text-/Thinking-Ausgabegebühren. Das erklärt die gerundete Launch-Schlagzeile von etwa 0,07 USD pro Sekunde, ohne daraus eine feste All-in-Gebühr zu machen. Preise, Tokenregeln und Gateway-Aufschläge können sich ändern.
Ein Produktionskostenmodell sollte identifizieren:
| Kostendimension | Was zu erhalten ist |
|---|---|
| Anbieter oder Gateway | Der exakte Anbieter, die Modell-ID und das Datum |
| Abrechnungseinheit | Sekunden, Video-Ausgabetokens, Eingabetokens, Thinking-Tokens oder ein Paket |
| Auflösungsmultiplikator | In der Generierung gewählte hochauflösende Auslieferung gegenüber separat angefragtem Upscaling; prüfen Sie Anbieterunterstützung und Abrechnung |
| Eingabemedien | Bilder, Quellvideos und ihre abrechenbaren Tokenregeln |
| Wiederholungs- und Ablehnungsrichtlinie | Ob Sicherheits-, Validierungs- oder Transportfehler berechnet werden |
| Abnahmeausbeute (Bestandsrate) | Clips, die die Auslieferungsliste bestehen, geteilt durch alle Versuche |
Schreiben Sie für einen hypothetischen Tokenplan die Formel, statt das Angebot eines Wettbewerbers zu kopieren:
raw generation cost = input token cost
                    + text and thinking output token cost
                    + video output token cost
workflow cost = sum of all generation attempts
              + separately billed upscaling
              + storage, transfer and review cost
cost per accepted clip = workflow cost / accepted clips
Zählen Sie einen Posten nicht doppelt, wenn er bereits in der Rechnung enthalten ist; ist accepted clips 0, ist der Preis pro akzeptiertem Clip undefiniert und muss separat ausgewiesen werden.
Veröffentlichen Sie keinen ToAPIs Preis, bis der aktuelle Katalog oder der Quote-Endpunkt Modell, SKU, Einheit und kontospezifische Rate bestätigt. Behaupten Sie nicht, dass eine von Dritten gemessene Latenz oder Kostengröße für ein anderes Gateway gilt.
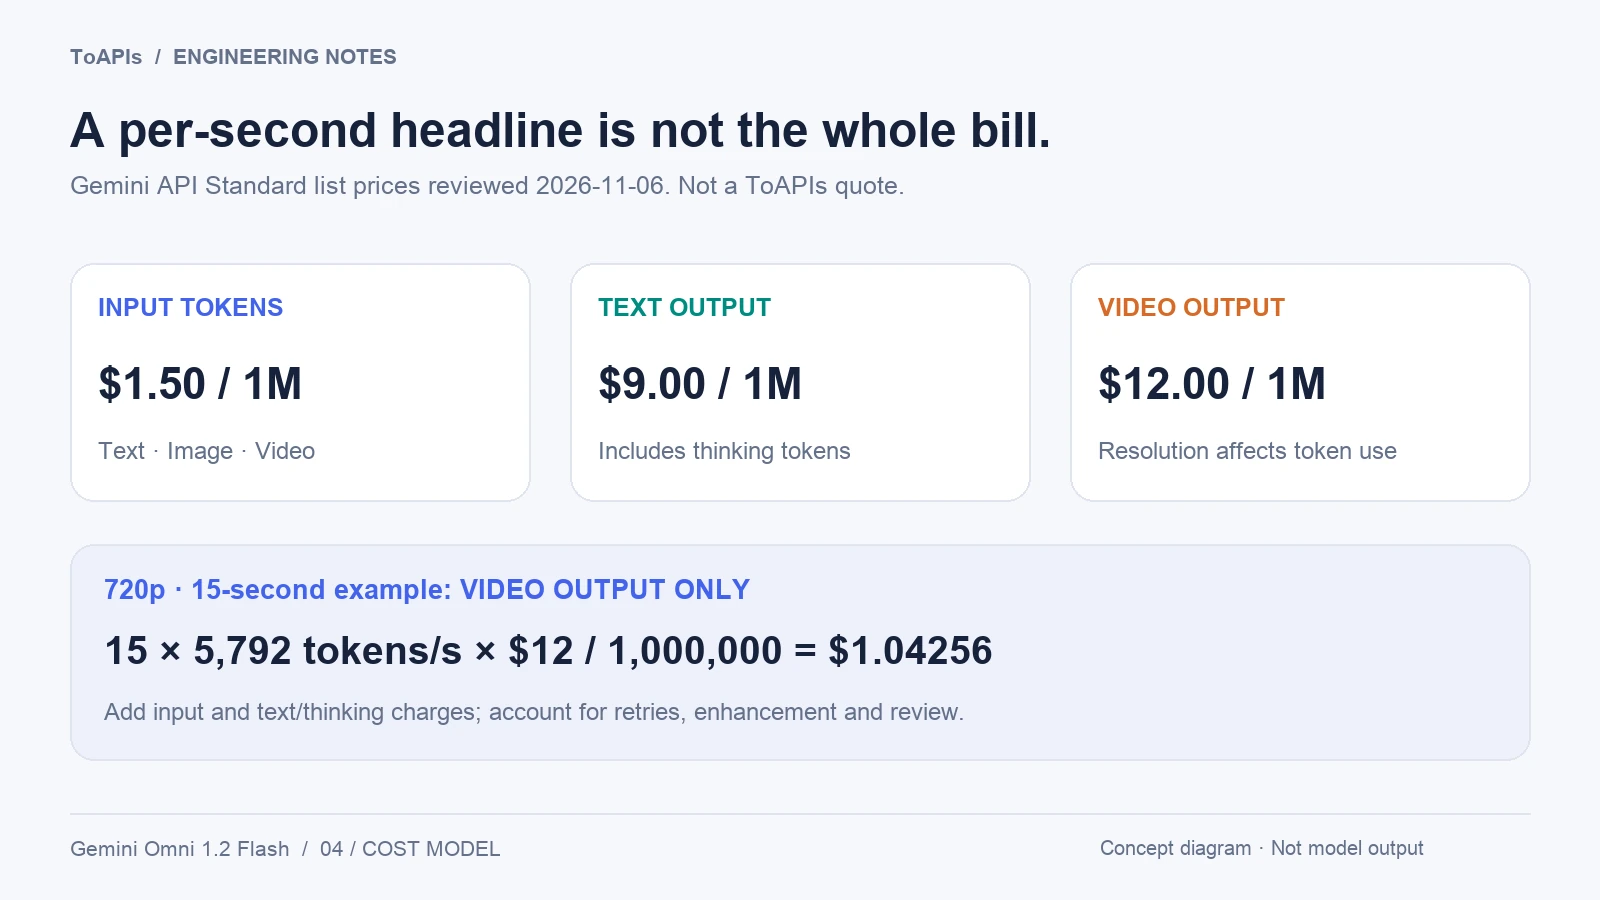
Illustration mit Anbieterlistenpreisen, geprüft am 6. November 2026, kein ToAPIs Angebot. Die 1,04256 USD decken in diesem Beispiel nur die Videoausgabe; Eingabe- sowie Text- und Thinking-Gebühren kommen hinzu.
7. Bauen Sie vor der Produktion ein Abnahmepaket
Bevor Sie dieses Modell in einer Anwendung aktivieren, führen Sie ein kleines, wiederholbares Paket aus:
- Text zu Video: ein beschriftetes Erklärstück mit geordneten Beats und expliziten Audio-Signalen.
- Bild zu Video: ein Produkt-Startbild mit einem geforderten Endzustand.
- Referenz zu Video: ein Motiv über mehrere Ansichten, mit einer Kontinuitätscheckliste.
- Videobearbeitung: eine Änderung an einem echten Clip unter Beibehaltung der Darstellung.
- Videoverlängerung: eine Einstellung, deren Kamerarichtung und Ton sich natürlich fortsetzen sollen.
- Hochauflösende Auslieferung: wenn der Anbieter beide Wege unterstützt, vergleichen Sie die Auswahl einer hochauflösenden Auslieferung in einer Generierungsanfrage mit dem separaten Upscaling eines bereits akzeptierten Entwurfs; keiner von beiden impliziert native 4K-Generierung.
Erfassen Sie für jeden Test Modell-ID, Route, Eingaben, Prompt, Seed falls unterstützt, Auflösung, Dauer, Task-ID, Wartezeit in der Warteschlange, Verarbeitungszeit, Ausgabe-Token- oder Abrechnungsdaten, Audioergebnis und Abnahmeurteil. Behalten Sie Fehlschläge, statt nur die besten Beispiele auszuwählen.
Behandeln Sie Bewertungen von Drittanbietern als Hypothesen. Eine unabhängige Review mit 20 Tests ist wertvoll, wenn sie sowohl Stärken als auch Fehlschläge nennt, aber ihre abgerechneten Preise, Latenz und Anbieterverhalten gehören zu dieser konkreten Testumgebung. Sie ist kein unabhängiger Benchmark jeder Gemini Omni 1.2 Flash Integration.
8. Checkliste für Verfügbarkeit und Integration
Die offizielle Google Modell-ID ist gemini-omni-1.2-flash, aber eine Modell-ID allein bedeutet nicht, dass ein Gateway sie aktiviert hat. Prüfen Sie vor der Integration über ToAPIs den Modellkatalog, die aktuellen Preise und die Request-Dokumentation. Bestätigen Sie die exakte Route, das Kontorecht, den Request-Body, das asynchrone Statusmodell, die Aufbewahrungsfrist für Ergebnisse und die Abrechnungsrichtlinie.
Wenn die Route fehlt oder das Angebot nicht verfügbar ist, lassen Sie die Funktion deaktiviert oder kennzeichnen Sie sie als in Kürze verfügbar. Ordnen Sie nicht stillschweigend ein anderes Gemini Modell demselben Marketingnamen zu. Melden Sie keine echte Generierung, solange nicht ein authentifizierter Aufruf erfolgreich war und die zurückgegebenen Medien geprüft wurden.
Quellen und Aktualisierungsrichtlinie
- Google: Gemini Omni 1.2 Flash, 15-Sekunden-Video und niedrigere Preise — offizielle Launch-Ankündigung, 5. November 2026.
- Google Cloud: Gemini Omni 1.2 Flash jetzt GA — allgemeine Verfügbarkeit, Enterprise-Kontext und Launch-Aussagen.
- Google Cloud Modelldokumentation — Modell-ID, Fähigkeiten, Grenzen und Release-Status.
- Gemini API Omni-Leitfaden — Interactions API, plattformspezifische Referenzen, hochskalierte Auflösungsstufen und Bearbeitungszustand.
- Gemini API Preise — Standard-Tokenraten und Umrechnung von Video-Tokens; ein Anbieterpreis, kein ToAPIs Angebot.
Wenn Sie diesen Leitfaden aktualisieren, erfassen Sie Anbieter, Modell-ID, Quell-URL und Prüfdatum für jede geänderte Fähigkeit oder jeden geänderten Preis. Halten Sie Anbieterpreise, Gateway-Angebote und Tests von Drittanbietern getrennt. Dieser Leitfaden behauptet keine ToAPIs Verfügbarkeit, keine authentifizierte Generierung, keinen allgemeinen Benchmark und kein garantiertes Produktionsergebnis.