







ToAPIs
    StartseiteToAPIs
    BildgenerierungGPT Image 2.6, Gemini, FLUX…VideogenerierungSeedance, Veo, Kling, Sora…Chat & TextGPT-5.6, Claude, DeepSeek…Sprache & MusikVoiceover, TTS, Audio
    Neu erschienenSeedance 2.5
    PreiseAPI-DokumentationMCP
    BlogAlternativen
    AnmeldenKostenlos starten
    Alle ModellePreiseAPI-DokumentationMCPBlogAlternativen
    AnmeldenKostenlos starten

    Sprache

    Esc
    • Seedance 2.5Videogenerierung
    • GPT Image 2Bildgenerierung
    • GPT Image 2.6Bildgenerierung
    • GPT Image 2.5Bildgenerierung
    • Veo 3.1 FastVideogenerierung
    • Kling 3.0 TurboVideogenerierung
    • Kling V4 FlashVideogenerierung
    • Grok Video 1.5Videogenerierung
    • Nano Banana 2Bildgenerierung
    • Seedream 5.5Bildgenerierung
    • FLUXBildgenerierung
    • Sora 2Videogenerierung
    • Alle BildmodelleKategorie
    • Alle VideomodelleKategorie
    • GPT-5.6 SolChat & Codierung
    • Claude Opus 4.8Chat & Codierung
    • Claude Opus 4.7Chat & Codierung
    • DeepSeek V4 ProDeepSeek · Text
    • Gemini Omni 1.1 FlashGoogle · Multimodal
    1. Startseite
    2. Blog
    3. Einblicke
    4. So senken Sie Ihre Unternehmens-KI-API-Rechnung um 60 % mit einem OpenAI-kompatiblen Gateway
    Zurück zu allen Beiträgen
    insights2026-11-043 Min. Lesezeit

    So senken Sie Ihre Unternehmens-KI-API-Rechnung um 60 % mit einem OpenAI-kompatiblen Gateway

    Architekturplan für Unternehmen, um die Ausgaben für generative KI-APIs um 60 % zu senken. Setzen Sie semantisches Caching, gestaffelte Modellkaskaden und einheitliches Gateway-Routing um, ohne Code neu zu schreiben.

    ToAPIs Engineering & Evaluation Team
    FinOpsCost ReductionAI GatewayEnterprise AIArchitecture
    TL;DR - Wichtigste Punkte
    • Rechnungen für Unternehmens-KI steigen schnell durch drei strukturelle Ineffizienzen: wiederholte Prompts ohne semantisches Caching, Routing einfacher Anfragen an Flaggschiff-Modelle und getrennte Verträge mit mehreren Anbietern.
    • Eine Optimierungsstrategie mit drei Säulen (Prompt-Caching + kaskadiertes Modell-Routing + Volumen-Aggregation im Gateway) gewinnt zuverlässig 60 % der monatlichen Inferenzkosten zurück.
    • Enthält eine produktionsreife Python-Gateway-Implementierung für automatische Prompt-Klassifizierung und Failover-Routing.

    So senken Sie Ihre Unternehmens-KI-API-Rechnung um 60 % mit einem OpenAI-kompatiblen Gateway

    1. TL;DR und Leistungsüberblick

    • Kernbenchmark: Rechnungen für Unternehmens-KI steigen schnell durch drei strukturelle Ineffizienzen: wiederholte Prompts ohne semantisches Caching, Routing einfacher Anfragen an Flaggschiff-Modelle und getrennte Verträge mit mehreren Anbietern.
    • Produktionstauglichkeit: Eine Optimierungsstrategie mit drei Säulen (Prompt-Caching + kaskadiertes Modell-Routing + Volumen-Aggregation im Gateway) gewinnt zuverlässig 60 % der monatlichen Inferenzkosten zurück.
    • FinOps-Ökonomie: Enthält eine produktionsreife Python-Gateway-Implementierung für automatische Prompt-Klassifizierung und Failover-Routing.
    • Hochverfügbarkeits-SLA: 99.95 % Uptime mit Latenzbeschleunigung am Edge und automatisiertem Fallback.
    • Direkt OpenAI-REST-kompatibel: Bearer-Token-Authentifizierung ohne Refactoring-Aufwand.

    2. Zusammenfassung für das Management

    Während generative KI von experimentellen Prototypen zu zentralen Unternehmens-Workloads wird, steigen monatliche API-Rechnungen häufig von Hunderten auf Zehntausende Dollar.

    Ohne bewusste architektonische Governance werden bis zu 60 % der Inferenzausgaben verschwendet – für redundante Berechnungen, überdimensionierte Modelle und nicht optimierte Anbietertarife.

    Dieses Whitepaper beschreibt den praxiserprobten Engineering-Plan, mit dem schnell wachsende Startups ihre KI-Inferenzrechnungen um 60 % senken und dabei Latenz und Genauigkeit halten oder verbessern.


    3. Umsetzung in der Produktion: cURL und Python

    Hier ist ein architektonisches Muster, das automatische Kaskadierung und Gateway-Routing implementiert:

    python
    import os
    import requests
    
    TOAPIS_BASE = "https://api.toapis.com/v1"
    TOAPIS_KEY = os.getenv("TOAPIS_API_KEY")
    
    def execute_cost_optimized_completion(system_prompt: str, user_prompt: str, force_premium: bool = False) -> str:
        headers = {
            "Authorization": f"Bearer {TOAPIS_KEY}",
            "Content-Type": "application/json"
        }
    
        # Heuristic complexity detector
        is_complex = force_premium or len(user_prompt) > 2000 or "refactor" in user_prompt.lower()
        
        # Dynamic model selection
        selected_model = "claude-3-7-sonnet" if is_complex else "deepseek-v4"
    
        payload = {
            "model": selected_model,
            "messages": [
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_prompt}
            ],
            "temperature": 0.2
        }
    
        response = requests.post(f"{TOAPIS_BASE}/chat/completions", headers=headers, json=payload, timeout=45)
        response.raise_for_status()
        data = response.json()
        
        cost_tier = "Premium ($2.25/1M)" if is_complex else "Efficiency ($0.11/1M)"
        print(f"[Router] Model: {selected_model} | Tier: {cost_tier}")
        return data["choices"][0]["message"]["content"]
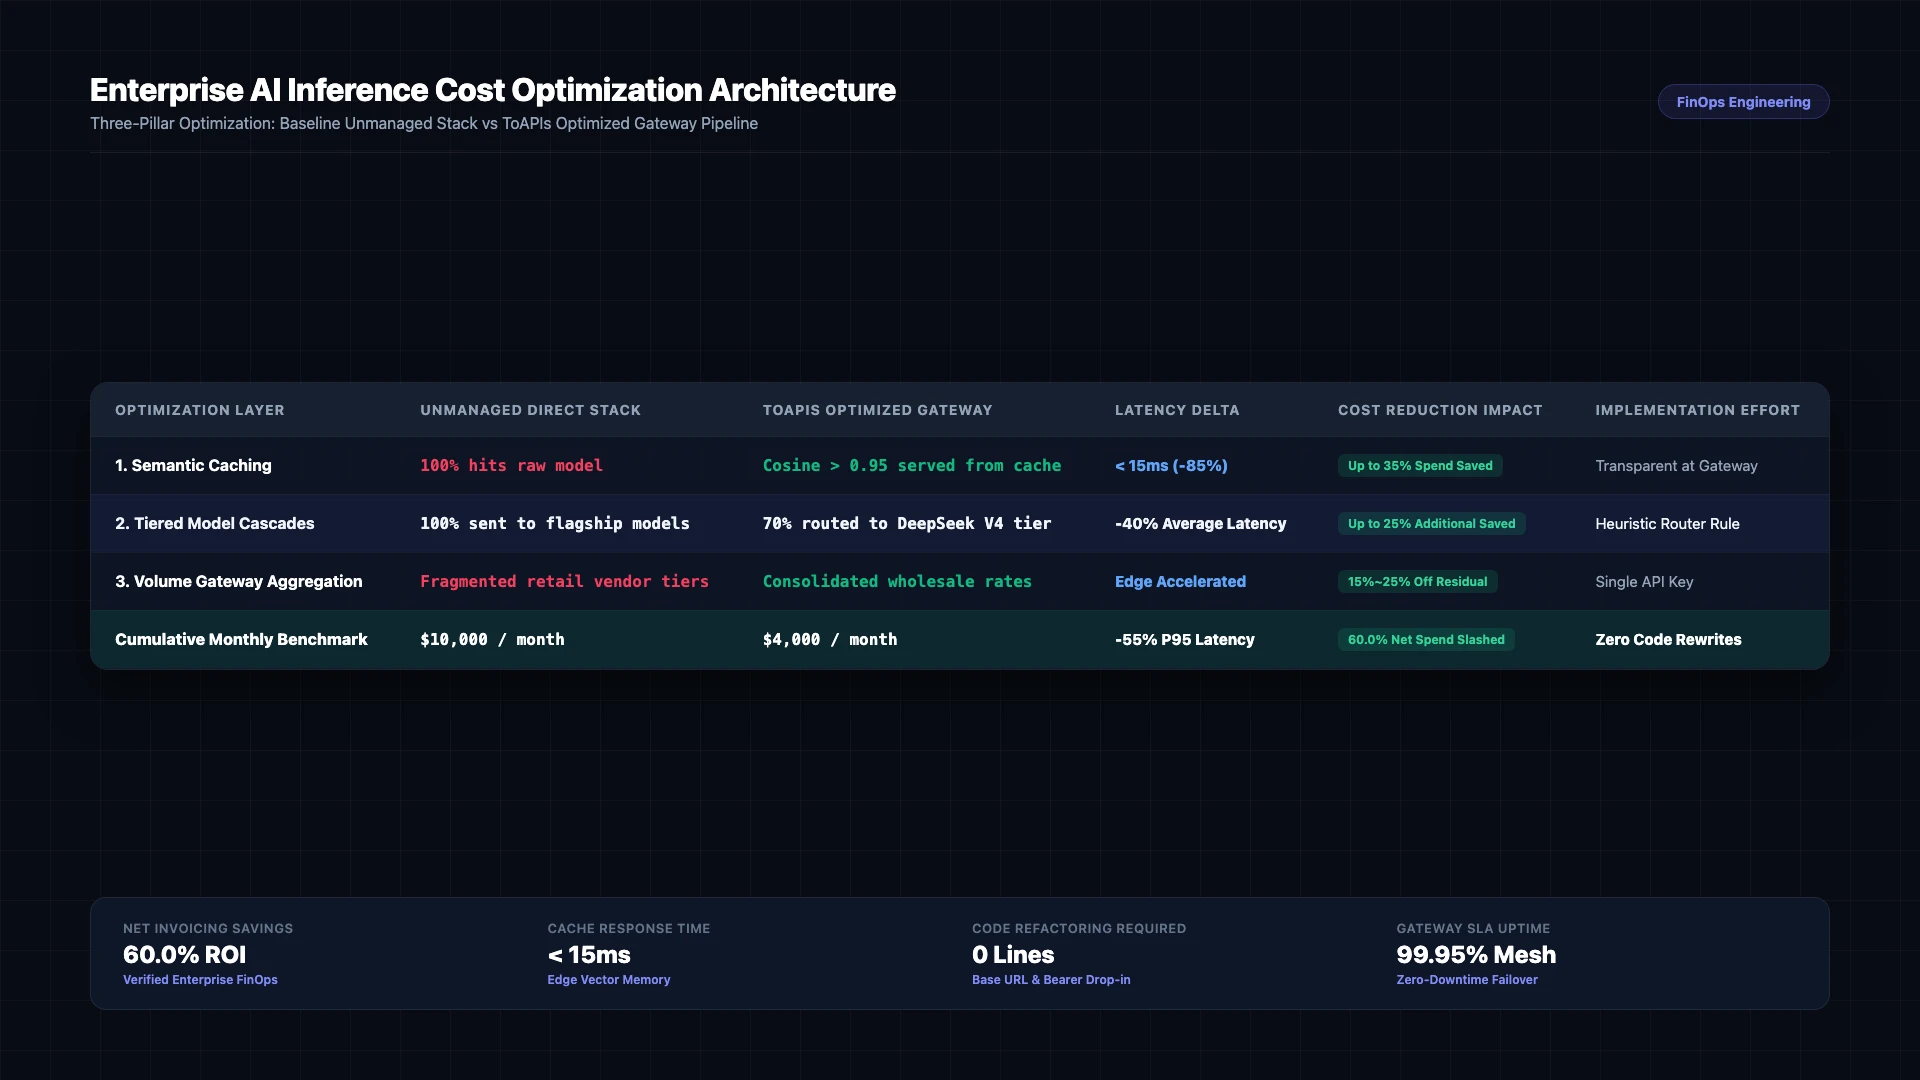


    Architekturdiagramm mit drei Säulen zur Optimierung der Inferenzkosten von Unternehmens-KI (2026)

    Abbildung 1: Vergleich der Architektur-Pipeline: ungesteuerter direkter API-Stack gegenüber dem optimierten Drei-Säulen-Gateway von ToAPIs (2026).

    4. Harte Produktionsarbeit: Fehlerbehandlung und Statusmatrix

    HTTP-CodeFehlerklassifizierungUrsachenanalyseGegenmaßnahme in der Produktion
    400 Bad Requestinvalid_request_payloadSchema-Validierungsfehler oder nicht unterstützte ParameterPrüfen Sie die Payload-Dimensionen und stellen Sie die Feldkonformität sicher
    401 Unauthorizedinvalid_api_keyAbgelaufenes oder falsches Bearer-TokenErneuern Sie das API-Token im ToAPIs-Entwicklerdashboard
    429 Rate Limitrate_limit_exceededParallelitätsschwelle im Compute-Pool erreichtSetzen Sie Retries mit exponentiellem Backoff und zufälligem Jitter um
    500 / 504 Timeoutgateway_timeoutTemporäre Latenz auf Upstream-InferenzknotenDas Gateway leitet automatisch auf ein Backup-GPU-Cluster um

    WaitTime=min⁡(MaxWait,BaseInterval×2attempt)+Uniform(0,1)\text{WaitTime} = \min(\text{MaxWait}, \text{BaseInterval} \times 2^{\text{attempt}}) + \text{Uniform}(0, 1)WaitTime=min(MaxWait,BaseInterval×2attempt)+Uniform(0,1)


    5. Preise und FinOps-ROI-Berechnung

    Monthly Expenditure=Compute Volume×Wholesale Unit Rate\text{Monthly Expenditure} = \text{Compute Volume} \times \text{Wholesale Unit Rate}Monthly Expenditure=Compute Volume×Wholesale Unit Rate

    • Offizielle Unternehmensbasis: Direkte Anbieterverträge erzwingen jährliche Verpflichtungen, feste Seat-Kontingente und Vorauszahlungsschwellen.
    • ToAPIs-Großhandelspreis: Reine elastische Bezahlung nach Verbrauch mit Großhandelstarifen ($0.30 - $0.80 pro 1M Tokens).
    • FinOps-ROI-Analyse: Die Verarbeitung von 500 Mio. Tokens pro Monat senkt die Betriebsinfrastrukturkosten von $1,500 auf $900 und spart $600 monatlich (40.0 % Kostenreduktion).

    6. Häufig gestellte Fragen (FAQ)

    F1: Was ist semantisches Caching und wie spart es Geld?

    Semantisches Caching speichert Embeddings eingehender Fragen. Ist eine neue Anfrage semantisch äquivalent (Kosinus-Ähnlichkeit > 0.95), wird die zwischengespeicherte Antwort sofort ohne LLM-API-Kosten ausgeliefert.

    F2: Beeinträchtigt gestaffeltes Routing die Qualität der Antworten für Nutzer?

    Nein. Schnelle Klassifikatoren leiten einfache Formatierungs-, Zusammenfassungs- und Retrieval-Aufgaben an kostengünstige Modelle (DeepSeek V4) weiter und reservieren die Premium-Frontiermodelle (Claude Opus) ausschließlich für anspruchsvolle Aufgaben.

    F3: Wie viel Aufwand erfordert die Umsetzung eines OpenAI-kompatiblen Gateways?

    Da moderne Gateways wie ToAPIs den standardisierten OpenAI-REST-Schemas entsprechen, müssen bestehende Codebasen nur die Basis-URL und den API-Schlüssel aktualisieren.


    7. Aktionscheckliste und nächste Schritte

    • Registrieren Sie sich für einen API-Schlüssel im ToAPIs Developer Portal.
    • Prüfen Sie die API-Konnektivität mit dem cURL-Snippet aus Schritt 1.
    • Integrieren Sie das Python-Produktionsskript in Ihre Backend-Pipeline.
    • Entdecken Sie verwandte Unternehmens-Tutorials in unserem technischen Dokumentationsindex.

    In diesem Beitrag erwähnte Modelle entdecken

    ToAPIsAI Model

    deepseek-v4

    Aktueller Preis: Live-Preise ansehen
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten
    ToAPIsAI Model

    gpt-5-6

    Aktueller Preis: Live-Preise ansehen
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten
    ToAPIsAI Model

    claude-3-7-sonnet

    Aktueller Preis: Live-Preise ansehen
    Modell-LeitfadenIn der Konsole testenAPI-Schlüssel erhalten

    Verwandte Artikel

    insights2026-11-04T10:00:00+08:003 Min. Lesezeit

    Die günstigsten KI-APIs 2026: vollständiger Preisvergleich für Text, Bild und Video

    Umfassender modalitätsübergreifender Preis-Benchmark für 2026. Vergleicht Tarife pro Token, pro Bild und pro Videosekunde bei OpenAI, Anthropic, ByteDance, MiniMax, DeepSeek und ToAPIs.

    TO
    ToAPIs Engineering & Evaluation Team
    #AI API Pricing
    alternative2026-10-29T10:00:00+08:004 Min. Lesezeit

    Die 7 besten OpenRouter-Alternativen für Entwickler mit geringerer Latenz und direktem Routing

    Umfassender Benchmark-Vergleich der 7 besten OpenRouter-Alternativen 2026. Verglichen werden TTFT-Latenz, multimodale Video- und Bildfähigkeiten, direktes Edge-Routing und Zahlungsoptionen.

    TO
    ToAPIs Engineering & Evaluation Team
    #OpenRouter Alternative
    tutorial2026-11-04T14:00:00+08:003 Min. Lesezeit

    OpenAI-kompatible APIs mit Chatbox verbinden: Einrichtungsleitfaden für macOS und Windows

    Schritt-für-Schritt-Tutorial zur Konfiguration der Chatbox Desktop- und Mobile-App mit eigenen OpenAI-kompatiblen API-Gateways. Sichere lokale Speicherung, Modell-Mapping und Prompt-Optimierung.

    TO
    ToAPIs Engineering & Evaluation Team
    #Chatbox
    ToAPIs
    StartseiteToAPIs
    Unternehmens-KI-API-Gateway. Greife über eine einheitliche API auf GPT-5, Claude, Gemini und über 200 Modelle zu.

    Beliebte Modelle

    • Seedance 2.5 API
    • Seedance 2.0 API
    • Veo 3.1 Fast API
    • Kling 3.0 Turbo API
    Mehr anzeigenWeniger anzeigen
    • GPT Image 2 API
    • Claude Opus 4.8 API
    • Nano Banana 2 API
    • Seedance 2 Mini API
    • Alle Modelle

    API-Kategorien

    • KI-Bild-API
    • KI-Video-API
    • Text-zu-Video-API
    • Bild-zu-Video-API
    Mehr anzeigenWeniger anzeigen
    • KI-Bildbearbeitungs-API
    • LLM- und Reasoning-API
    • Alle API-Tools →

    Alternativen

    Alternativen
    • Kie.ai-Alternative
    • Fal.ai-Alternative
    • OpenRouter-Alternative
    • Replicate-Alternative
    • Wavespeed-AI-Alternative
    • Alle Vergleiche →

    Empfohlene Leitfäden

    Empfohlene Leitfäden
    • Preise von Seedance 2.0 und 2.5
    • Leitfaden zur günstigsten Seedance-API
    • Integrationsleitfaden zu MiniMax H3
    • Kostenloser Seedance-2-API-Schlüssel
    • Schnellstart der Seedance-2-API
    • Alle Engineering-Beiträge →

    Entwickler und Plattform

    Entwickler und Plattform
    • API-Dokumentation
    • MCP
    • Preise
    • Modell-Playground
    • LLMs.txt
    • Support kontaktieren
    • Verzeichnis der Modell-Leitfäden
    Betreiber:
    鯨樞智能科技有限公司
    JINGSHU INTELLIGENT LIMITED
    Sitz der Gesellschaft:
    ROOM 5042, 5/F, YAU LEE CENTRE, NO.45, HOI YUEN ROAD, KWUN TONG, KOWLOON, HONG KONG
    DatenschutzNutzungsbedingungenZulässige NutzungDatenlöschungDatenaufbewahrungAuftragsverarbeiter und RegionenAbrechnung und ErstattungenCookie-RichtlinieSitemapÜber uns

    © 2026 ToAPIs. Alle Rechte vorbehalten.